要點速覽:
馬賽克會丟掉一部分細節。不同原圖,可能變成同一片色塊。
AI 可以補出清楚的畫面,但補出來的細節,未必是原來那一份。
難以還原,不等於不會泄露。文字、視頻和畫面裏的其他線索,仍可能暴露內容或身份。
刑偵片裏經常有這樣一幕:監控拍到一個模糊的人影,技術人員敲幾下鍵盤,再來一句“放大,增強”,臉和車牌就都出來了。
既然電腦能輕鬆把清晰圖片變成馬賽克,爲什麼不能把這個過程倒過來?
先從電腦打碼時做的那件小事說起。
一、打碼時,圖片少了什麼?
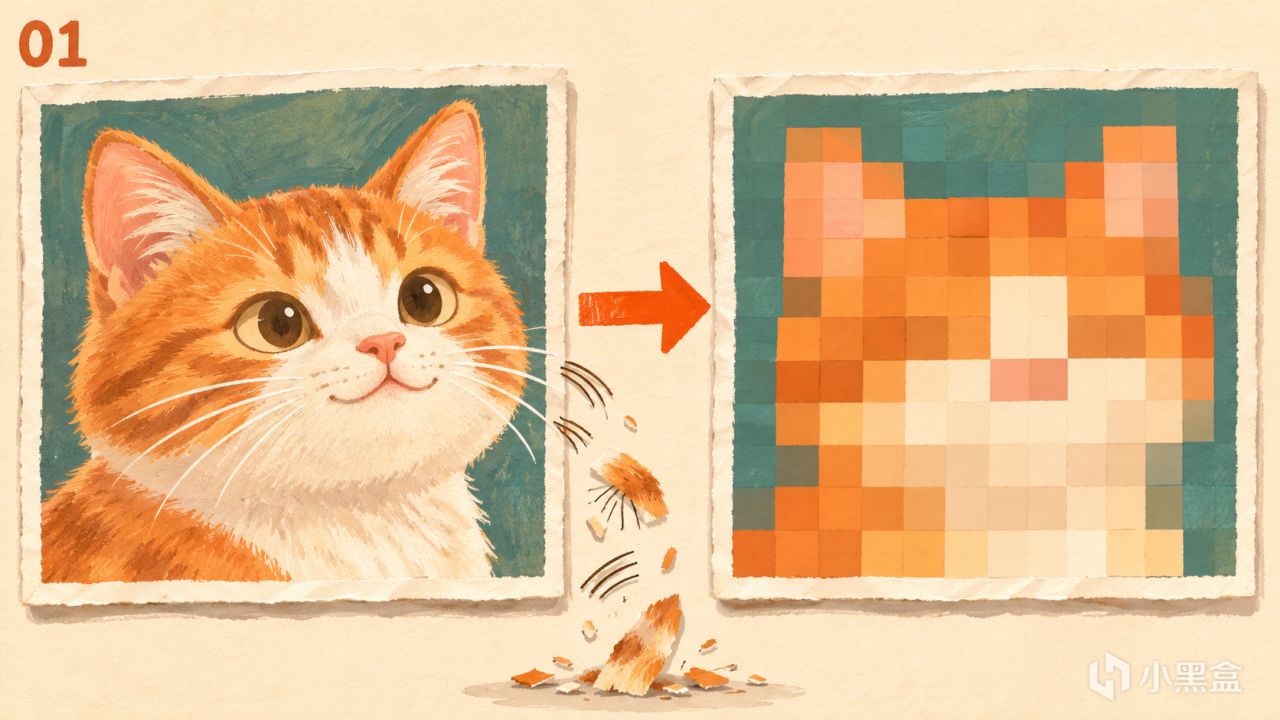
圖片由許多個小像素組成。眼睛的形狀、頭髮的走向,都是這些像素之間的顏色差異。
常見的塊狀馬賽克,會把一小片像素合併成同一種顏色。比如原來一塊區域裏有深有淺,處理後,就都變成這一塊的平均顏色。
方塊還在,方塊裏面的細節卻少了。圖片的寬高甚至可以完全不變,但眼睫毛、衣服紋路,已經不再單獨保留。
這裏說的是常見的像素塊馬賽克。模糊濾鏡等其他處理,具體做法會有區別。
二、爲什麼不能反着算回去?
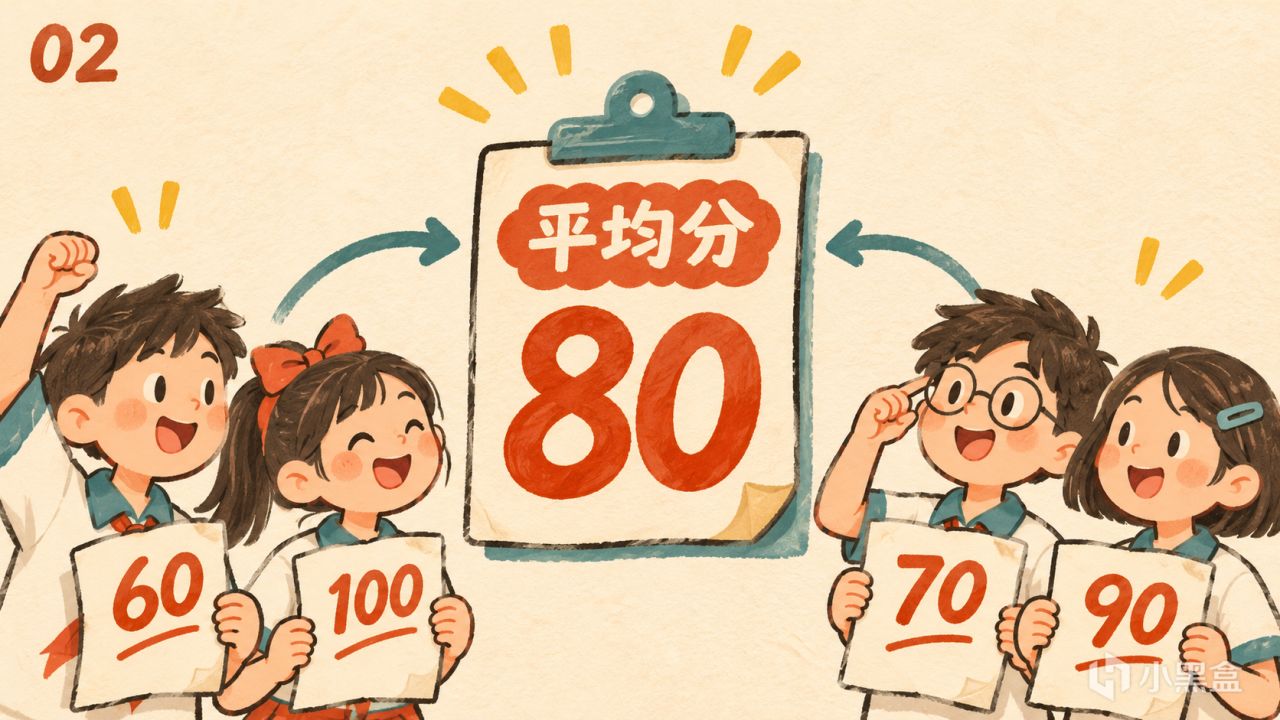
假設老師告訴你:兩個同學的平均分是 80 分。
他們可能分別考了 60 和 100,也可能是 70 和 90,還可能都是 80。知道平均分,不能確定每個人的成績。
馬賽克也有類似的問題:好幾種不同的原始細節,可能算出同一個色塊。
打碼時,電腦知道原來的像素,合併起來很容易。還原時,你手裏只剩合併後的結果,答案卻可能有很多個。
算得再快,也不能僅憑這個結果,認定哪一個纔是真的。
所以它沒有一把通用的“解碼鑰匙”。編輯軟件裏能撤銷打碼,通常是因爲還留着原圖或操作記錄,取回的是保留的數據。
三、AI“去馬賽克”,補出來的是真的嗎?
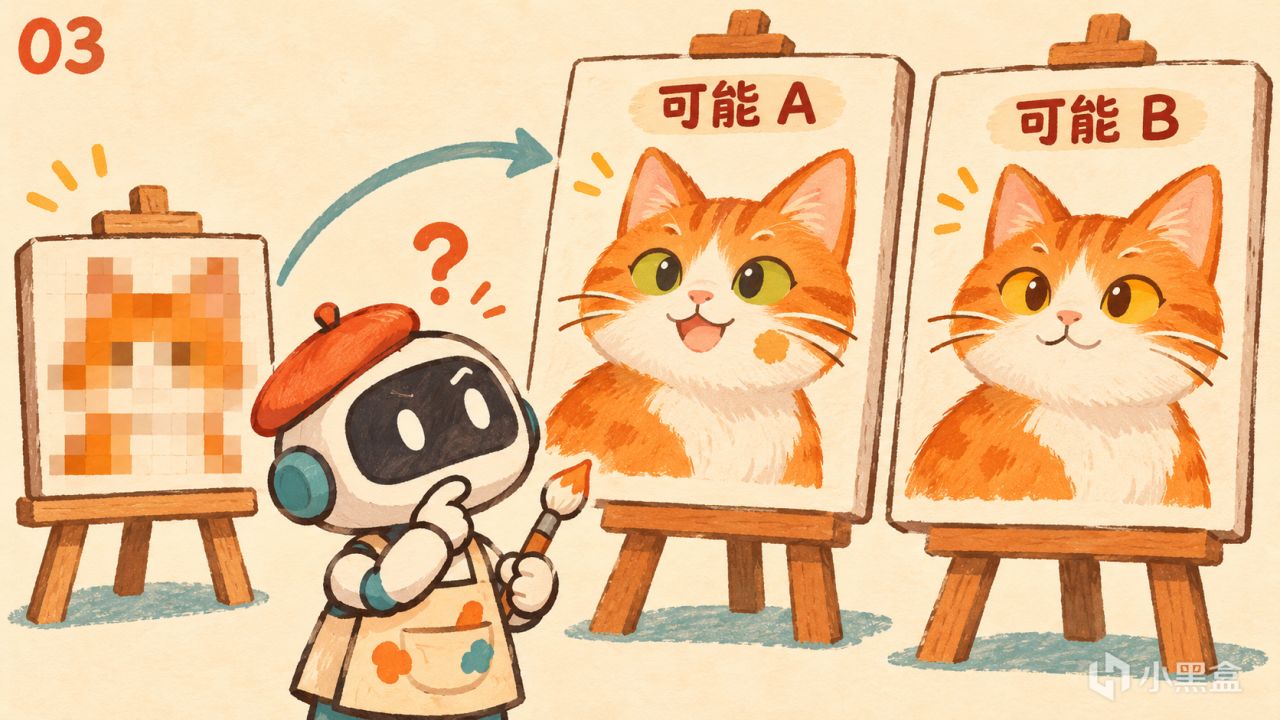
AI 看過大量圖片,學到了一些規律:眼睛通常長在哪裏,頭髮大致怎樣延伸,貓咪的臉一般是什麼樣。
它可以根據剩下的輪廓、顏色和這些規律,補出一張清楚的圖。有些細節可能補對,有些則可能是“看着合理”的新內容。
例如,2020 年的 PULSE 研究會尋找逼真的高清人臉,讓它縮小後能匹配輸入的低清圖。但匹配得上,並不能證明它就是原來的那張臉。
四、那爲什麼還有“破解成功”的例子?
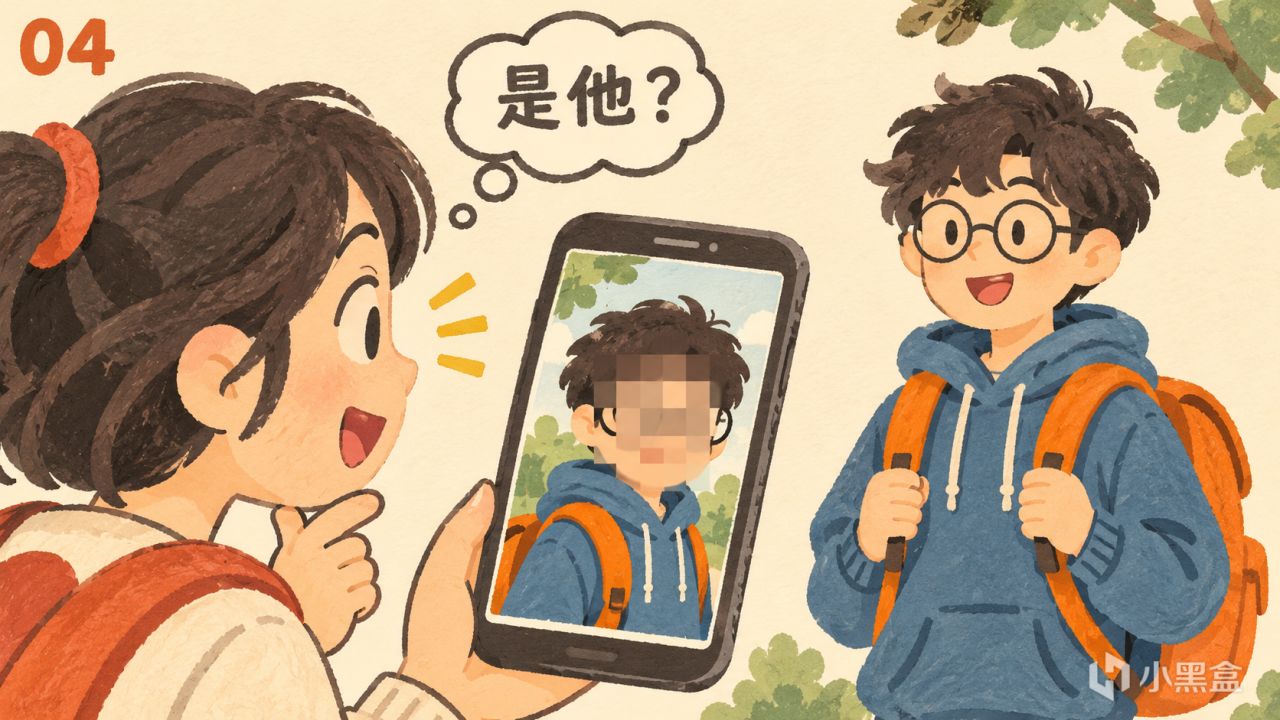
因爲認出內容,並不一定要先還原所有像素。
同學的臉被打碼了,你仍可能從校服、書包、髮型和拍攝地點認出他。程序也可以利用殘留特徵;如果已經有一組候選人,範圍還會進一步縮小。
文字也有類似情況。常用字、字體和上下文都會限制答案,有些打碼還保留了筆畫的明暗分佈。研究者確實在一定條件下恢復過被遮蔽的文字,也做過遮蔽圖像的識別實驗。
不能精確恢復原圖,不等於看不出它在說什麼、拍了誰。
五、視頻爲什麼可能比單張圖片更容易露餡?
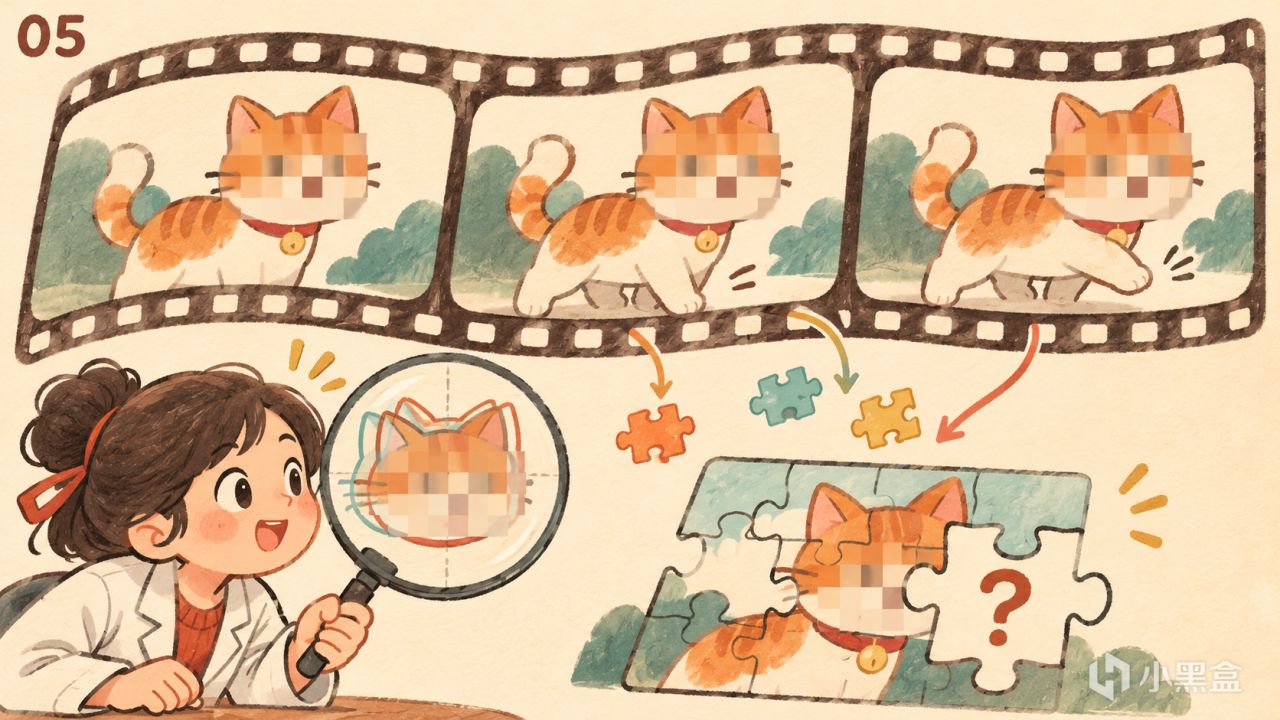
一張圖片只有一個瞬間,視頻卻有連續的許多幀。
人和馬賽克網格發生相對移動時,不同幀裏的色塊,可能混合了不同位置的像素。把這些畫面對齊,就有機會多得到一些線索。
2020 年一項人臉視頻研究,就利用相鄰幀的信息,重建出了接近原視頻的畫面,展示了像素化可能帶來的身份泄露風險。
當然,把同一張打碼圖重複一萬次,也不會憑空長出細節。多幀有沒有幫助,要看它們是否帶來了新的信息,以及打碼和壓縮有多嚴重。
六、真要保護隱私,怎麼遮更合適?
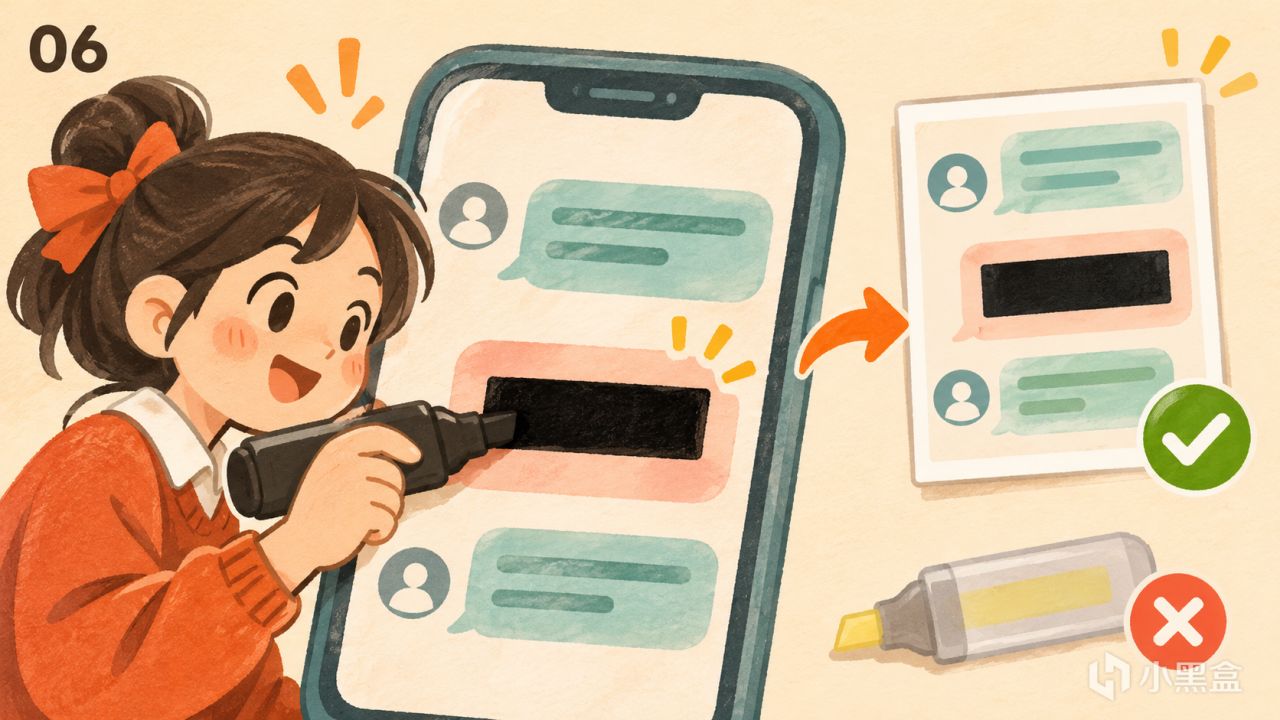
對於不想公開的賬號、手機號、地址和聊天內容,更合適的辦法是:用完全不透明的純色塊蓋住整個敏感區域,導出新圖片,再檢查一遍。
覆蓋寫進最終圖片後,這片區域的輸出像素就不再隨下面的文字變化。半透明塗抹、很輕的模糊,則可能繼續留下線索。
還要留意:可移動的遮擋層,不等於已經處理好的圖片;視頻要檢查整個片段,防止遮擋跟丟、切鏡漏幀。想隱藏身份,也得看看聲音、衣着和背景有沒有暴露線索。
結語:
感謝喝油們閱讀。,今天這個文章感覺質量有點沒很高,我會繼續努力的
主要研究依據:
[1] Menon 等,PULSE:通過生成模型探索高清圖像,CVPR 2020。arXiv:2003.03808
[2] Hill 等,馬賽克和模糊用於文檔遮蓋的有效性,PoPETs 2016(4):403–417。https://hovav.net/ucsd/papers/hzss16.html
[3] McPherson 等,使用深度學習識別經過遮蔽的圖像,2016。arXiv:1609.00408
[4] Shuvi 等,利用神經網絡對齊進行人臉視頻去像素化,2020。arXiv:2009.13856
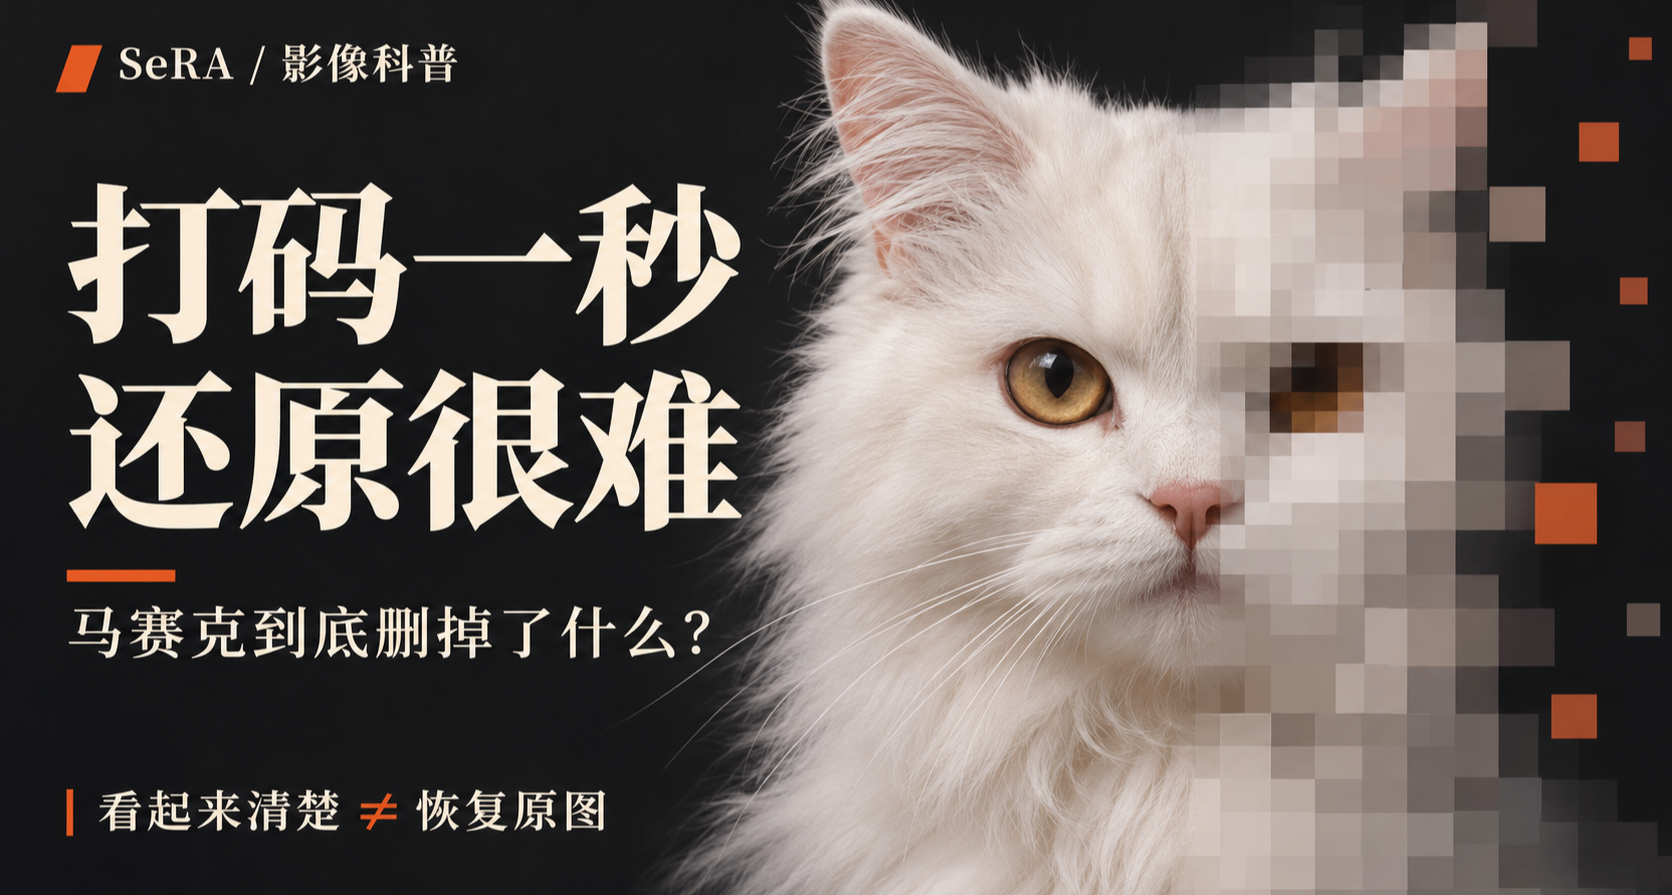
配圖爲 AI 生成的科普插畫,用於說明原理,非真實“去馬賽克”效果對比。
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com