要点速览:
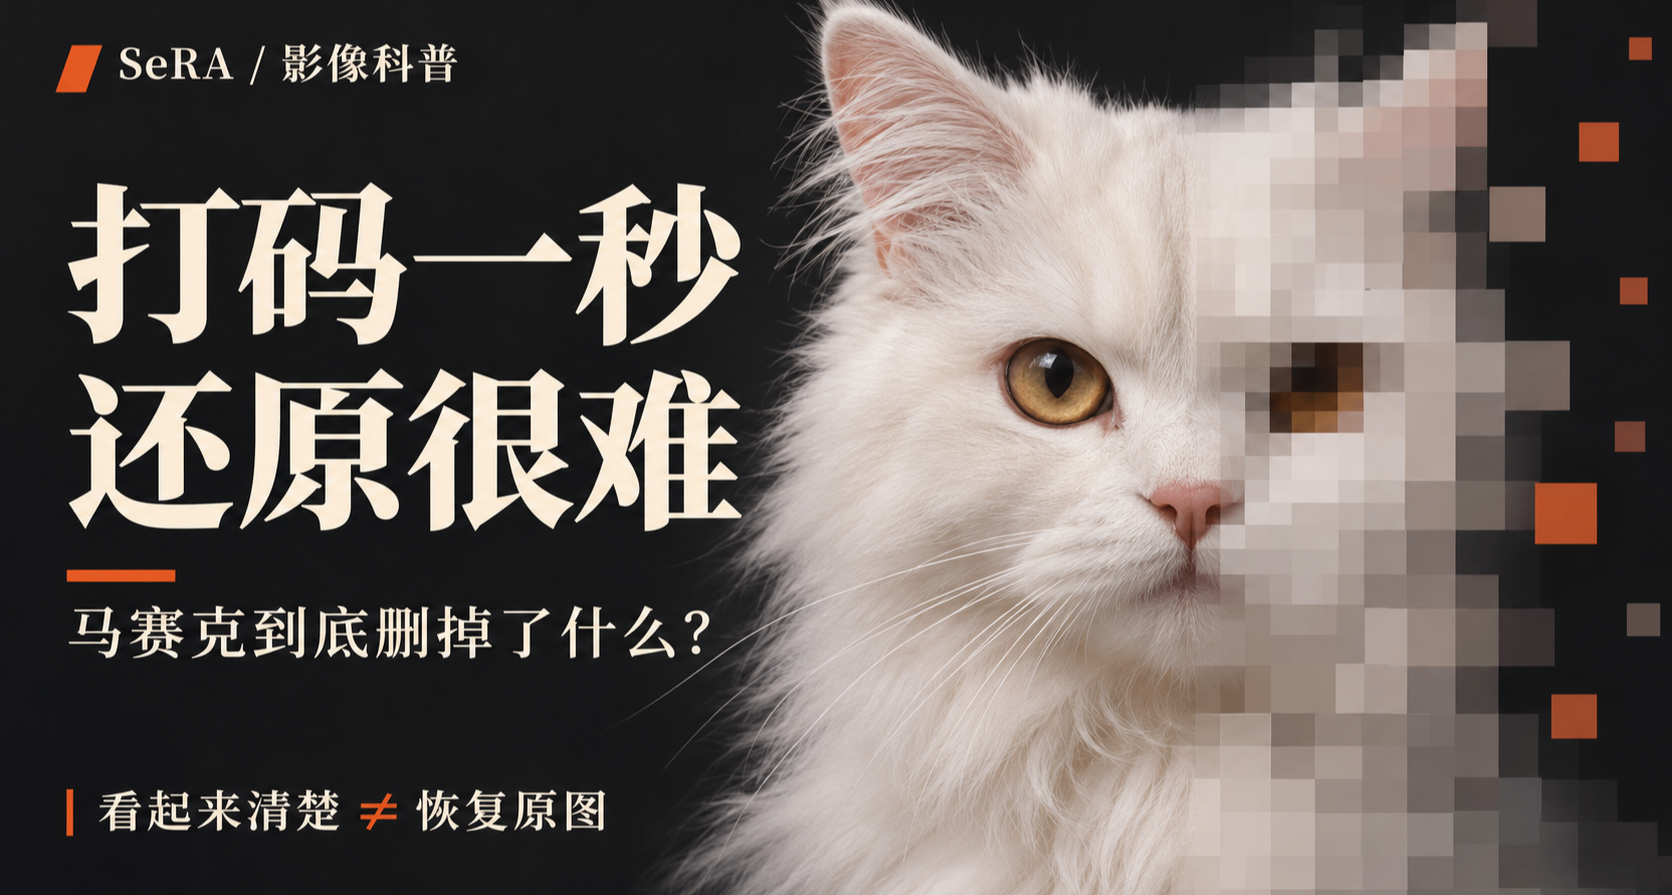
马赛克会丢掉一部分细节。不同原图,可能变成同一片色块。
AI 可以补出清楚的画面,但补出来的细节,未必是原来那一份。
难以还原,不等于不会泄露。文字、视频和画面里的其他线索,仍可能暴露内容或身份。
刑侦片里经常有这样一幕:监控拍到一个模糊的人影,技术人员敲几下键盘,再来一句“放大,增强”,脸和车牌就都出来了。
既然电脑能轻松把清晰图片变成马赛克,为什么不能把这个过程倒过来?
先从电脑打码时做的那件小事说起。
一、打码时,图片少了什么?
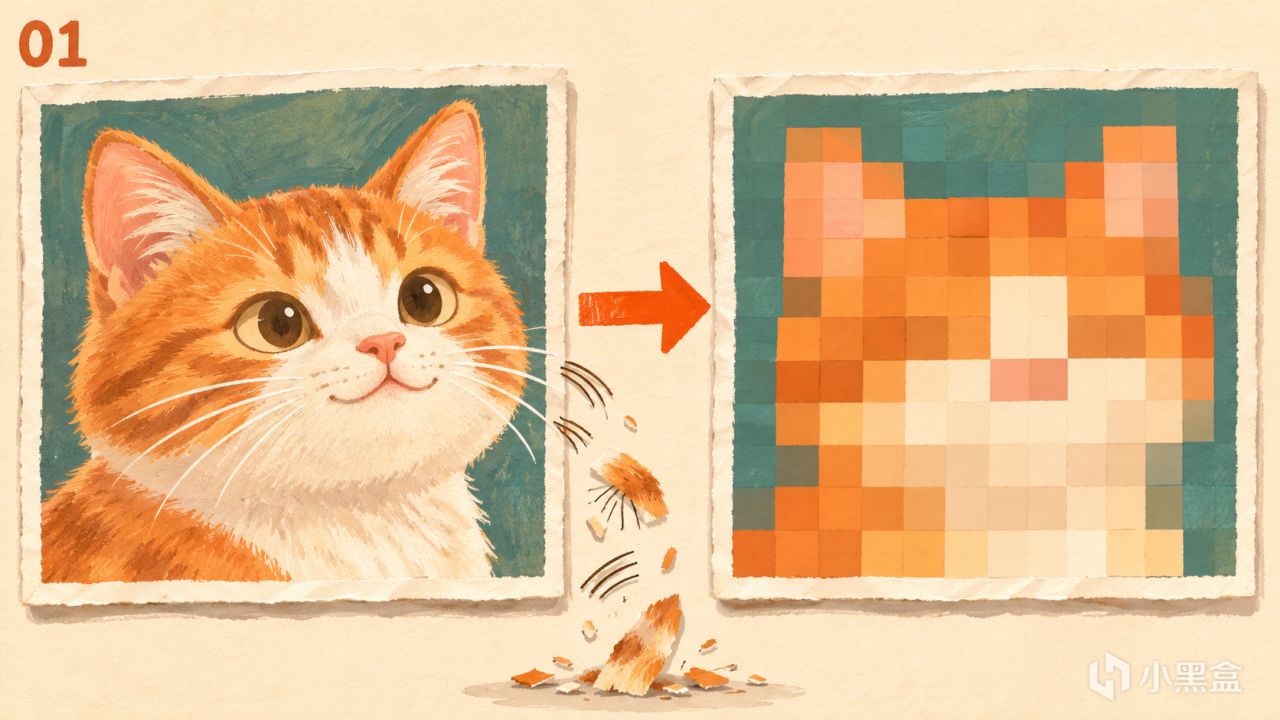
图片由许多个小像素组成。眼睛的形状、头发的走向,都是这些像素之间的颜色差异。
常见的块状马赛克,会把一小片像素合并成同一种颜色。比如原来一块区域里有深有浅,处理后,就都变成这一块的平均颜色。
方块还在,方块里面的细节却少了。图片的宽高甚至可以完全不变,但眼睫毛、衣服纹路,已经不再单独保留。
这里说的是常见的像素块马赛克。模糊滤镜等其他处理,具体做法会有区别。
二、为什么不能反着算回去?
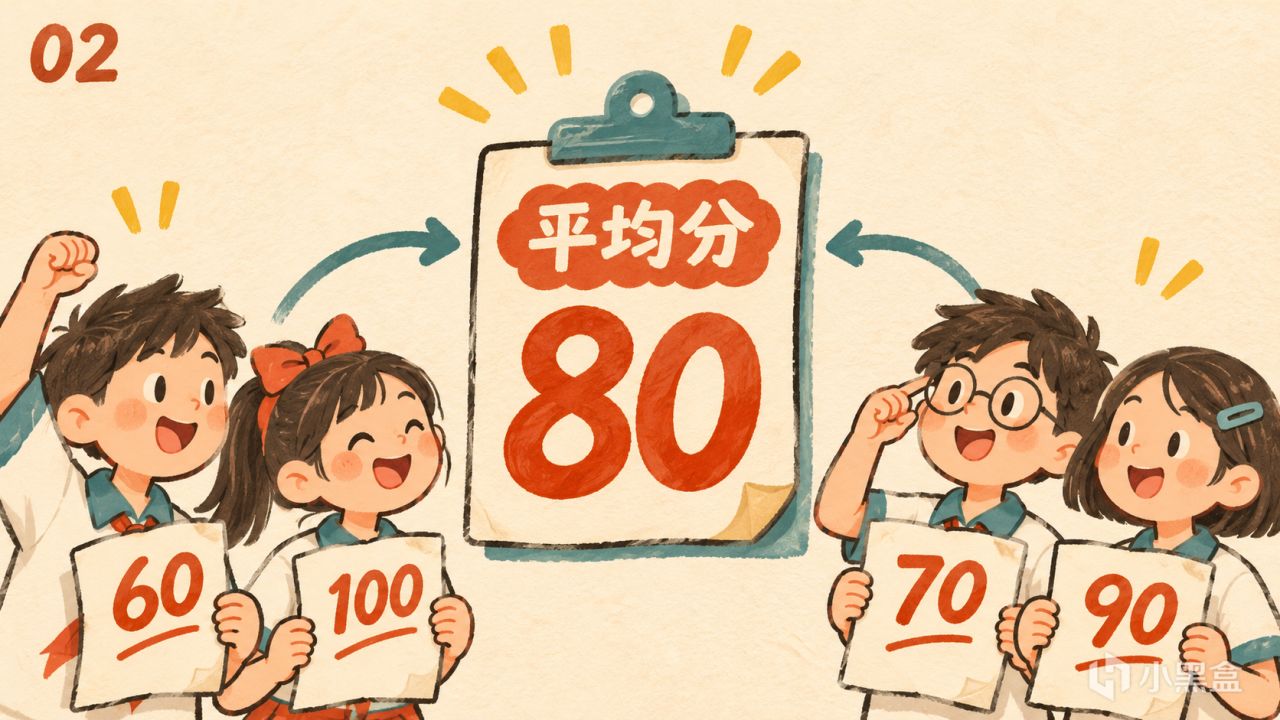
假设老师告诉你:两个同学的平均分是 80 分。
他们可能分别考了 60 和 100,也可能是 70 和 90,还可能都是 80。知道平均分,不能确定每个人的成绩。
马赛克也有类似的问题:好几种不同的原始细节,可能算出同一个色块。
打码时,电脑知道原来的像素,合并起来很容易。还原时,你手里只剩合并后的结果,答案却可能有很多个。
算得再快,也不能仅凭这个结果,认定哪一个才是真的。
所以它没有一把通用的“解码钥匙”。编辑软件里能撤销打码,通常是因为还留着原图或操作记录,取回的是保留的数据。
三、AI“去马赛克”,补出来的是真的吗?
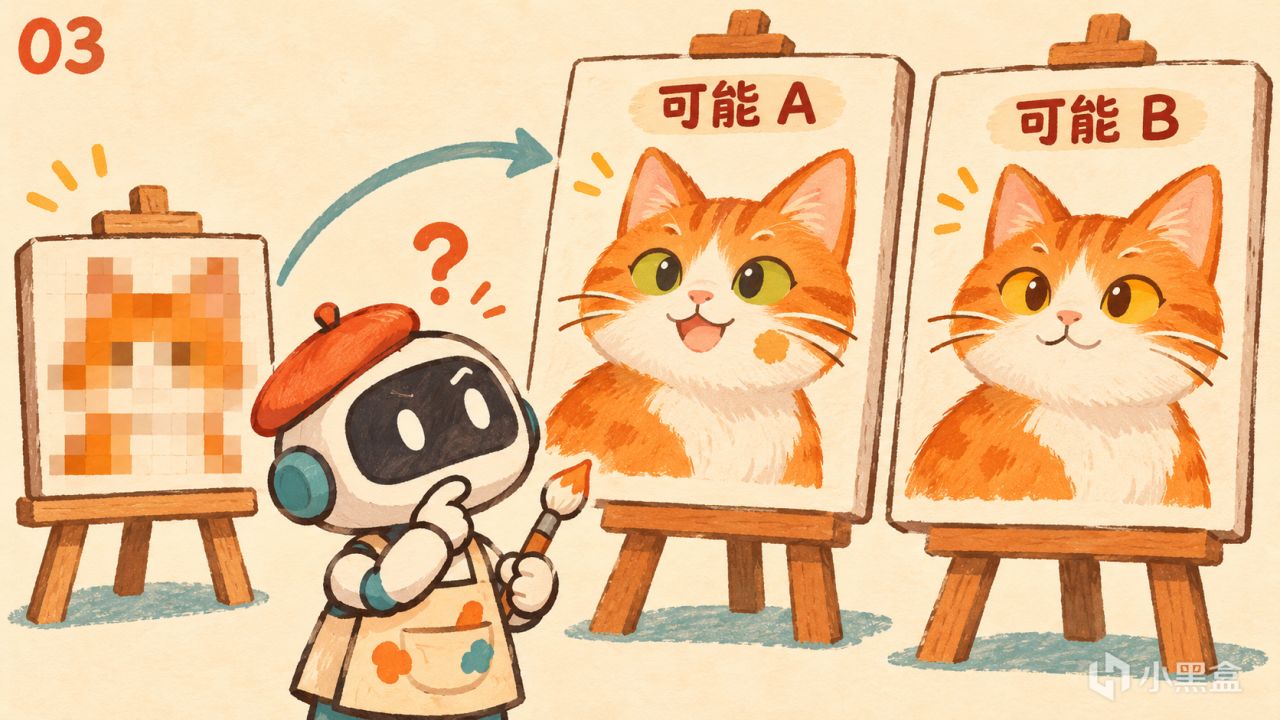
AI 看过大量图片,学到了一些规律:眼睛通常长在哪里,头发大致怎样延伸,猫咪的脸一般是什么样。
它可以根据剩下的轮廓、颜色和这些规律,补出一张清楚的图。有些细节可能补对,有些则可能是“看着合理”的新内容。
例如,2020 年的 PULSE 研究会寻找逼真的高清人脸,让它缩小后能匹配输入的低清图。但匹配得上,并不能证明它就是原来的那张脸。
四、那为什么还有“破解成功”的例子?
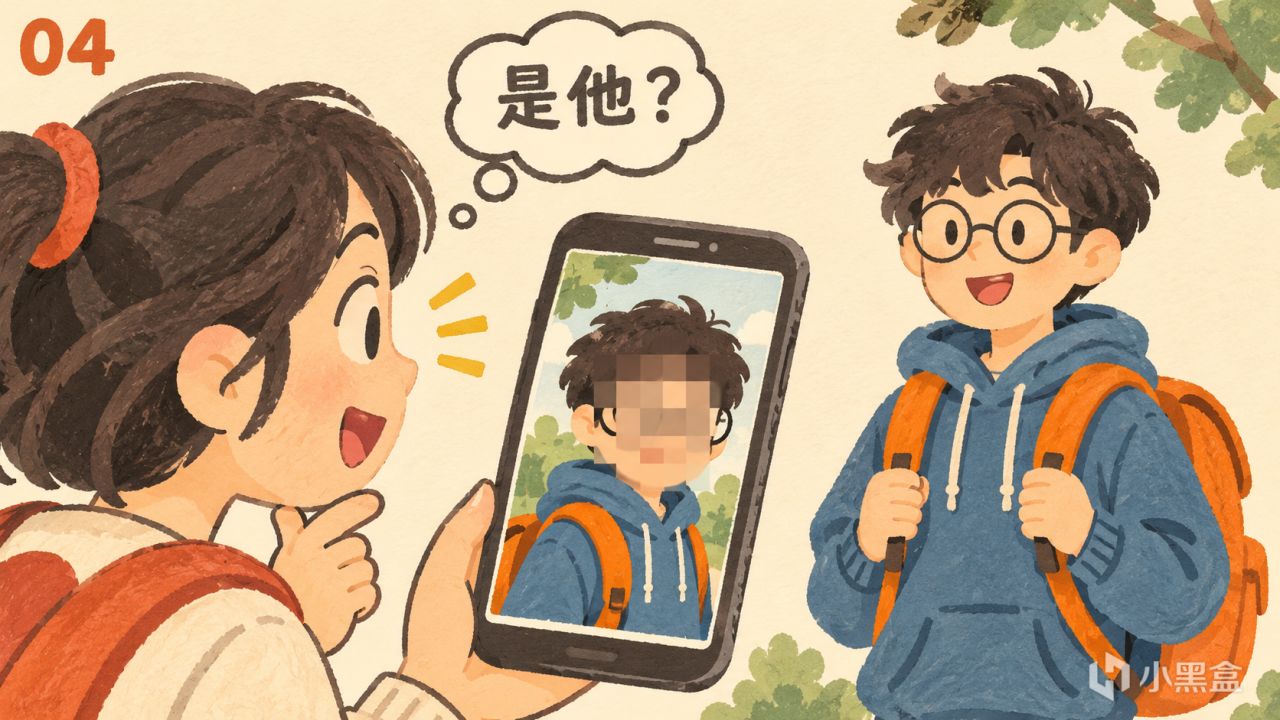
因为认出内容,并不一定要先还原所有像素。
同学的脸被打码了,你仍可能从校服、书包、发型和拍摄地点认出他。程序也可以利用残留特征;如果已经有一组候选人,范围还会进一步缩小。
文字也有类似情况。常用字、字体和上下文都会限制答案,有些打码还保留了笔画的明暗分布。研究者确实在一定条件下恢复过被遮蔽的文字,也做过遮蔽图像的识别实验。
不能精确恢复原图,不等于看不出它在说什么、拍了谁。
五、视频为什么可能比单张图片更容易露馅?
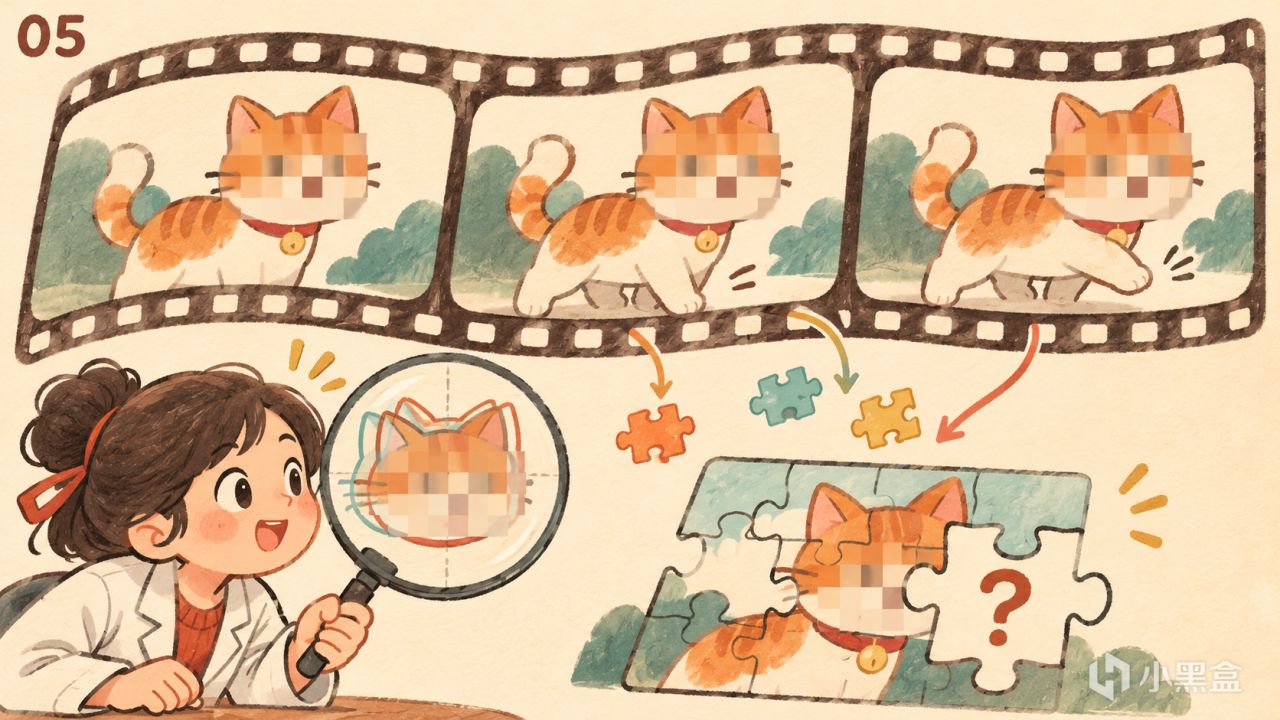
一张图片只有一个瞬间,视频却有连续的许多帧。
人和马赛克网格发生相对移动时,不同帧里的色块,可能混合了不同位置的像素。把这些画面对齐,就有机会多得到一些线索。
2020 年一项人脸视频研究,就利用相邻帧的信息,重建出了接近原视频的画面,展示了像素化可能带来的身份泄露风险。
当然,把同一张打码图重复一万次,也不会凭空长出细节。多帧有没有帮助,要看它们是否带来了新的信息,以及打码和压缩有多严重。
六、真要保护隐私,怎么遮更合适?
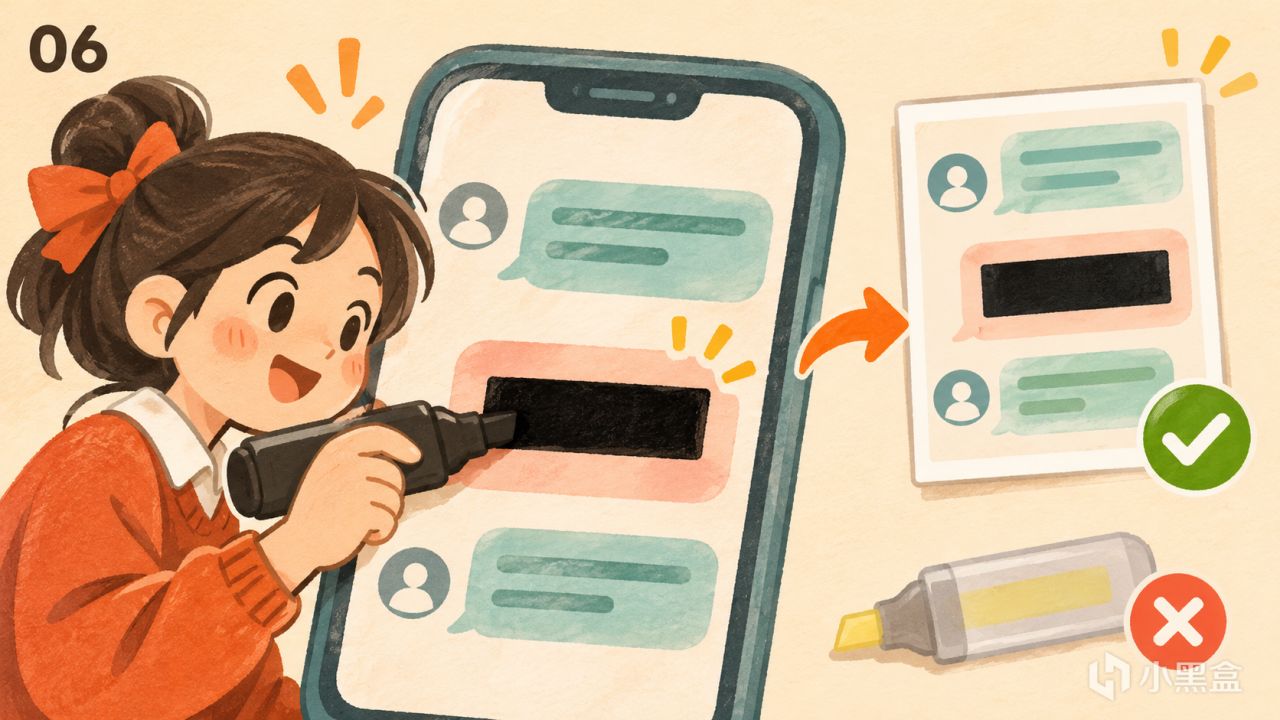
对于不想公开的账号、手机号、地址和聊天内容,更合适的办法是:用完全不透明的纯色块盖住整个敏感区域,导出新图片,再检查一遍。
覆盖写进最终图片后,这片区域的输出像素就不再随下面的文字变化。半透明涂抹、很轻的模糊,则可能继续留下线索。
还要留意:可移动的遮挡层,不等于已经处理好的图片;视频要检查整个片段,防止遮挡跟丢、切镜漏帧。想隐藏身份,也得看看声音、衣着和背景有没有暴露线索。
结语:
感谢喝油们阅读。,今天这个文章感觉质量有点没很高,我会继续努力的
主要研究依据:
[1] Menon 等,PULSE:通过生成模型探索高清图像,CVPR 2020。arXiv:2003.03808
[2] Hill 等,马赛克和模糊用于文档遮盖的有效性,PoPETs 2016(4):403–417。https://hovav.net/ucsd/papers/hzss16.html
[3] McPherson 等,使用深度学习识别经过遮蔽的图像,2016。arXiv:1609.00408
[4] Shuvi 等,利用神经网络对齐进行人脸视频去像素化,2020。arXiv:2009.13856
配图为 AI 生成的科普插画,用于说明原理,非真实“去马赛克”效果对比。
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com