【前哨硬件情報】Anthropic 近期在路演推介材料中展示了一項顛覆性數據。其內部模型僅耗時約 3 天,便自主完成了將模型算法跨平臺遷移部署至 AMD MI355X 算力集羣的操作,而傳統人工遷移適配週期長達 6 至 12 個月。
「前哨基地情報到,前沿硬件早知道!」
軟硬件解耦與算力同質化
在人工智能硬件基礎設施領域,英偉達長期依託 CUDA 生態的高門檻構建了堅固的技術護城河。開發者與企業若想更換至其他算力平臺,通常需要耗費數月甚至一年時間進行算子重構、底層調優與運行庫適配。
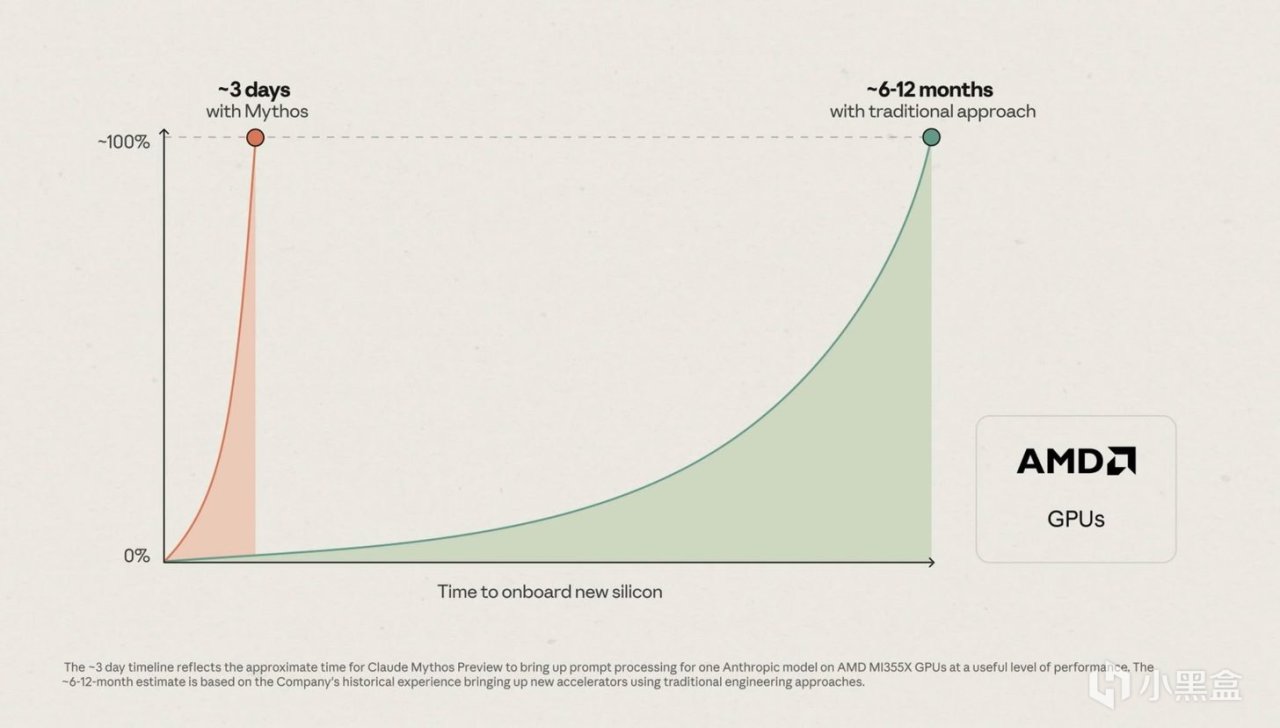
Anthropic 披露的數據顯示,前沿模型本身已具備極強的跨平臺代碼重寫與底層調優能力。通過讓模型自主解析底層算法依賴並對接目標硬件架構,跨廠商遷移門檻迎來斷崖式下跌。在 Anthropic 的架構視野中,不同廠商的 GPU 正逐步演化爲可隨時替換的「同質化通用算力單元」。
互聯壁壘與物理底盤競爭
儘管軟件層面的跨平臺編譯效率迎來飛躍,但斷言英偉達生態壁壘瓦解依然爲時尚早。
首先,CUDA 背後沉澱了長達近二十年的底層核心數學庫與成熟工具鏈。更爲關鍵的是物理互聯架構,英偉達通過 NVLink 與專有高速網絡協議,配合 NCCL 通信庫將成千上萬張顯卡粘合爲超低延遲的統一巨型算力陣列。這種集羣拓撲級的通信帶寬優勢,短期內單純依靠上層模型編譯仍難以完全彌平。
遷移突破與生態現狀提煉
【跨平臺遷移耗時】:藉助模型自主適配僅需約 3 天,較傳統工程團隊耗費 6 至 12 個月大幅縮減 98% 以上。
【驗證測試平臺】:以 AMD 新一代 Instinct MI355X 加速芯片爲目標環境,成功跑通端到端推理適配。
【算力定位轉變】:企業開始將底層算力硬件視爲可隨時平替的標準化消耗品,弱化對單一廠商閉源生態的綁定依賴。
【客觀侷限說明】:(注:軟件算法遷移跑通不等於完全釋放物理硬件的滿血集羣互聯能效,大規模多節點通信仍受限於底層網絡拓撲與物理帶寬)
指揮官省流
【生態解綁與遷移收益】:AI 自主跨架構適配算法的突破,直接擊穿了以往被 CUDA 閉源生態深度綁定的工程困局;當底層平臺的適配週期從漫長的 6 至 12 個月斷崖式壓縮至僅需 3 天,GPU 便真正蛻變爲可隨時平替的「同質化通用算力單元」,企業採購並切換至 AMD 等競品算力陣列的門檻與試錯成本被徹底打碎。
【集羣通信與物理壁壘】:軟件層實現 3 天快速遷移,並不代表能直接抹平硬件底盤的物理差距。英偉達真正的護城河早已延伸至物理通信層,依託 NVLink、InfiniBand 專有網絡與 NCCL 通信庫將海量 GPU 粘合成超低延遲計算陣列;在超大規模分佈式訓練和高併發集羣通信中,純軟件適配依然無法完全替代物理拓撲與專有高速互聯的技術壁壘。
【算力成本與生態預期】:將底層算力視作可隨時平替的「同質化單元」,核心意義在於打破單一硬件生態的閉環壟斷;隨着大模型自主跨架構調優大幅降低試錯門檻,數據中心算力採購將從「被迫綁定 CUDA」逐步邁向「多芯片競價採購」,不僅能倒逼芯片廠商擠壓硬件溢價,也讓下游企業獲取算力的綜合成本迎來實質性回落。
點贊加關注,硬核乾貨不迷路
信源:Wccftech / Anthropic / X
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com