【前哨硬件情报】Anthropic 近期在路演推介材料中展示了一项颠覆性数据。其内部模型仅耗时约 3 天,便自主完成了将模型算法跨平台迁移部署至 AMD MI355X 算力集群的操作,而传统人工迁移适配周期长达 6 至 12 个月。
「前哨基地情报到,前沿硬件早知道!」
软硬件解耦与算力同质化
在人工智能硬件基础设施领域,英伟达长期依托 CUDA 生态的高门槛构建了坚固的技术护城河。开发者与企业若想更换至其他算力平台,通常需要耗费数月甚至一年时间进行算子重构、底层调优与运行库适配。
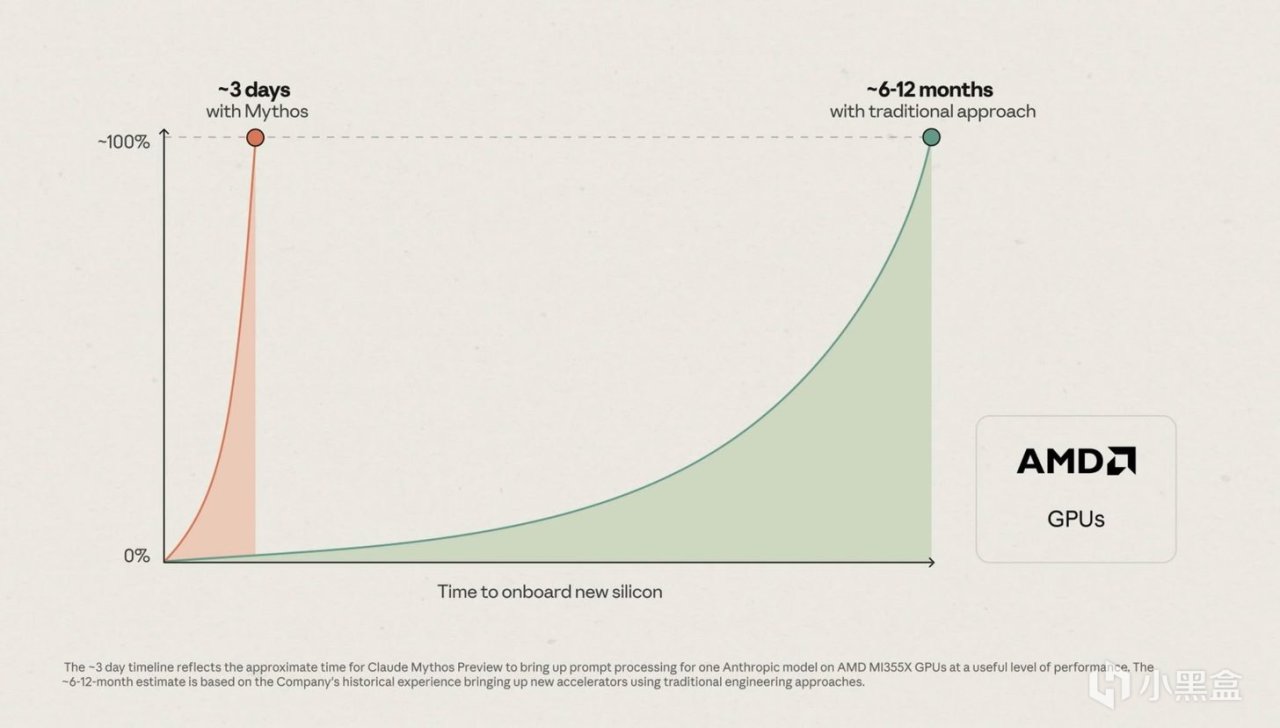
Anthropic 披露的数据显示,前沿模型本身已具备极强的跨平台代码重写与底层调优能力。通过让模型自主解析底层算法依赖并对接目标硬件架构,跨厂商迁移门槛迎来断崖式下跌。在 Anthropic 的架构视野中,不同厂商的 GPU 正逐步演化为可随时替换的「同质化通用算力单元」。
互联壁垒与物理底盘竞争
尽管软件层面的跨平台编译效率迎来飞跃,但断言英伟达生态壁垒瓦解依然为时尚早。
首先,CUDA 背后沉淀了长达近二十年的底层核心数学库与成熟工具链。更为关键的是物理互联架构,英伟达通过 NVLink 与专有高速网络协议,配合 NCCL 通信库将成千上万张显卡粘合为超低延迟的统一巨型算力阵列。这种集群拓扑级的通信带宽优势,短期内单纯依靠上层模型编译仍难以完全弥平。
迁移突破与生态现状提炼
【跨平台迁移耗时】:借助模型自主适配仅需约 3 天,较传统工程团队耗费 6 至 12 个月大幅缩减 98% 以上。
【验证测试平台】:以 AMD 新一代 Instinct MI355X 加速芯片为目标环境,成功跑通端到端推理适配。
【算力定位转变】:企业开始将底层算力硬件视为可随时平替的标准化消耗品,弱化对单一厂商闭源生态的绑定依赖。
【客观局限说明】:(注:软件算法迁移跑通不等于完全释放物理硬件的满血集群互联能效,大规模多节点通信仍受限于底层网络拓扑与物理带宽)
指挥官省流
【生态解绑与迁移收益】:AI 自主跨架构适配算法的突破,直接击穿了以往被 CUDA 闭源生态深度绑定的工程困局;当底层平台的适配周期从漫长的 6 至 12 个月断崖式压缩至仅需 3 天,GPU 便真正蜕变为可随时平替的「同质化通用算力单元」,企业采购并切换至 AMD 等竞品算力阵列的门槛与试错成本被彻底打碎。
【集群通信与物理壁垒】:软件层实现 3 天快速迁移,并不代表能直接抹平硬件底盘的物理差距。英伟达真正的护城河早已延伸至物理通信层,依托 NVLink、InfiniBand 专有网络与 NCCL 通信库将海量 GPU 粘合成超低延迟计算阵列;在超大规模分布式训练和高并发集群通信中,纯软件适配依然无法完全替代物理拓扑与专有高速互联的技术壁垒。
【算力成本与生态预期】:将底层算力视作可随时平替的「同质化单元」,核心意义在于打破单一硬件生态的闭环垄断;随着大模型自主跨架构调优大幅降低试错门槛,数据中心算力采购将从「被迫绑定 CUDA」逐步迈向「多芯片竞价采购」,不仅能倒逼芯片厂商挤压硬件溢价,也让下游企业获取算力的综合成本迎来实质性回落。
点赞加关注,硬核干货不迷路
信源:Wccftech / Anthropic / X
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com