今天凌晨,Anthropic 沒搞任何預熱直播和倒計時,直接在官網、客戶端和 API 裏同步甩出了兩款重磅王牌模型——Claude Fable 5.2 和 Claude Mythos 5.2。
前兩天大家還在圍觀各家新模型的灰度測試,結果 Claude 這一記悶棍下來,不僅把 ARC-AGI-3 標準框架的歷史最高分給破了,還在十多項硬核基準測試裏把自家的 Opus 5.5、隔壁的 GPT-6 Astra 和谷歌的 Gemini 4 Carbon 挨個壓了一頭。今天咱們就把官方放出的實測數據、多智能體極限實驗以及社區技術博主的深度拆解揉在一起,帶大家看看這次 5.2 系列到底猛在哪。
一、Fable 5.2 和 Mythos 5.2 到底有什麼區別?
Fable 5.2 和 Mythos 5.2 底層共用的是同一個基座模型,定位非常純粹:就是專門用來啃各個領域裏最 棘手、最硬核的技術工程和科研難題。
那爲什麼要拆成兩個版本?核心在於安全護欄與開放權限:
Claude Fable 5.2:配備了完整的強安全護欄,面向所有付費用戶開放(包括客戶端、API 和 Claude Code),主攻高難度代碼工程、數學推理、多模態視覺和智能體任務。
Claude Mythos 5.2:解除了部分高敏感領域的安全限制,專門面向
通過資質審覈的網絡安全與生物醫學研究機構
開放。像底層漏洞挖掘、攻擊場景推演、從頭設計蛋白質結構這類容易觸發普通模型拒答的深水區科研任務,就是 Mythos 5.2 的主場。
另外在正式上線前,這套模型也經過了英國 AI 安全研究所(AISecurityInst)、FrontierDesign2 和 METR_Evals 等多家外部獨立機構的對齊與安全測評,在絕大多數對齊指標上持平或優於前代。
二、1000 個 Agent 協作 30 小時,完全形式化“費馬大定理”
枯燥的跑分表咱們往後放一放,先看這次發佈裏最讓人頭皮發麻的一項極限測試——用多智能體集羣去攻克數學界大名鼎鼎的**“費馬大定理(Fermat's Last Theorem)”形式化證明**。
所謂“形式化證明”,不是讓 AI 用自然語言寫一段數學綜述,而是要把整個定理極其龐大複雜的數學推導過程,一步不差地翻譯成計算機可以逐行、逐邏輯節點嚴格校驗的標準化形式語言。只要中間有一處邏輯斷層或語法對不上,編譯校驗就會直接卡死。
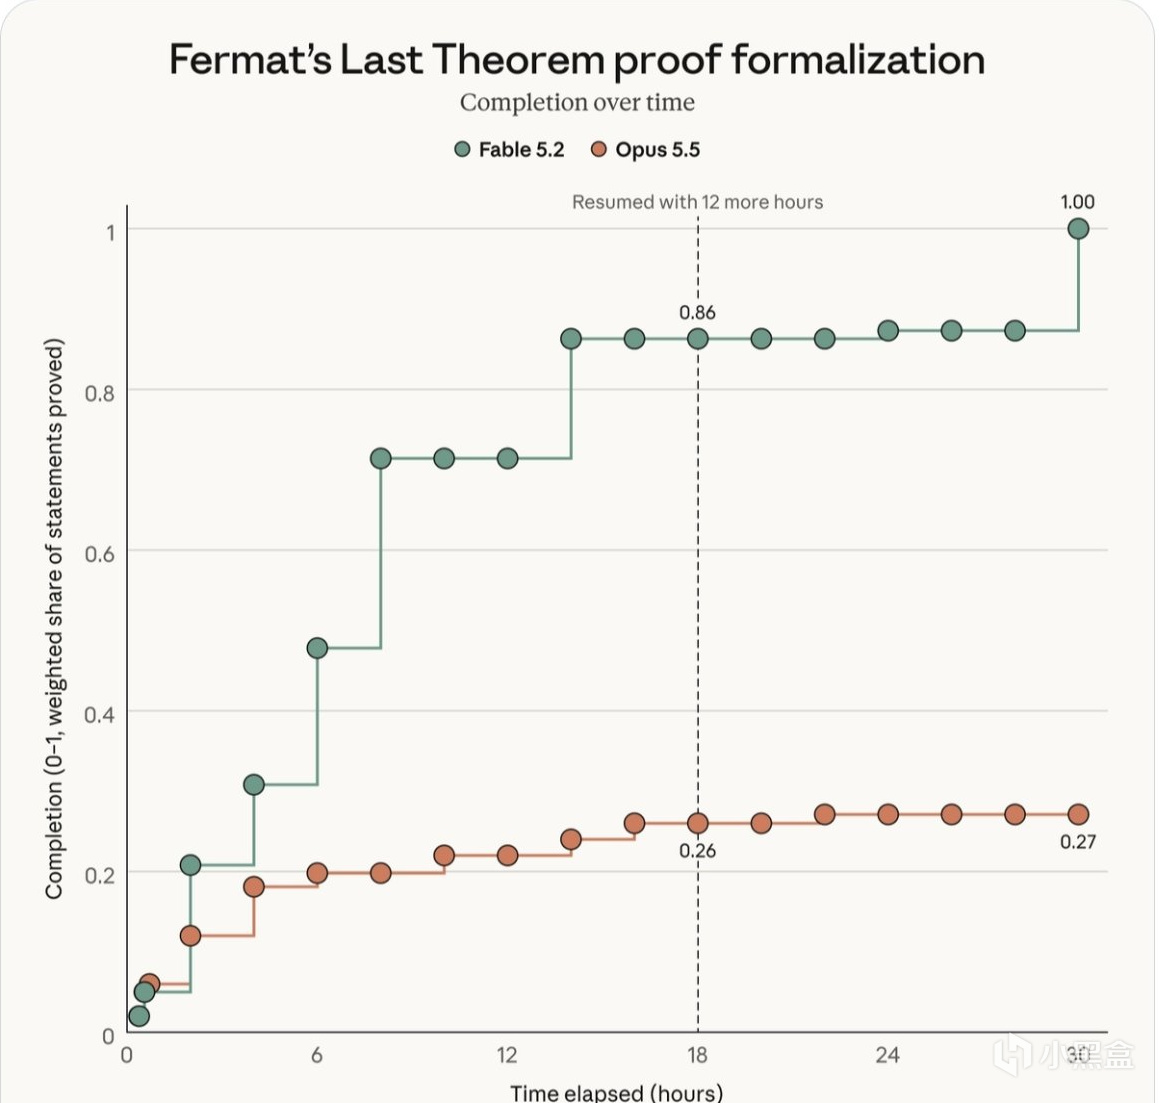
結合官方放出的實驗曲線解讀,這場測試直接拉起了 **1000 個 Fable 5.2 智能體(Agent)**組成協作系統,同時拿自家的當家主力 Opus 5.5 在完全相同的實驗條件下做對照。看上面這張時間進度圖(橫軸爲運行小時數,縱軸爲已證明語句的加權佔比),兩代模型的差距非常直觀:
前 18 小時階段:在運行到第 18 小時(圖中豎虛線處)時,Opus 5.5 的完成度只推到了26%(0.26);而由 1000 個 Fable 5.2 組成的智能體團隊,進度已經一路狂飆到86%(0.86)。
追加 12 小時續跑(18 至 30 小時):當實驗爲雙方同時追加 12 個小時繼續攻堅時,Opus 5.5 幾乎撞上了能力牆,在漫長的 12 個小時裏只艱難往前蹭了 1 個百分點,最終在 30 小時結束時停滯在27%;反觀 Fable 5.2 協作系統沒有出現長鏈路崩潰,在30 小時內拿下了 100%(1.00)完全形式化證明。
除了這場數學大考,Anthropic 內部還披露了一個很接地氣的工程實績:目前 Anthropic 內部超過 90% 的核心代碼庫變更已經由 Claude 編寫;而在真實工程測試中,Fable 5.2 曾獨立把一套核心生產服務從 Python 完整遷移重構到 Rust,直接讓該服務的啓動速度暴漲了 26 倍。
這兩個實證擺在一起,傳遞出的信號很明確:Fable 5.2 升級的重點不再是“單輪對話寫個貪喫蛇小遊戲”,而是超長週期的多智能體協同、超大規模代碼庫的跨語言重構,以及死磕到底的嚴密邏輯推演。
三、ARC-AGI 權威驗證:標準框架 81.2% 刷新歷史最高紀錄
看完了工程實戰,再看專門用來防“刷題背答案”、考驗模型面對陌生規則時抽象推理能力的權威榜單 ARC-AGI。
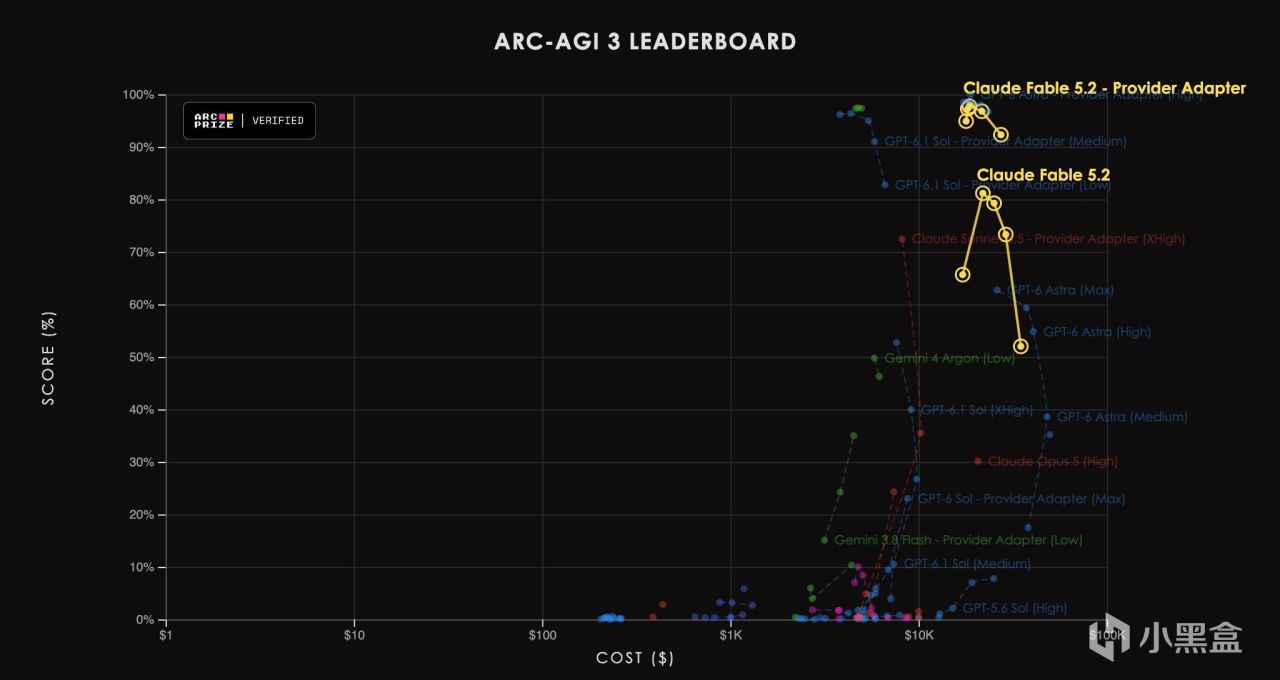
ARC Prize 官方第一時間放出了 Claude Fable 5.2 的核驗成績單(Verified):
ARC-AGI-1:得分98.5%,單任務成本低至$0.36;
ARC-AGI-2:得分93.8%,單任務成本僅$0.98;
ARC-AGI-3(廠商適配器框架 Provider Adapter harness):轟下97.7%的超高分(總測試成本約 $18.6K),直接頂到了整張排行榜的最頂端;
ARC-AGI-3(標準測試框架 Standard harness):在不借助特定廠商適配器的標準測試下,拿下81.2%(總測試成本約 $21.9K),正式刷新了 ARC-AGI-3 標準框架下的歷史最高分紀錄。
對照上面這張黑底散點圖(橫軸是測試花費,縱軸是準確率得分)能看得更清楚:在右上角逼近 100% 天花板的位置,黃色圓圈標註的 Claude Fable 5.2 - Provider Adapter 穩居第一梯隊最高點;而在下方代表標準框架的黃色折線 Claude Fable 5.2 上,它的最高點衝到了 81.2%,把同場競技的 GPT-6 Astra (Max)(60% 出頭)、GPT-6 Astra (High)(約 55%)、Claude Sonnet 5.5 - Provider Adapter (XHigh)(約 72%)、Gemini 4 Argon (Low)(50%)以及 GPT-6.1 Sol 各檔位遠遠甩在身後。
四、13 項基準全維度橫評:正面硬剛 GPT-6 Astra 與 Gemini 4 Carbon
除了 ARC-AGI,Anthropic 官方這次直接曬出了一張涵蓋 13 個大項的硬核成績單,把 Fable 5.2 / Mythos 5.2 與前代 Fable 5.1、自家主力 Opus 5.5、OpenAI 的 GPT-6 Astra 以及谷歌的 Gemini 4 Carbon 放在同一張表裏做橫向對比。
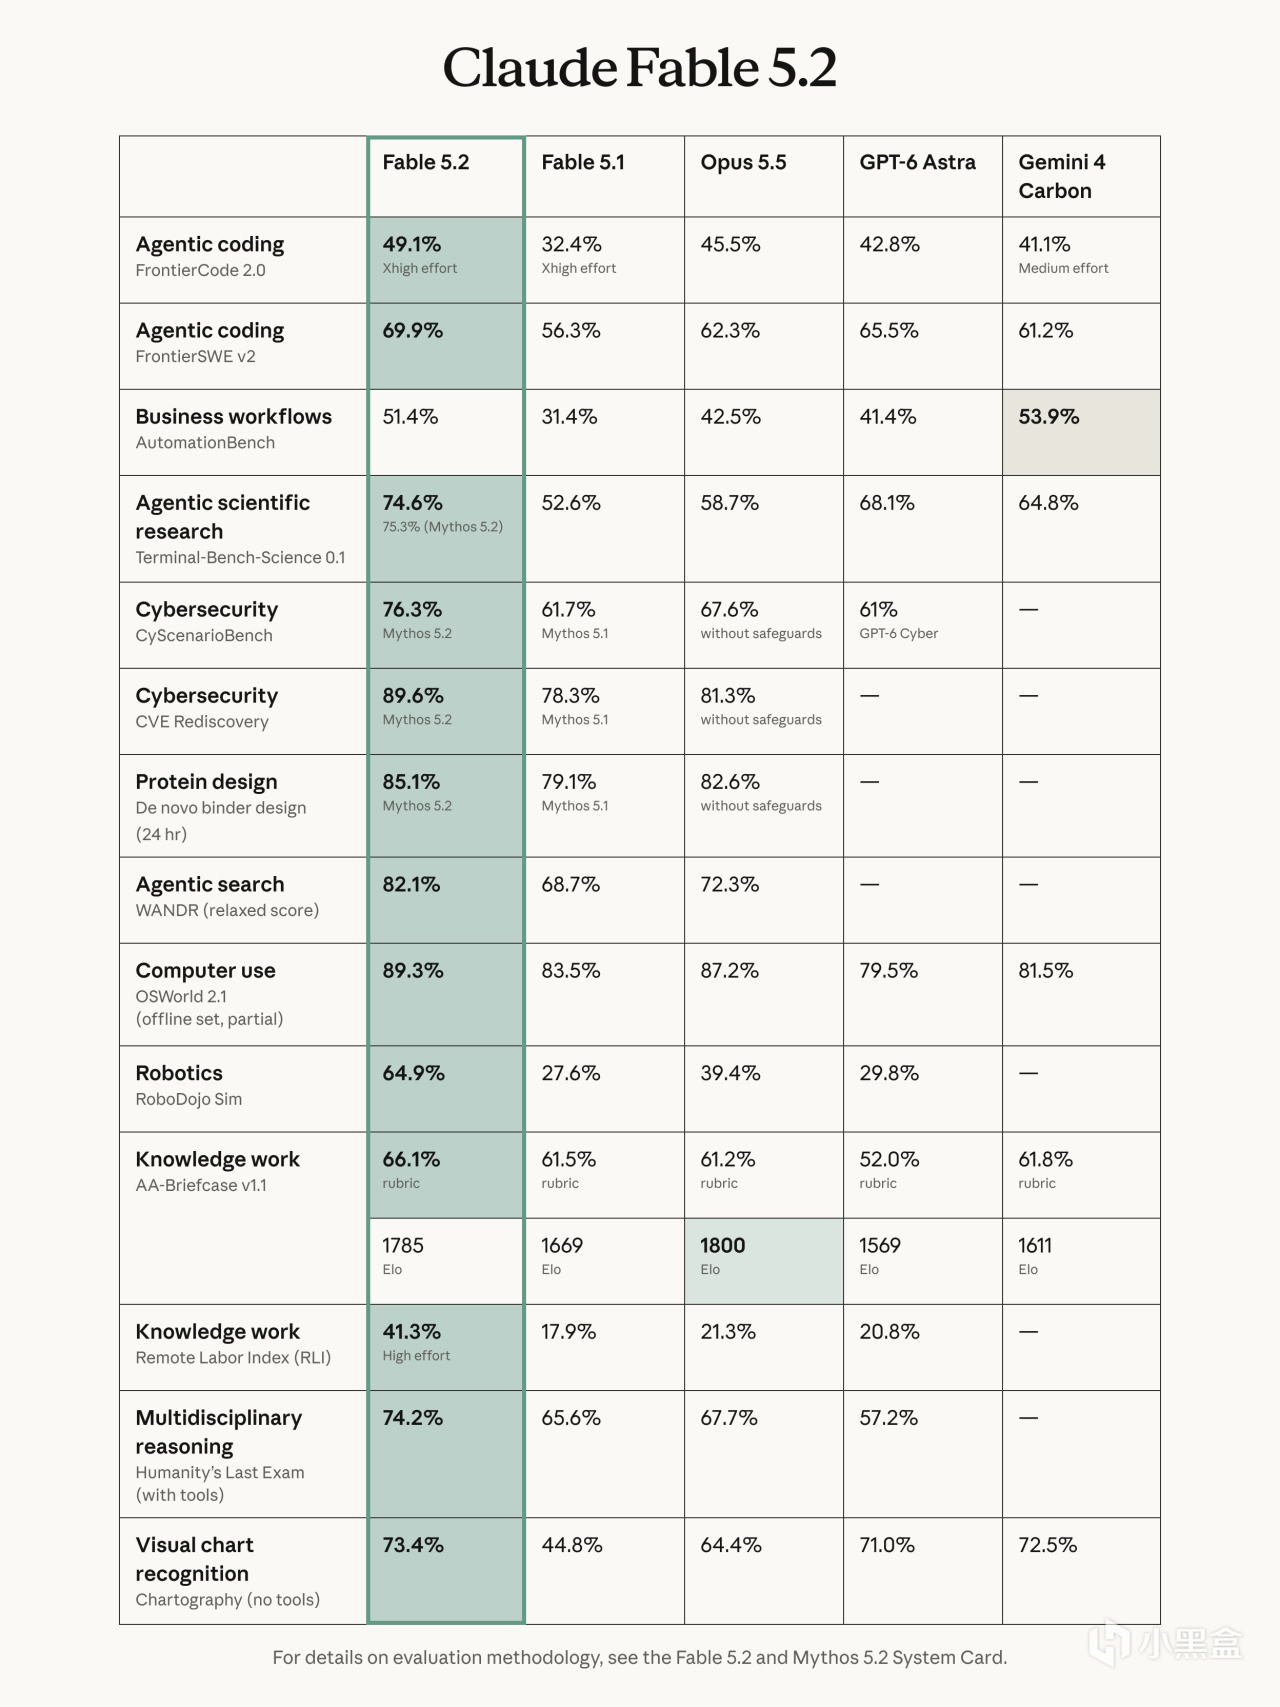
咱們把這十幾項數據拆成幾個關鍵賽道來看:
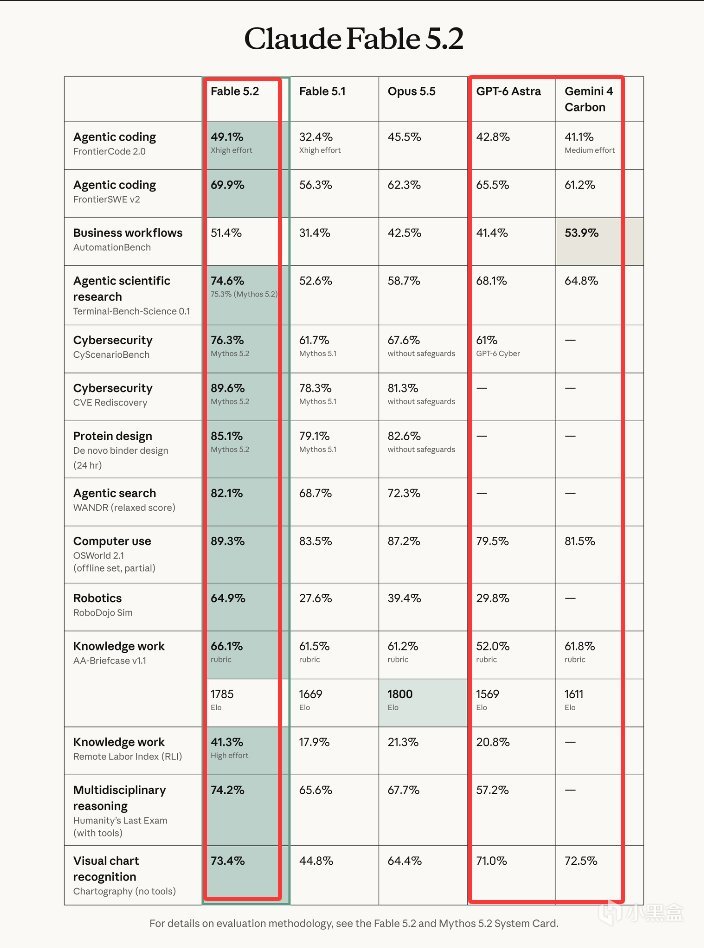
1. 智能體編碼與軟件工程:全面壓制
FrontierCode 2.0:Fable 5.2(Xhigh 檔位)拿到49.1%,不僅比前代 Fable 5.1(32.4%)暴漲 16.7 個百分點,也穩穩壓過 Opus 5.5(45.5%)、GPT-6 Astra(42.8%)和 Gemini 4 Carbon(41.1%)。
FrontierSWE v2:Fable 5.2 拿下69.9%,逼近七成大關,領先第二名 GPT-6 Astra(65.5%)4.4 個百分點,比 Opus 5.5(62.3%)和 Gemini 4 Carbon(61.2%)高出七八個百分點。
2. 網安攻防與蛋白質設計:Mythos 5.2 一騎絕塵
在需要解除常規護欄的專項測試裏,表格專門列出了 Mythos 5.2 的成績:
CyScenarioBench(網絡安全場景基準):Mythos 5.2 拿到76.3%,比無護欄版 Opus 5.5(67.6%)高出近 9 個百分點,更是甩開專門的 GPT-6 Cyber(61%)超過 15 個百分點。
CVE Rediscovery(真實 CVE 漏洞重發現):Mythos 5.2 直接幹到了89.6%(對比無護欄版 Opus 5.5 的 81.3% 和 Mythos 5.1 的 78.3%)。接近九成的漏洞重現率,也難怪官方只敢對認證安全機構開放。
De novo binder design(24 小時從頭設計蛋白質結合物):Mythos 5.2 達到85.1%,刷新了同賽道的最高紀錄(無護欄版 Opus 5.5 爲 82.6%,Mythos 5.1 爲 79.1%)。
3. 計算機操作與機器人控制:最高拉開兩倍以上分差
OSWorld 2.1(計算機操作):Fable 5.2 達到89.3%,領先 Opus 5.5(87.2%)和 Gemini 4 Carbon(81.5%),比 GPT-6 Astra(79.5%)整整高出近 10 個百分點。
RoboDojo Sim(機器人控制模擬):這是整張表裏分差最誇張的一項——Fable 5.2 拿到了64.9%,而 GPT-6 Astra 只有29.8%,前代 Fable 5.1 是27.6%,Opus 5.5 爲39.4%。也就是說在機器人控制場景下,Fable 5.2 的得分超過了 GPT-6 Astra 的兩倍以上。
4. 科研、多學科推理、遠程勞務與無工具看圖
Terminal-Bench-Science 0.1(智能體科研任務):Fable 5.2 拿到74.6%(Mythos 5.2 更是達到75.3%),大幅拋離 GPT-6 Astra(68.1%)、Gemini 4 Carbon(64.8%)和 Opus 5.5(58.7%)。
Humanity's Last Exam(帶工具多學科綜合推理):在這場“人類終極考試”中,Fable 5.2 拿下74.2%,比 Opus 5.5(67.7%)高 6.5 個百分點,比 GPT-6 Astra(57.2%)足足高出 17 個百分點。
Remote Labor Index(RLI 遠程勞務指數):Fable 5.2(High 檔位)衝到41.3%,差不多是 Opus 5.5(21.3%)和 GPT-6 Astra(20.8%)的兩倍,比 Fable 5.1(17.9%)翻了一倍還多。
Chartography(無工具純視覺圖表識別):在不調用代碼解釋器等任何外部工具的前提下,純靠肉眼看圖,Fable 5.2 拿到73.4%,比前代 Fable 5.1(44.8%)暴漲 28.6 個百分點,同時超越 Gemini 4 Carbon(72.5%)和 GPT-6 Astra(71.0%)。
五、思考檔位與成本深扒:High 檔位追平滿血 Opus 5.5,花銷直接砍半
很多經常跑 Agent 的開發者最怕一件事:模型跑分確實高,但全是用十倍 Token 硬砸出來的。爲了回應這個顧慮,Claude 官方專門放出了一組 不同思考力度檔位(Effort level:Low / Med / High / Xhigh / Max)與單任務成本(Cost per task/attempt) 的實測曲線圖。
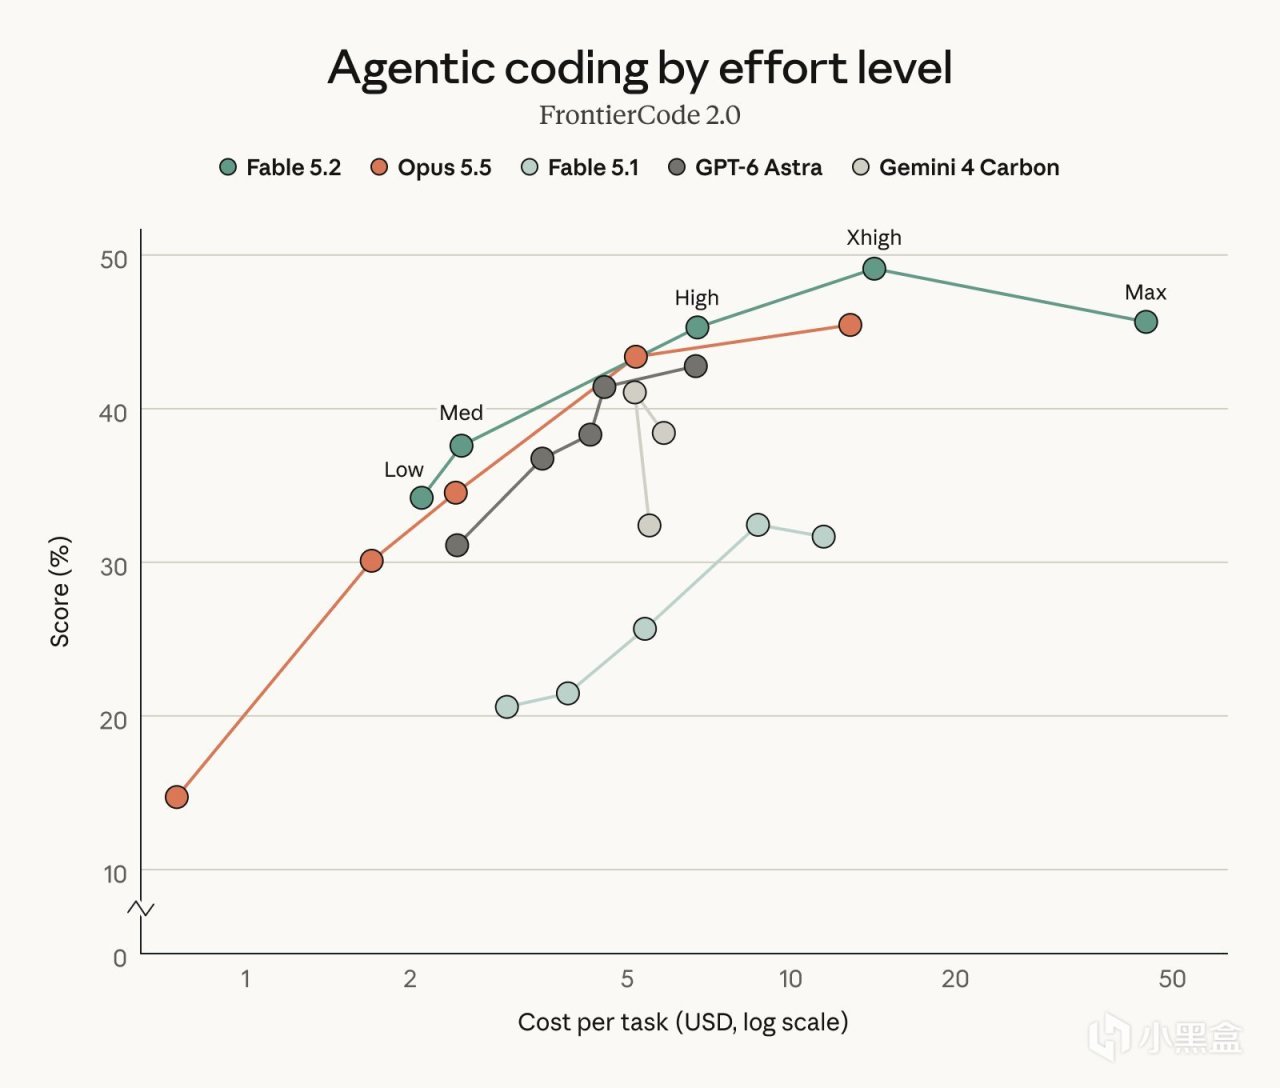
先看最關鍵的這張 FrontierCode 2.0 智能體編碼曲線圖:
當把 Fable 5.2 設在High(高)檔位時,它的編碼得分(約 45.5%)就已經和Opus 5.5 開啓 Max(極限)檔位打了個平手;但往橫軸的成本刻度上一看,Fable 5.2 High 檔位的單任務花費只有 Opus 5.5 Max 檔位的大約一半(約 6 到 7 美元 vs 13 美元以上)。
如果把 Fable 5.2 往上推到Xhigh(超高)檔位,單任務成本來到 14 美元左右,得分直接衝上49.1%,拿下目前已發佈所有模型裏的最高分。
圖裏還有一個很有意思的細節:在 FrontierCode 2.0 測試中,如果你把 Fable 5.2 硬拉到最右邊的Max 檔位,單任務成本飆到近 50 美元,得分反而回落到了 46% 左右。這也說明在複雜編碼任務裏,Xhigh 檔位纔是真正的甜點區,無腦拉滿 Max 反而可能因爲過度發散而浪費預算。
再看官方同步放出的另外三項檔位效率曲線(WANDR 智能體搜索、BenchCAD 2.1 硬件工程、Chartography 視覺圖表識別):
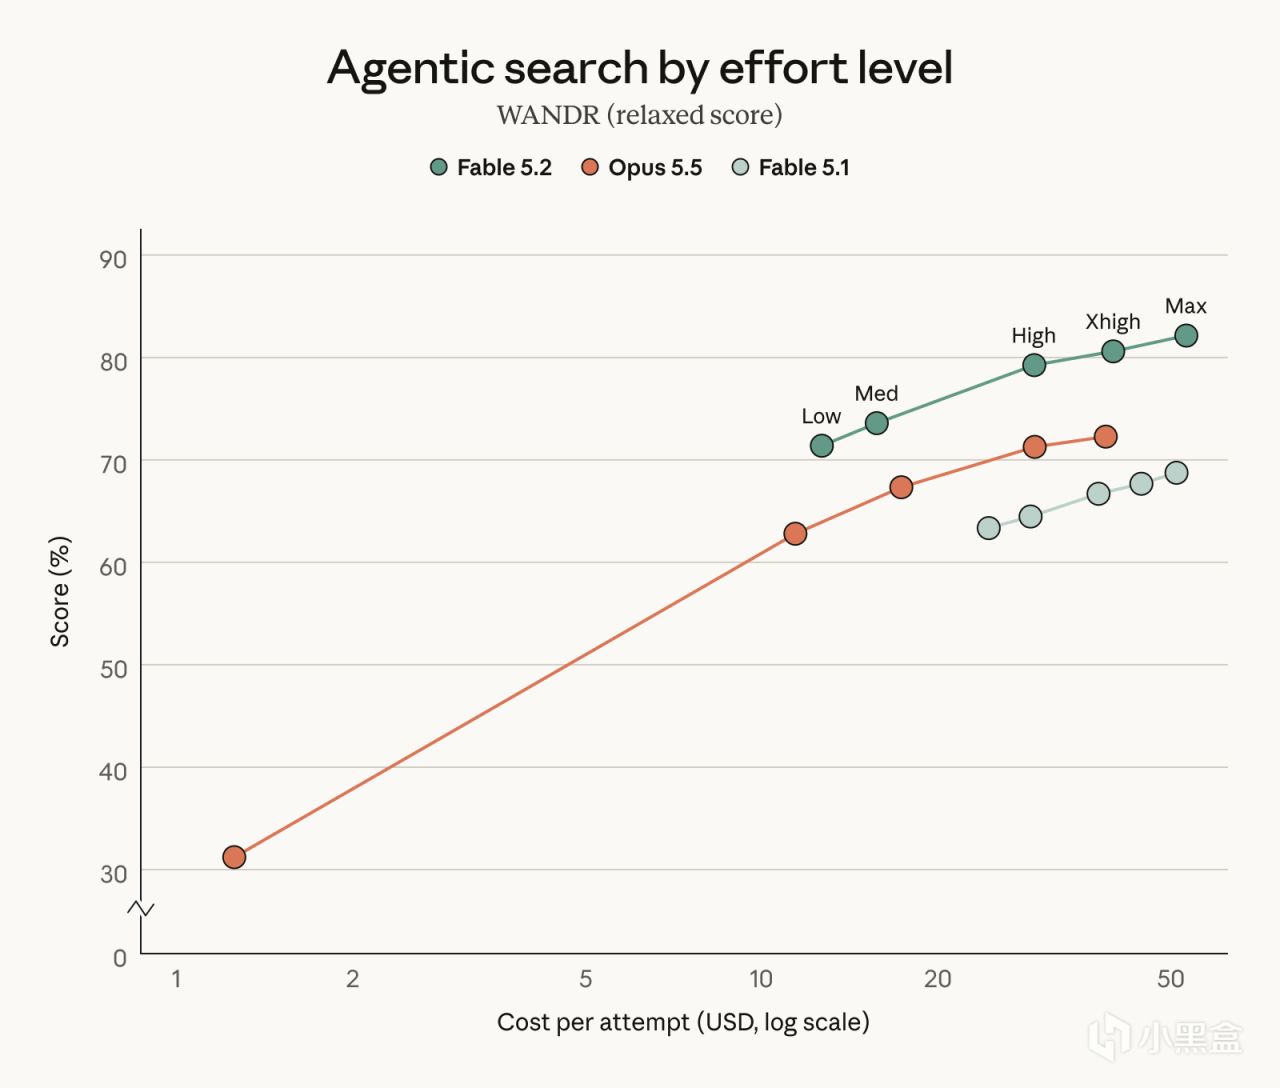
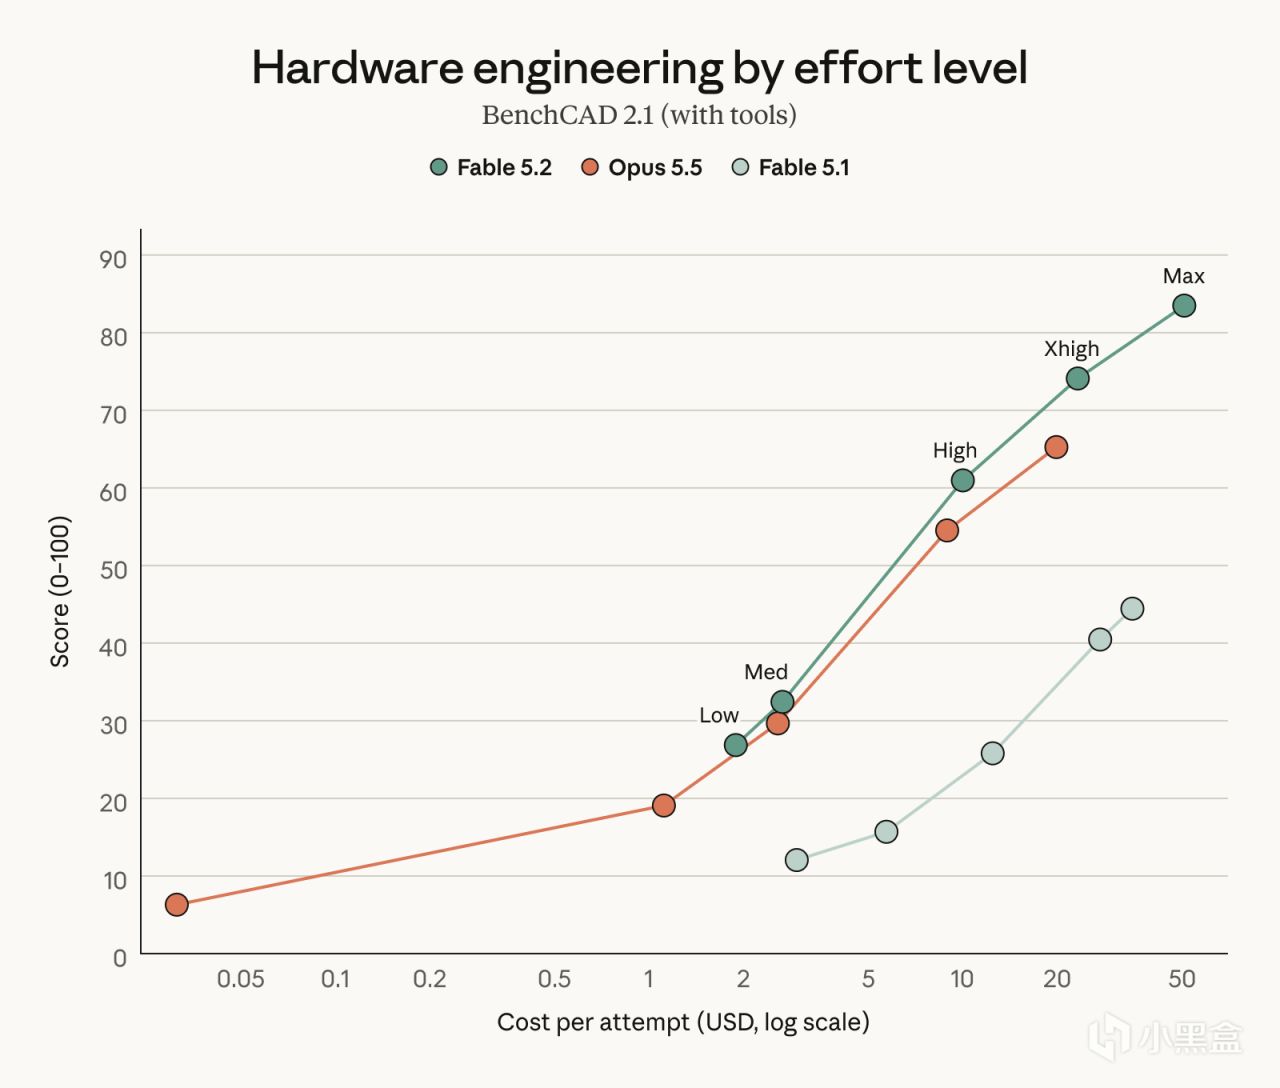
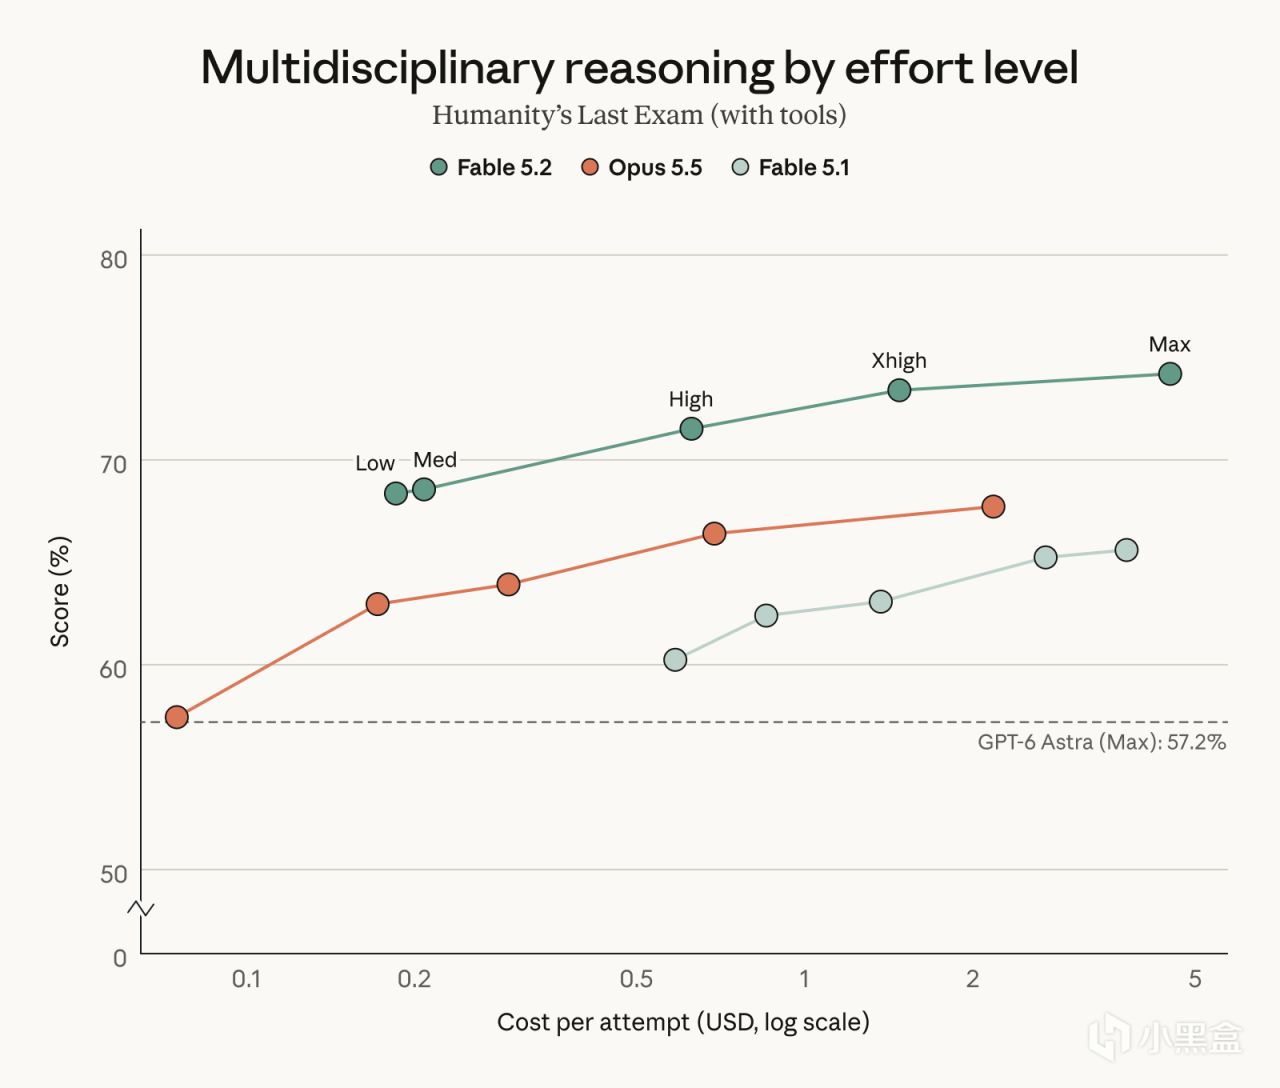
在這三張圖裏,代表 Fable 5.2 的綠色折線從 Low、Med、High、Xhigh 到 Max 全程壓在橙色 Opus 5.5 和淺色 Fable 5.1 的上方:
在WANDR 智能體搜索中,Fable 5.2 光是開Low 檔位(單次成本約 13 美元),得分就已經超過 71%,基本追平了 Opus 5.5 開到 High/Max 檔位的水平;拉到 Max 檔位則一路漲到82.1%。
在BenchCAD 2.1 硬件工程測試中,差距更加離譜:Opus 5.5 哪怕把預算拉滿也才摸到 51% 左右,而 Fable 5.2 在Low 檔位就接近 50%,開到Max 檔位直接幹到了近70%。
在Chartography 視覺圖表識別裏,單次嘗試成本還不到0.2 美元,Fable 5.2 在 Low 檔位就能拿到約 68%,到 High 檔位以上穩定在73.4%,比同成本下的 Opus 5.5 高出近 10 個百分點。
官方也順帶交代了客戶端的默認設置:在 Claude 網頁/桌面端應用和 Claude Code 裏,系統默認開啓的是 Medium(中等)檔位,兼顧日常響應速度和額度消耗;遇到硬骨頭時再手動切到 High 或 Xhigh 檔位。
六、速度、價格與選型建議:日常開發到底要不要換?
最後把大家關心的速度、API 定價、訂閱權益以及官方選型建議彙總一下:
輸出提速 30%,說話更乾脆: 參與早期測試的開發者普遍反饋,5.2 系列的溝通表達比過去的 Fable 和 Mythos 模型清晰得多,少了很多繞彎子的車軲轆話。同時它的生成輸出速度比 Fable 5.1 和 Mythos 5.1 提升了最高 30%;如果對響應延遲要求極高,API 裏還提供了最高2.5 倍速的 Fast 模式可選。
API 調用降價 20%: Fable 5.2 的 API 標準定價下調到了輸入 8 美元 / 百萬 Token、輸出 40 美元 / 百萬 Token,相比上一代降了 20%,配合前面提到的高檔位效率提升,單任務實際開銷降幅還要更大。
訂閱用戶怎麼用?Pro 用戶有限時福利:
Max 和 Ultra 訂閱用戶:直接解鎖 Fable 5.2,無時間限制;
Pro 訂閱用戶:官方這次給 Pro 用戶開放了Fable 5.2 的限時使用權限,一直持續到 11 月 16 日。手裏有 Pro 賬號的小夥伴,這幾天不妨抓緊把攢着的複雜項目拿出來跑一跑;
Mythos 5.2:僅面向通過驗證的網絡安全與生物醫學研究機構開放申請。
最實在的選型建議——“日常用 Opus 5.5,硬仗上 Fable 5.2”: 儘管 Fable 5.2 跑分殺瘋了,但 Anthropic 官方給出的使用建議非常實在:日常普通的代碼編寫、常規文檔處理和一般工作負載,繼續用 Opus 5.5 就行。畢竟在常規知識工作(如 AA-Briefcase Elo 評分)上 Opus 5.5 依然極穩,價格和額度消耗也更友好。只有當你碰上真正棘手的硬骨頭——比如跨語言遷移大型生產代碼庫、高複雜度算法與數學推導、硬件工程建模,或者 Opus 5.5 反覆改不對的深層架構 Bug 時,直接切到 Fable 5.2 並掛上 High / Xhigh 檔位,它纔是目前真正的版本答案。
不過,最後還是有個老生常談的問題,你能穩定用上claude嗎?(滑稽)
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com