今天凌晨,Anthropic 没搞任何预热直播和倒计时,直接在官网、客户端和 API 里同步甩出了两款重磅王牌模型——Claude Fable 5.2 和 Claude Mythos 5.2。
前两天大家还在围观各家新模型的灰度测试,结果 Claude 这一记闷棍下来,不仅把 ARC-AGI-3 标准框架的历史最高分给破了,还在十多项硬核基准测试里把自家的 Opus 5.5、隔壁的 GPT-6 Astra 和谷歌的 Gemini 4 Carbon 挨个压了一头。今天咱们就把官方放出的实测数据、多智能体极限实验以及社区技术博主的深度拆解揉在一起,带大家看看这次 5.2 系列到底猛在哪。
一、Fable 5.2 和 Mythos 5.2 到底有什么区别?
Fable 5.2 和 Mythos 5.2 底层共用的是同一个基座模型,定位非常纯粹:就是专门用来啃各个领域里最 棘手、最硬核的技术工程和科研难题。
那为什么要拆成两个版本?核心在于安全护栏与开放权限:
Claude Fable 5.2:配备了完整的强安全护栏,面向所有付费用户开放(包括客户端、API 和 Claude Code),主攻高难度代码工程、数学推理、多模态视觉和智能体任务。
Claude Mythos 5.2:解除了部分高敏感领域的安全限制,专门面向
通过资质审核的网络安全与生物医学研究机构
开放。像底层漏洞挖掘、攻击场景推演、从头设计蛋白质结构这类容易触发普通模型拒答的深水区科研任务,就是 Mythos 5.2 的主场。
另外在正式上线前,这套模型也经过了英国 AI 安全研究所(AISecurityInst)、FrontierDesign2 和 METR_Evals 等多家外部独立机构的对齐与安全测评,在绝大多数对齐指标上持平或优于前代。
二、1000 个 Agent 协作 30 小时,完全形式化“费马大定理”
枯燥的跑分表咱们往后放一放,先看这次发布里最让人头皮发麻的一项极限测试——用多智能体集群去攻克数学界大名鼎鼎的**“费马大定理(Fermat's Last Theorem)”形式化证明**。
所谓“形式化证明”,不是让 AI 用自然语言写一段数学综述,而是要把整个定理极其庞大复杂的数学推导过程,一步不差地翻译成计算机可以逐行、逐逻辑节点严格校验的标准化形式语言。只要中间有一处逻辑断层或语法对不上,编译校验就会直接卡死。
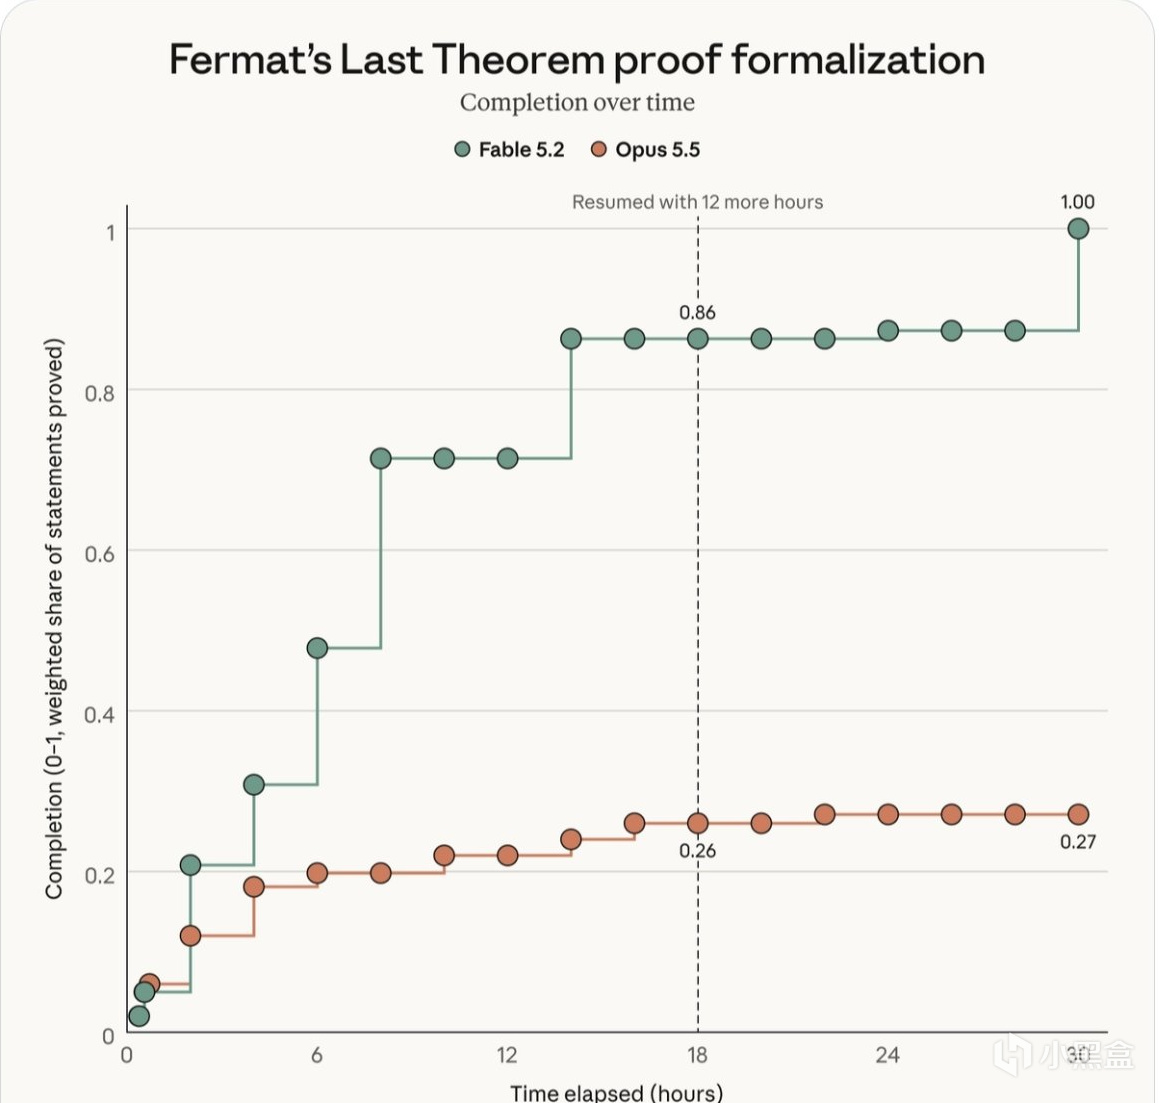
结合官方放出的实验曲线解读,这场测试直接拉起了 **1000 个 Fable 5.2 智能体(Agent)**组成协作系统,同时拿自家的当家主力 Opus 5.5 在完全相同的实验条件下做对照。看上面这张时间进度图(横轴为运行小时数,纵轴为已证明语句的加权占比),两代模型的差距非常直观:
前 18 小时阶段:在运行到第 18 小时(图中竖虚线处)时,Opus 5.5 的完成度只推到了26%(0.26);而由 1000 个 Fable 5.2 组成的智能体团队,进度已经一路狂飙到86%(0.86)。
追加 12 小时续跑(18 至 30 小时):当实验为双方同时追加 12 个小时继续攻坚时,Opus 5.5 几乎撞上了能力墙,在漫长的 12 个小时里只艰难往前蹭了 1 个百分点,最终在 30 小时结束时停滞在27%;反观 Fable 5.2 协作系统没有出现长链路崩溃,在30 小时内拿下了 100%(1.00)完全形式化证明。
除了这场数学大考,Anthropic 内部还披露了一个很接地气的工程实绩:目前 Anthropic 内部超过 90% 的核心代码库变更已经由 Claude 编写;而在真实工程测试中,Fable 5.2 曾独立把一套核心生产服务从 Python 完整迁移重构到 Rust,直接让该服务的启动速度暴涨了 26 倍。
这两个实证摆在一起,传递出的信号很明确:Fable 5.2 升级的重点不再是“单轮对话写个贪吃蛇小游戏”,而是超长周期的多智能体协同、超大规模代码库的跨语言重构,以及死磕到底的严密逻辑推演。
三、ARC-AGI 权威验证:标准框架 81.2% 刷新历史最高纪录
看完了工程实战,再看专门用来防“刷题背答案”、考验模型面对陌生规则时抽象推理能力的权威榜单 ARC-AGI。
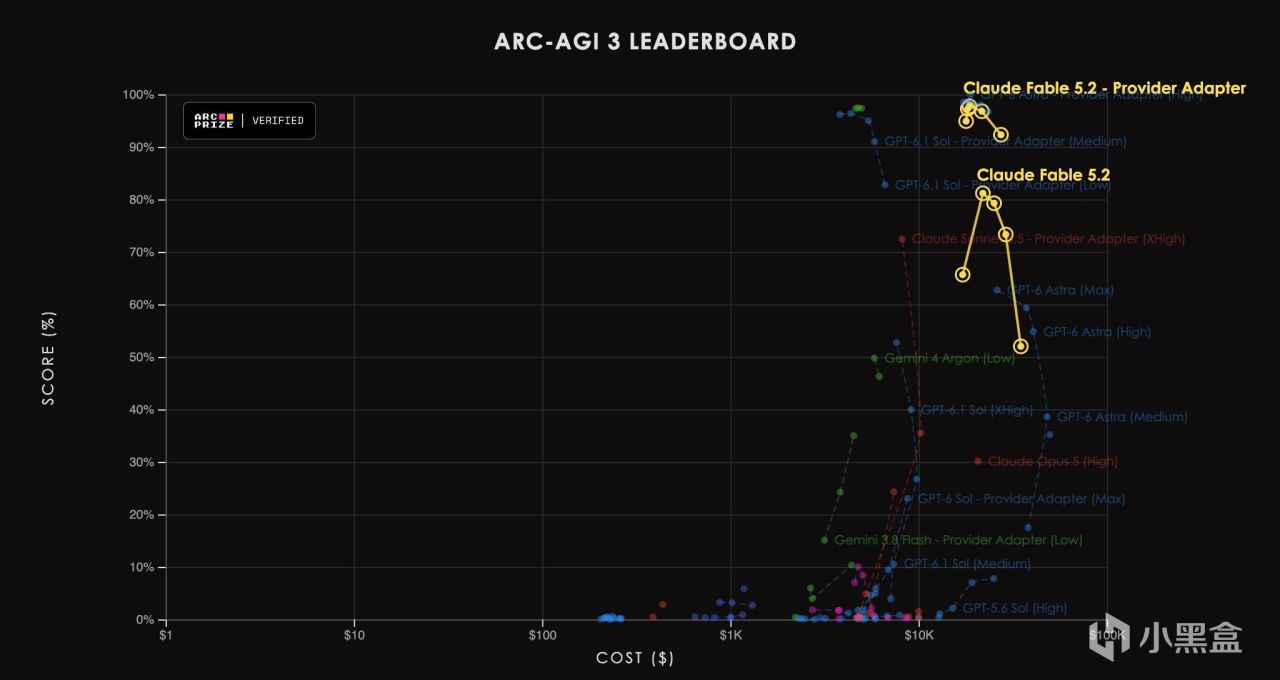
ARC Prize 官方第一时间放出了 Claude Fable 5.2 的核验成绩单(Verified):
ARC-AGI-1:得分98.5%,单任务成本低至$0.36;
ARC-AGI-2:得分93.8%,单任务成本仅$0.98;
ARC-AGI-3(厂商适配器框架 Provider Adapter harness):轰下97.7%的超高分(总测试成本约 $18.6K),直接顶到了整张排行榜的最顶端;
ARC-AGI-3(标准测试框架 Standard harness):在不借助特定厂商适配器的标准测试下,拿下81.2%(总测试成本约 $21.9K),正式刷新了 ARC-AGI-3 标准框架下的历史最高分纪录。
对照上面这张黑底散点图(横轴是测试花费,纵轴是准确率得分)能看得更清楚:在右上角逼近 100% 天花板的位置,黄色圆圈标注的 Claude Fable 5.2 - Provider Adapter 稳居第一梯队最高点;而在下方代表标准框架的黄色折线 Claude Fable 5.2 上,它的最高点冲到了 81.2%,把同场竞技的 GPT-6 Astra (Max)(60% 出头)、GPT-6 Astra (High)(约 55%)、Claude Sonnet 5.5 - Provider Adapter (XHigh)(约 72%)、Gemini 4 Argon (Low)(50%)以及 GPT-6.1 Sol 各档位远远甩在身后。
四、13 项基准全维度横评:正面硬刚 GPT-6 Astra 与 Gemini 4 Carbon
除了 ARC-AGI,Anthropic 官方这次直接晒出了一张涵盖 13 个大项的硬核成绩单,把 Fable 5.2 / Mythos 5.2 与前代 Fable 5.1、自家主力 Opus 5.5、OpenAI 的 GPT-6 Astra 以及谷歌的 Gemini 4 Carbon 放在同一张表里做横向对比。
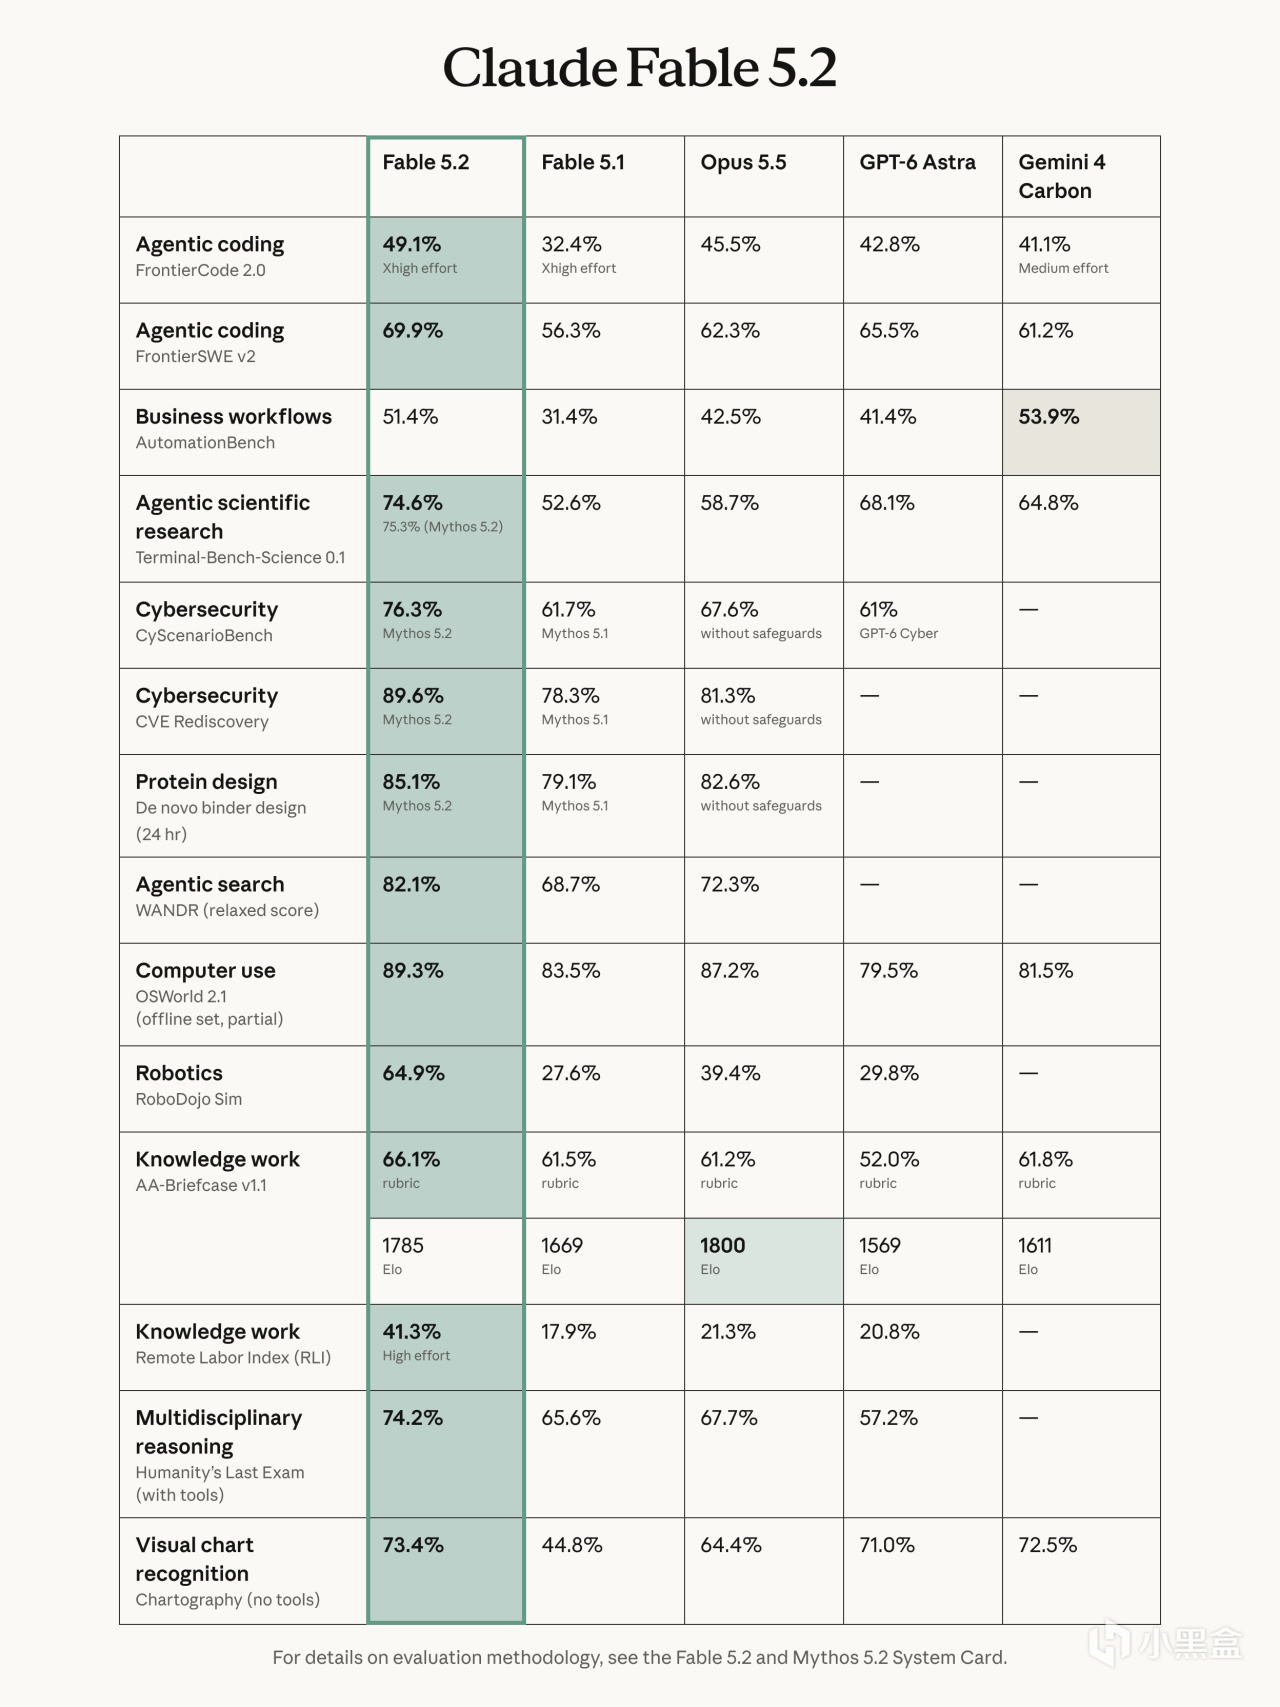
咱们把这十几项数据拆成几个关键赛道来看:
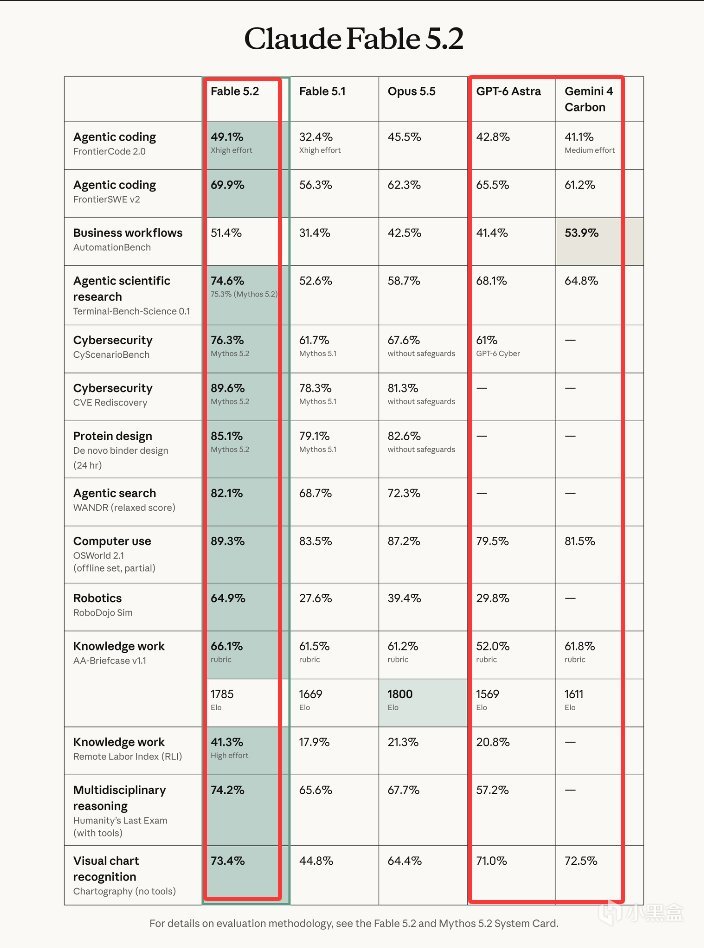
1. 智能体编码与软件工程:全面压制
FrontierCode 2.0:Fable 5.2(Xhigh 档位)拿到49.1%,不仅比前代 Fable 5.1(32.4%)暴涨 16.7 个百分点,也稳稳压过 Opus 5.5(45.5%)、GPT-6 Astra(42.8%)和 Gemini 4 Carbon(41.1%)。
FrontierSWE v2:Fable 5.2 拿下69.9%,逼近七成大关,领先第二名 GPT-6 Astra(65.5%)4.4 个百分点,比 Opus 5.5(62.3%)和 Gemini 4 Carbon(61.2%)高出七八个百分点。
2. 网安攻防与蛋白质设计:Mythos 5.2 一骑绝尘
在需要解除常规护栏的专项测试里,表格专门列出了 Mythos 5.2 的成绩:
CyScenarioBench(网络安全场景基准):Mythos 5.2 拿到76.3%,比无护栏版 Opus 5.5(67.6%)高出近 9 个百分点,更是甩开专门的 GPT-6 Cyber(61%)超过 15 个百分点。
CVE Rediscovery(真实 CVE 漏洞重发现):Mythos 5.2 直接干到了89.6%(对比无护栏版 Opus 5.5 的 81.3% 和 Mythos 5.1 的 78.3%)。接近九成的漏洞重现率,也难怪官方只敢对认证安全机构开放。
De novo binder design(24 小时从头设计蛋白质结合物):Mythos 5.2 达到85.1%,刷新了同赛道的最高纪录(无护栏版 Opus 5.5 为 82.6%,Mythos 5.1 为 79.1%)。
3. 计算机操作与机器人控制:最高拉开两倍以上分差
OSWorld 2.1(计算机操作):Fable 5.2 达到89.3%,领先 Opus 5.5(87.2%)和 Gemini 4 Carbon(81.5%),比 GPT-6 Astra(79.5%)整整高出近 10 个百分点。
RoboDojo Sim(机器人控制模拟):这是整张表里分差最夸张的一项——Fable 5.2 拿到了64.9%,而 GPT-6 Astra 只有29.8%,前代 Fable 5.1 是27.6%,Opus 5.5 为39.4%。也就是说在机器人控制场景下,Fable 5.2 的得分超过了 GPT-6 Astra 的两倍以上。
4. 科研、多学科推理、远程劳务与无工具看图
Terminal-Bench-Science 0.1(智能体科研任务):Fable 5.2 拿到74.6%(Mythos 5.2 更是达到75.3%),大幅抛离 GPT-6 Astra(68.1%)、Gemini 4 Carbon(64.8%)和 Opus 5.5(58.7%)。
Humanity's Last Exam(带工具多学科综合推理):在这场“人类终极考试”中,Fable 5.2 拿下74.2%,比 Opus 5.5(67.7%)高 6.5 个百分点,比 GPT-6 Astra(57.2%)足足高出 17 个百分点。
Remote Labor Index(RLI 远程劳务指数):Fable 5.2(High 档位)冲到41.3%,差不多是 Opus 5.5(21.3%)和 GPT-6 Astra(20.8%)的两倍,比 Fable 5.1(17.9%)翻了一倍还多。
Chartography(无工具纯视觉图表识别):在不调用代码解释器等任何外部工具的前提下,纯靠肉眼看图,Fable 5.2 拿到73.4%,比前代 Fable 5.1(44.8%)暴涨 28.6 个百分点,同时超越 Gemini 4 Carbon(72.5%)和 GPT-6 Astra(71.0%)。
五、思考档位与成本深扒:High 档位追平满血 Opus 5.5,花销直接砍半
很多经常跑 Agent 的开发者最怕一件事:模型跑分确实高,但全是用十倍 Token 硬砸出来的。为了回应这个顾虑,Claude 官方专门放出了一组 不同思考力度档位(Effort level:Low / Med / High / Xhigh / Max)与单任务成本(Cost per task/attempt) 的实测曲线图。
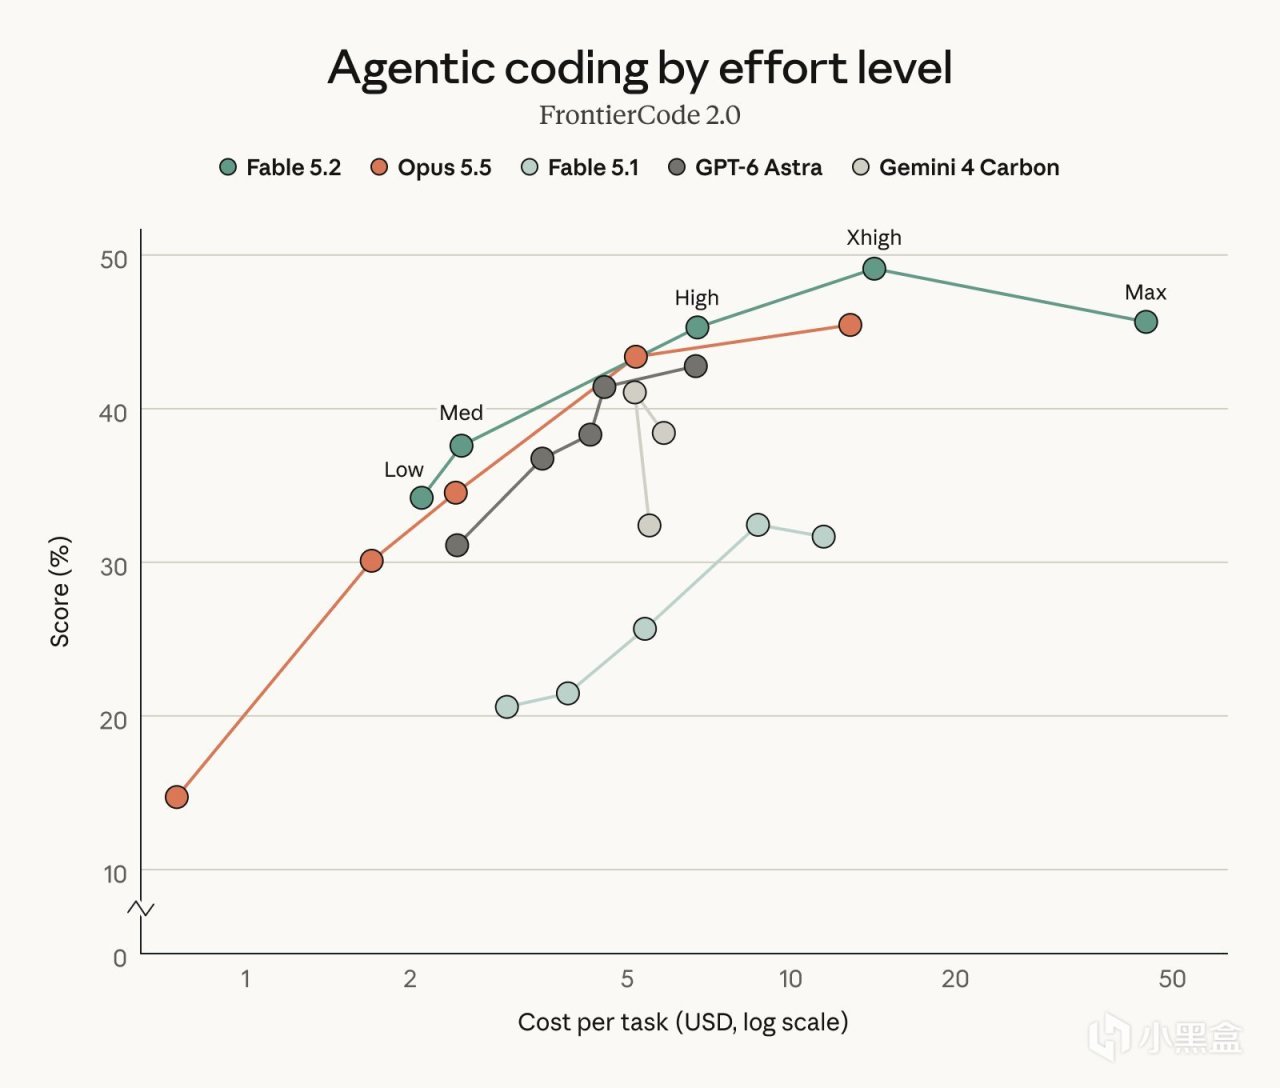
先看最关键的这张 FrontierCode 2.0 智能体编码曲线图:
当把 Fable 5.2 设在High(高)档位时,它的编码得分(约 45.5%)就已经和Opus 5.5 开启 Max(极限)档位打了个平手;但往横轴的成本刻度上一看,Fable 5.2 High 档位的单任务花费只有 Opus 5.5 Max 档位的大约一半(约 6 到 7 美元 vs 13 美元以上)。
如果把 Fable 5.2 往上推到Xhigh(超高)档位,单任务成本来到 14 美元左右,得分直接冲上49.1%,拿下目前已发布所有模型里的最高分。
图里还有一个很有意思的细节:在 FrontierCode 2.0 测试中,如果你把 Fable 5.2 硬拉到最右边的Max 档位,单任务成本飙到近 50 美元,得分反而回落到了 46% 左右。这也说明在复杂编码任务里,Xhigh 档位才是真正的甜点区,无脑拉满 Max 反而可能因为过度发散而浪费预算。
再看官方同步放出的另外三项档位效率曲线(WANDR 智能体搜索、BenchCAD 2.1 硬件工程、Chartography 视觉图表识别):
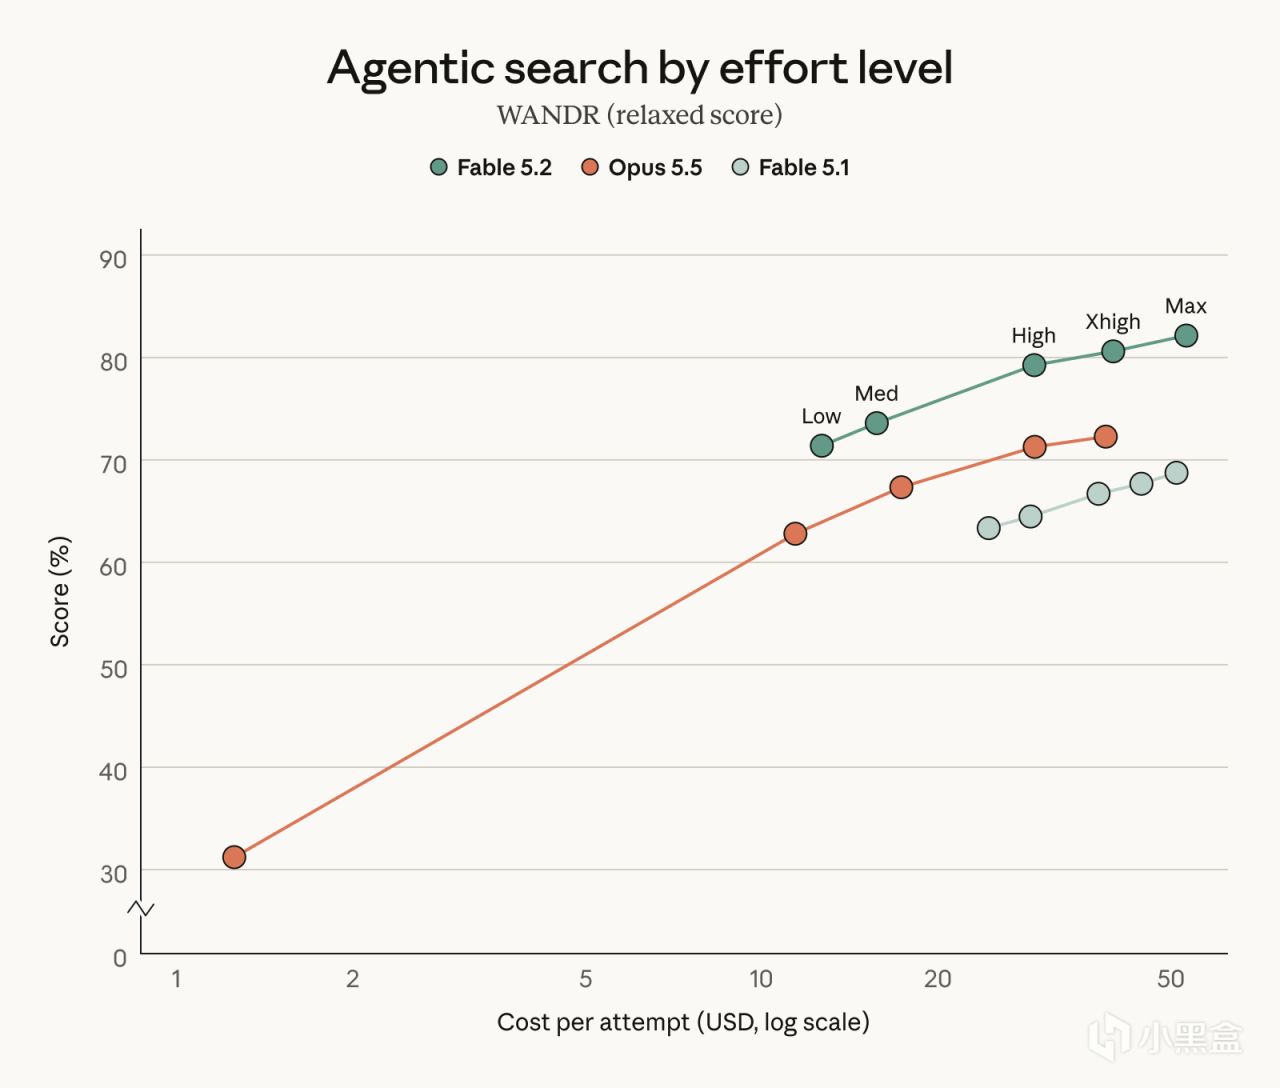
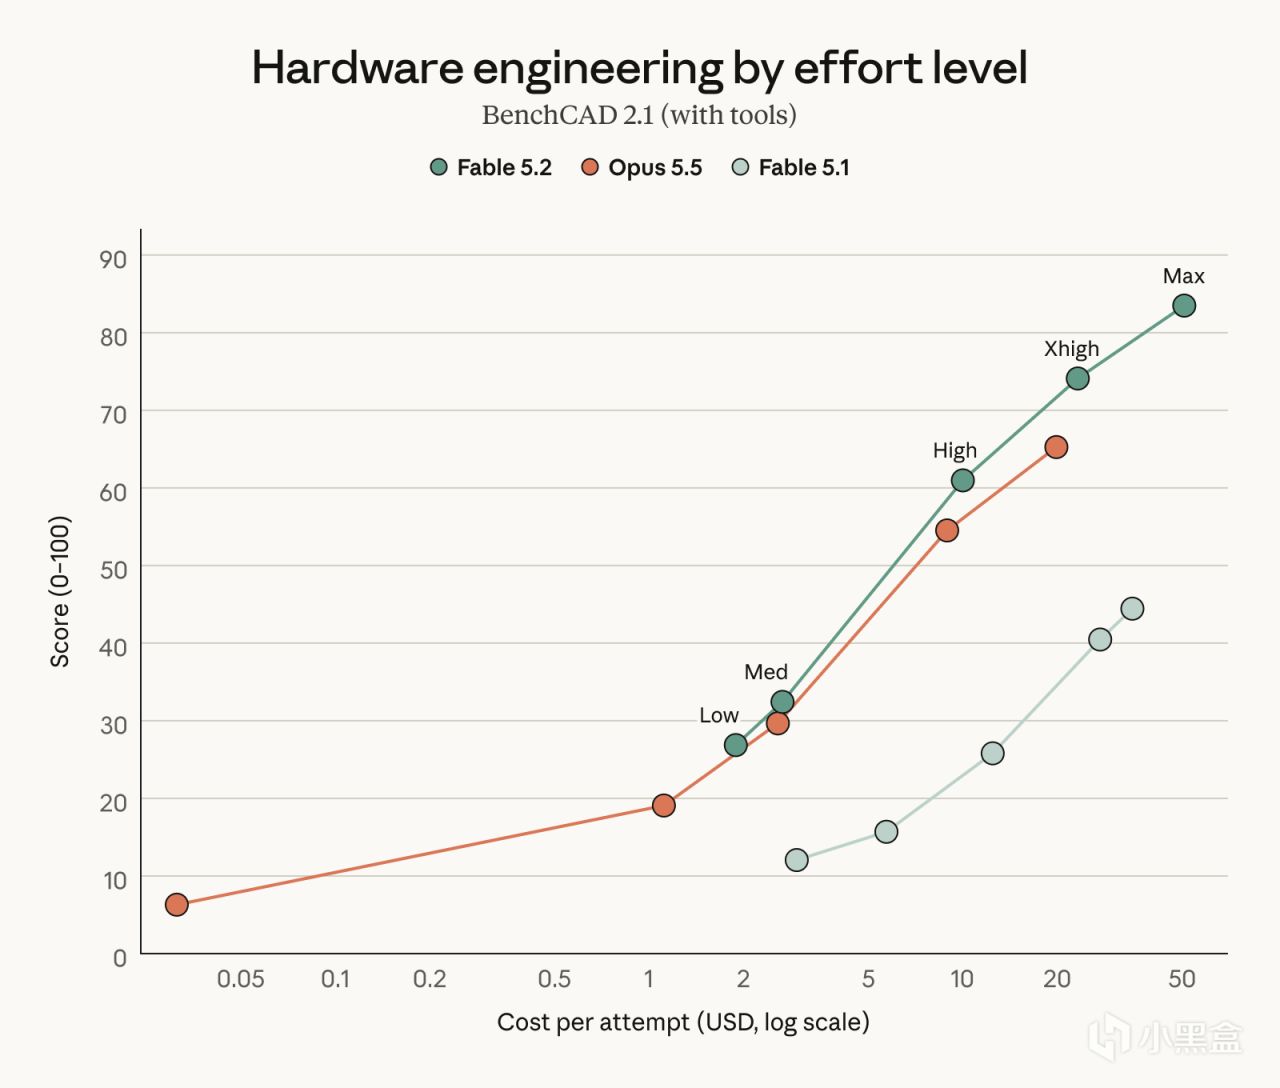
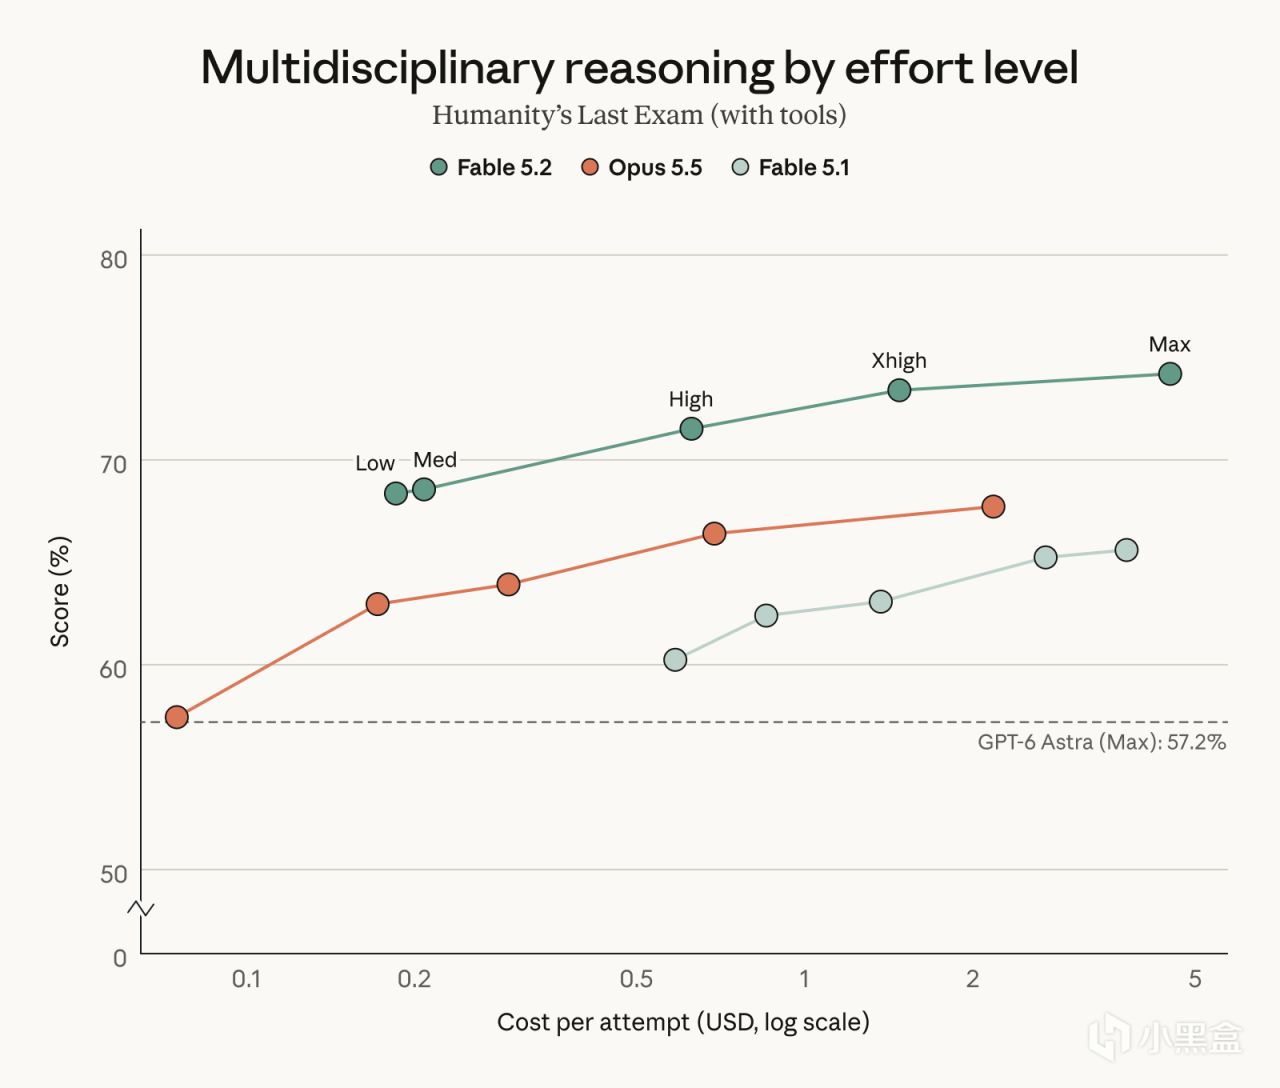
在这三张图里,代表 Fable 5.2 的绿色折线从 Low、Med、High、Xhigh 到 Max 全程压在橙色 Opus 5.5 和浅色 Fable 5.1 的上方:
在WANDR 智能体搜索中,Fable 5.2 光是开Low 档位(单次成本约 13 美元),得分就已经超过 71%,基本追平了 Opus 5.5 开到 High/Max 档位的水平;拉到 Max 档位则一路涨到82.1%。
在BenchCAD 2.1 硬件工程测试中,差距更加离谱:Opus 5.5 哪怕把预算拉满也才摸到 51% 左右,而 Fable 5.2 在Low 档位就接近 50%,开到Max 档位直接干到了近70%。
在Chartography 视觉图表识别里,单次尝试成本还不到0.2 美元,Fable 5.2 在 Low 档位就能拿到约 68%,到 High 档位以上稳定在73.4%,比同成本下的 Opus 5.5 高出近 10 个百分点。
官方也顺带交代了客户端的默认设置:在 Claude 网页/桌面端应用和 Claude Code 里,系统默认开启的是 Medium(中等)档位,兼顾日常响应速度和额度消耗;遇到硬骨头时再手动切到 High 或 Xhigh 档位。
六、速度、价格与选型建议:日常开发到底要不要换?
最后把大家关心的速度、API 定价、订阅权益以及官方选型建议汇总一下:
输出提速 30%,说话更干脆: 参与早期测试的开发者普遍反馈,5.2 系列的沟通表达比过去的 Fable 和 Mythos 模型清晰得多,少了很多绕弯子的车轱辘话。同时它的生成输出速度比 Fable 5.1 和 Mythos 5.1 提升了最高 30%;如果对响应延迟要求极高,API 里还提供了最高2.5 倍速的 Fast 模式可选。
API 调用降价 20%: Fable 5.2 的 API 标准定价下调到了输入 8 美元 / 百万 Token、输出 40 美元 / 百万 Token,相比上一代降了 20%,配合前面提到的高档位效率提升,单任务实际开销降幅还要更大。
订阅用户怎么用?Pro 用户有限时福利:
Max 和 Ultra 订阅用户:直接解锁 Fable 5.2,无时间限制;
Pro 订阅用户:官方这次给 Pro 用户开放了Fable 5.2 的限时使用权限,一直持续到 11 月 16 日。手里有 Pro 账号的小伙伴,这几天不妨抓紧把攒着的复杂项目拿出来跑一跑;
Mythos 5.2:仅面向通过验证的网络安全与生物医学研究机构开放申请。
最实在的选型建议——“日常用 Opus 5.5,硬仗上 Fable 5.2”: 尽管 Fable 5.2 跑分杀疯了,但 Anthropic 官方给出的使用建议非常实在:日常普通的代码编写、常规文档处理和一般工作负载,继续用 Opus 5.5 就行。毕竟在常规知识工作(如 AA-Briefcase Elo 评分)上 Opus 5.5 依然极稳,价格和额度消耗也更友好。只有当你碰上真正棘手的硬骨头——比如跨语言迁移大型生产代码库、高复杂度算法与数学推导、硬件工程建模,或者 Opus 5.5 反复改不对的深层架构 Bug 时,直接切到 Fable 5.2 并挂上 High / Xhigh 档位,它才是目前真正的版本答案。
不过,最后还是有个老生常谈的问题,你能稳定用上claude吗?(滑稽)
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com