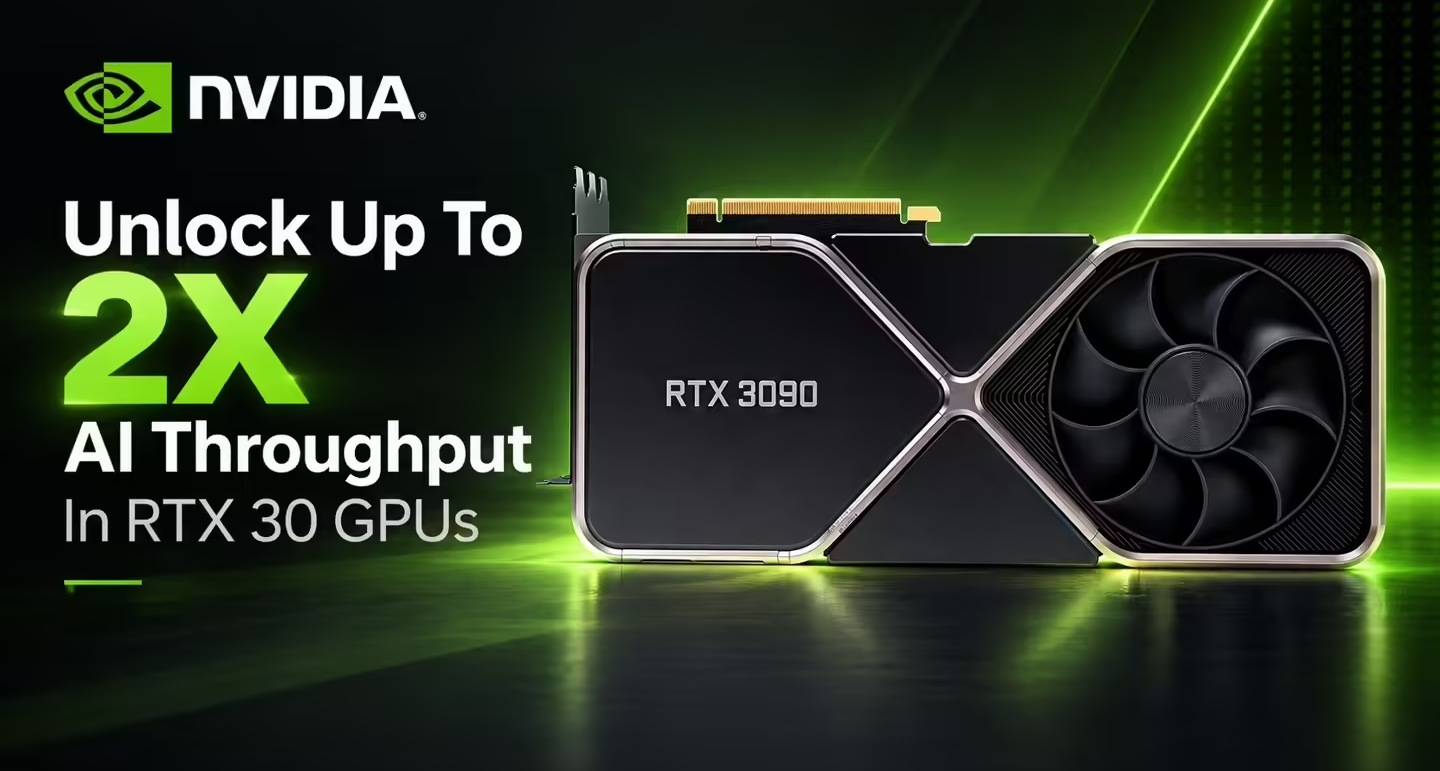
不少玩本地 AI 繪圖、跑大模型的朋友手裏都有一張 RTX30 系顯卡。30 系顯卡本身硬件是有更強 AI 算力的,只是英偉達給消費卡做了限制,還有大量尚未釋放的計算潛力。
最近 GitHub 上有兩個很火的開源項目:Linux 版 GPU Unlock、Windows 移植版 Windows GPU UNLOC,不用刷顯卡 BIOS、不用改硬件,可以解開這個限制,AI 畫圖、大模型推理速度直接上一個臺階!
Linux 版:GPU Unlock
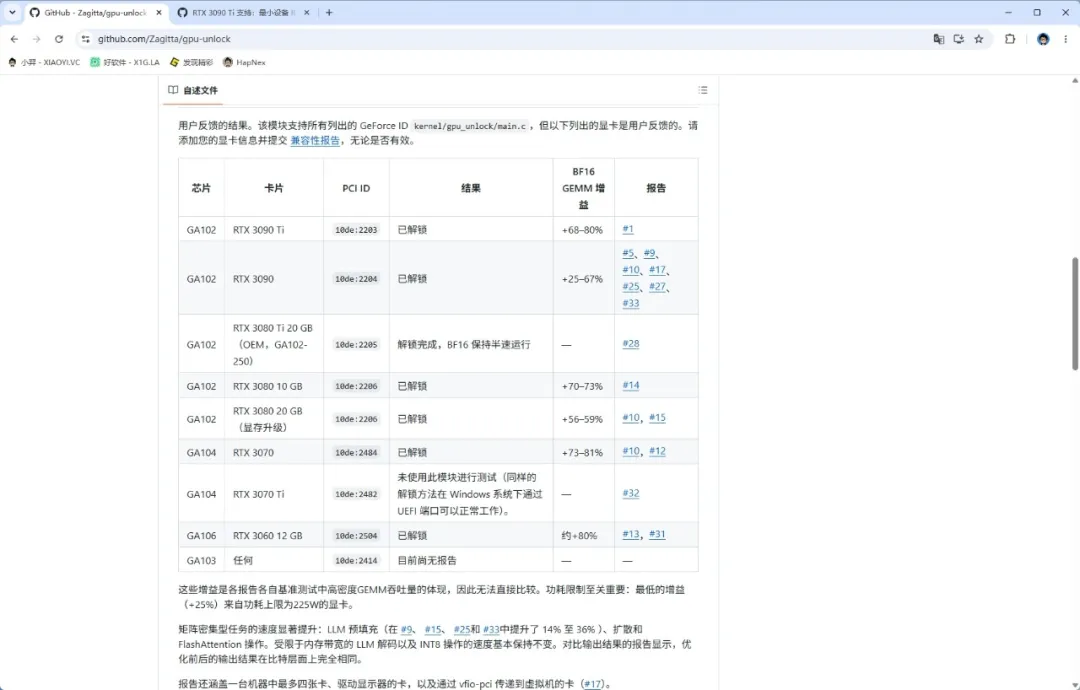
該項目由開發者 Zagitta 開發,技術源自早期針對 CMP 挖礦顯卡的固件解鎖研究,採用Linux 內核模塊的實現方案。
✅工作原理
工具會在英偉達官方顯卡驅動加載之前運行,修改顯卡硬件速度選擇寄存器,執行 FLR 功能級重置,之後再將顯卡交給原版 NVIDIA 驅動完成初始化。全程不需要刷寫顯卡 VBIOS,不用修改驅動文件,更新顯卡驅動後也無需重新打補丁,重啓系統後生效,不會對顯卡做永久性硬件改動。
解鎖針對的是特定指令限制:消費級安培顯卡在 FP32 累加的 FP16/BF16 張量核心運算,指令發射速率被人爲限制,解鎖後可以釋放硬件原生的計算能力,張量核心吞吐量最高近乎翻倍。支持 GPU 型號爲 GA102、GA103、GA104、GA106,覆蓋 RTX30 全系列大部分型號,但並非每一張顯卡都一定解鎖成功,存在個體兼容性差異。
✅實測性能表現
硬件跑分層面,RTX3090 Ti 在 450W 功耗牆下,矩陣運算性能大幅上漲;RTX3080 Ti 315W 功耗條件,BF16 吞吐量從 71.59 TFLOPS 提升至 113.98 TFLOPS;RTX3080 10GB 原廠 320W 功耗上限,FP16/BF16 性能由 65 TFLOPS 提升至 110‑113 TFLOPS。
真實 AI 應用測試:ComfyUI 圖像生成任務,MOSS‑Image、Qwen‑Image 等 BF16 負載吞吐量提升56%‑58%,圖片生成質量沒有發生改變;INT8 低精度模式幾乎沒有收益。
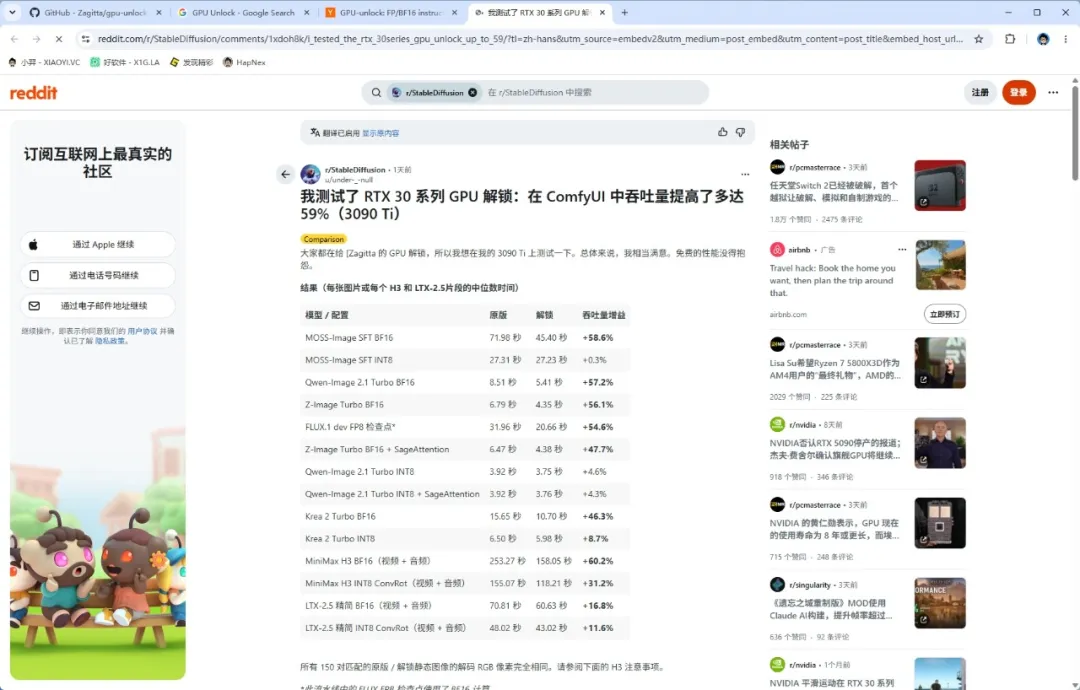
大語言模型 vLLM 推理中,提示詞預處理吞吐量提升約 33%,但是 token 生成速度幾乎不變 —— 大模型解碼瓶頸大多是顯存帶寬,而非張量核心算力,因此不是所有場景都會加速。
Windows 版:Windows GPU UNLOC
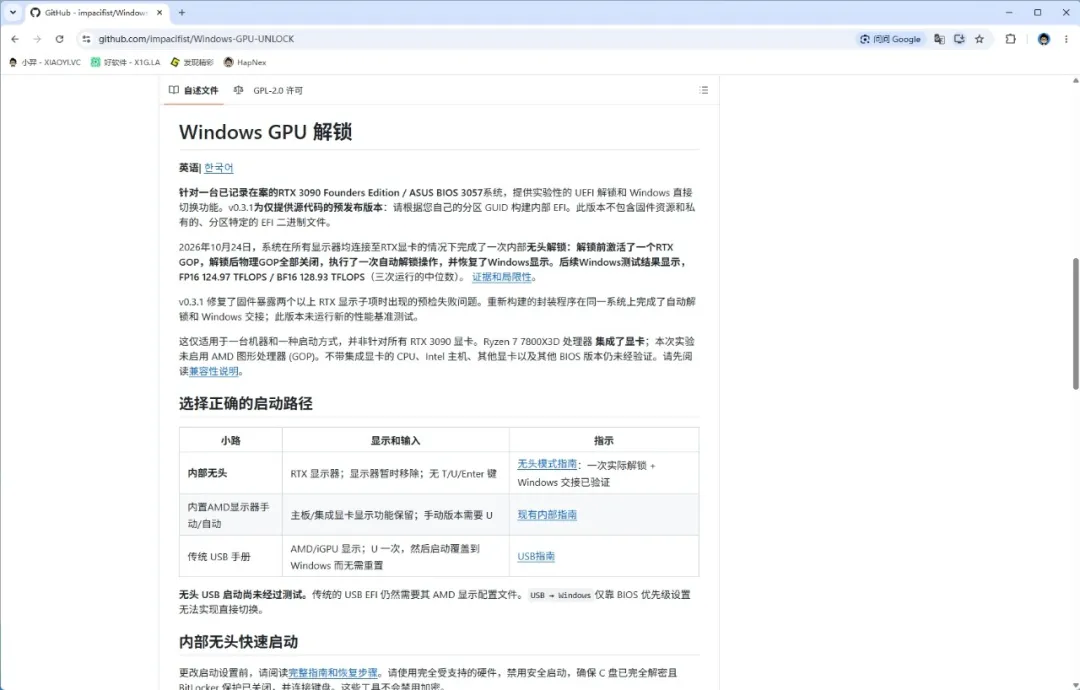
原版 GPU Unlock 依賴 Linux 內核模塊,Windows 沒有對應的內核執行環境,開發者 impacifist 完成了實驗性 Windows 平臺移植版本。注意:該版本尚屬於早期實驗產物,並非正式通用發行版,兼容性較差,僅少量硬件測試成功。
✅實現方式
放棄 Linux 內核模塊思路,改爲UEFI 層面執行解鎖邏輯,在系統啓動早期修改顯卡寄存器,完成 GPU 功能重置,之後交給 Windows 的英偉達驅動接管顯卡。
社區公開案例中,RTX3090 運行該方案後 BF16 計算吞吐量提升約 82.5%,跑分提升幅度甚至高於 Linux 版本,但成功案例非常有限。很多主板、顯卡組合會出現解鎖失敗、系統藍屏、顯卡識別異常等問題,普通用戶不建議在主力機直接使用。
最後總結
GPU Unlock 系列項目,證明 RTX30 安培消費顯卡硬件本身具備更強的 AI 計算能力,只是被軟件層面限制。
它不是萬能性能補丁,不會讓遊戲變快,但對於本地 AI 愛好者,以零硬件成本挖掘老卡的 AI 潛力,擁有很高的探索價值。如果你是 Windows 普通用戶,建議先蹲後續更新,別急着上車。老 30 顯卡再戰 AI,又多了一個玩法!
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com