Agent製作遊戲教程(三):獨狼的美術自救指南——AI製作美術資產的三種流派
本文依然基於我自己的獨立遊戲《碼農物語》開發時遇到的問題以及踩坑總結,乾貨較多,面向有一定AI和Agent使用基礎、但美術基礎約等於零、或者根本沒預算請外包美術的獨狼開發者。
但是需要你們有錢買哈機密、gpt會員、豆包和minimax的會員或者api
2D美術死穴與幀間一致性
上一期我們講了模塊化開發和如何用文檔防止AI拉出一坨屎山代碼。按照前兩期的步驟,很多盒友手裏的PoC應該已經跑通了——比如我遊戲裏的農田能劃格子了、機器人能按寫好的腳本去播種澆水了。
但這時候,只要你點開遊戲畫面,一股濃烈的廉價感就會撲面而來:全屏都是灰撲撲的div方塊、網上隨便扒來的風格互斥的圖標、還有刺眼的白底紅字。
這時候肯定有盒友要問了:現在AI繪圖不是都進化到能以假亂真了嗎?我直接讓AI給我畫一套遊戲角色的跑動動作圖不就行了?
很可惜的是,人工智障還沒有進化到那一步。AI畫單張壁紙確實強,但遊戲動畫要的是“連續幀”。AI一旦開始畫第二幀,反手就會給你整出新花樣:第1幀長髮飄飄,第2幀頭髮突然變短;第3幀衣服顏色從藍色變綠色;第4幀甚至可能憑空多長出兩根手指。這東西放進遊戲裏一播放,角色不是在走路,是在原地發病變異
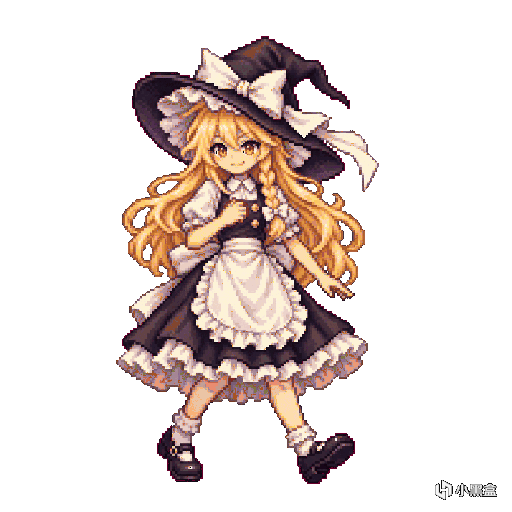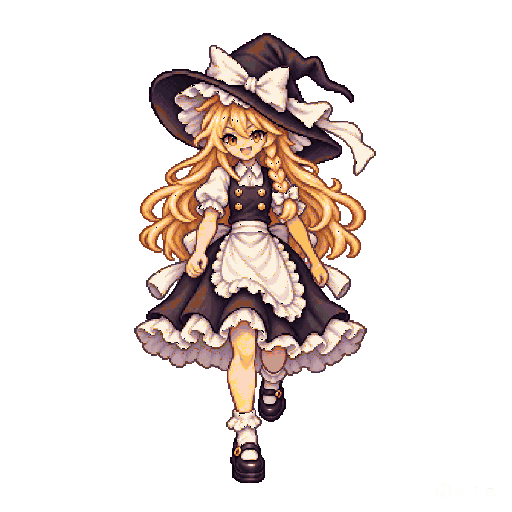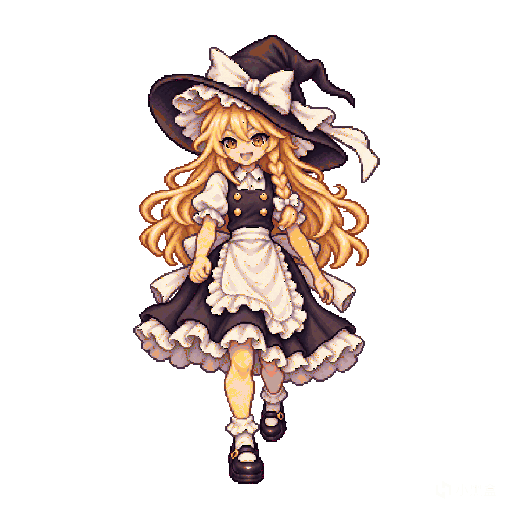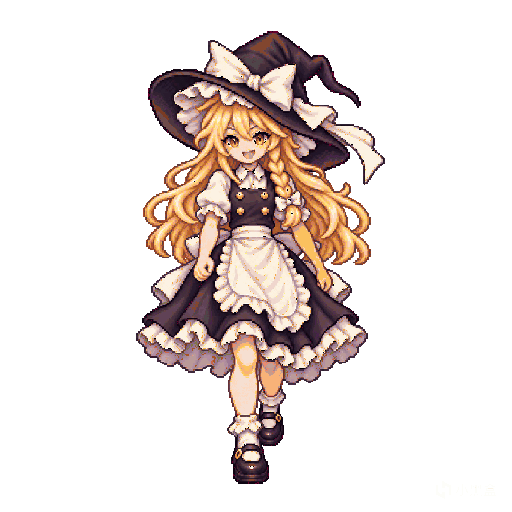
這就是AI做遊戲美術最大的死穴:缺乏幀間一致性。說白了,AI畫第二幀的時候,根本不記得第一幀到底畫成了什麼樣。
爲了解決這個問題,目前行得通的方案主要有三種:窮哥們法、美術大佬法、視頻法。豐儉由人,大家根據自己的錢包和肝臟健康程度自選。
窮哥們法:讓AI手搓SVG代碼
所謂窮哥們法,省流:一分錢不花,全靠你手裏的編程Agent純手搓SVG。
很多不怎麼懂前端的盒友可能不知道SVG是什麼。這玩意兒本質上不是由一個個彩色像素拼起來的位圖(不是png也不是jpg),它其實就是純文本格式的XML代碼。矩形就是<rect>,圓形就是<circle>,複雜的輪廓線條就是<path>貝塞爾曲線,填充顏色就是fill="#xxxxxx"。
既然是寫代碼,那這正好撞在各大LLM(Deepseek、千問、Claude等)的槍口上了,這可是它們的傳統強項。
窮哥們法有極其離譜的優點:
第一是真的一毛錢不用掏。不需要你買MJ會員,不需要你有4090跑SD,甚至連畫圖軟件都不用開,你平常用哪個AI搞VibeCoding,就讓它順手寫SVG。
第二是矢量圖無限縮放不模糊。不管你遊戲窗口怎麼拉伸、在高分屏上怎麼放大,它都是絕對銳利的。這東西天生極度適合做UI圖標、技能按鈕、農作物各生長階段外觀、機械零件、掉落物以及扁平科技風的小物件。
但這裏注意注意注意!Ai畫的SVG只能說勉強能用,只適合圖標和一些輕量小遊戲的美術資產製作。
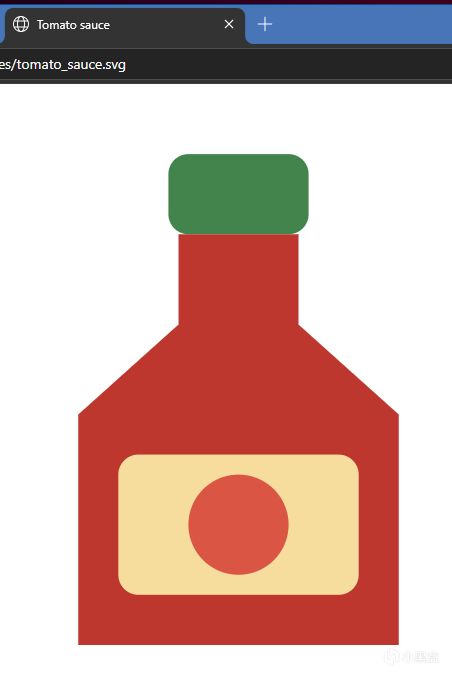
千萬不要試圖讓AI用SVG給你畫二次元老婆立繪或者厚塗寫實怪物。複雜的貝塞爾曲線AI寫出來極容易變成抽象派畢加索,而且代碼量上萬行後會讓瀏覽器渲染直接卡死。
提示詞模板如下,直接複製給你的Agent:
“你現在是資深2D遊戲矢量UI與圖標設計師。請用純SVG代碼幫我繪製一個【主題,比如:2D扁平風格的農田自動巡檢機器人,包含履帶底座、方塊機身和掃描探頭】。
要求:
1. 必須使用標準的 <svg viewBox='0 0 64 64'> 格式,尺寸定爲 64x64;
2. 結構必須語義化分組,用 <g id='track'>、<g id='body'>、<g id='sensor'> 等標籤包裹不同部件;
3. 扁平風格,色彩明快,主色調不要超過4種;
4. 保證圖形居中,四周留出安全邊距;
5. 只輸出純 <svg>...</svg> 代碼塊,不要帶任何markdown廢話和外層HTML容器。”
美術大佬法:3D姿態截圖 + 深度圖 + 逐幀跑圖 + 人工修圖
如果你的遊戲是橫版卷軸、動作或者RPG,主角必須得有跑動、揮劍、施法這套正兒八經的連續動作序列幀,那窮哥們法的矢量圖就搞不定了,你必須得用位圖。
因爲這套方案需要用到3D軟件,而且最後必須有人工修圖把關。Ai直出的圖屬於能看但存在各種各樣的問題。
這套方法的核心邏輯非常樸素:AI之所以每幀亂變,是因爲它腦子裏沒有物理空間的概念。那我們就用現成的3D骨骼動作給AI作爲參考圖。
具體怎麼幹?分四步:
第一步:去白嫖現成的3D動作。零美術基礎千萬別想着自己去Blender裏建模捏人綁骨骼,那是職業模型師乾的事。直接去Adobe旗下的Mixamo網站(完全免費的動捕動作庫,註冊個賬號就能下)或者去開源模型站下個人體木偶。選好你想要的動作,比如“Walk Forward”或者“Slash”。把3D視角的攝像機鎖死在你遊戲需要的角度(比如標準的2D側視,或者45度斜俯視),然後把這個動作按幀導出一組截圖。
這一步也可以ai代勞,只需要安裝blender和blenderMCP,就可以讓ai輸出參考圖,提示詞如下
“如果當前沒有安裝blender的mcp,則安裝,並完成以下任務:
將指定模型在blender中輸出深度圖、骨骼圖、剪影圖和姿勢參考截圖到指定目錄。”
姿勢示意圖,給ControlNet的OpenPose識別動作姿態;另一個是深度圖(Depth map,就是距離鏡頭近處偏白、遠處偏黑的灰度圖)。深度圖極其關鍵!它把角色的胖瘦、肢體前後遮擋關係徹底焊死了,AI拿到深度圖就再也沒法隨便給角色胡亂加粗手臂或者長出第三隻手。
gemini的agent反重力裏,只能上傳3張圖片給繪畫模型,多餘的會被拋掉。所以我建議只上傳骨骼示意圖、深度圖和角色對應視角的設定圖。
有需要參考圖的請留言或者私信聯繫我,我會免費提供。
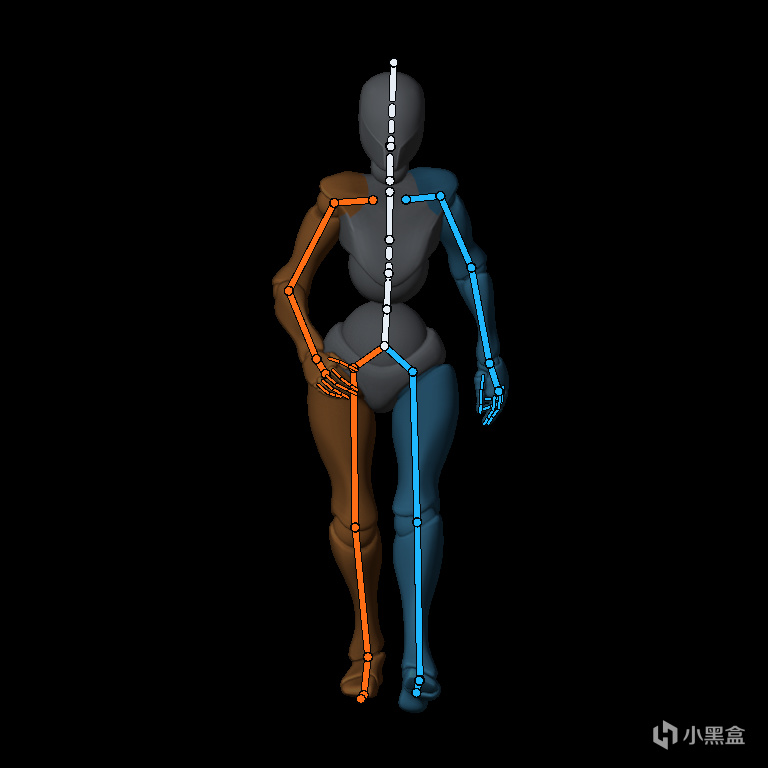
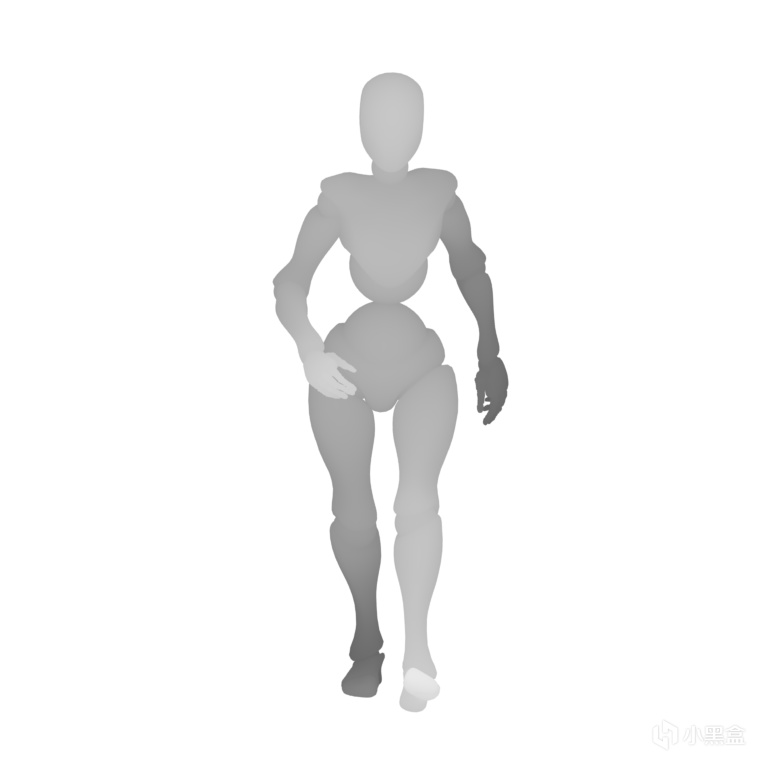
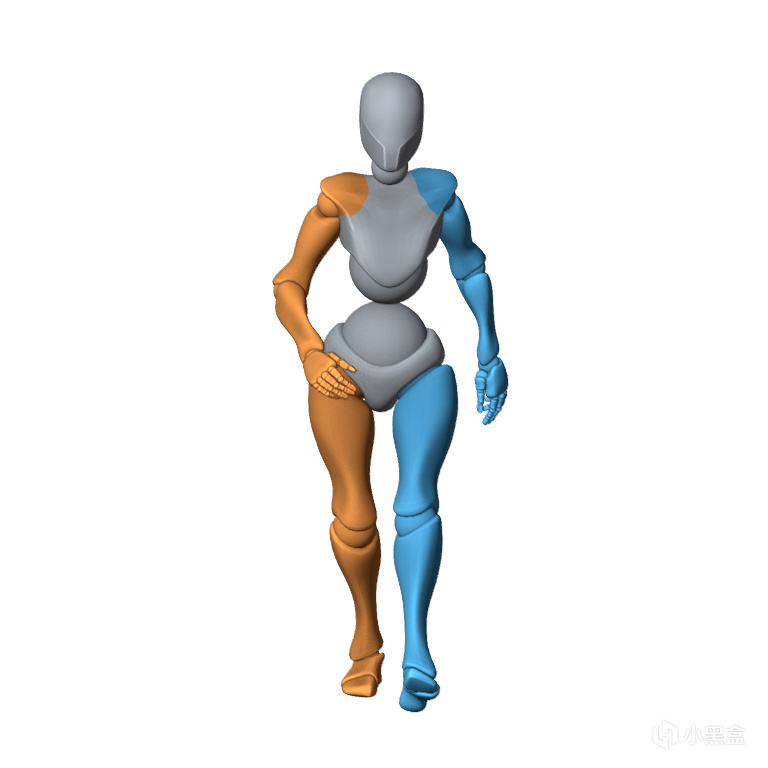
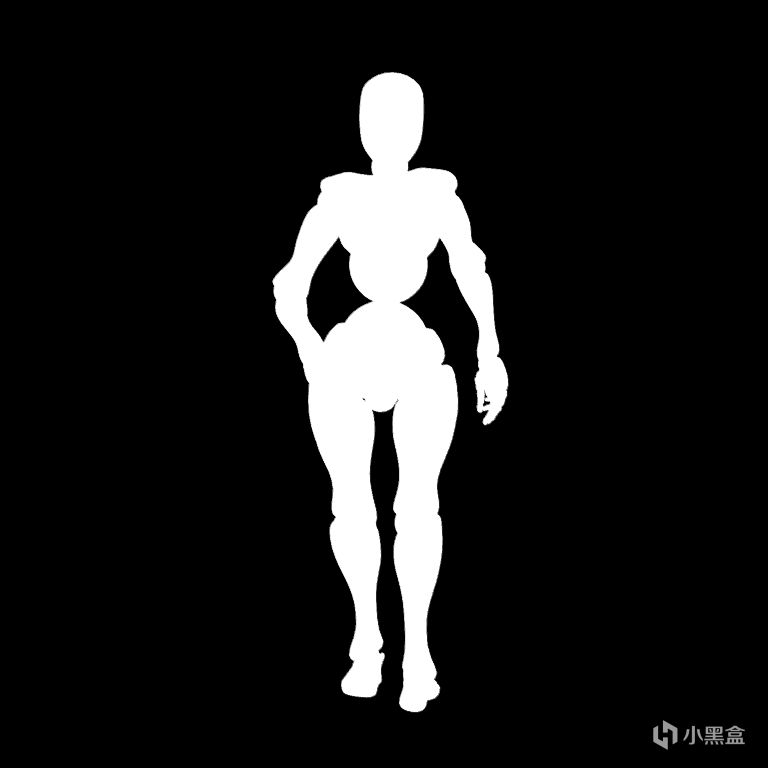
第二步:把角色設定圖和深度圖、姿勢示意圖傳給ai
第三步:人肉修圖(最關鍵的一步!)。AI生成的這十幾張PNG,大體動作肯定是對齊的,但細看必定會有穿幫:第3幀胸口有紐扣,第4幀紐扣突然沒了;第5幀劍刃突然變粗了;第7幀靴子邊緣多了幾塊髒斑點。這時候你必須把這組圖扔進Photoshop、Aseprite或者Krita裏,按播放快捷鍵來回輪播,像挑刺一樣把穿幫的像素點手動塗改抹平。這一步省不掉,不修的話放到遊戲裏角色就會瘋狂閃爍抽搐。
不人肉修圖的代價如下:
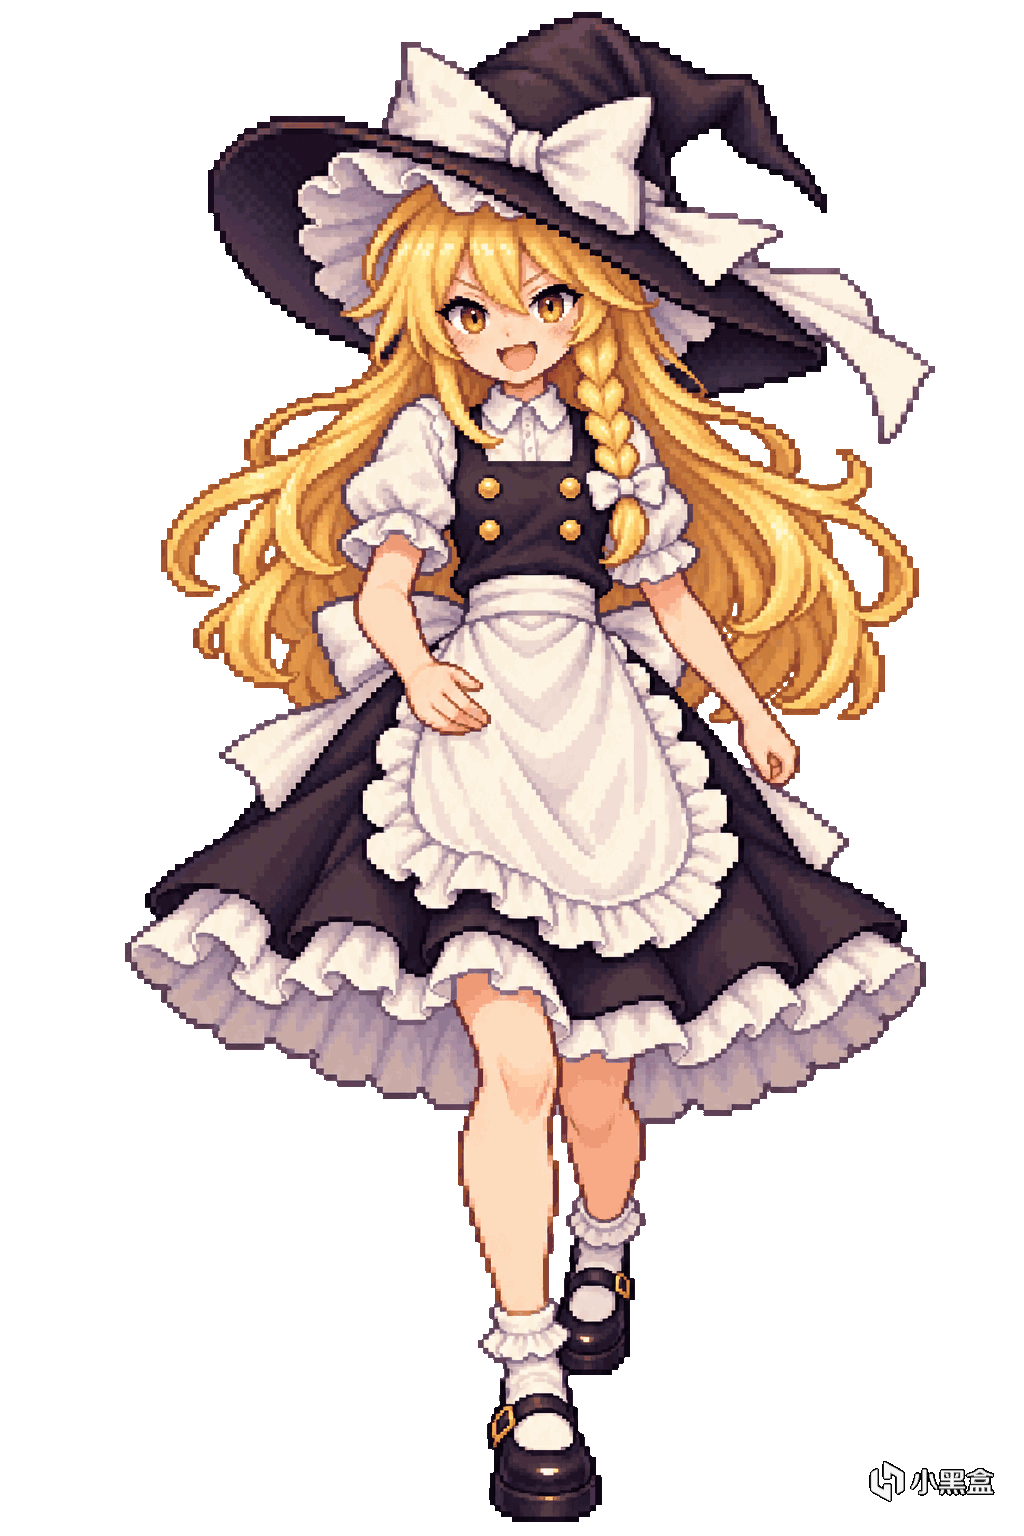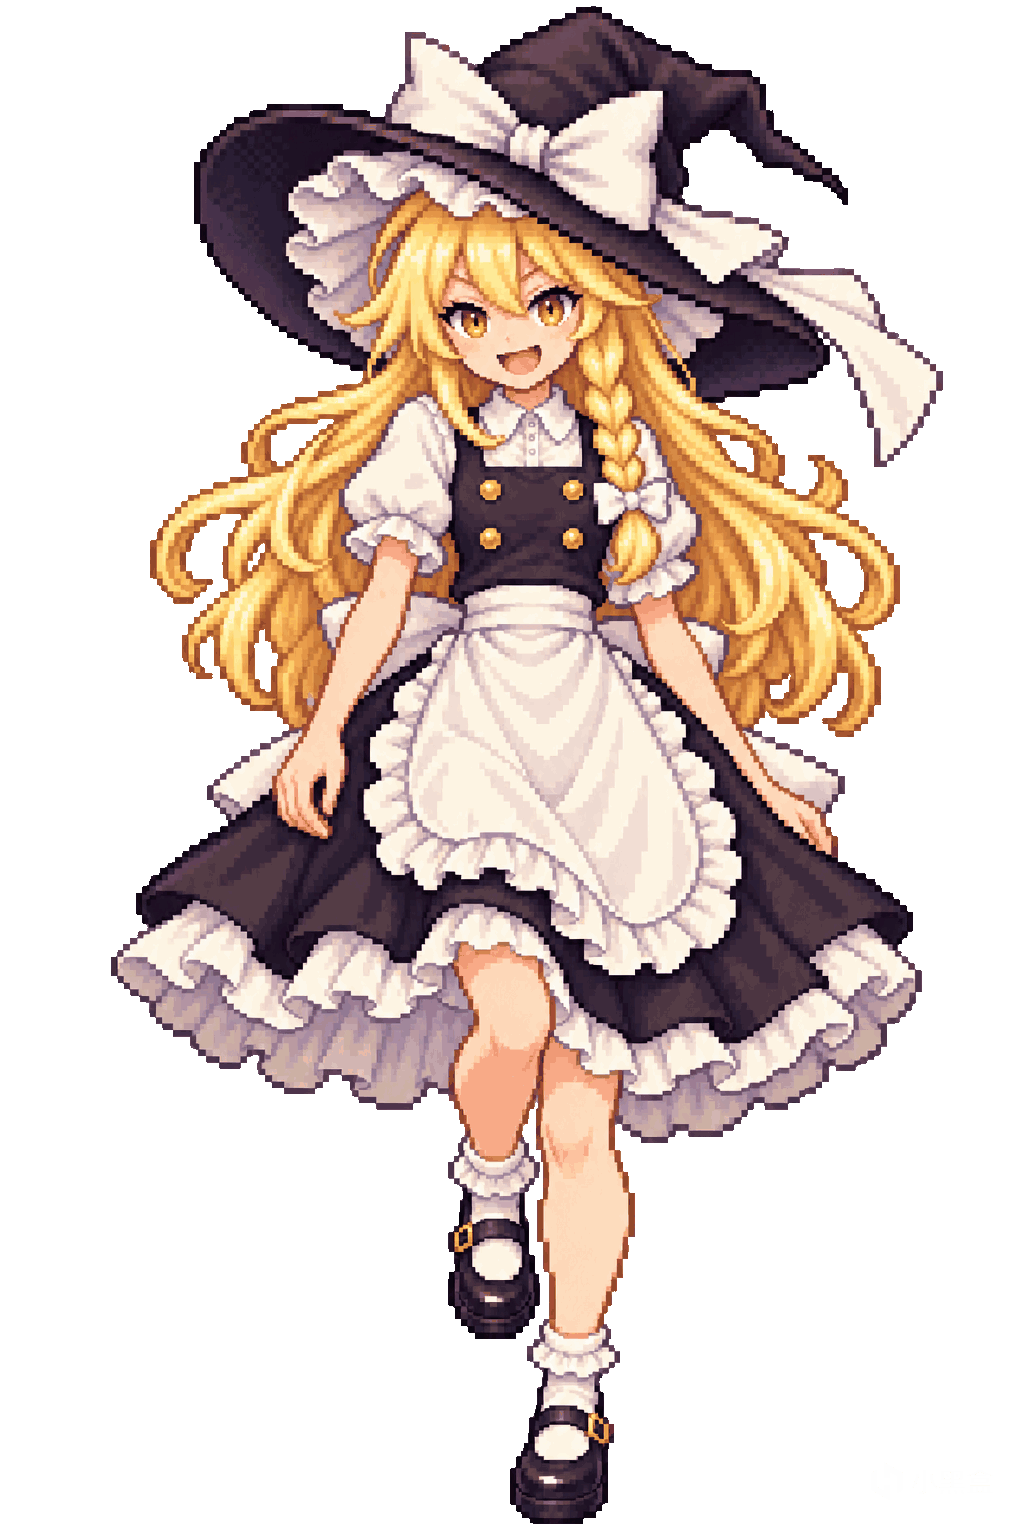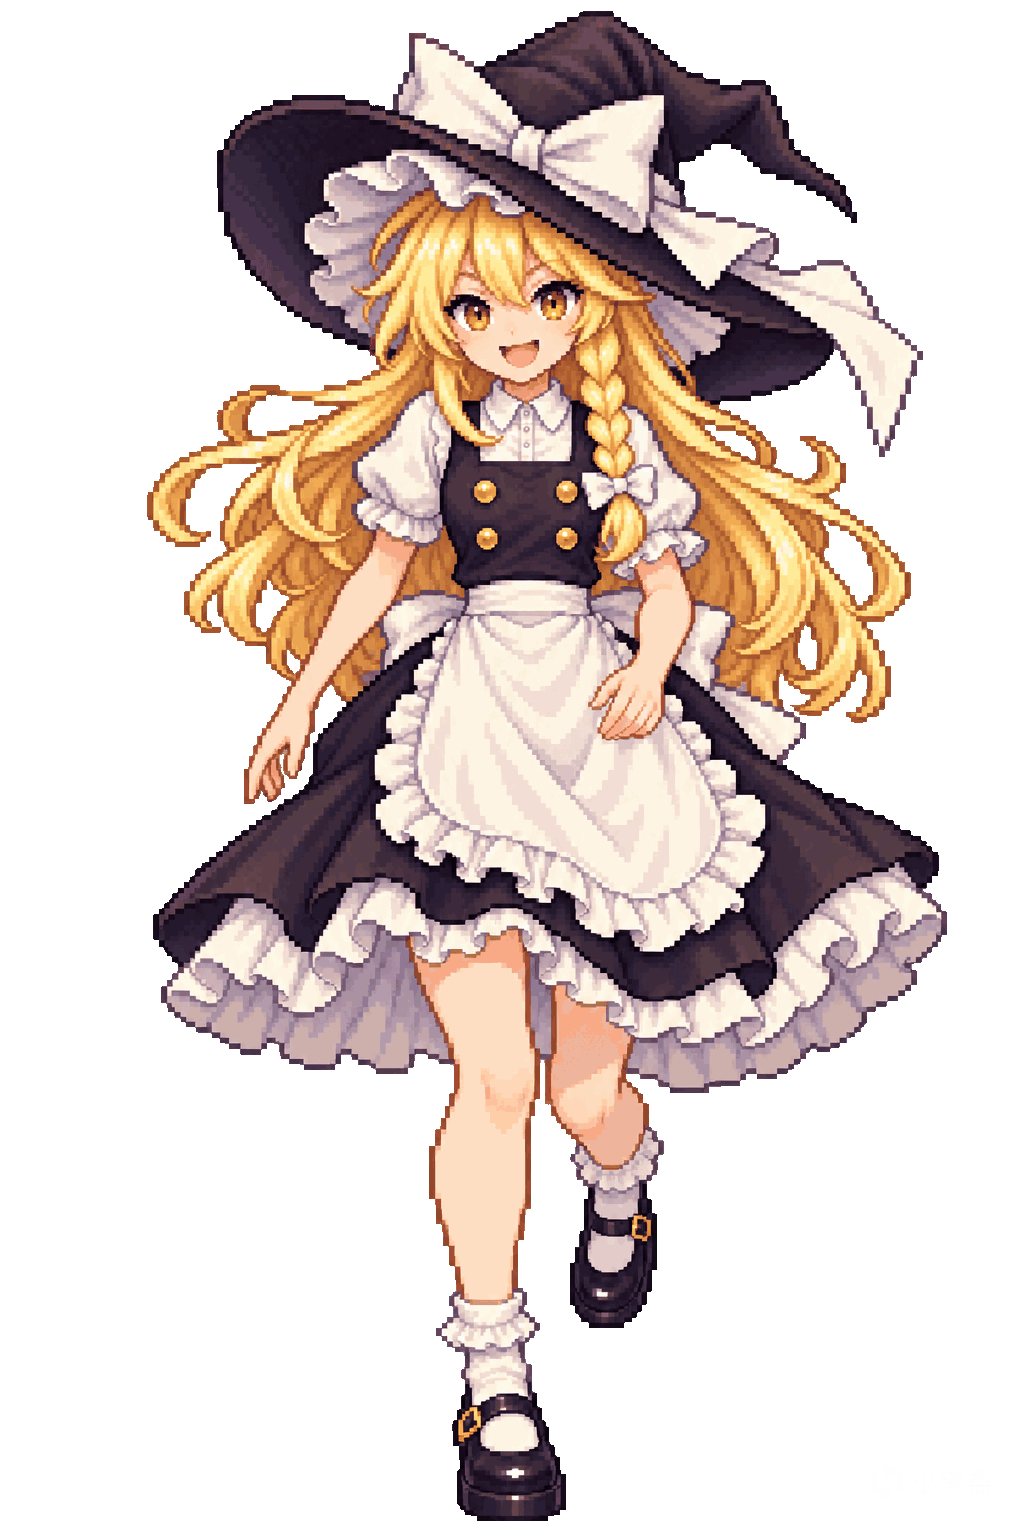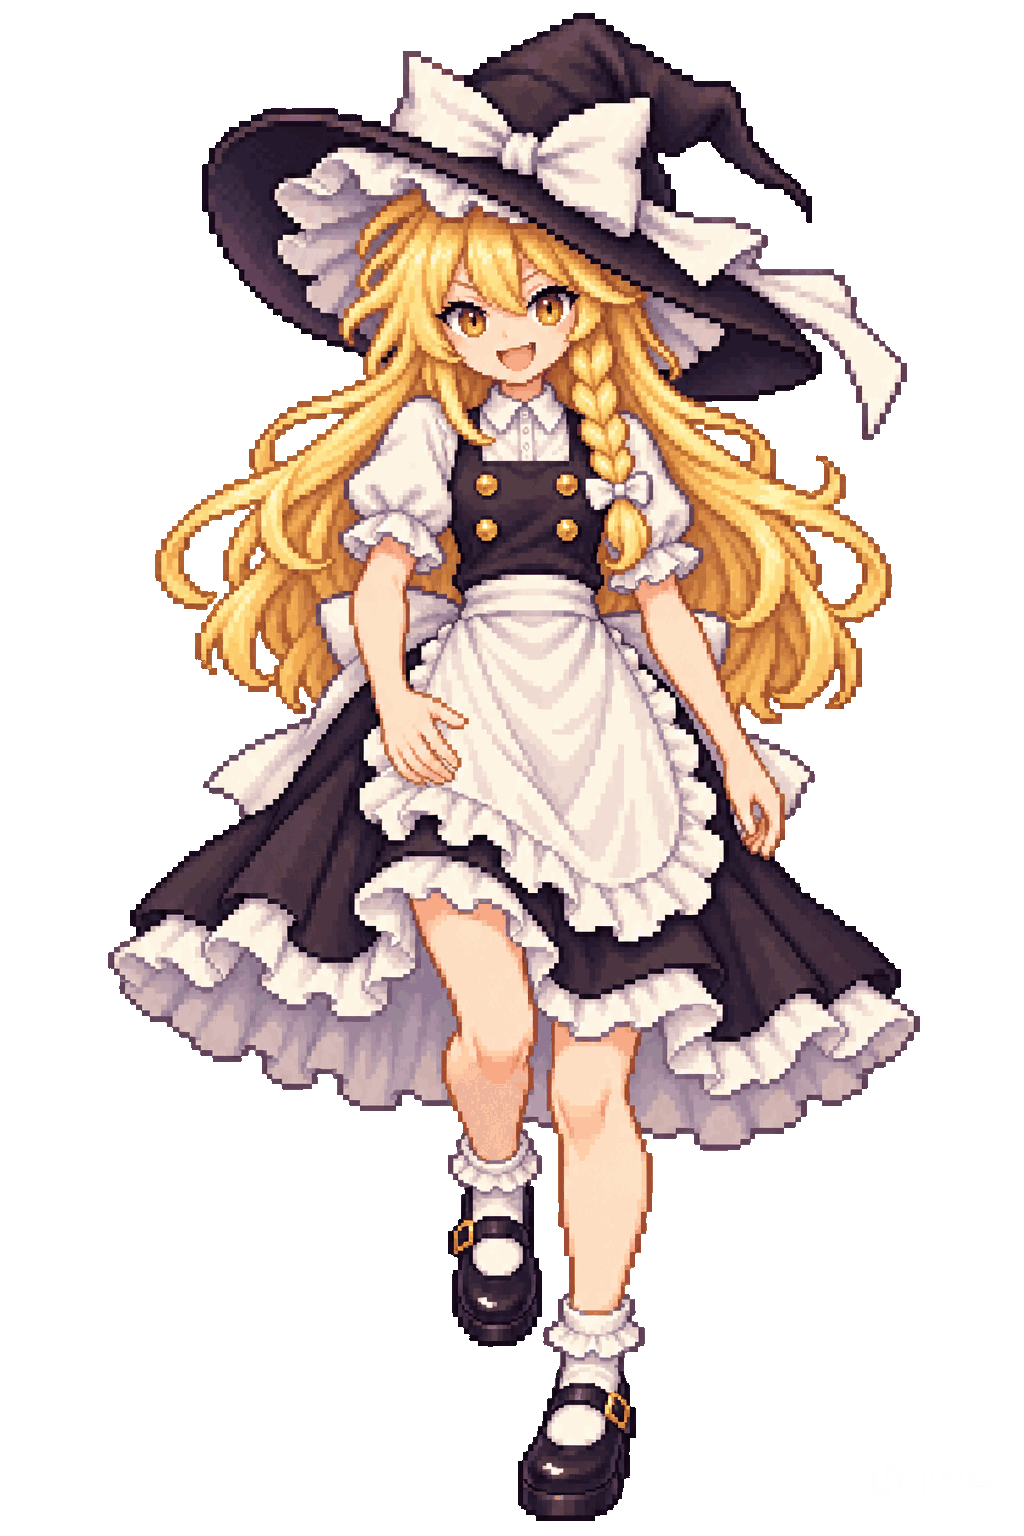
第四步:合成精靈圖。把修好的PNG按規律命名(比如hero_run_00.png到07.png),用TexturePacker或者直接讓Agent寫個幾行Python腳本,一鍵拼成整張精靈圖(Sprite Sheet)並導出帶有每幀座標信息的JSON文件。
讓Agent寫拼圖腳本的提示詞很簡單:
“寫一個本地Python腳本,用Pillow庫:讀取指定目錄下所有有序命名的PNG圖片,檢測並裁掉每張圖四周的透明空白,按角色底部腳底對齊,將它們無縫拼成一張單行(或4x4網格)的sprite_sheet.png,並輸出對應的atlas.json記錄每張小圖的位置和寬高。”
富哥法:AI生成視頻 + 抽幀 + 智能摳圖
如果你覺得搞3D太麻煩,學不會Blender也懶得在Mixamo裏調動作,而且你自認手殘修不來圖,但你兜裏有預算(或者本地顯卡有4090/各大視頻模型平臺點數充足),那就可以直接走富哥路線。
富哥法的底層邏輯是降維打擊:利用現在的視頻生成大模型(可靈Kling、Runway Gen-3、Luma等)。視頻模型在預訓練的時候學的就是現實世界連續運動的規律,它天生就解決了“幀與幀之間連接不自然”的毛病。
具體操作:
第一步:圖生視頻跑綠幕動作。把你事先設計好的角色正面立繪作爲參考圖餵給視頻模型。提示詞裏必須嚴防死守兩個東西:背景和機位!比如提示詞必須寫明:“純綠色背景(green screen #00FF00)、地面無陰影、固定機位視角攝像機、2D遊戲角色循環奔跑動畫”。千千萬萬不能讓AI運鏡,鏡頭要是拉近推遠一下,這組素材當場就廢了。
第二步:視頻轉圖片。給agent下指令:
“把視頻轉換爲幀序列”
第三步:批量摳圖去綠邊。從視頻裏抽出來的圖底色是綠的,而且由於視頻壓縮,角色邊緣往往會有很嚴重的綠幕反光和溢色(Green Spill)。如果用傳統畫圖軟件的顏色魔棒去點,邊緣會留下一圈極其噁心的綠色毛邊。要麼手動摳圖要麼讓ai進行摳圖。只需要對agent說:
“摳圖、保持畫風不變、去除背景”
ai摳圖建議使用gpt和gemini。豆包不知道怎麼回事,經常輸出不出透明背景的圖
第四步:腳底中心對齊。視頻模型生成的動作通常會有輕微的全局位移漂移(角色一邊走一邊往前滑)。如果你直接把抽出來的圖拼在一起,角色在遊戲裏循環播放時就會左右亂抖。讓Agent寫個輕量的OpenCV腳本,計算每一幀角色身體像素的“最底部中心點”,把所有幀的腳底座標釘死在畫布相同的位置,再拼成精靈圖。
視頻法雖然爽,但坑也很明顯:
首尾幀循環閉環難搞。視頻模型很難做到完美的無縫循環(Seamless loop),通常需要你人工在抽出來的幾十幀裏,手動挑選出剛好跨完一步的完整週期(比如剛好從左腳落地到下一次左腳落地的第4幀到第12幀)拿來用。
一般來講,精靈圖都是4幀4向(上下左右)的。這裏我爲了演示視頻轉幀序列由ai摳圖後的gif的效果多好,採用的是24幀/s的圖,實際遊戲中只需要抬腿邁腿落地等關鍵幀組成的4-8幀。不過很可惜的是我口袋裏分文不剩,只能給你們看不精修和抽卡時長啥樣了。如圖:
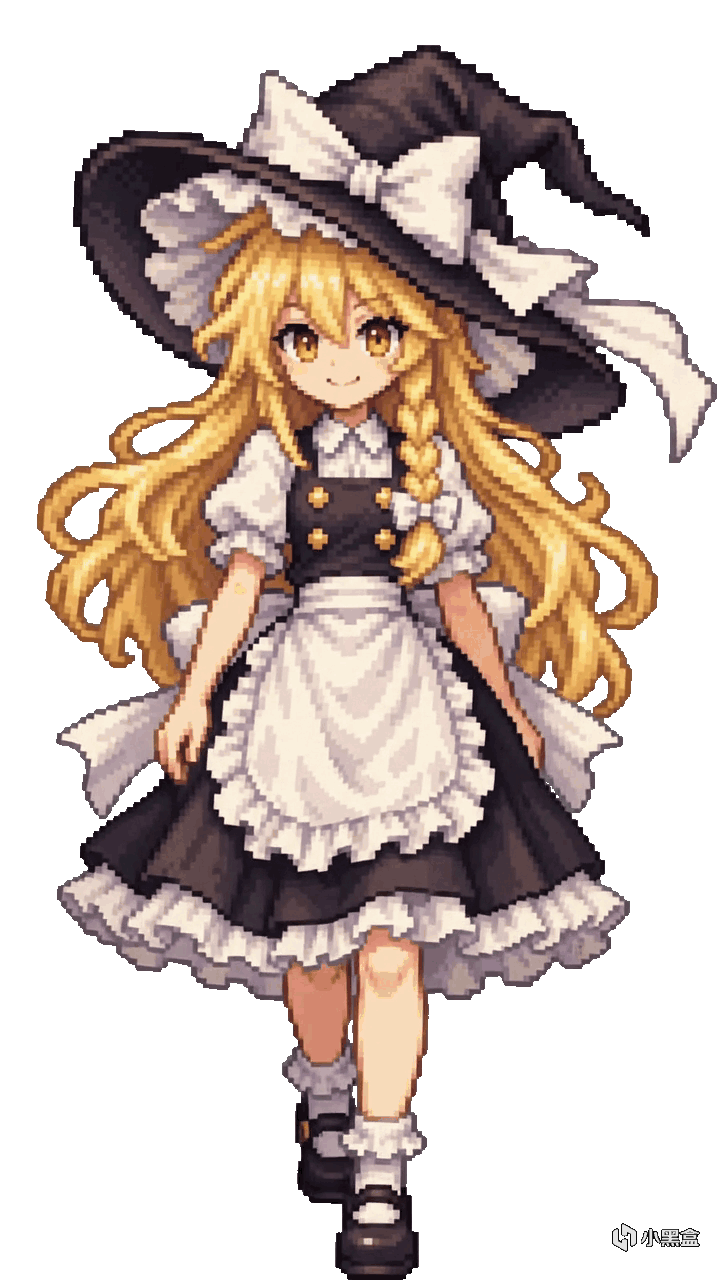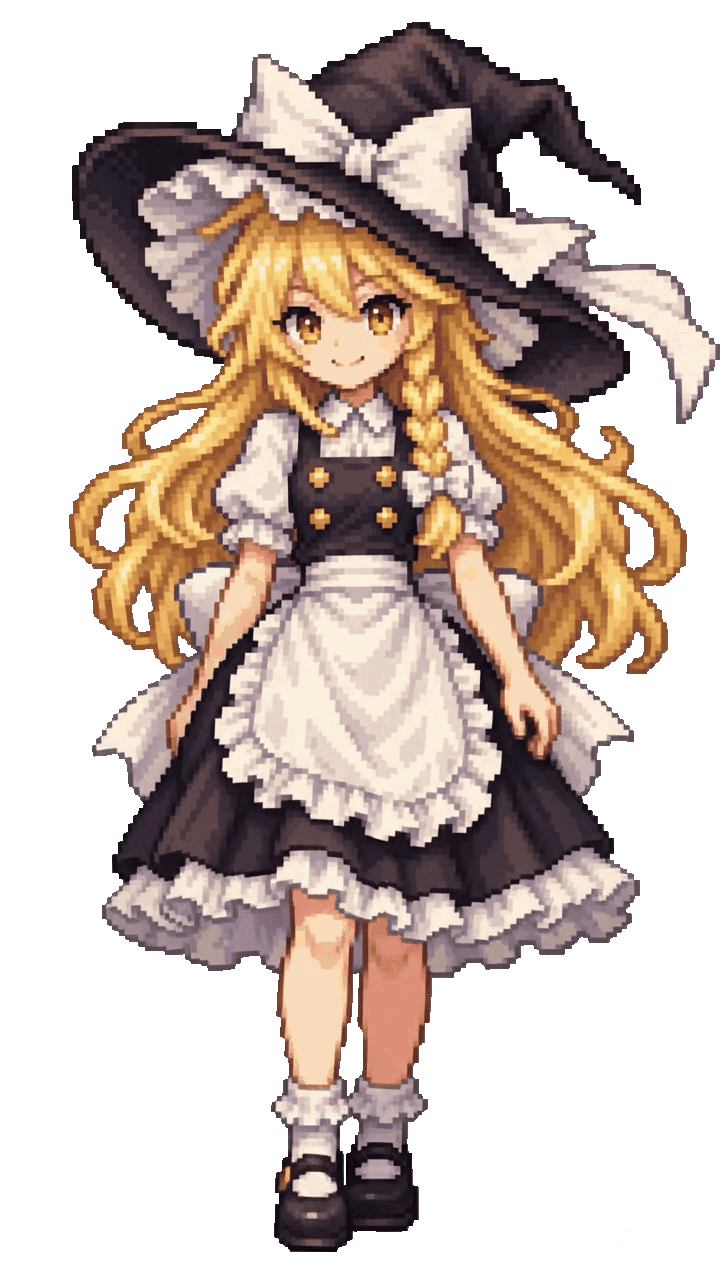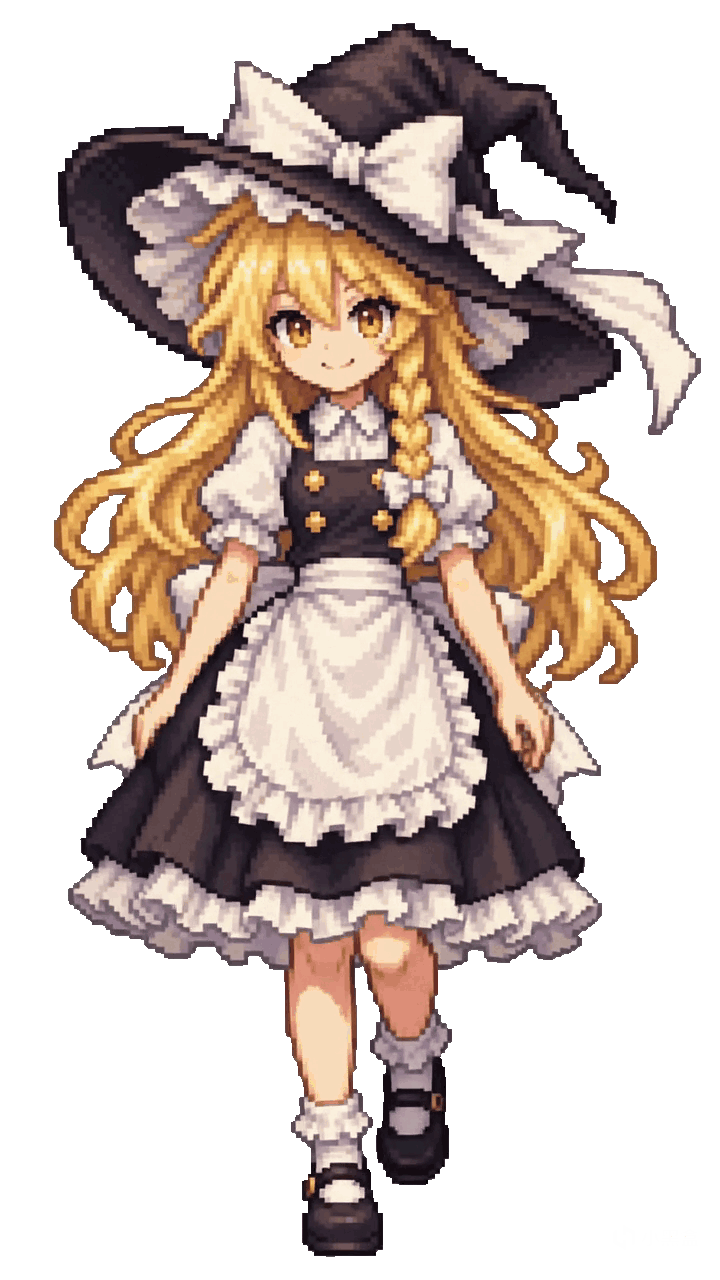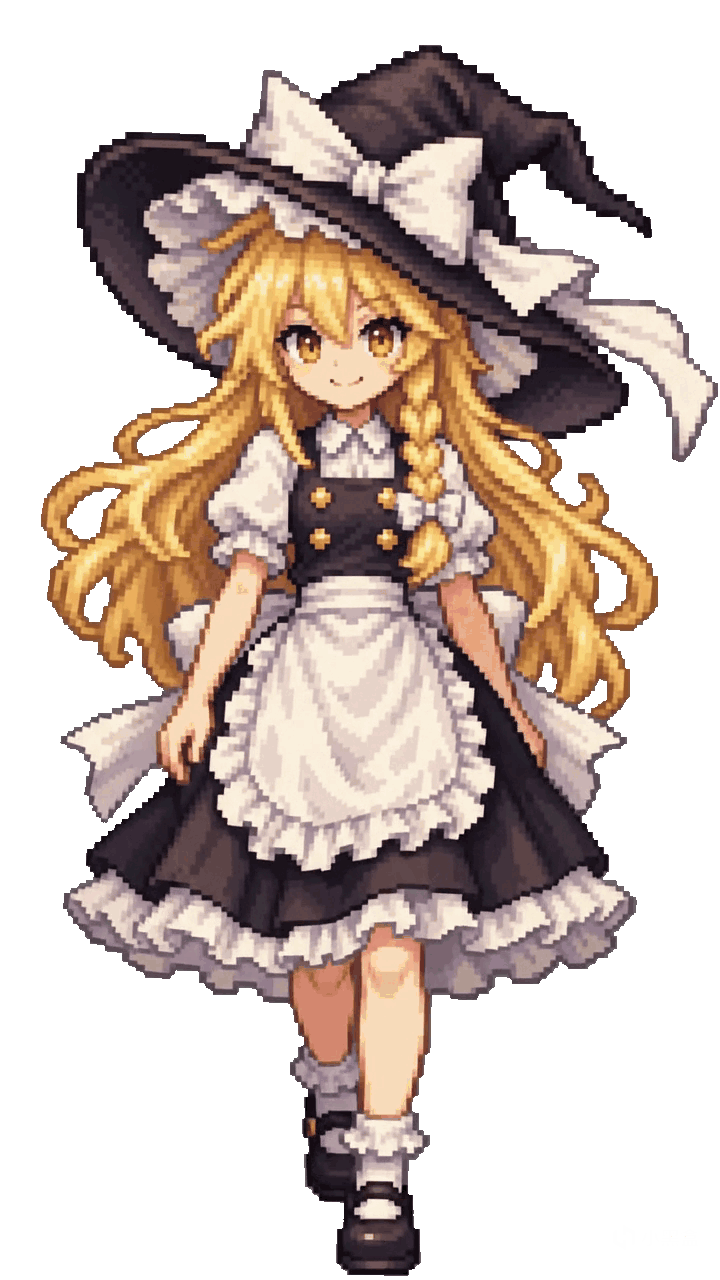
下期預告:美術資產3D篇:
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com