10月AI雜談
本期大綱
Gemini 4 確實不錯
Opus5.5/GPT6.1 Sol 都降價了, 速度也很快, 但是用起來更費勁了
DeepSeek v4.1 1017 代碼任務, 國產AI中的絕對主力平替
kimi k3/k3.1 策劃任務, 國產AI的不錯平替
qwen3.8 max 拉完了
Gemini 4 Argon
挺貴的, 代碼任務蹬不起. 只用來做關鍵的"策劃任務"
邏輯能力, 創意性, 關鍵信息捕捉, 細小漏洞的察覺
個人認爲當下時間超過了 Opus5.5 (任何模型剛發佈都是最強的)
很多 Opus5.5 發現不了的問題設計, Gemini-4 可以很好的分析出來
Gemini-4 做遊戲創意, 給出的點子, 也都很不錯, 總體的可實行度比 Opus5.5 高很多;
目前的問題在於賊貴, 20$訂閱檔, 額度比當時 GPT6 Astra 剛發佈時還少.
5~6個系統的設計就把一週的額度蹬完了.
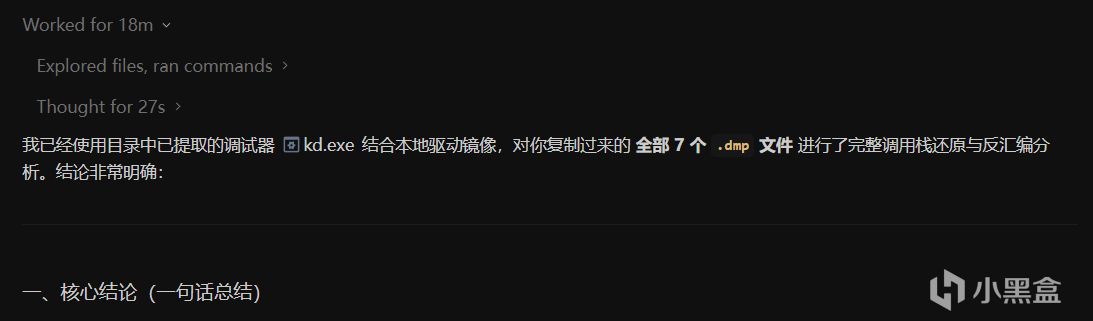
檢查了一個Windows系統藍屏問題, GLM5.3搞了兩個小時, Kimi k3.1 pro 搞了半個小時, 沒有任何結果.
Gemini 4 Argon 18分鐘搞定了問題;
Opus5.5/GPT6.1 Sol 降價提速, 確實好用, 但是也變難用了
上個月停用了一個月的 GPT和Opus
原因是:
GPT 5.6 Sol: 太囉嗦, 想一萬種邊界可能
GPT6 Astra: 貴得犯罪
Opu5: 比驢還蠢
這個月 Opus 5.5 和 GPT6.1 Sol發佈後, 又重新訂閱上了
一開始用起來, 發現真的很驚豔, 處理任務的速度極快, 代碼質量極高;
額度很耐用, 20$訂閱, 即使換算成150人民幣的國產AI訂閱, 性價比也是更高的.
一開始還以爲 A/ 和 openAi 發現了什麼外星人科技;
用着用着發現不對勁, 簡單總結就是, 都開始偷懶了;
曾經的 GPT 是你隨便提了一個2行代碼的小問題, GPT恨不得把整個代碼庫都分析一遍
現在的 GPT 是, 我放在路徑下的 ReadMe.md, GPT都不會主動去讀
曾經的 Claude是, 我隨便提到某個關鍵詞, 他就全庫檢索這個關鍵詞, 去分析對應的代碼
現在的 Claude是, 如果把我揹包系統的截圖發給他給他參考, 那麼他甚至不會去讀揹包系統的代碼, 就只靠截圖來理解
---
這種變化, 我也說不上是好還是不好, 見仁見智;
想起我之前的文章寫的:
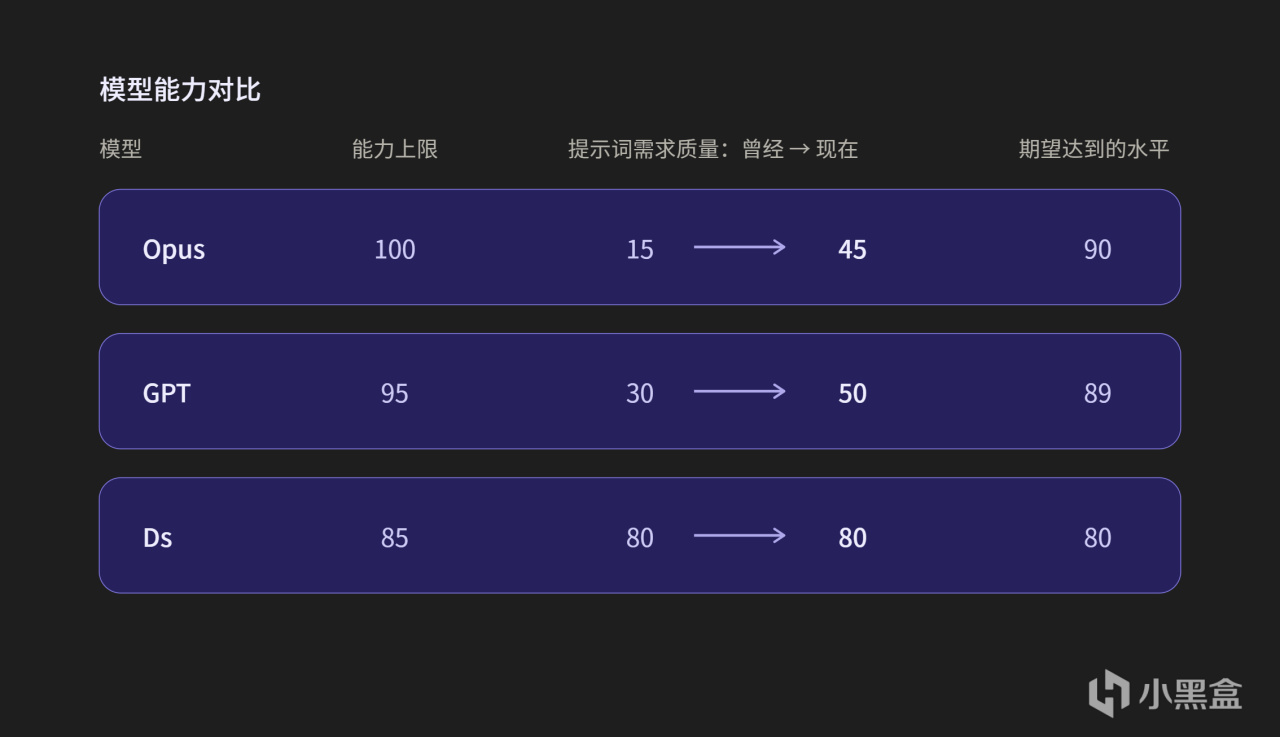
Opus 是罕見的能聽懂人話的AI, 你隨便說點什麼, 他就能準確的猜到你想幹什麼
ChatGpt 永遠在考慮千萬分之一概率的邊界問題, 永遠限制不住的拓展思考
國產AI其實能力不弱, 但是極其考驗提示詞編寫水平
現在, 都向着"極其考驗提示詞編寫水平"方向發展了...
一張圖總結:
DeepSeek v4.1 Flash
還是國產模型中, 代碼任務, 價格+能力+速度, 第一檔的存在
比他快的, 沒他智能
比他智能的, 速度極慢
kimi k3 | Qwen3.8 Max
Kimi k3 總體還是不錯的, 思考特徵與 Claude極爲相似, 水平總體在線.
如果想執行思維邏輯任務, 但是又沒辦法用Claude, Kimi是個不錯的平替
Qwen3.8 Max 專門拉出來罵一下, 能力挺強的, 這個可以當 GPT 的國產平替, 但是速度太慢了, 慢出天際
我是在千問自己的 Qoder中, 凌晨1點用的, 思考強度-中, 一個簡單的任務能思考十幾分鍾, 等後續優化吧.
總結或補充
ChatGpt, 性價比高, 速度快, 代碼任務可首選, 一週的代碼審覈中, 異味代碼爲 1/20
Opus, 性價比高, 速度快, 仍然是審美能力在線, 設計遊戲UI的首選, 一週的代碼審覈中, 異味代碼爲 0/20
Kimi, 性價比中, 速度中, 勝在國內使用起來方便, 用來做策劃任務, 挺好用的
Deepseek v4.1 flash, 性價比高, 速度中, 我主要用來審查代碼, 挺好用的. 簡單修改一些bug, 也還行
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com