10月AI杂谈
本期大纲
Gemini 4 确实不错
Opus5.5/GPT6.1 Sol 都降价了, 速度也很快, 但是用起来更费劲了
DeepSeek v4.1 1017 代码任务, 国产AI中的绝对主力平替
kimi k3/k3.1 策划任务, 国产AI的不错平替
qwen3.8 max 拉完了
Gemini 4 Argon
挺贵的, 代码任务蹬不起. 只用来做关键的"策划任务"
逻辑能力, 创意性, 关键信息捕捉, 细小漏洞的察觉
个人认为当下时间超过了 Opus5.5 (任何模型刚发布都是最强的)
很多 Opus5.5 发现不了的问题设计, Gemini-4 可以很好的分析出来
Gemini-4 做游戏创意, 给出的点子, 也都很不错, 总体的可实行度比 Opus5.5 高很多;
目前的问题在于贼贵, 20$订阅档, 额度比当时 GPT6 Astra 刚发布时还少.
5~6个系统的设计就把一周的额度蹬完了.
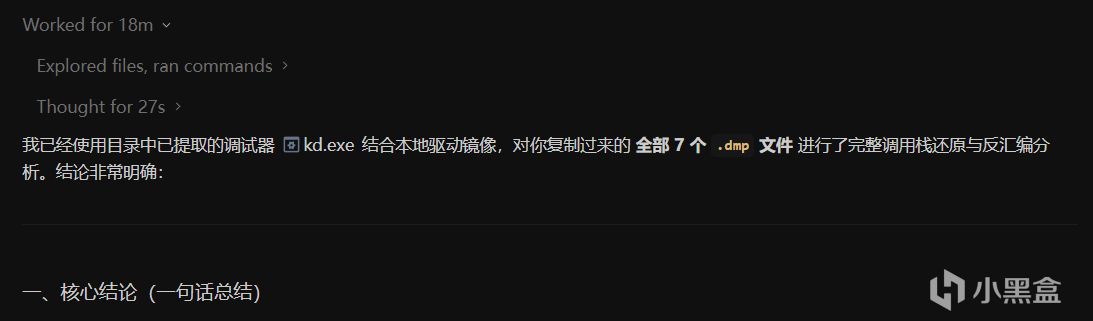
检查了一个Windows系统蓝屏问题, GLM5.3搞了两个小时, Kimi k3.1 pro 搞了半个小时, 没有任何结果.
Gemini 4 Argon 18分钟搞定了问题;
Opus5.5/GPT6.1 Sol 降价提速, 确实好用, 但是也变难用了
上个月停用了一个月的 GPT和Opus
原因是:
GPT 5.6 Sol: 太啰嗦, 想一万种边界可能
GPT6 Astra: 贵得犯罪
Opu5: 比驴还蠢
这个月 Opus 5.5 和 GPT6.1 Sol发布后, 又重新订阅上了
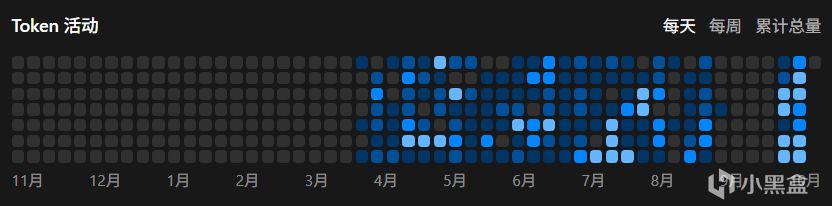
一开始用起来, 发现真的很惊艳, 处理任务的速度极快, 代码质量极高;
额度很耐用, 20$订阅, 即使换算成150人民币的国产AI订阅, 性价比也是更高的.
一开始还以为 A/ 和 openAi 发现了什么外星人科技;
用着用着发现不对劲, 简单总结就是, 都开始偷懒了;
曾经的 GPT 是你随便提了一个2行代码的小问题, GPT恨不得把整个代码库都分析一遍
现在的 GPT 是, 我放在路径下的 ReadMe.md, GPT都不会主动去读
曾经的 Claude是, 我随便提到某个关键词, 他就全库检索这个关键词, 去分析对应的代码
现在的 Claude是, 如果把我背包系统的截图发给他给他参考, 那么他甚至不会去读背包系统的代码, 就只靠截图来理解
---
这种变化, 我也说不上是好还是不好, 见仁见智;
想起我之前的文章写的:
Opus 是罕见的能听懂人话的AI, 你随便说点什么, 他就能准确的猜到你想干什么
ChatGpt 永远在考虑千万分之一概率的边界问题, 永远限制不住的拓展思考
国产AI其实能力不弱, 但是极其考验提示词编写水平
现在, 都向着"极其考验提示词编写水平"方向发展了...
一张图总结:
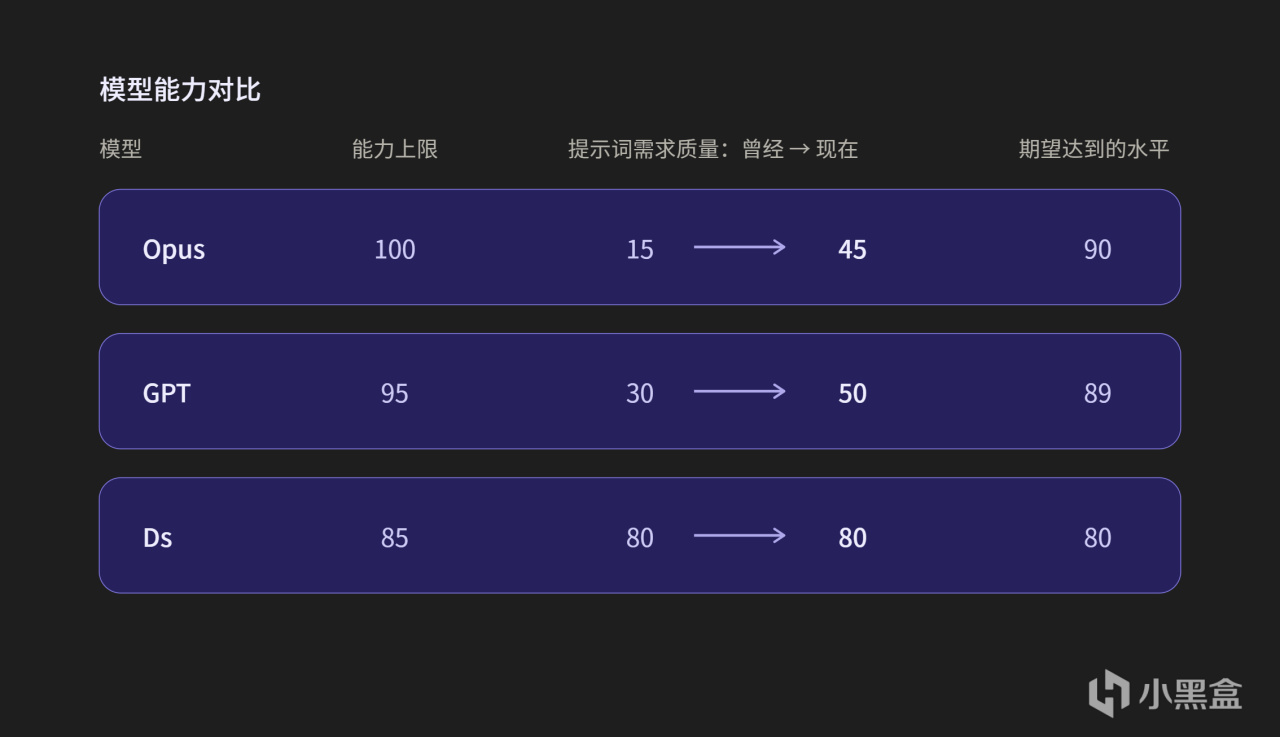
DeepSeek v4.1 Flash
还是国产模型中, 代码任务, 价格+能力+速度, 第一档的存在
比他快的, 没他智能
比他智能的, 速度极慢
kimi k3 | Qwen3.8 Max
Kimi k3 总体还是不错的, 思考特征与 Claude极为相似, 水平总体在线.
如果想执行思维逻辑任务, 但是又没办法用Claude, Kimi是个不错的平替
Qwen3.8 Max 专门拉出来骂一下, 能力挺强的, 这个可以当 GPT 的国产平替, 但是速度太慢了, 慢出天际
我是在千问自己的 Qoder中, 凌晨1点用的, 思考强度-中, 一个简单的任务能思考十几分钟, 等后续优化吧.
总结或补充
ChatGpt, 性价比高, 速度快, 代码任务可首选, 一周的代码审核中, 异味代码为 1/20
Opus, 性价比高, 速度快, 仍然是审美能力在线, 设计游戏UI的首选, 一周的代码审核中, 异味代码为 0/20
Kimi, 性价比中, 速度中, 胜在国内使用起来方便, 用来做策划任务, 挺好用的
Deepseek v4.1 flash, 性价比高, 速度中, 我主要用来审查代码, 挺好用的. 简单修改一些bug, 也还行
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com