9 月 22 日消息,小米今日凌晨正式發佈並開源了全新的 Xiaomi MiMo-V2.6 系列,包含 Pro 與 Flash 兩個原生全模態模型。
小米稱這是其探索 RSI(遞歸自我改進)路徑的關鍵一步,通過規模化擴展強化學習算力,讓模型在持續的探索與反饋中拓展智能邊界。
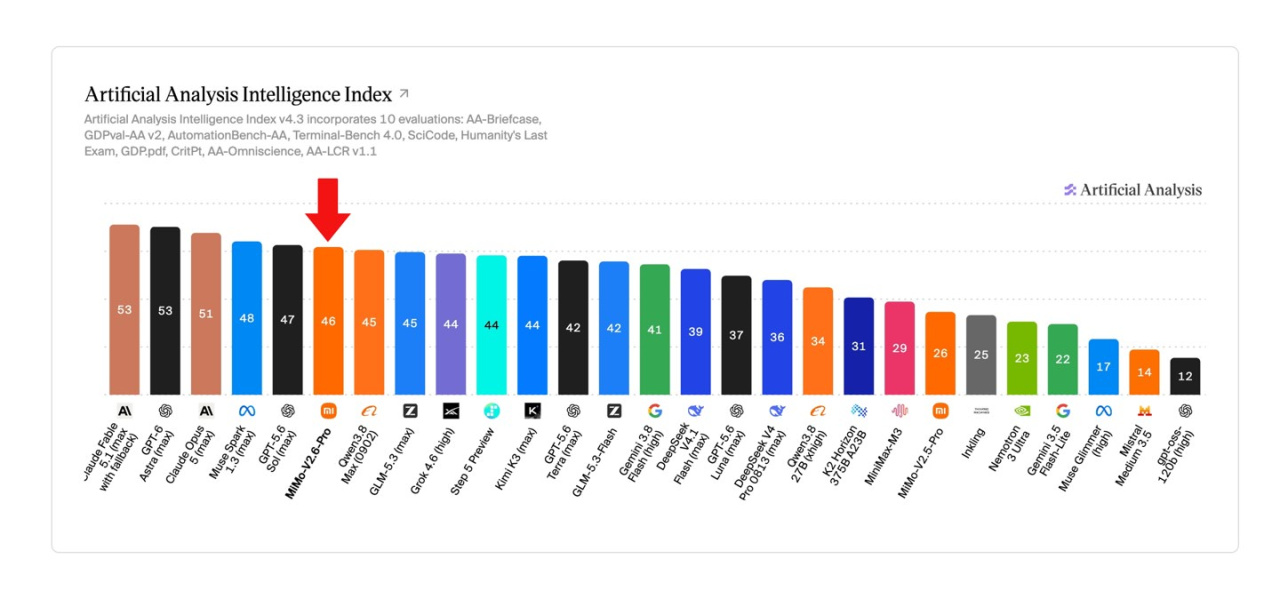
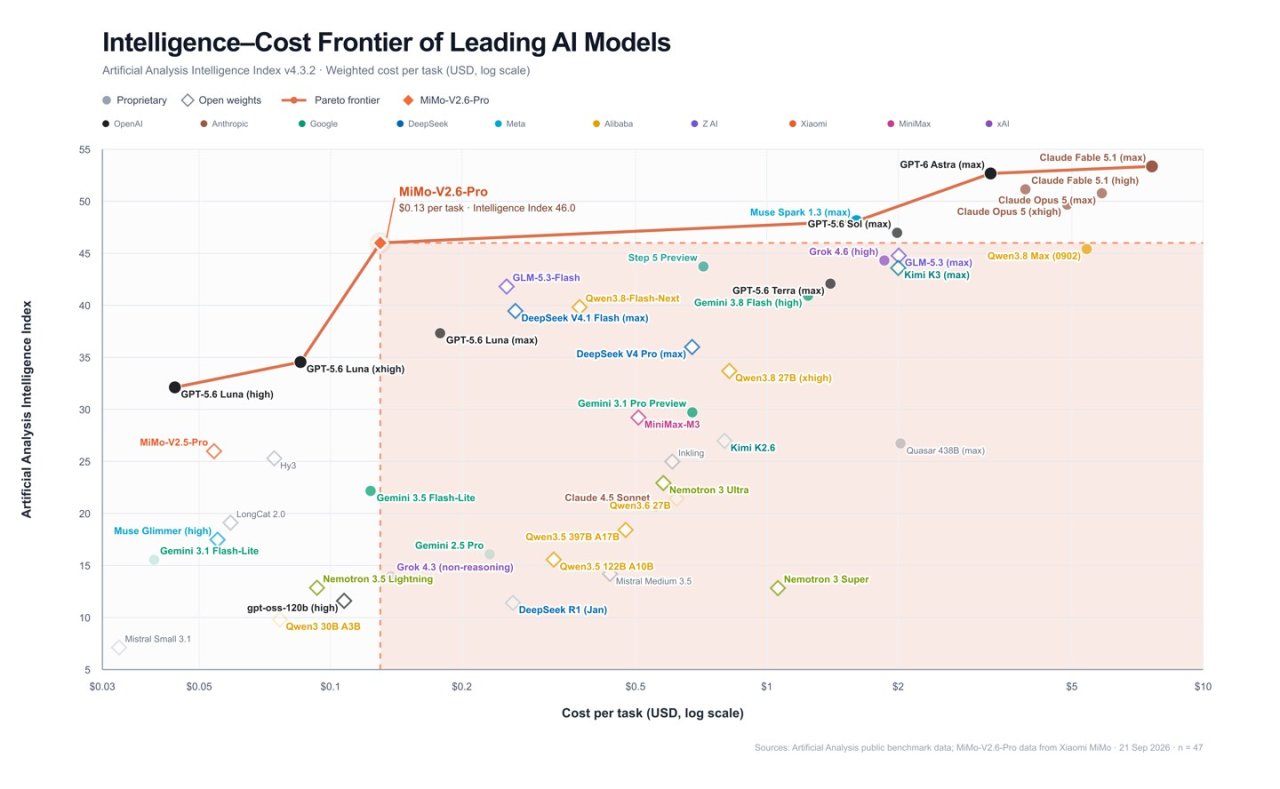
得益於 RL 算力的擴展,MiMo-V2.6-Pro 在 Artificial Analysis Intelligence Index(AA 綜合智能指數)v4.3.2 中取得 46 分,超過 Kimi K3(44 分)和 GLM-5.3(45 分),成爲當前 AA 指數上排名最高的開源權重模型,較其前代 MiMo-V2.5-Pro 的 26 分高出 20 分。
小米官方同時說明,該模型與 Claude Fable 5.1 和 GPT-6 Astra(均爲 53 分)等頂級閉源模型相比仍有差距。
在 RL 訓練階段,MiMo-V2.6 可能是目前國產開源模型中投入 RL 算力最多的模型之一。Pro 與 Flash 訓練歷時不到 6 天,成本分別約 262 萬美元與 85 萬美元,各完成 30 步,累計約 75 萬條軌跡。
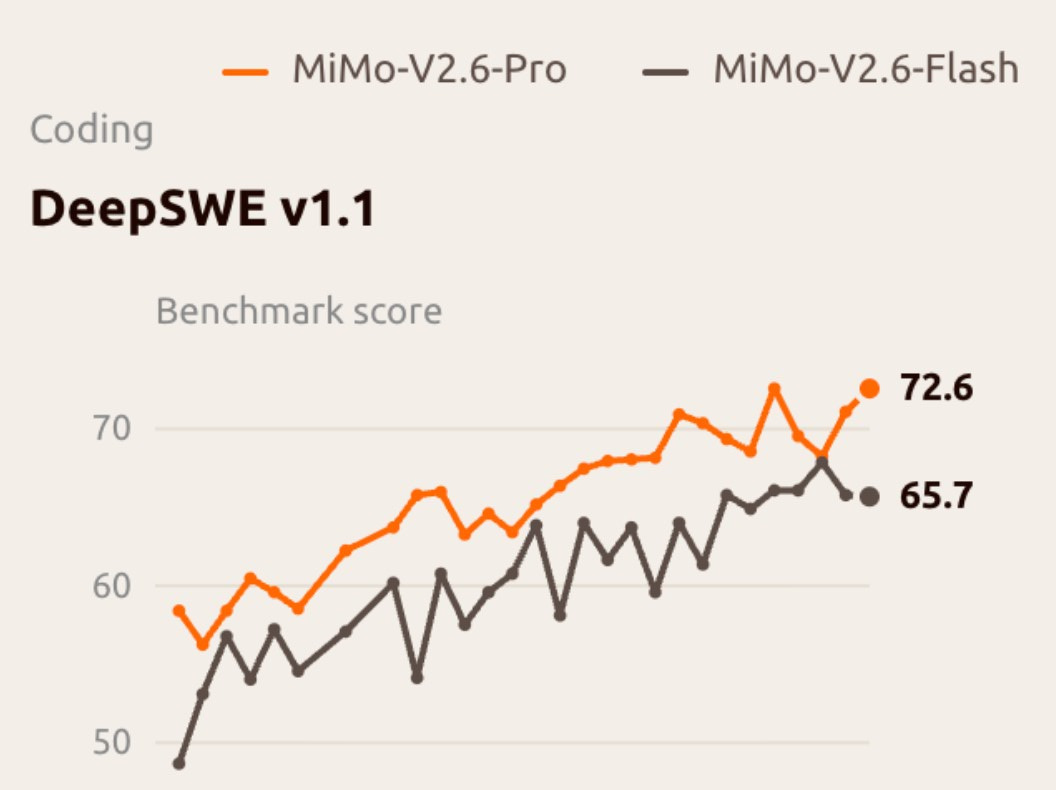
訓練任務平均通過率分別相對提升 25% 和 12%,樣本外的長程軟件工程評測基準 DeepSWE v1.1 分別提升約 17 分(48.8 至 65.7)和約 14 分(58.4 至 72.6)。
本次訓練從三個維度擴展 RL 算力:更大的 Batch 與更高吞吐,單次更新使用 1568 個樣本,支持 100 萬上下文長度訓練,單步訓練 Token 達 3.5 至 3.7B;更多任務與複雜環境,構建覆蓋 Code、General、Visual、Cyber 等方向的多任務訓練體系;更大的 Grader 算力,通過 Group 內相對比較爲長程 RL 任務提供更精準的獎勵信號。
能力擴展上,MiMo-V2.6 融合了 3D 空間推理、多模態感知與計算機操作能力。在遊戲開發中,用戶輸入圖片、視頻或文字後,模型可將需求拆解爲多個任務,由多智能體協作完成 3D 場景搭建、交互邏輯編寫與視覺驗證。在具身仿真環境中,MiMo-V2.6 可直接以多視角相機畫面爲輸入,通過視覺反饋閉環控制 Franka Panda 機械臂,完成物體抓取、顏色匹配與精準放置。
科研方面,MiMo-V2.6-Pro 協助研究人員完成了全氟和多氟烷基物質(PFAS)吸附用金屬有機框架(MOF)材料的設計方案篩選,並在 Lean 4 中完成了 Li-Yorke 經典論文《週期三蘊含混沌》原始主定理的完整形式化,形成 6000 餘行 Lean 源碼,完整證明通過 Lean 內核覈驗。模型未接受過針對 Lean 的專項後訓練。
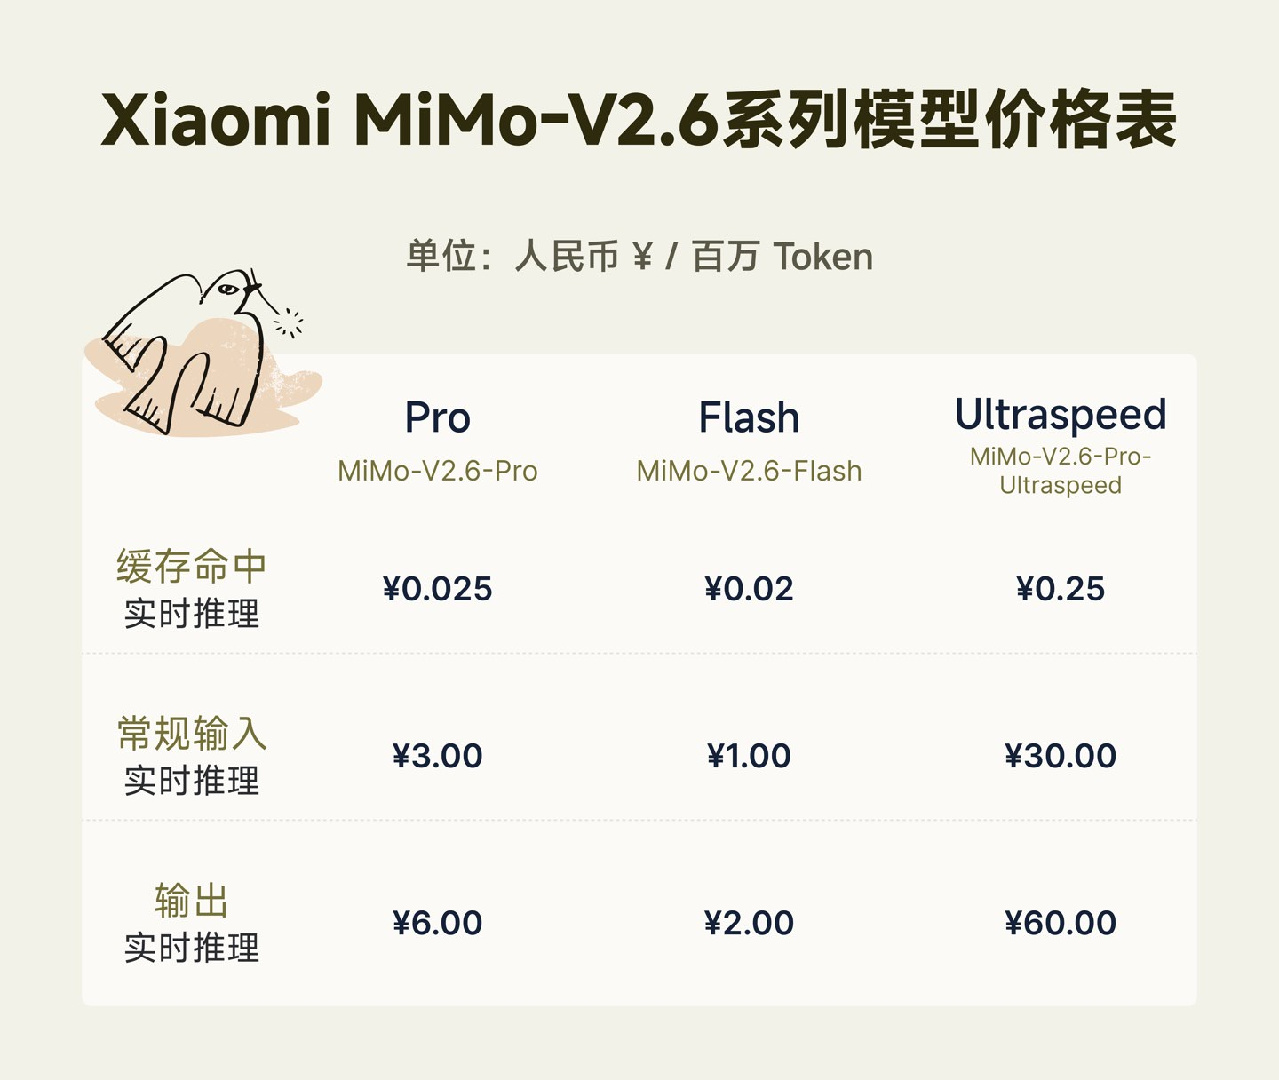
MiMo-V2.6 系列沿用 V2.5 系列的 API 定價:Flash 爲每百萬詞元輸入 1 元、每百萬輸出 2 元;Pro 爲 3 元和 6 元,並提供 99% 緩存摺扣。在同等智能水平下,價格僅爲海外模型的 1/20 至 1/60。
伴隨新模型發佈,MiMo Desktop 桌面客戶端(支持 Windows 與 Mac)及會員訂閱方案同步上線,訂閱會員即可使用 MiMo-V2.6-Pro 和 Flash 模型,也可配置自己的 API Key 使用客戶端。
MiMo Desktop 同步上線 MiMo-V2.6-Pro 的 UltraSpeed 超高速模式,提供最高 20 倍的推理速度。
MiMo-V2.6 系列已上線 Xiaomi MiMo 開放平臺。原邀測活動將在 1 周後結束,已獲得邀測資格的用戶切換模型名稱後方可繼續使用。
同時,小米全面開源 MiMo-V2.6-Pro、Flash 模型權重與技術報告,同步開放 MiMo-V2.6-Distill-Qwen-9B 及配套 RL 研究資源,分享經過驗證的訓練實踐,以下是詳細開源內容:
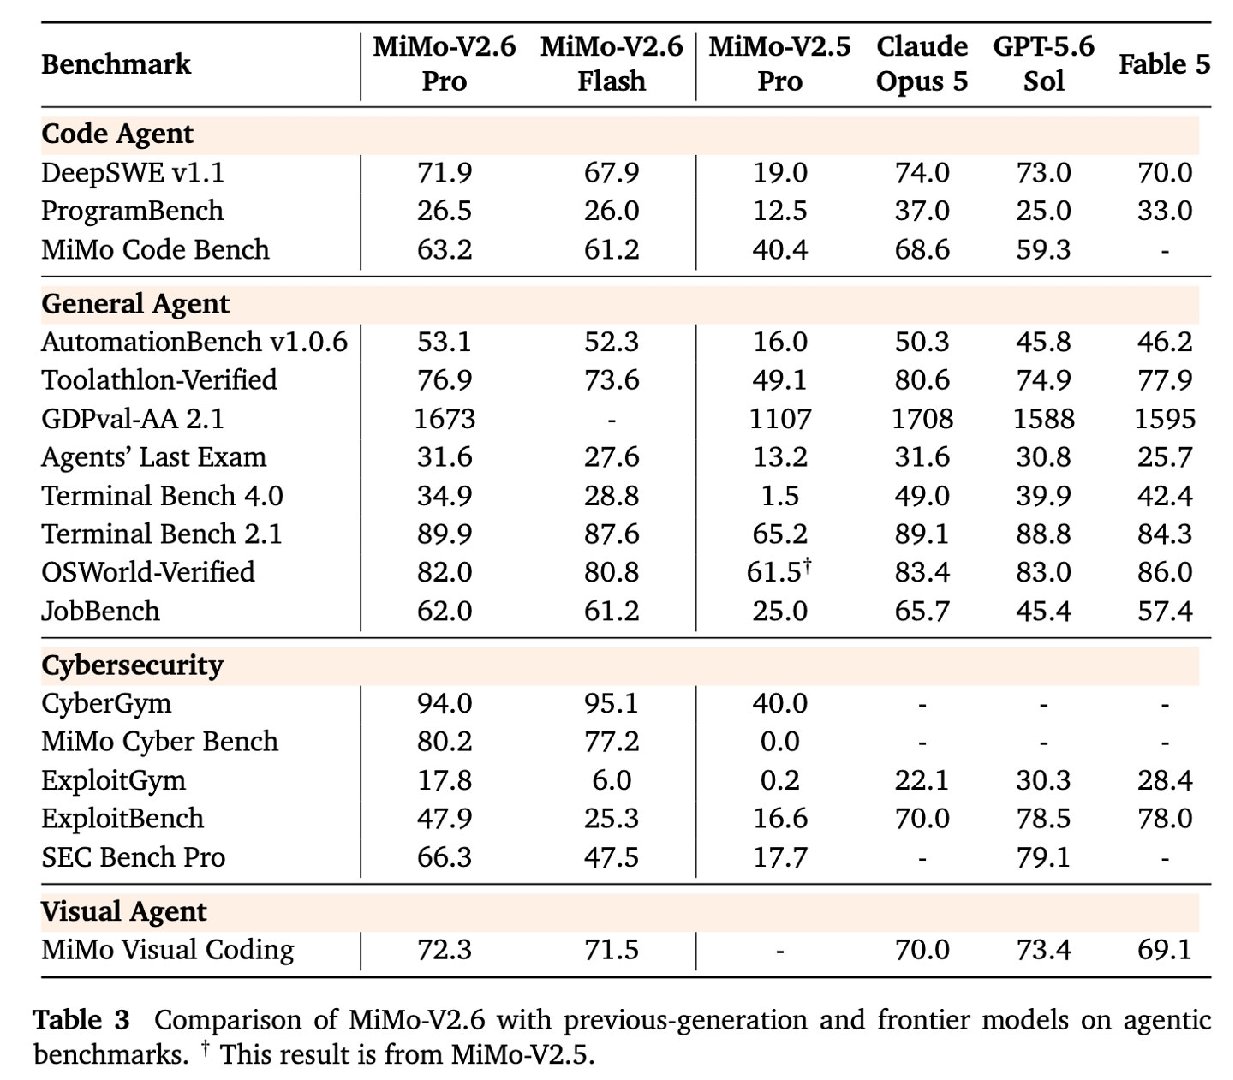
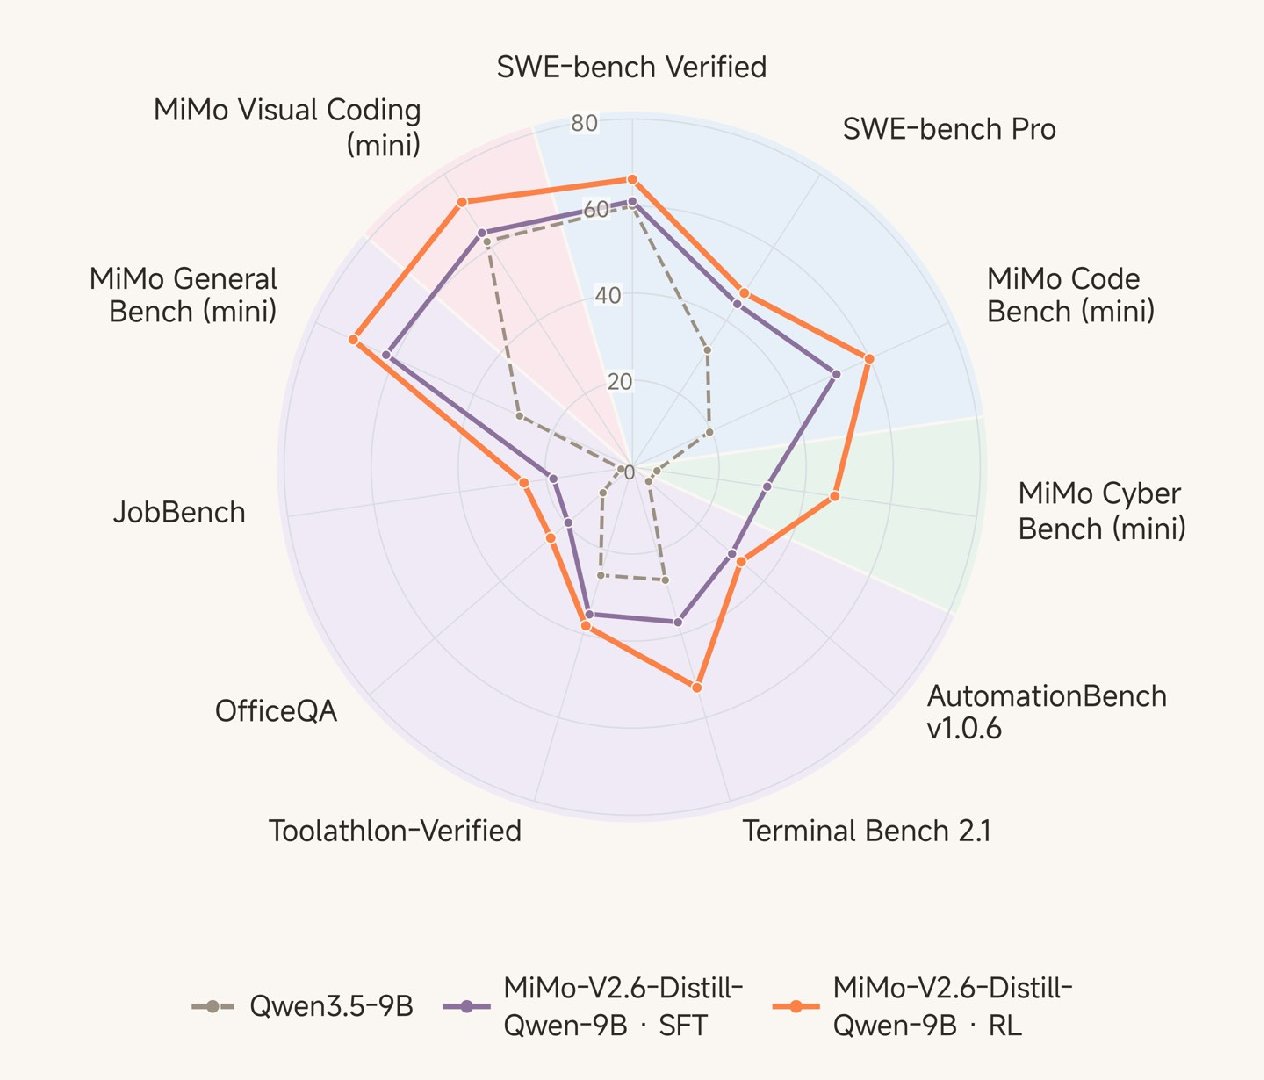
7k+ 高質量 RL 任務環境:覆蓋軟件工程、漏洞復現、知識型工作、網頁設計開發四類智能體任務。以 MiMo-V2.6-Distill-Qwen-9B 爲起點展開 RL 訓練,在 11 項評測中均較 SFT 基線取得提升:SWE-bench Verified 從 61.1 提升至 66.2,MiMo Cyber Bench 從 31.3 提升至 47.0,Terminal Bench 2.1 從 37.1 提升至 52.8,MiMo Visual Coding 從 64.0 提升至 72.4;
端到端 RL 訓練框架:基於 verl、uni-agent 和 mini-swe-agent,覆蓋環境交互、軌跡採集、獎勵評估與策略優化的完整訓練流程。結合開放的模型與任務環境,支持社區圍繞訓練算法、獎勵機制和 agent harness 開展研究與迭代;
輕量可組合的 Harness:開源極簡 mini-harnesses,將系統提示、工具與上下文管理解耦,構建多樣且可控的訓練配置。通過 Multi-Harness Training,能夠將多樣性和整潔性納入 RL 訓練,提升模型在不同框架、包括未見框架上的泛化能力,支持社區自由組合框架組件、拓展訓練配置,持續探索新的研究方向。
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com