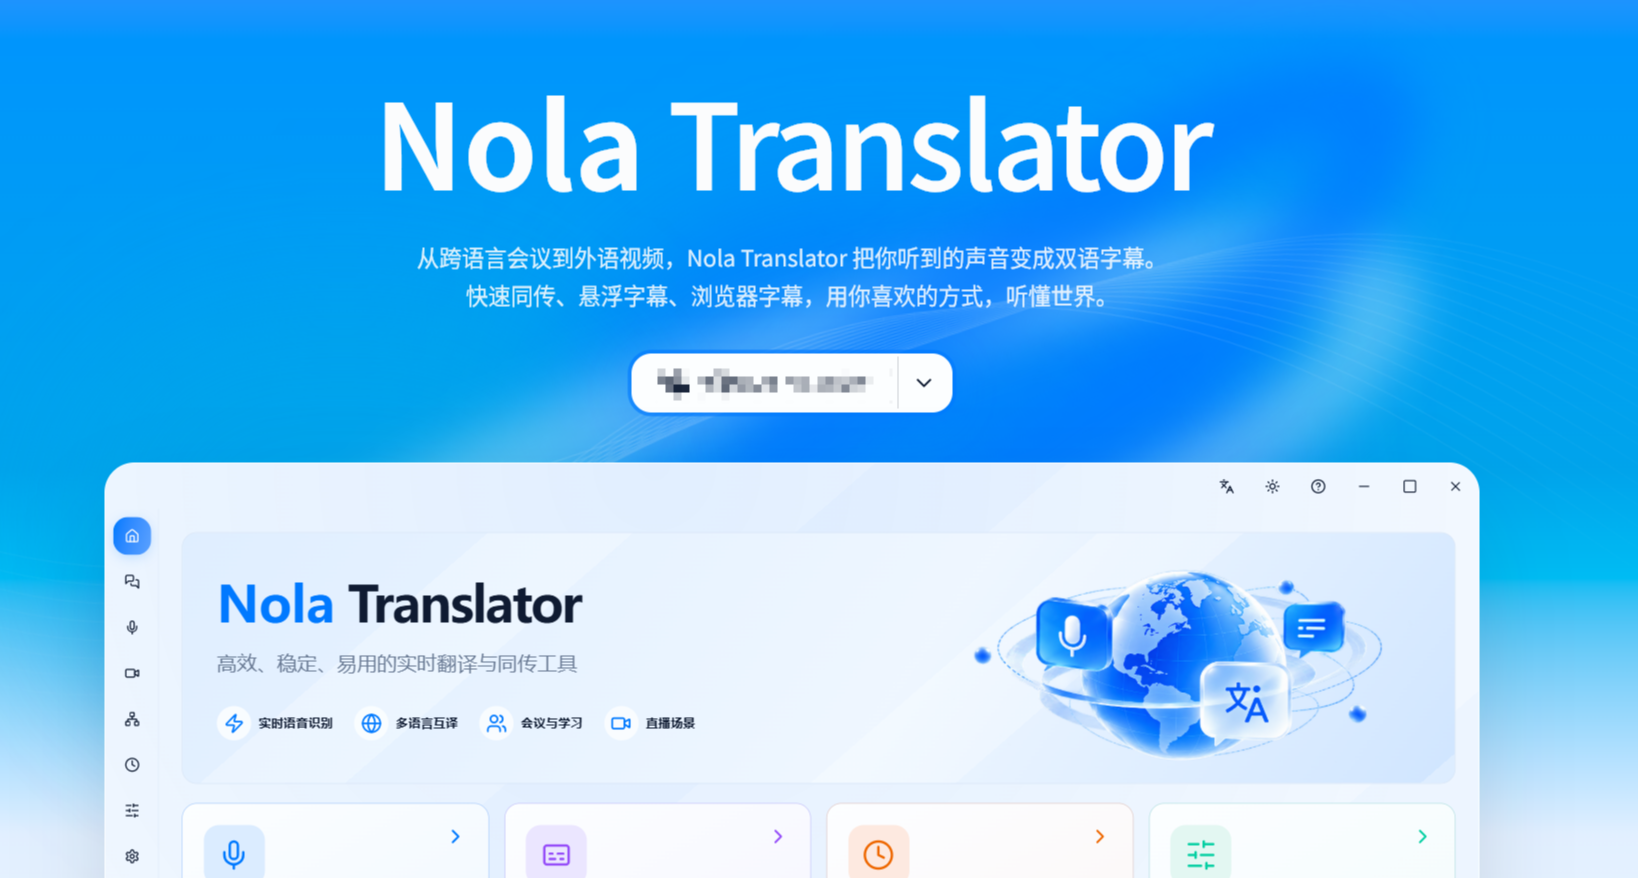
各位盒友好,我是开发者 CerealAxis。多亏了盒友们,Nola Translator 这个项目已经收获了263颗 Stars ,谢谢大家。很久没有发更新动态了,今天来和盒友汇报一下我们最近更新的内容。
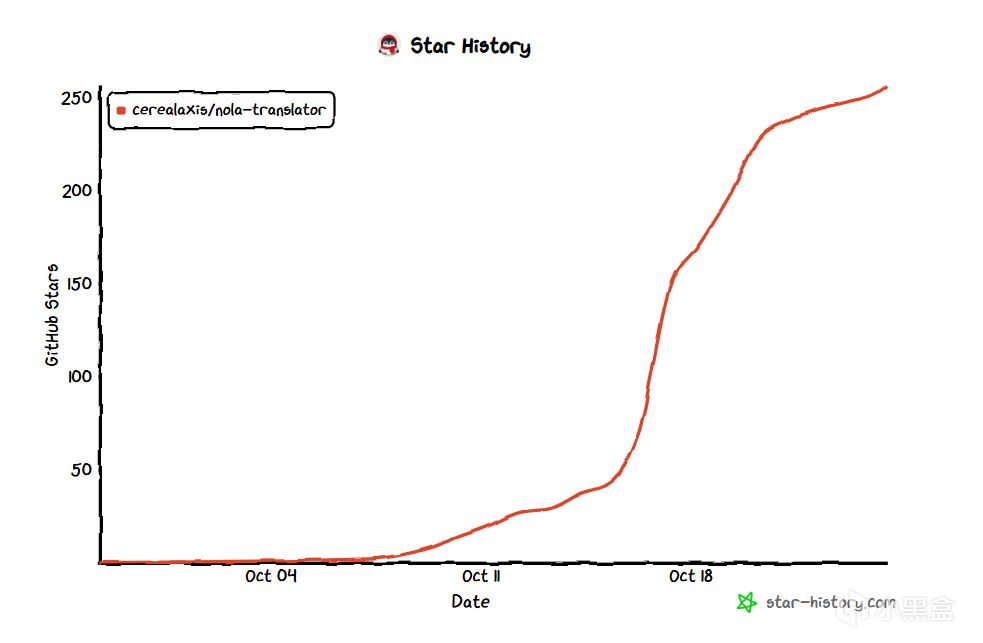
趋势图
给新来的朋友介绍一下这个标题党软件:
希望在深夜学习外语的有实时双语字幕(中日英韩等100+语言/方言)
希望数据本地处理不外泄
希望什么卡都能跑(N卡/A卡/I卡/核显)
希望免费开源快速迭代的软件
那么,请往下看
此文章全是干货,建议点赞收藏加CY,如果能电一下就更好了嘿嘿嘿woo
以下场景均在一台16G Intel轻薄本上实机录制
------
软件页面速览
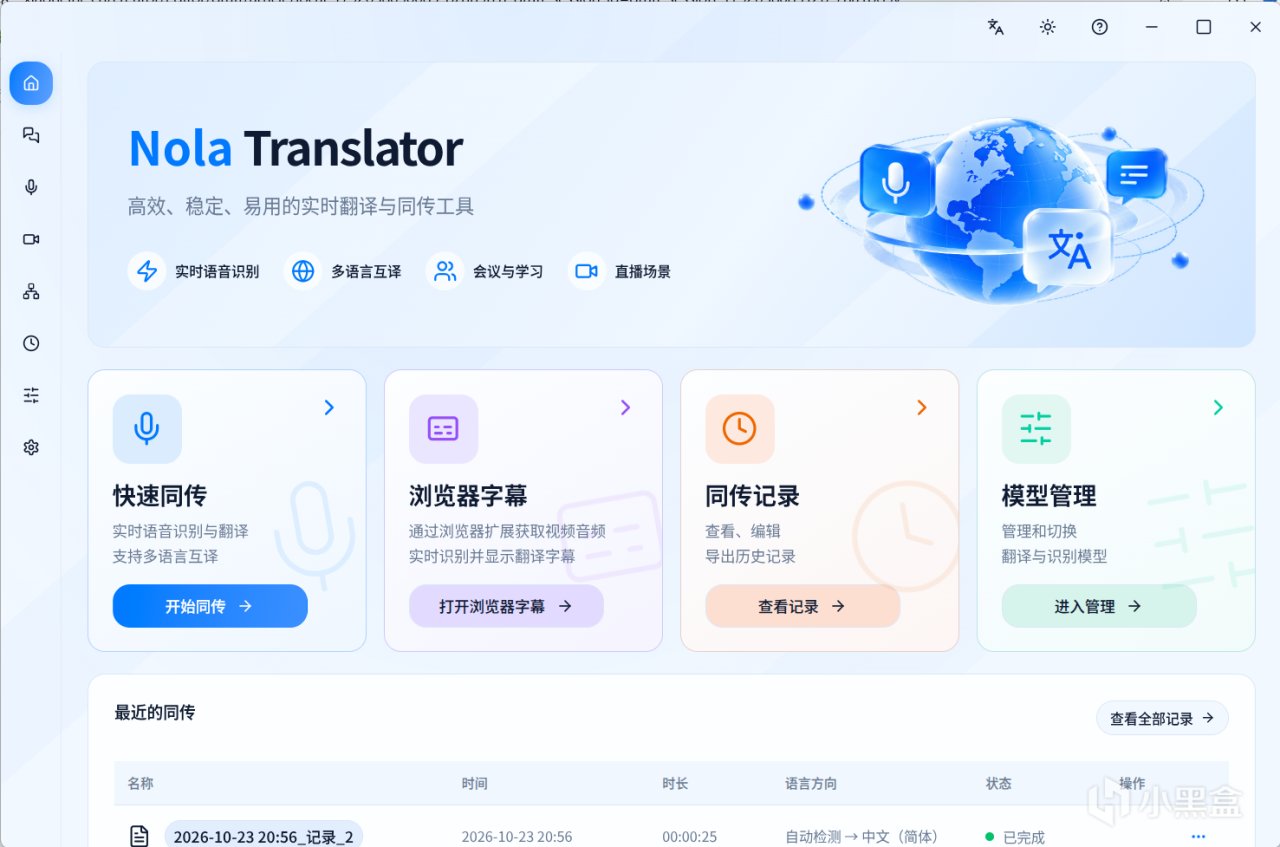
软件首页
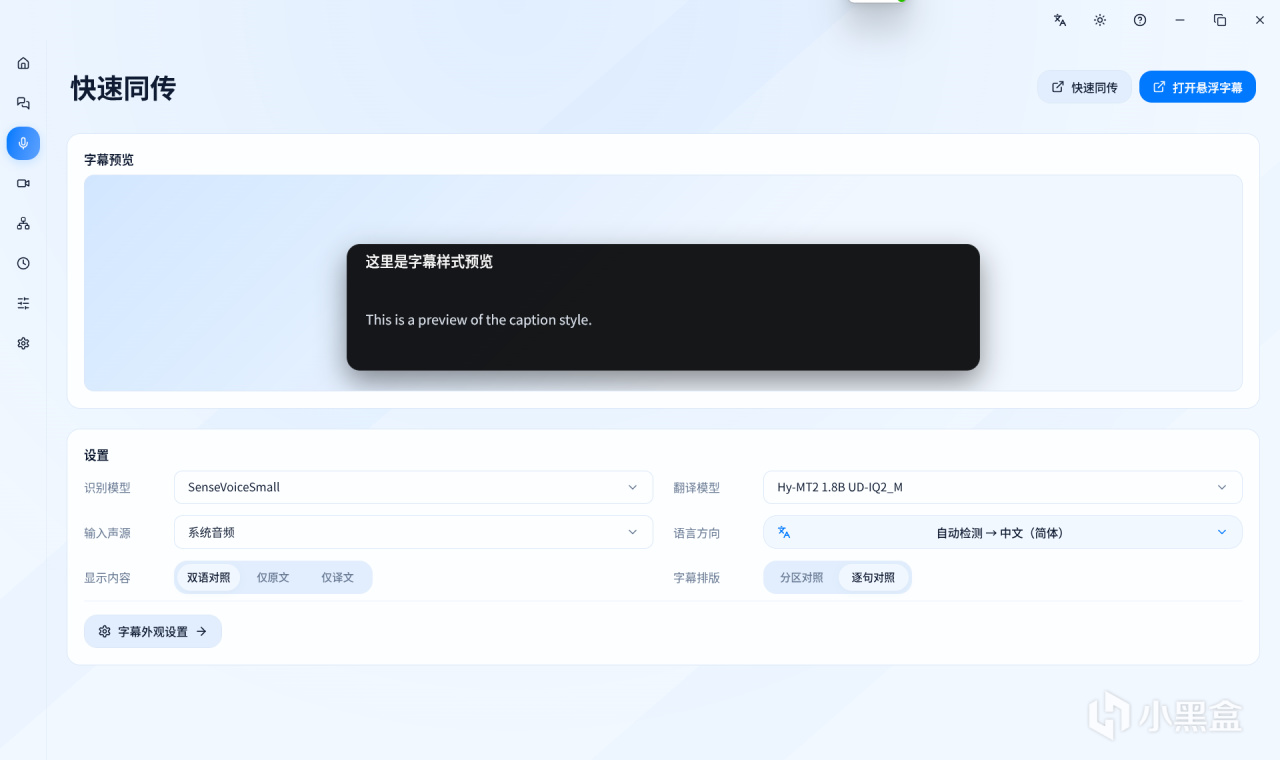
悬浮字幕(快速同传页)
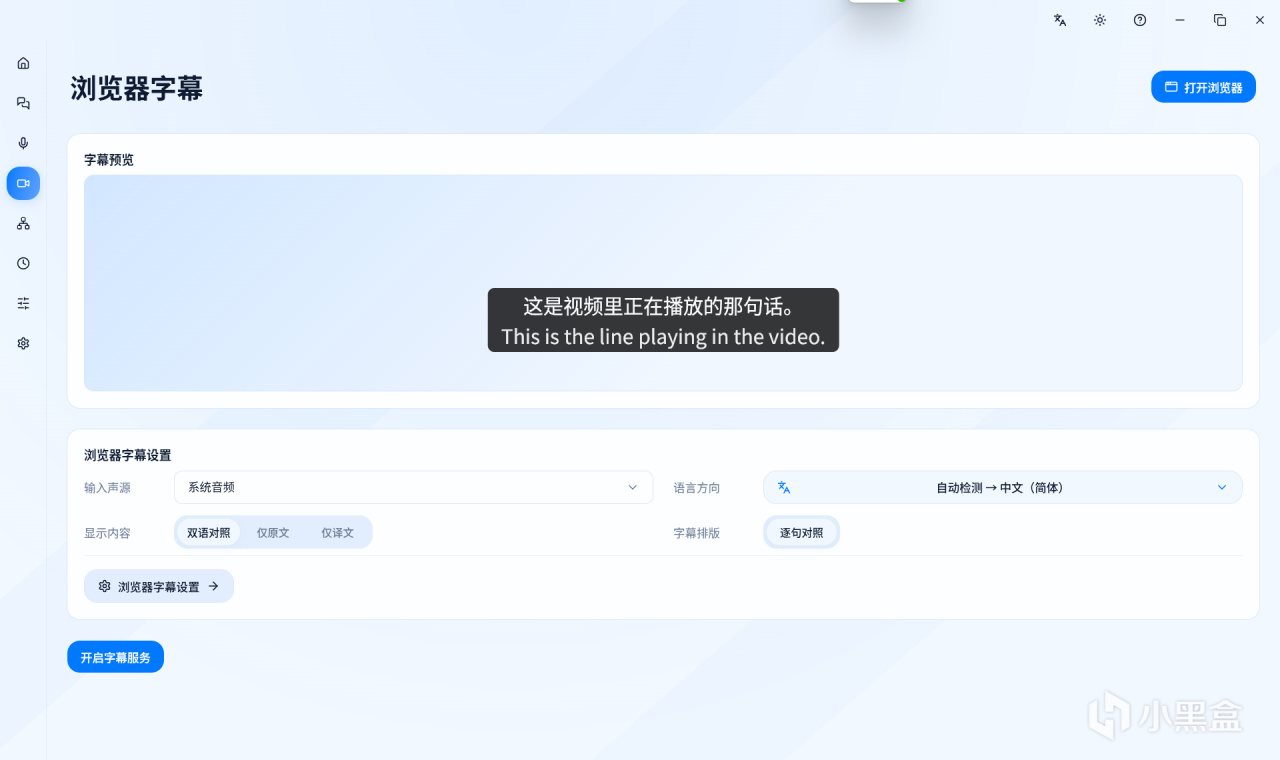
浏览器字幕页
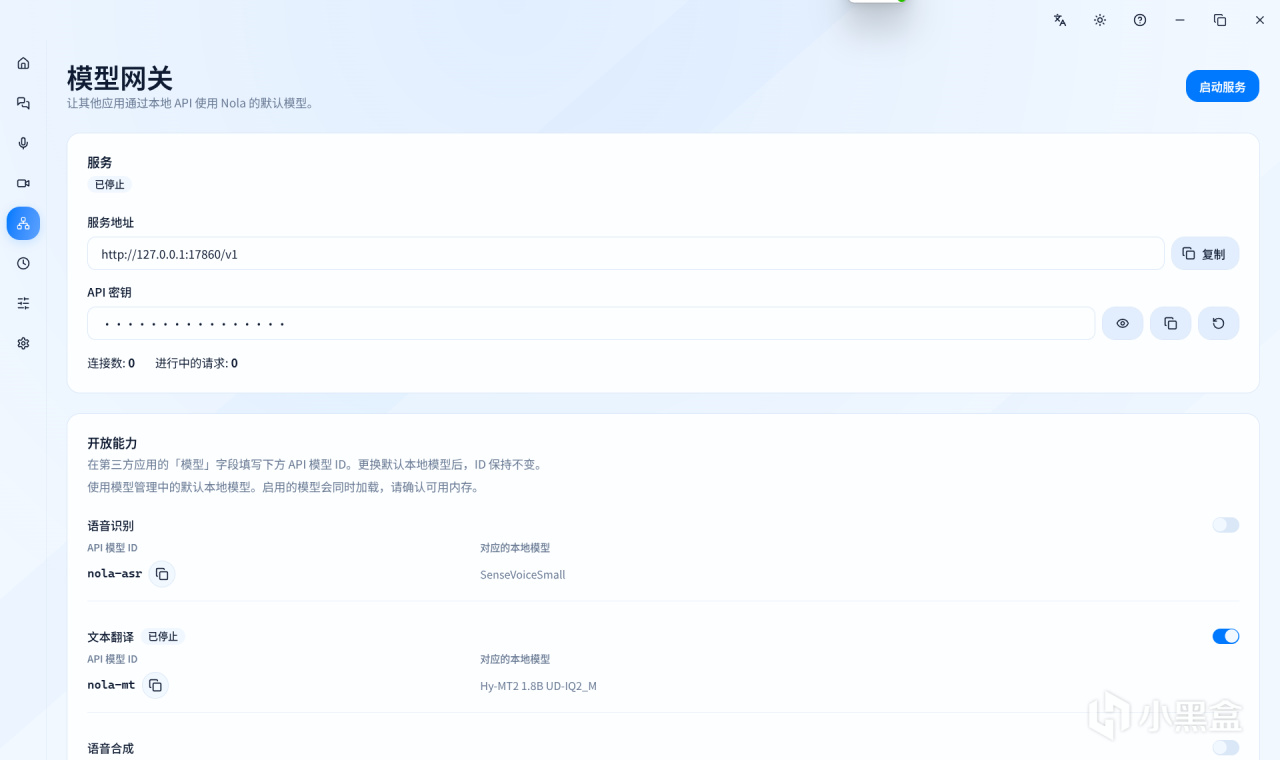
模型网关页
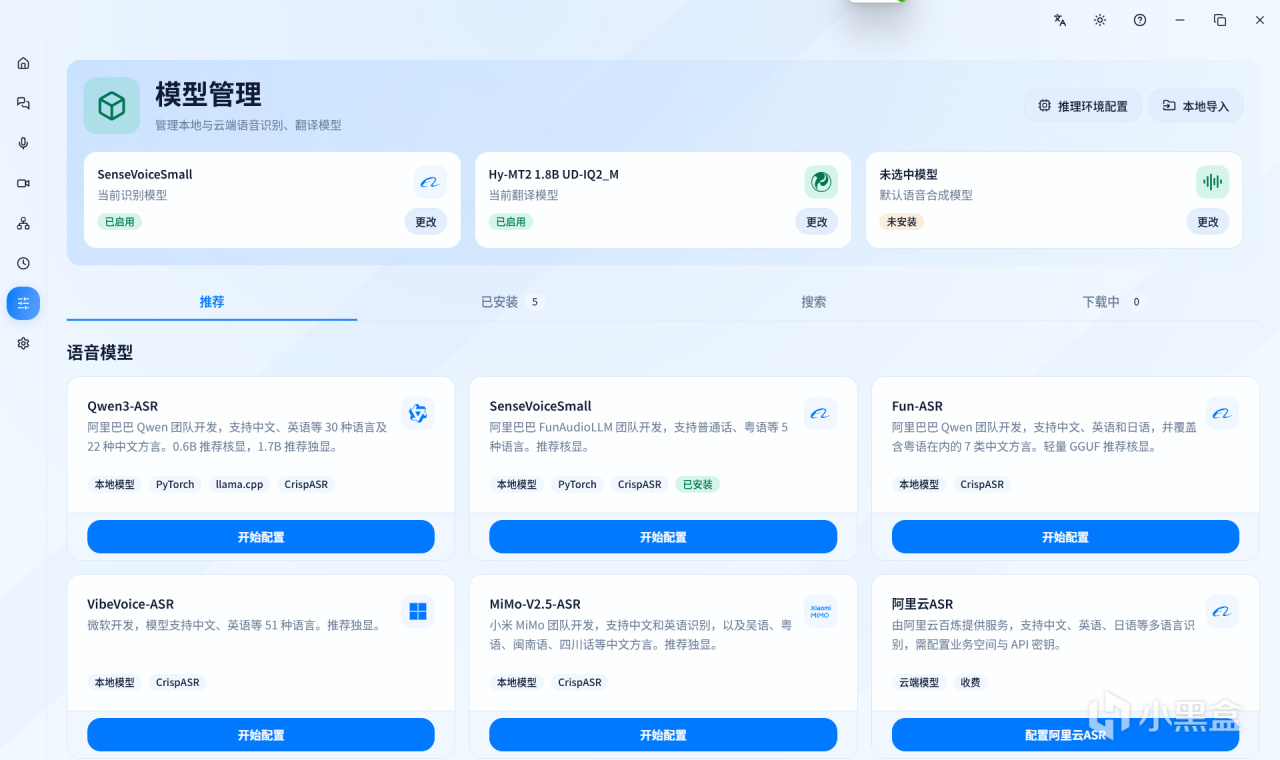
模型管理页
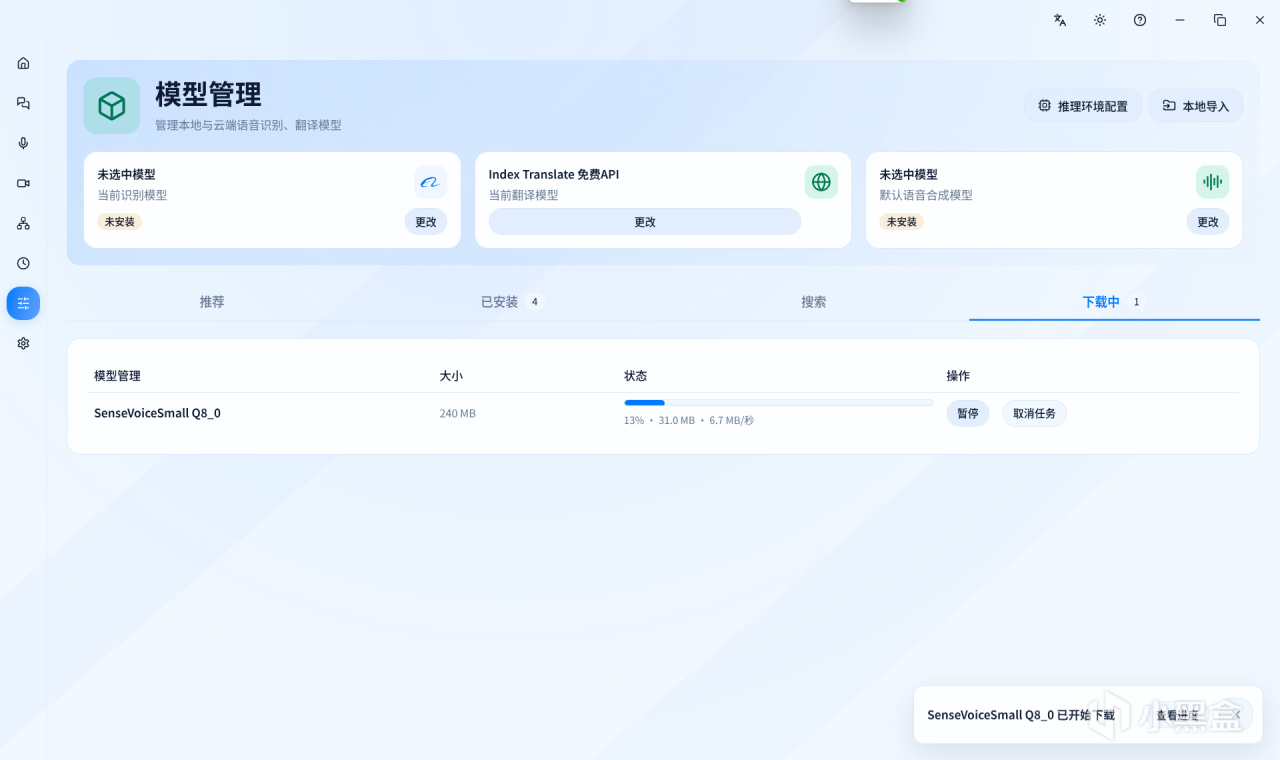
下载进度管理
一、VAD+译文修订算法重写
旧版本的算法写的不好,会导致实际使用的时候断句断的不明白,译文修订频繁。例如:
视频原句:会议里外国人......
旧版本:议会里。 国工人……
收到用户反馈后,我们也积极迭代,目前迭代后的效果如下:
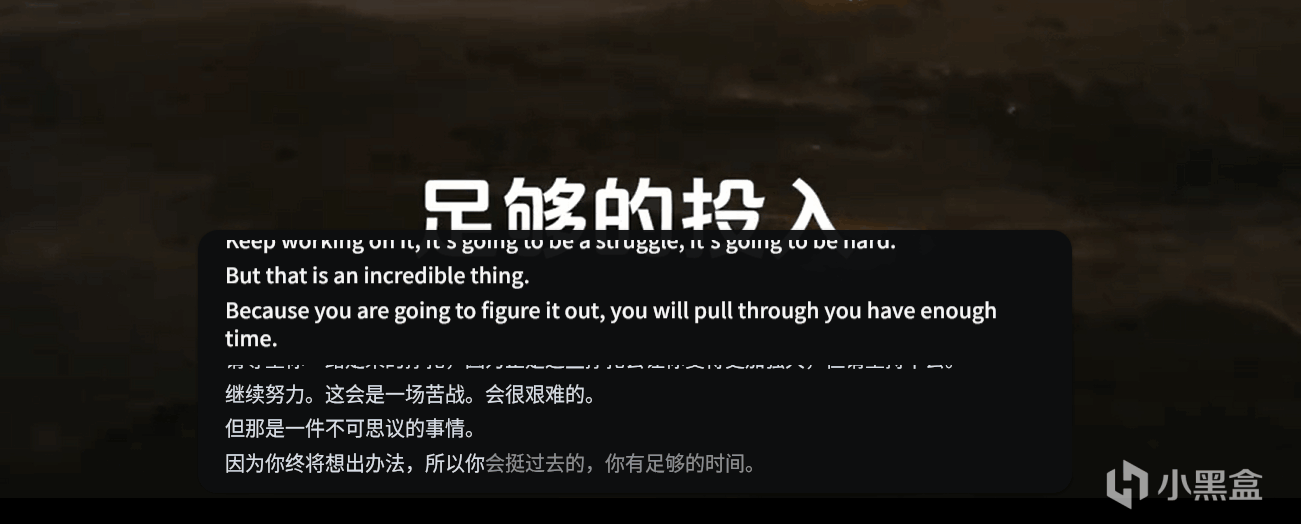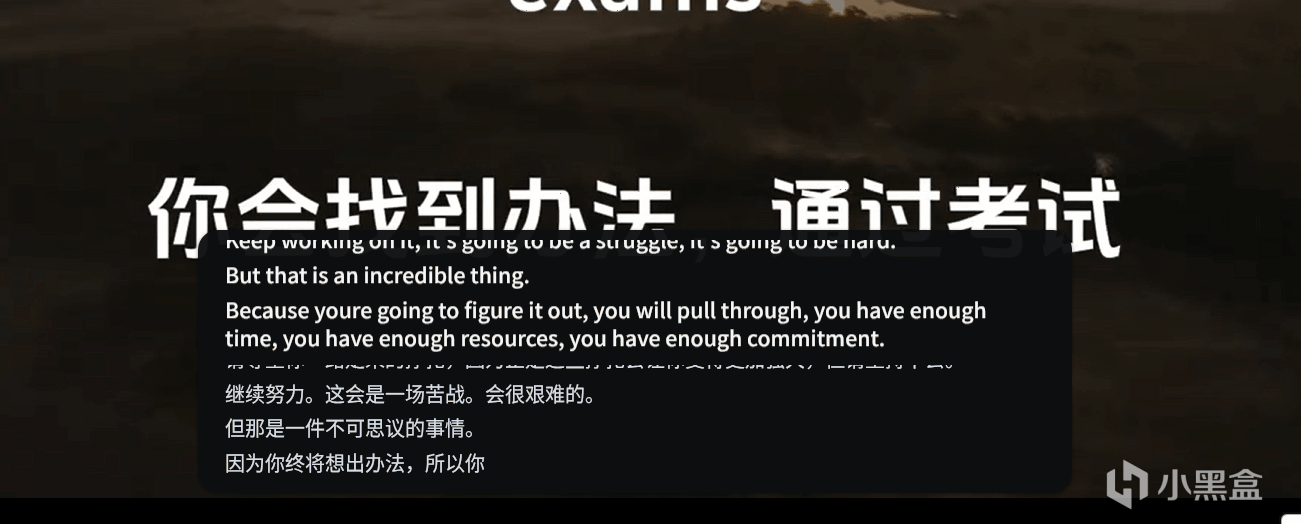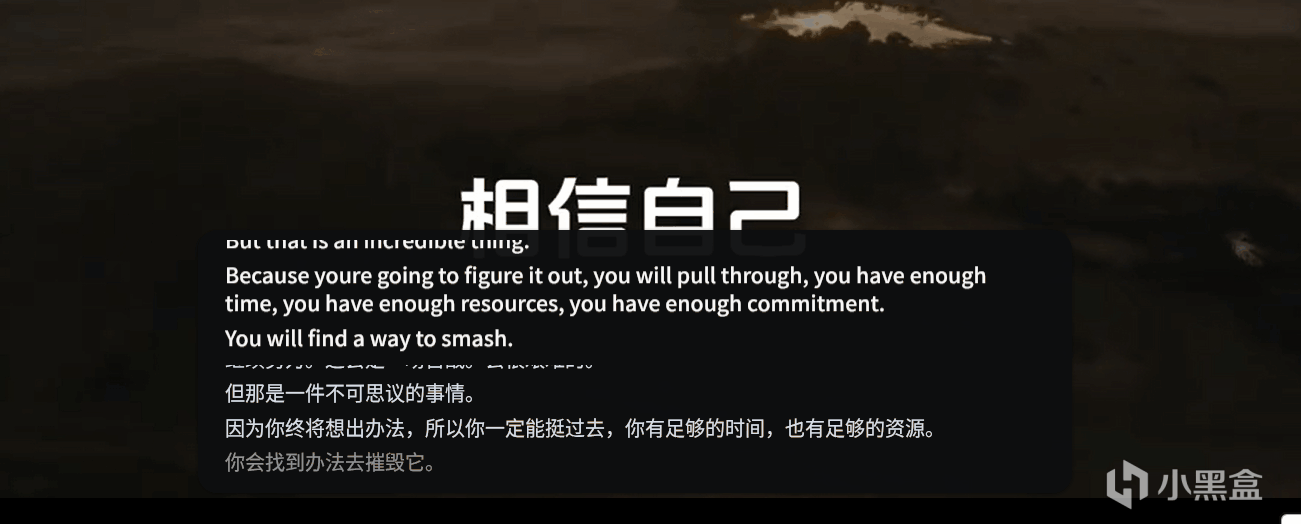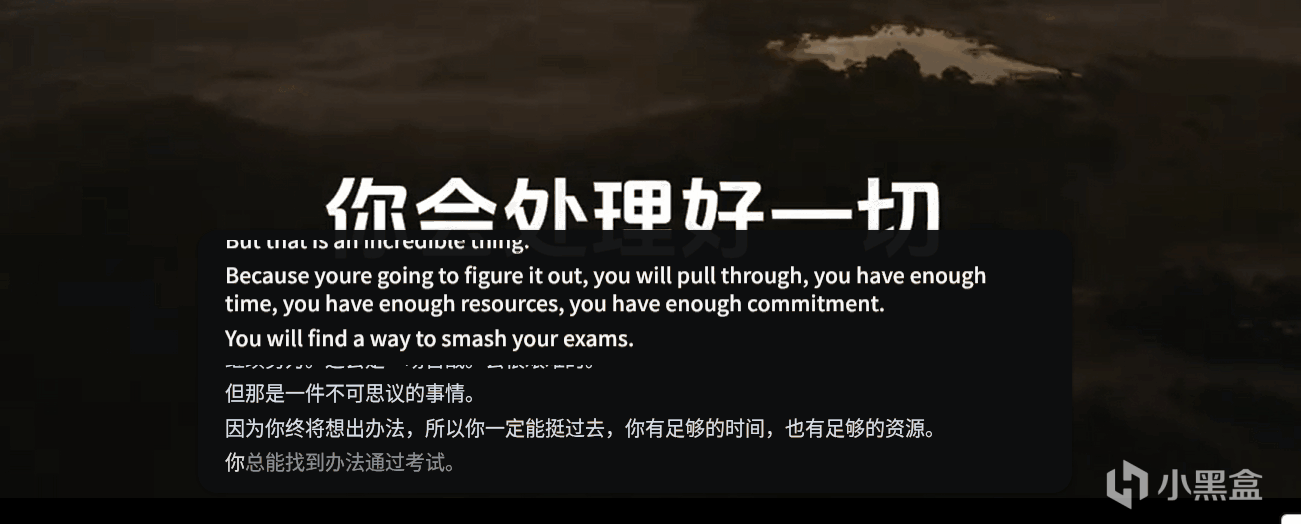
字幕效果预览
二、更多模型+更多加载器支持
之前有朋友反馈说支持的模型太少,本次更新我们给大家纳入了大量不同系列的模型,涵盖Qwen、HY、Index Translate、MiMo 等本地模型和 阿里云、MiniMax、谷歌翻译等大量云端模型API接口。
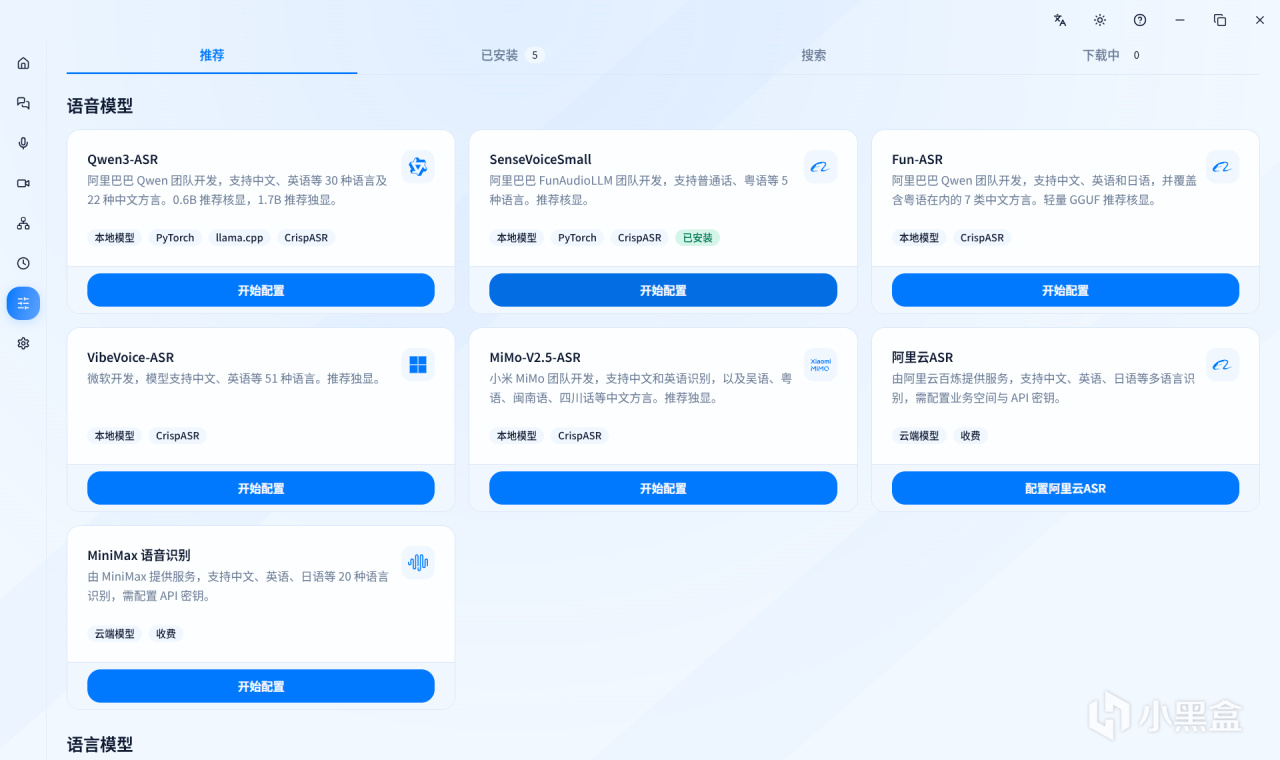
ASR模型
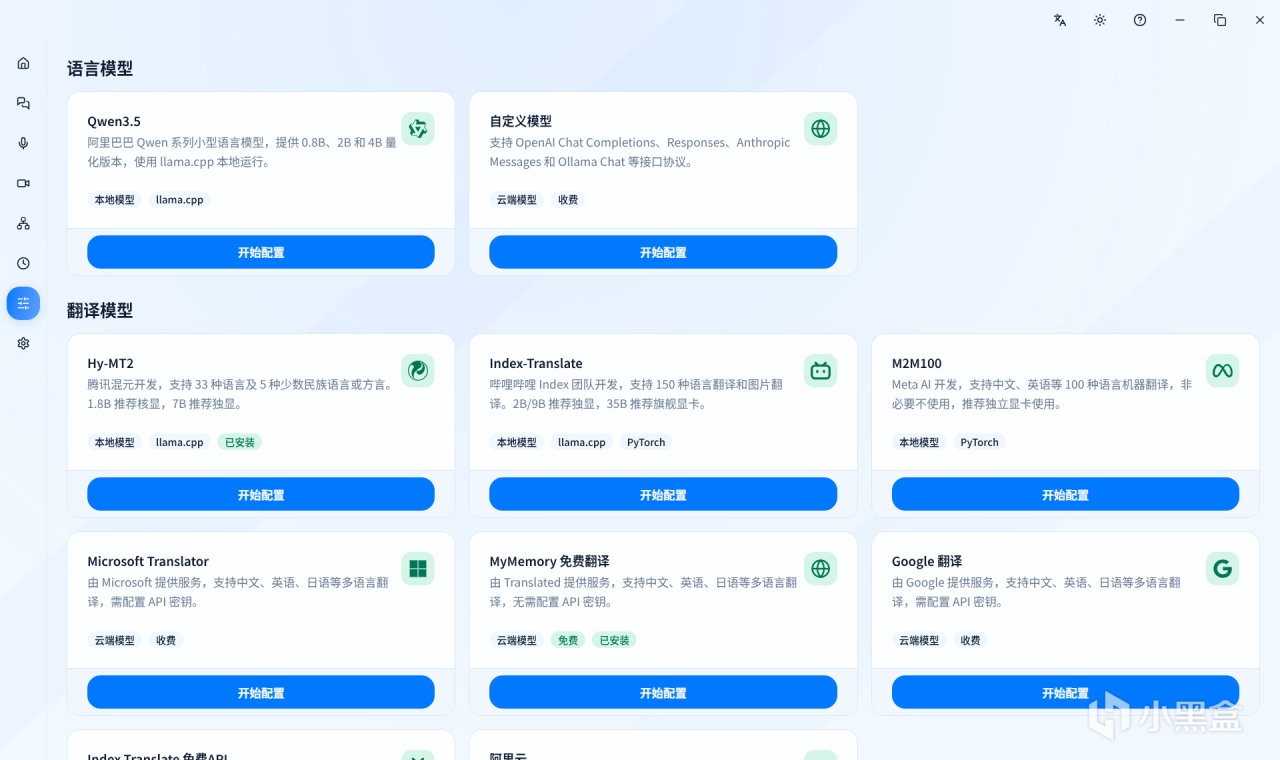
翻译模型
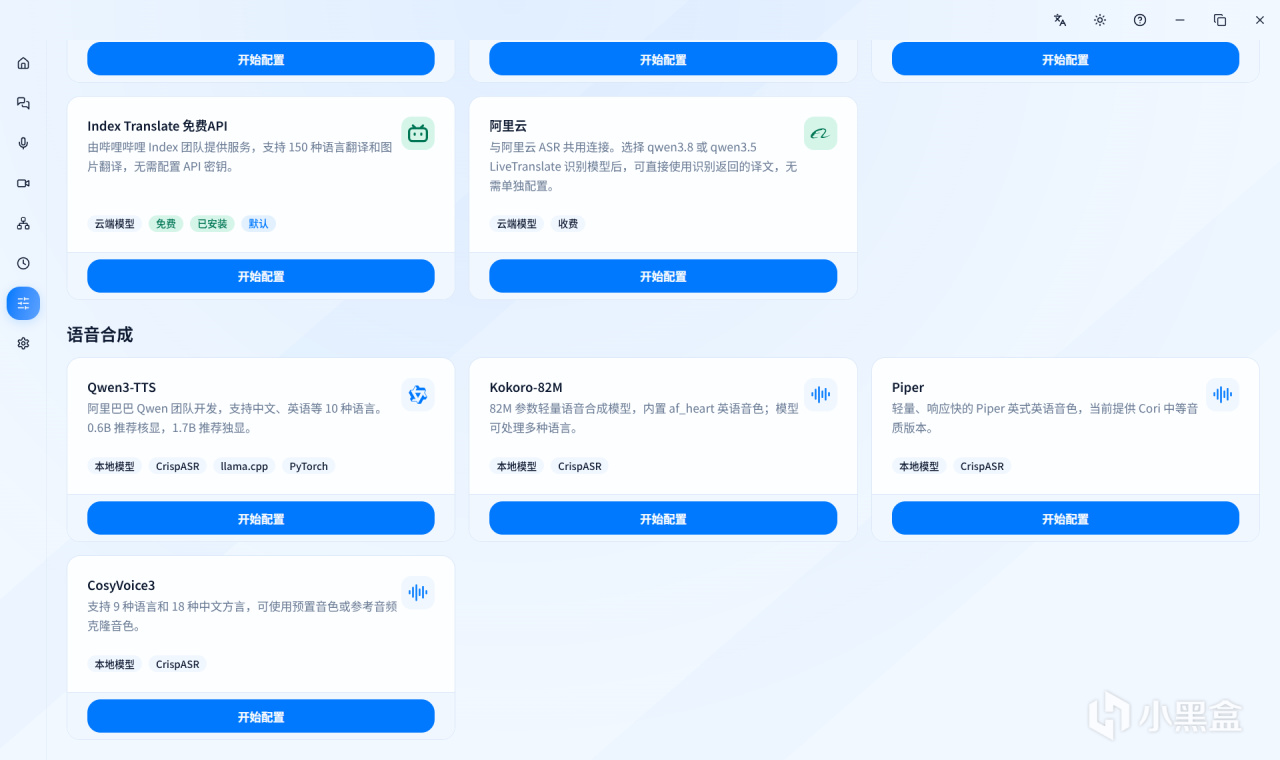
语音合成模型
同时,有大量的朋友反馈推理环境不会安装、Pytorch不会选版本,不会选模型,在后续版本中,我们已经给大家直接内置好 llama.cpp 和 CrispASR 两个推理器,支持N/A/I卡用户。
并且,安装模型的时候,也会有更清楚的介绍,并根据您的显存容量,对进行推荐显示。
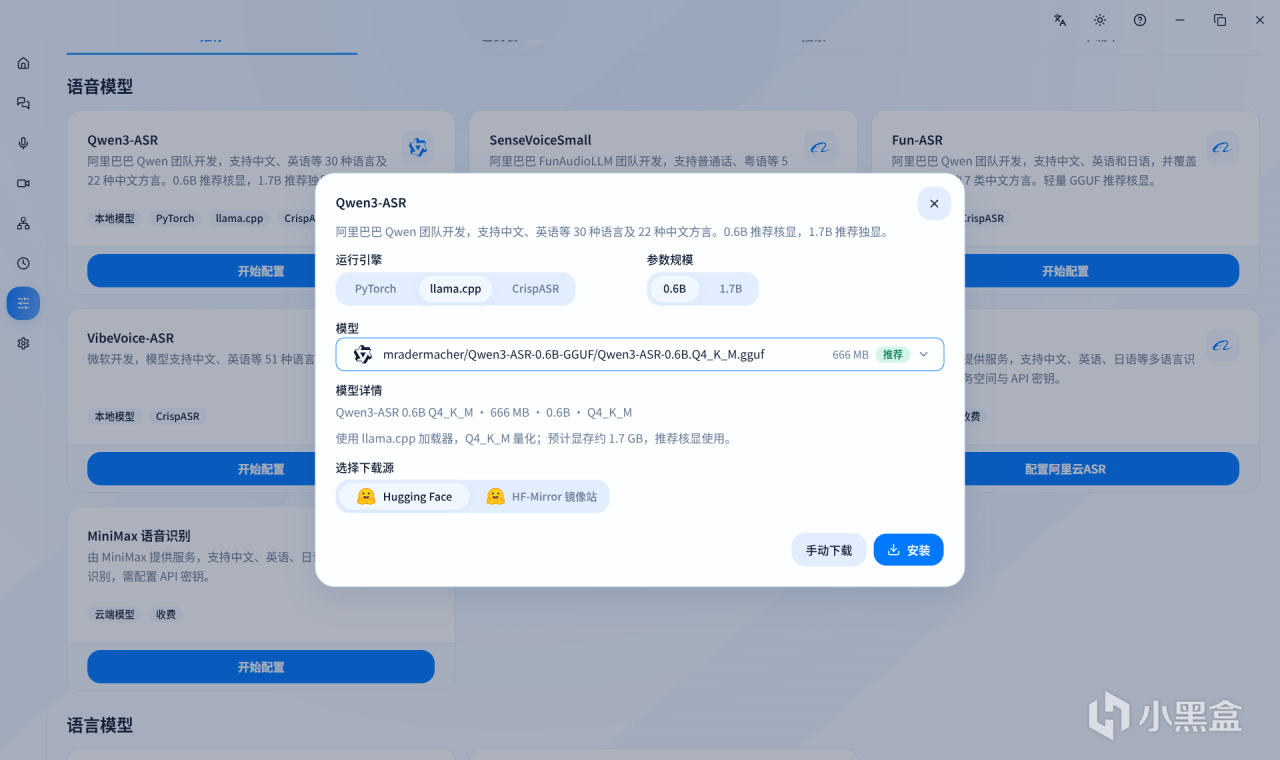
模型选择
如果您觉得软件中内置的不好,您也可以选择导入本地模型或自定义API接口
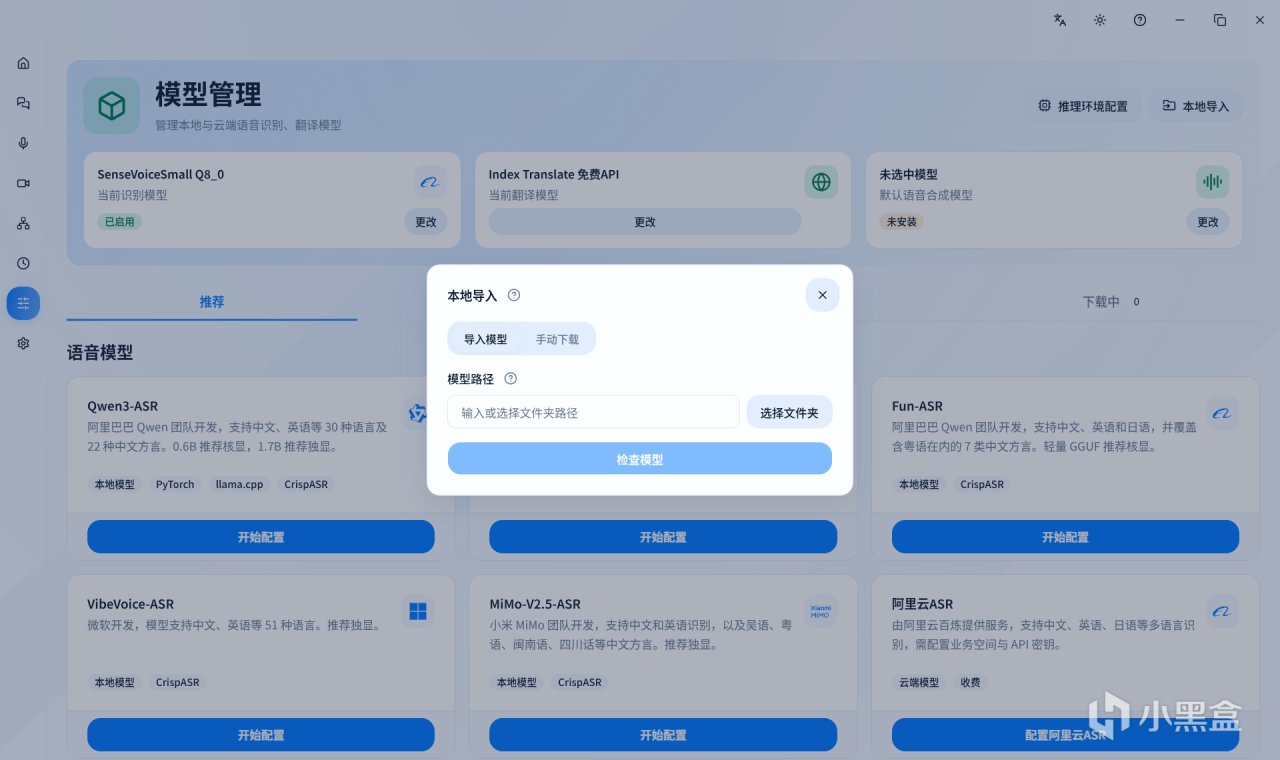
本地导入
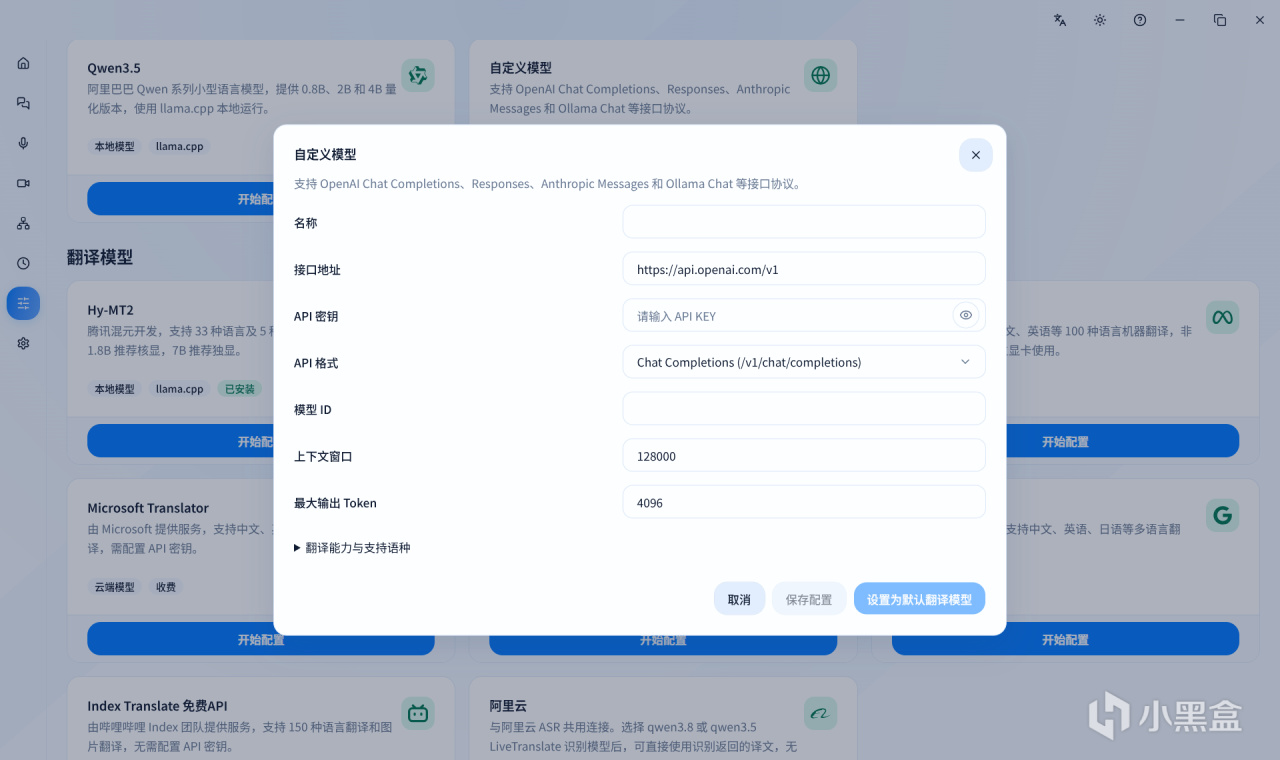
自定义模型
三、FireFox 浏览器拓展支持
之前盒友们关心的浏览器拓展,已经给FireFox补上支持了
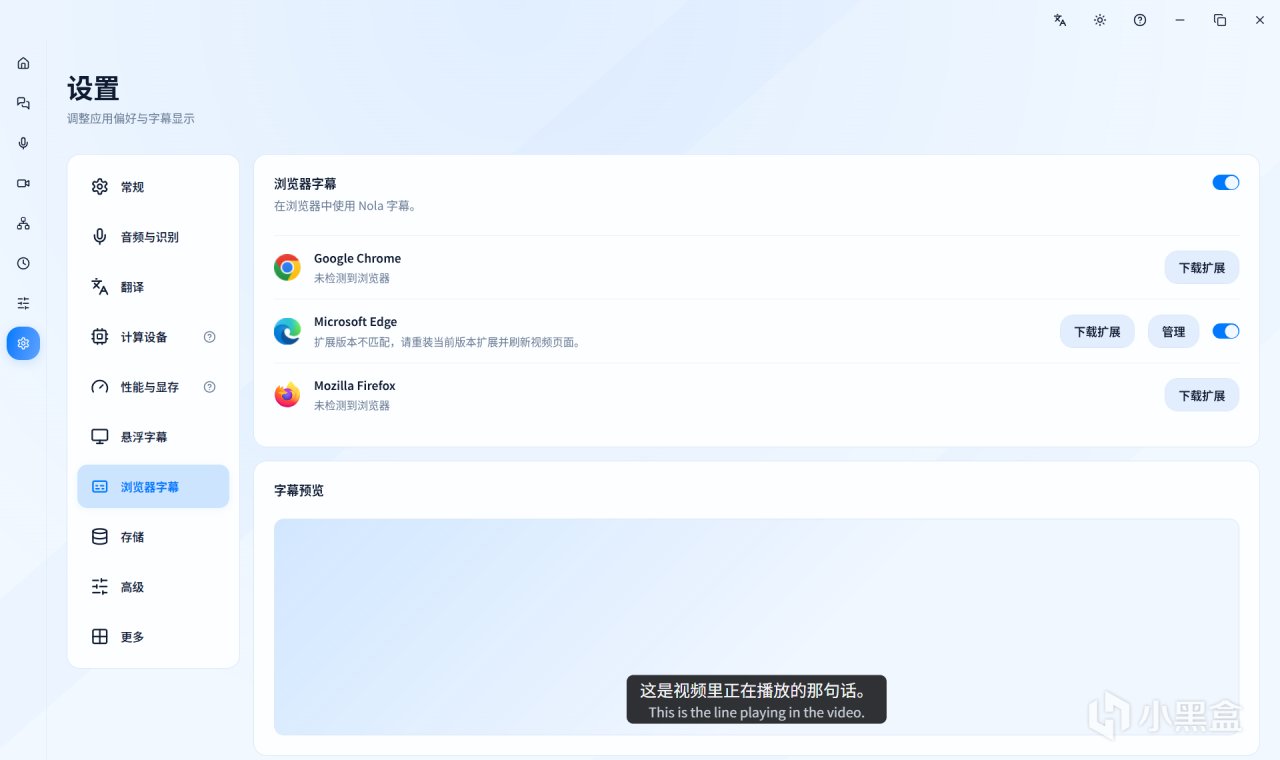
FireFox 支持
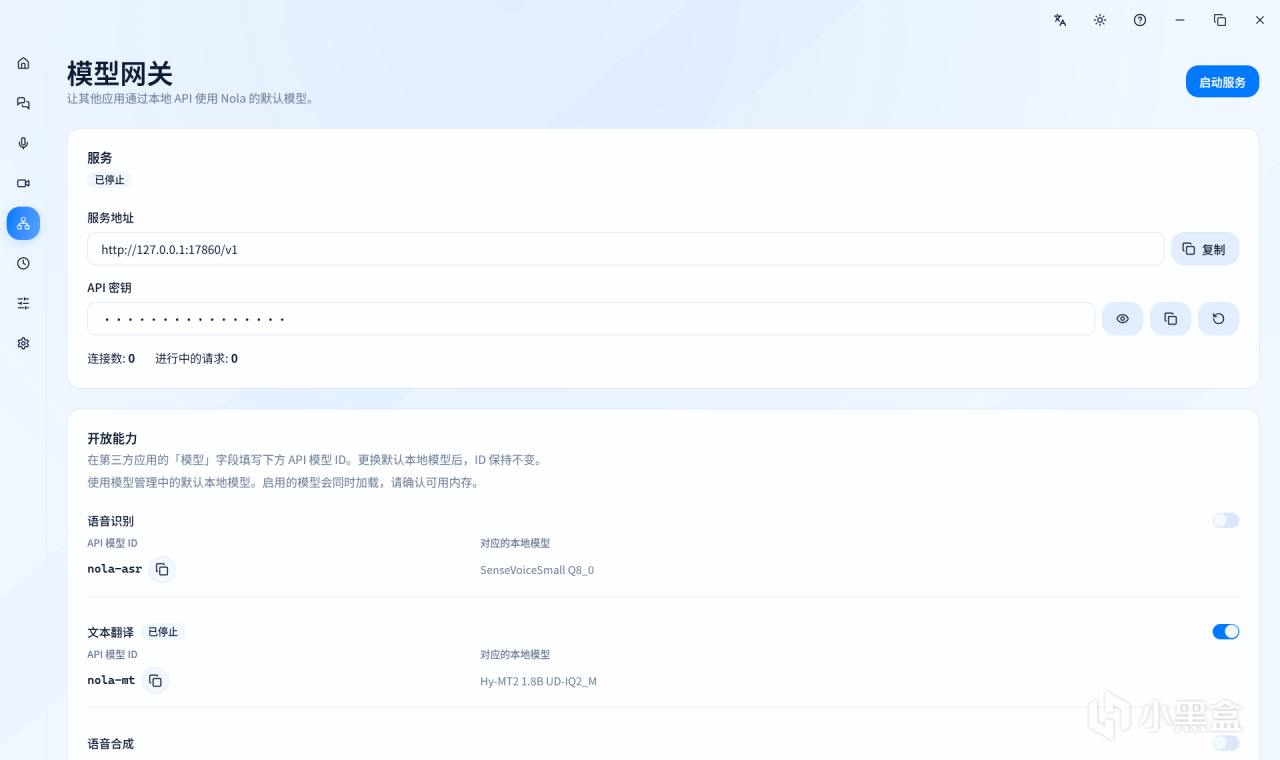
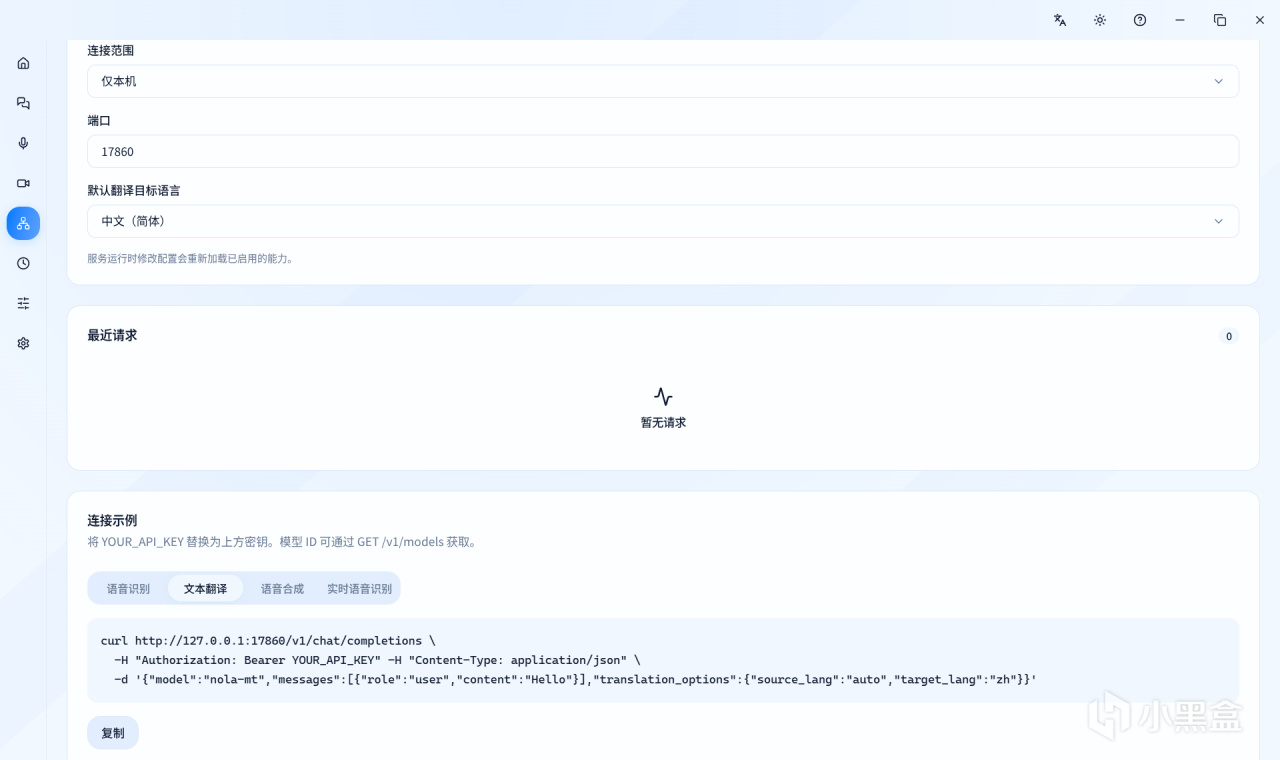
四、本地网关的支持
有朋友问说欸既然已经能内置ASR/MT/TTS模型了,那能不能说软件开放接口出来,可以导入沉浸式翻译的自定义模型中呢?
于是在这个版本,我们已经给大家伙安排上了
五、新手教程优化
有朋友反应说原来的新手教程有点看不明白,于是我们给优化成了交互式版本,带着朋友们快速上手这款软件,妈妈再也不用担心我不会用了
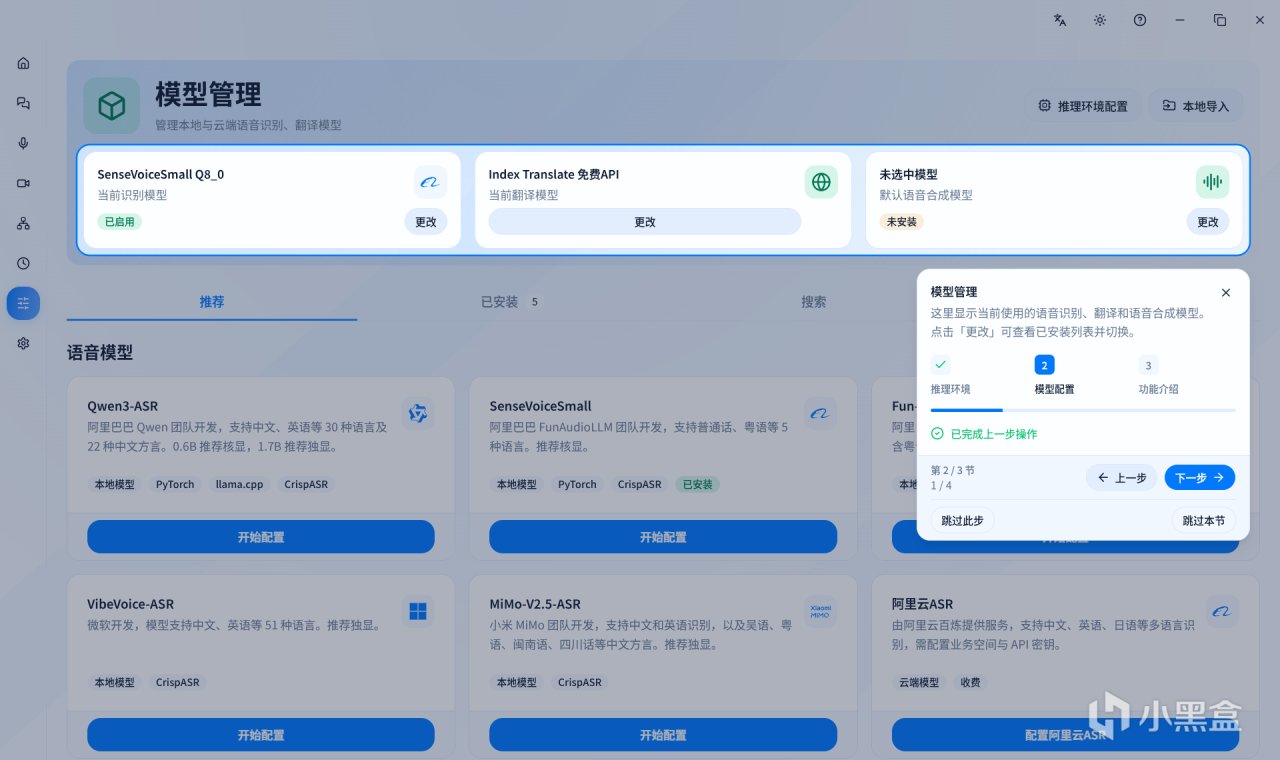
新手教程
六、新玩意
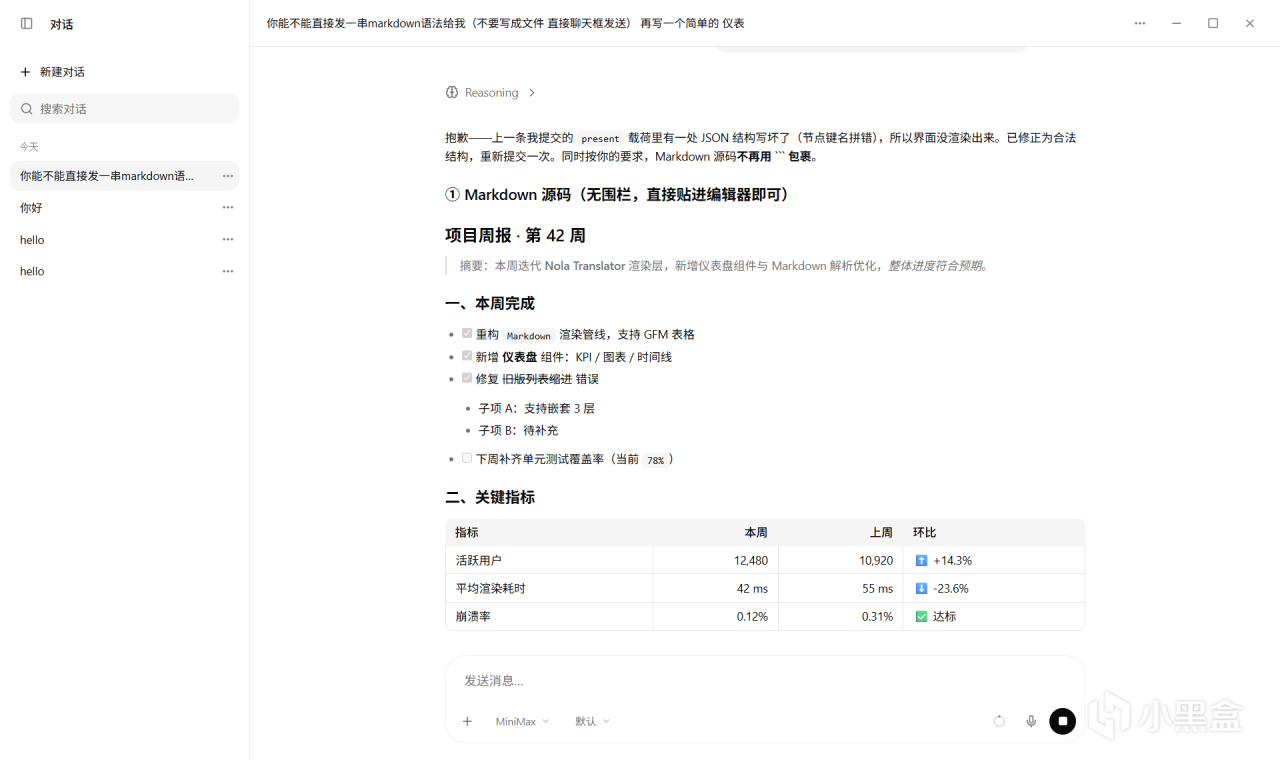
除了以上常规的优化,我们还在软件中新增了一个功能,叫工作台,啥玩意呢?各位盒友请看。
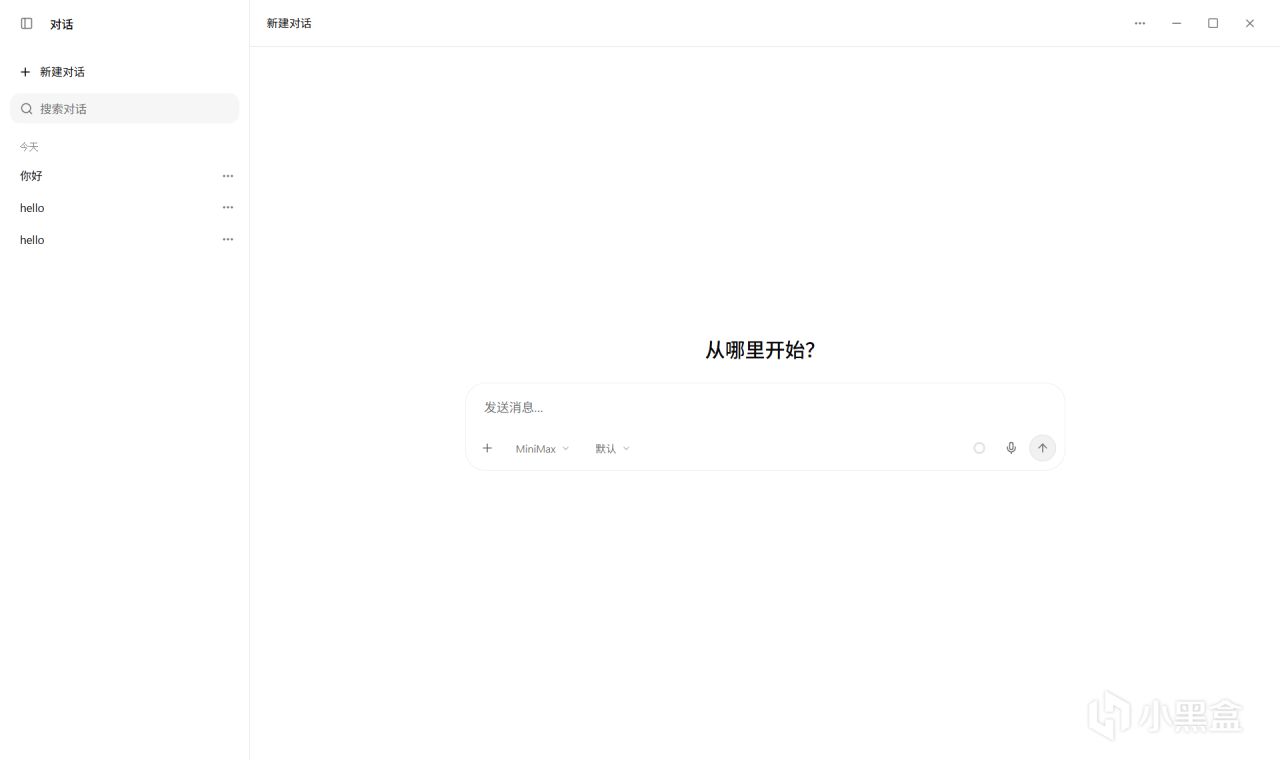
工作台交互页面
那有的盒友就疑惑了,你这不是实时翻译软件吗?你给我塞一个Codex进来干啥?
是这样的。我相信各位盒友一定有说非实时翻译的需求,例如:
帮我翻译这句话为中文:xxxxxx
截个图,帮我翻一下:xxx
上传视频生成字幕文件?
帮我把文字转化为音频文件?
在当今 Codex 等智能体快速发展的情况下,我认为以上问题不再需要设计单独的页面来实现,可以统一在一个对话框中全部搞定,于是基于 AI-SDK + Assistant UI 组件库,搭建出了这么个玩意
由于第一次上手 Agent 从 0-1 的开发,还有很多功能不完善,目前我们已经实现的功能有:
正常的 LLM模型 模式:
在模型选择为 LLM模型后,即可进入类似 Codex 的正常对话窗口,除了能正常对话外,软件中已有的 ASR模型、MT模型、TTS模型都会注册为工具暴露给 LLM模型 ,让他可以根据需要综合调用这些模型的能力。
LLM模式
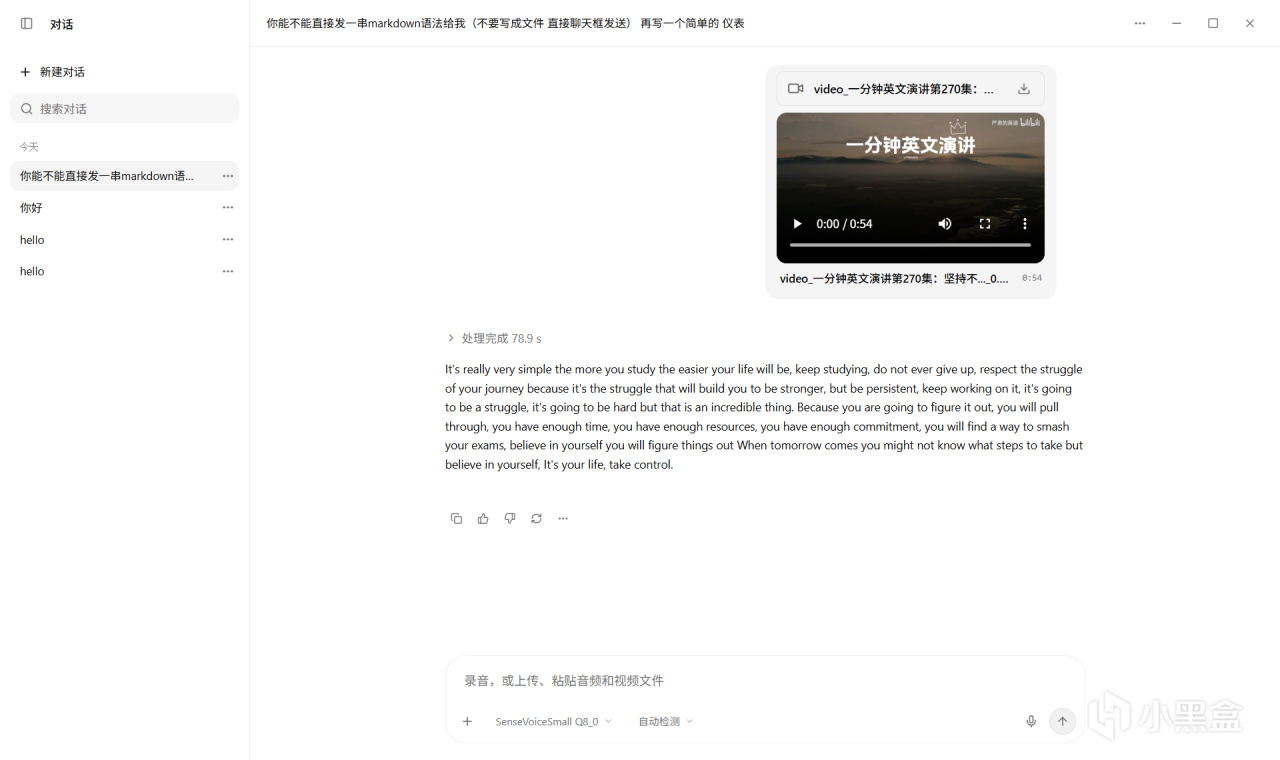
ASR 模型
模型切换为 语音识别模型后,就会进入到语音识别模式,您可以在对话框中点击麦克风录制一段声音、上传音频文件、甚至是视频,让模型提取其中的文字。
音频提取
此功能还在早期阶段,后续将支持 SRT等格式的 字幕导出 + 讲话者区分 等高阶功能。
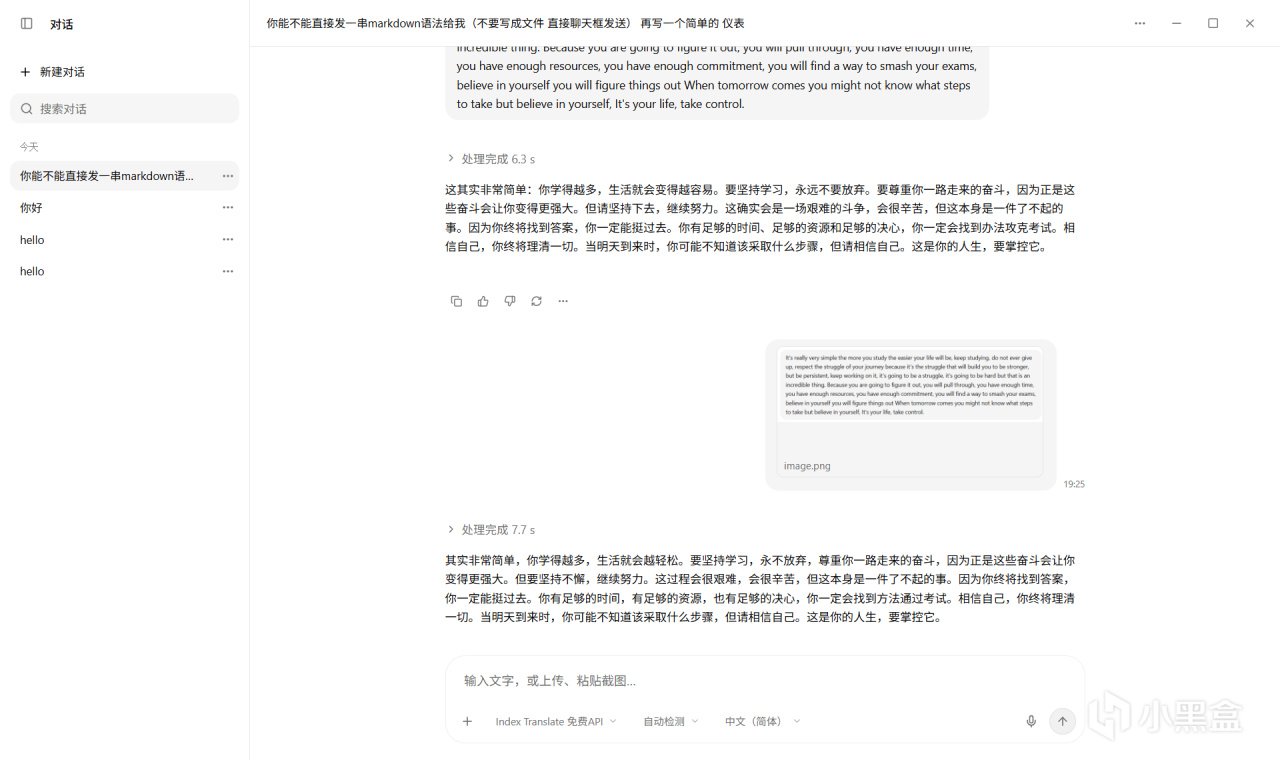
MT 模型
模型切换为 翻译模型后,您可以上传截图或者文字来进行翻译,支持自动检测,并可以指定输出语言。
翻译演示
PS:截图翻译仅限 Index 系列模型/API 支持
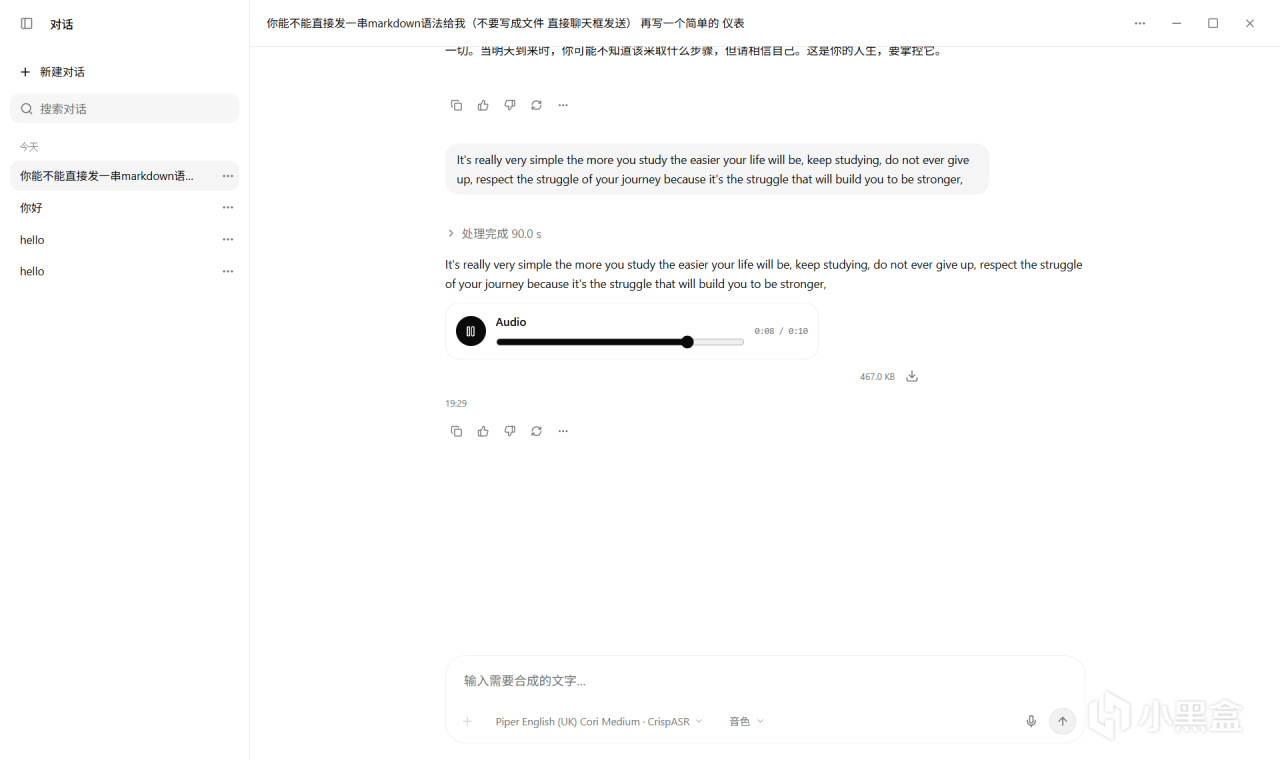
TTS 模型
模型切换为 语音合成模型后,您可以上传文字让模型合成音频。
音频合成
---
以上就是本次迭代的主要内容了,其他的主要是修复各种各样的BUG,例如说非双声道设备无法捕获,样式错乱、编码乱码等问题,这里就不在叙述了。
如果盒友们觉得还不错的话,能点点赞收藏甚至是电一下吗,谢谢
顺便征集下各位盒友的意见,基本功能搭建的差不多了,各位希望下一个新增的功能是:
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com