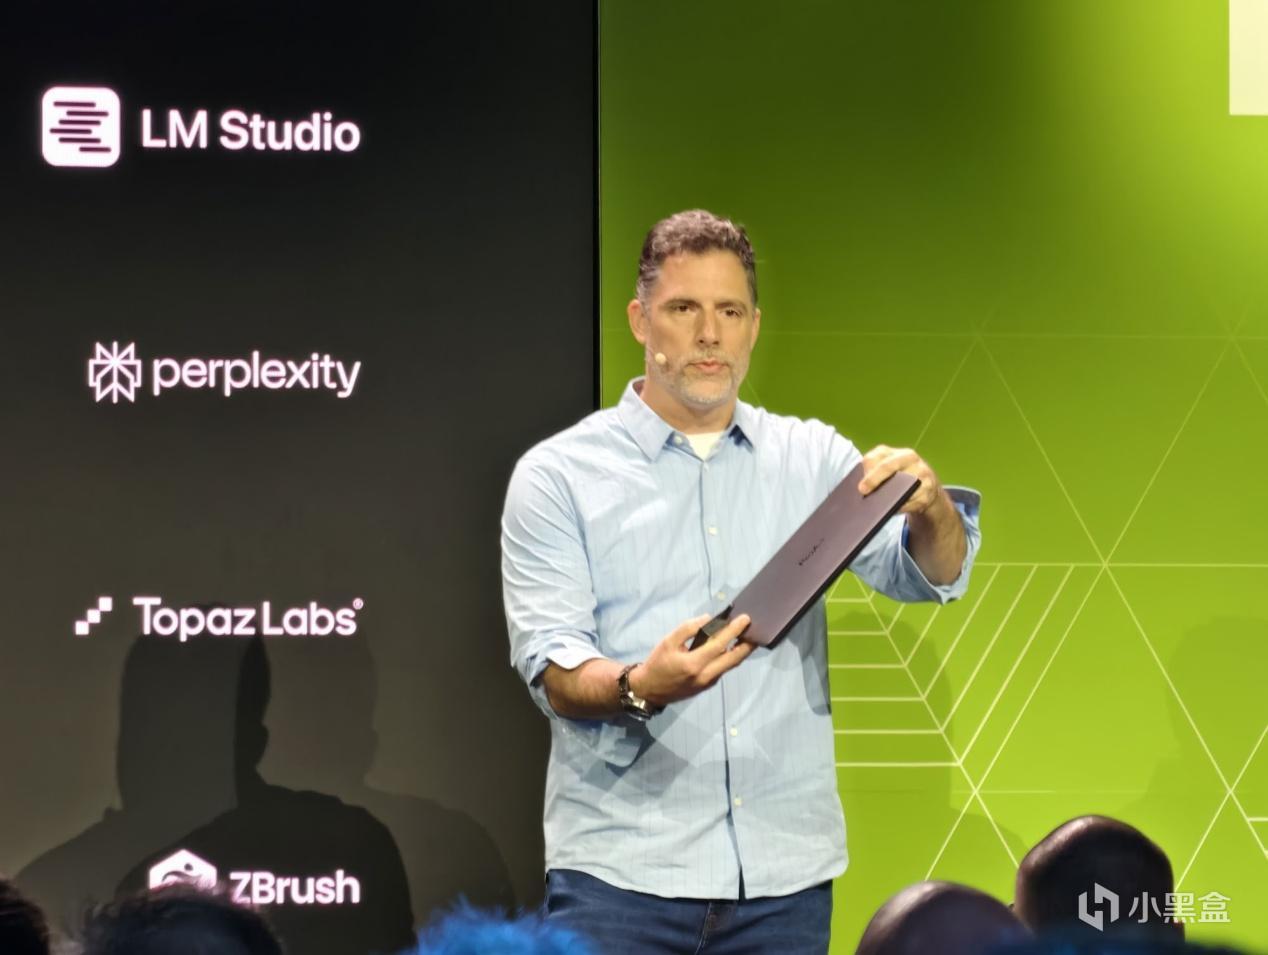
在微軟Surface Laptop Ultra舊金山發佈活動結束後的第二天,NVIDIA RTX Spark媒體編輯日在原場地展開。顯然微軟Surface Laptop Ultra只是RTX Spark筆記本的一道前菜,其背後將擴展出一個全新、獨立、與衆不同的Windows SoC新生態,NVIDIA x Microsoft的“NM”組合將會用行動告訴我們Windows搭配RTX Spark將會很有搞頭。
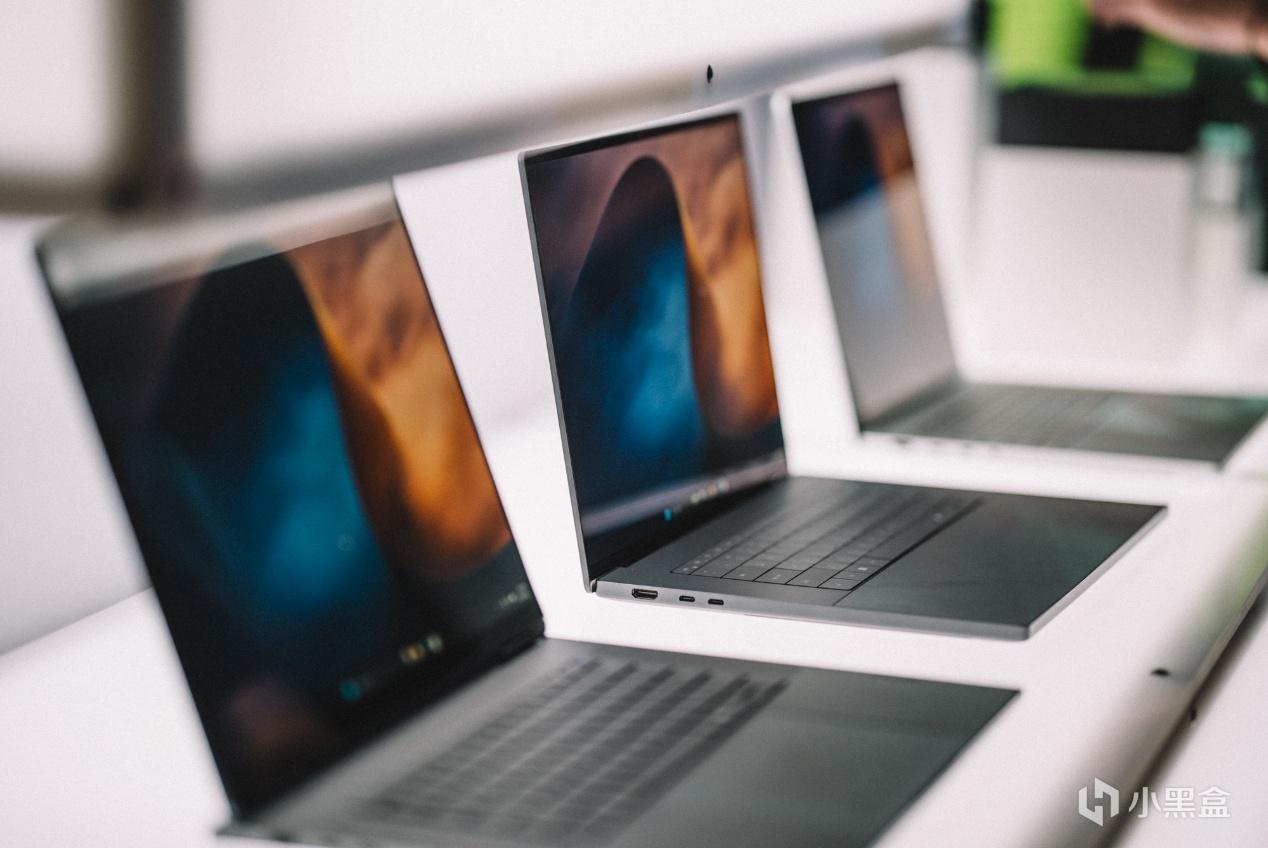
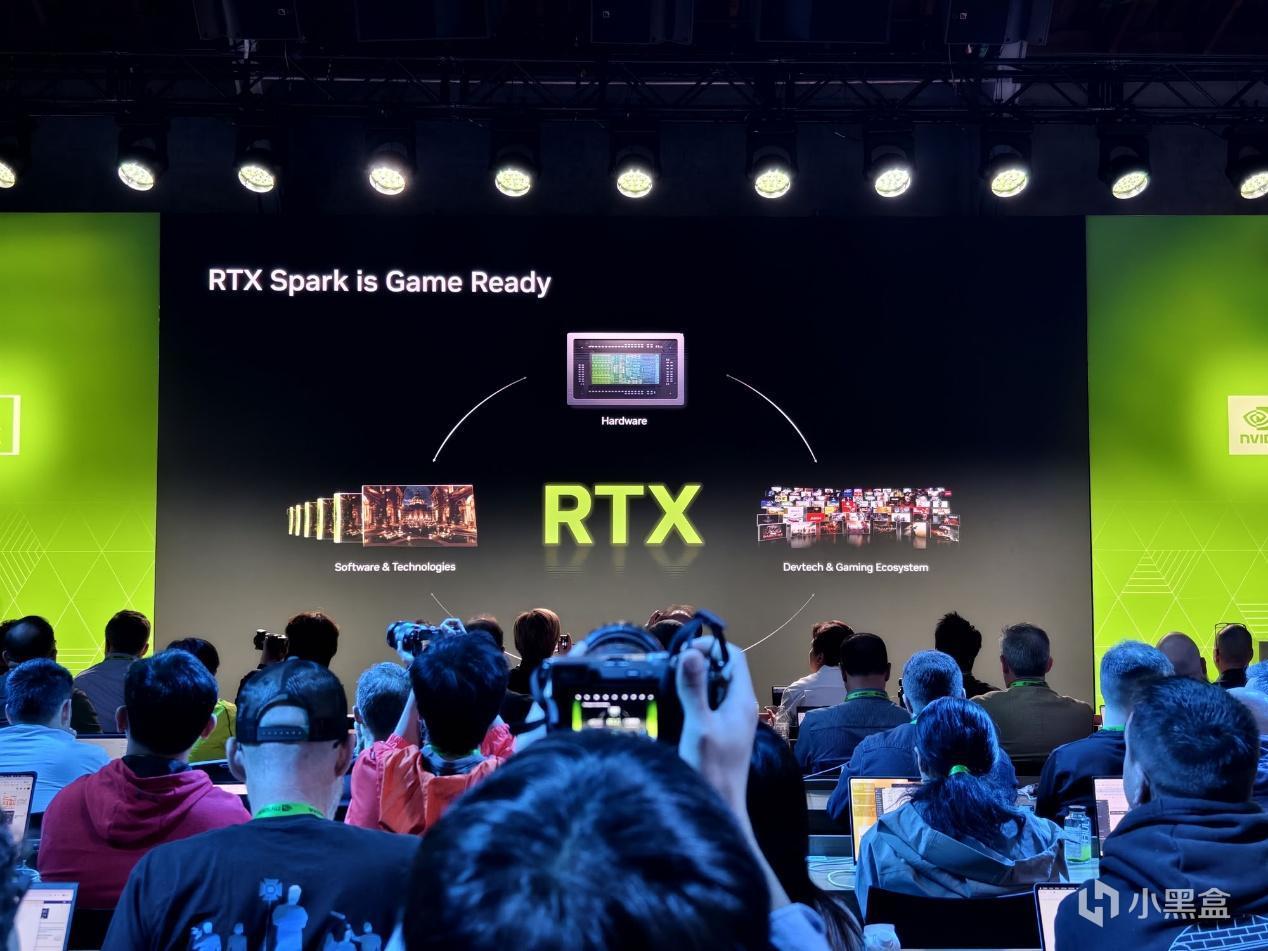
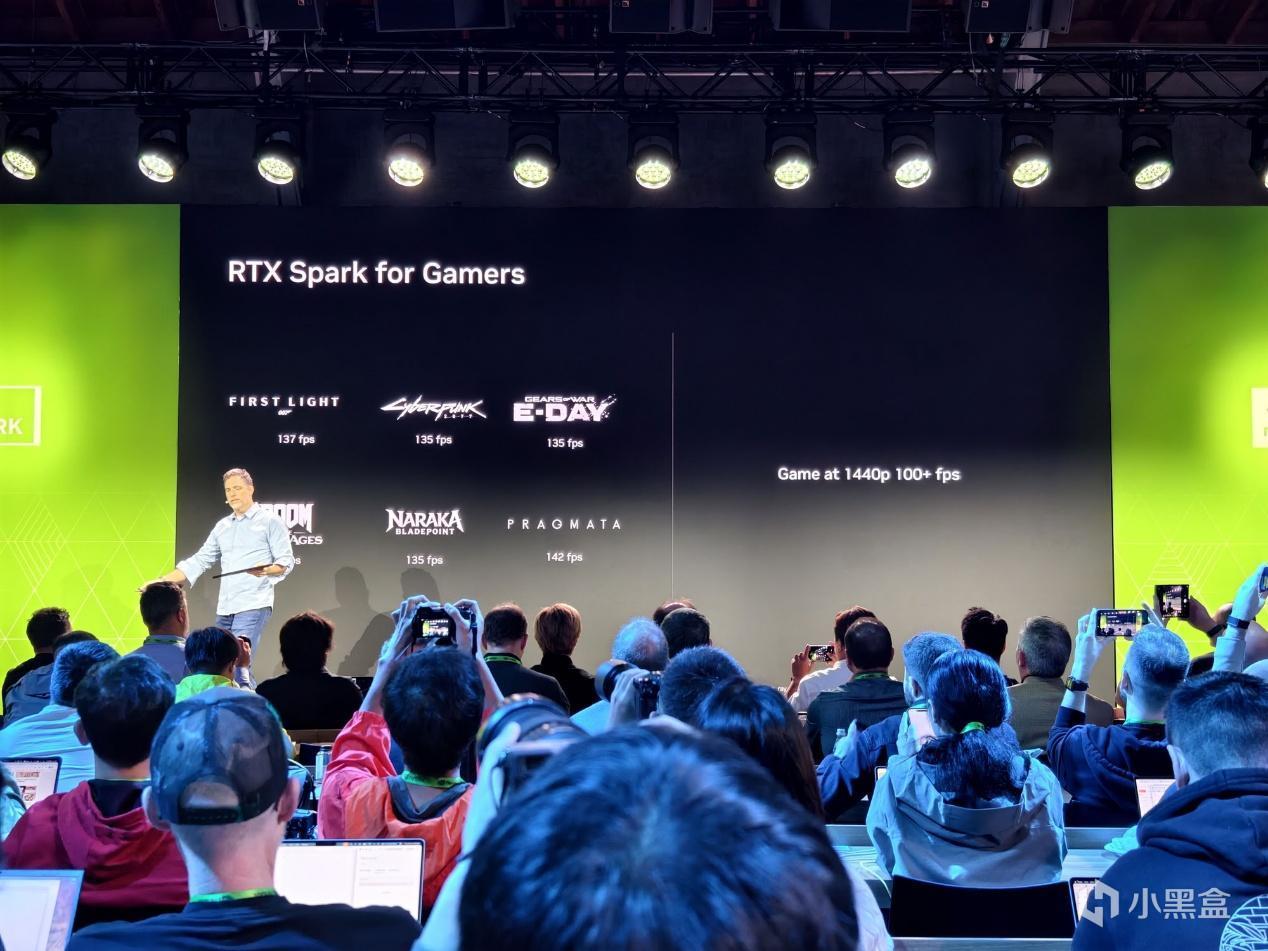
在這長達一整天的媒體溝通會中,RTX Spark N1X作爲絕對的主角已經展現出了性能與生態的多面性,它的硬件規格很能打,有着RTX 50系列獨顯的性能,並且可以塞入最低1.35kg,未來可能會更輕的輕薄本中。同時它被Windows on Arm寵幸,過去一年多的海量優化、適配,以及NVIDIA強大的遊戲、創作、生產力與娛樂的號召力,讓RTX Spark發佈的第一天就擁有海量的專業應用支持,以及上百款3A遊戲大作加入,所有遊戲和應用的體驗都能在2.5K分辨率的屏幕上保持100FPS以上的幀率運行。
重點是,微軟Surface之後,華碩、戴爾、惠普、聯想、微星也已經推出了對應的RTX Spark筆記本產品,給這場全新的芯片之旅定下了宏大的開場篇章。
NVIDIA RTX Spark無疑是一個令人振奮的新產品,同時也是一個新時代的開端,它究竟可以做到什麼地步?現在不妨讓筆者整理一些編輯日現場信息,對RTX Spark有一個初步瞭解。與此同時,我們的RTX Spark筆記本深度評測內容也同時發佈,感興趣的同學也歡迎前往愛極物公衆號翻閱。
爲什麼要做RTX Spark?
RTX Spark N1X超級芯片無疑是整個SoC的核心,用NVIDIA的表述,這是一個全新的Windows SoC品類。事實也是如此,在此之前,Windows on Arm幾乎圍繞高通驍龍X Elite系列搭建,受限於對PC計算、圖形計算的理解,再加上PC領域的行業號召力欠缺,基於驍龍X Elite系列SoC的產品在過去很長一段時間中苦苦支撐。
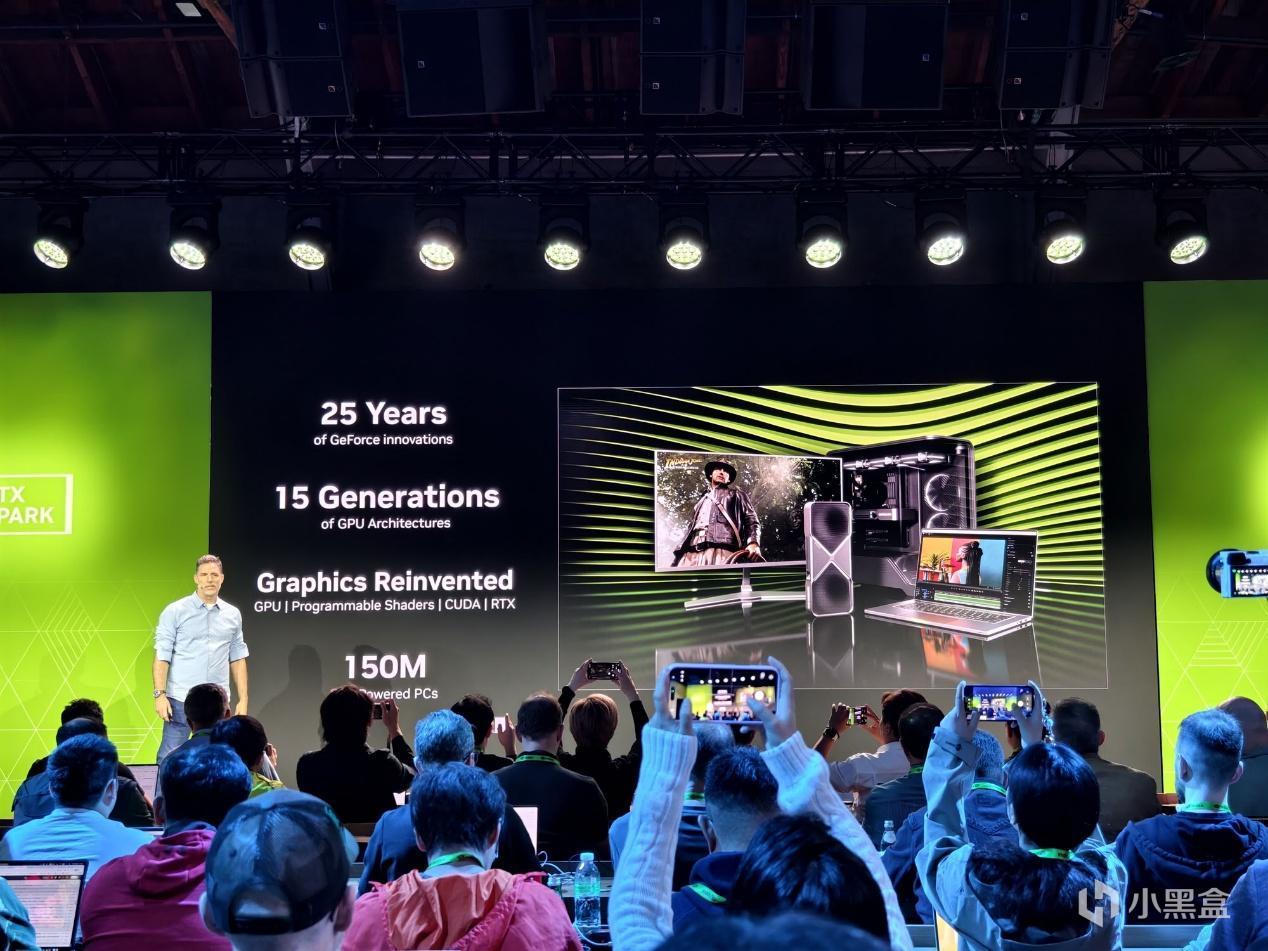
而NVIDIA顯然是不一樣的。在過去25年中,NVIDIA整整推出了15代用於PC的GPU,無論是GPU的概念,還是將大規模並行處理器從論文走向量產實踐,推出可編程GPU和大名鼎鼎的CUDA,並用作後來的GPU神經網絡訓練加速。大約在8年前,首款支持實時光線追蹤的GeForce RTX 20系列發售,如今全球已經擁有超過1.5億臺RTX PC。
硬件只是載體,棧纔是壁壘。1.5億臺RTX PC的裝機量的基礎是一整套橫跨遊戲、創作、AI 的軟件層,這也進而成爲RTX Spark獨一無二的優勢。
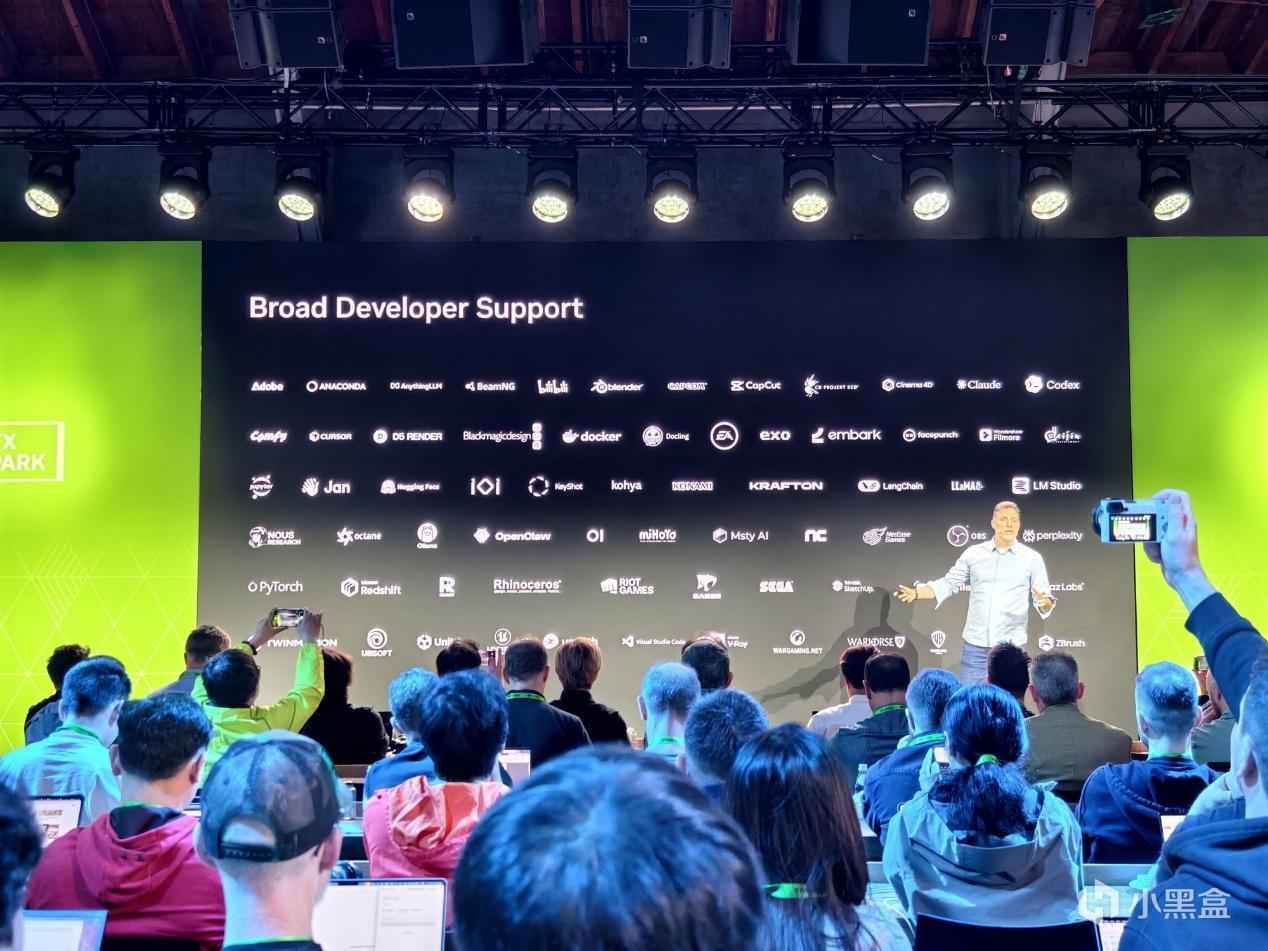
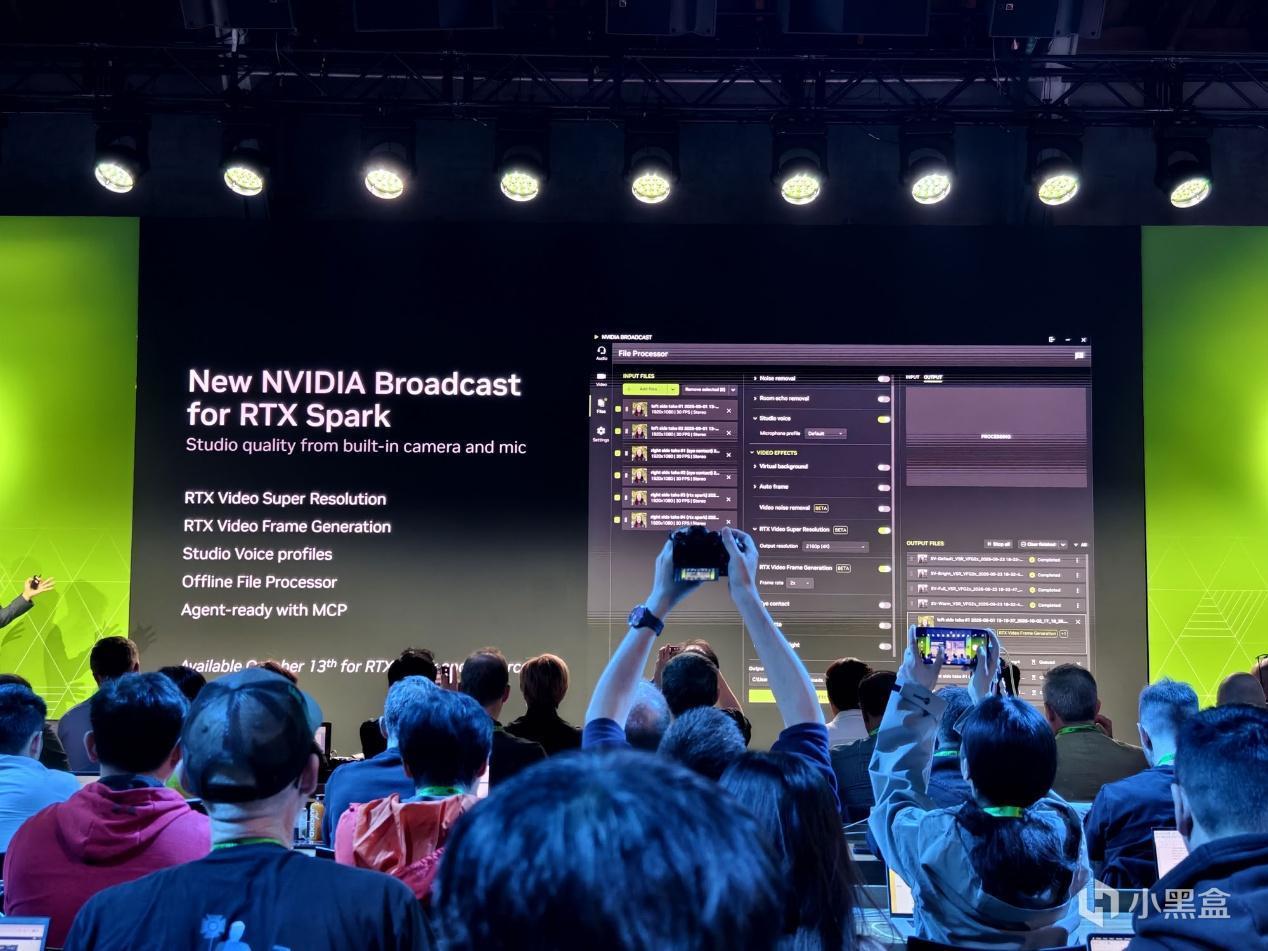
更確切的說,RTX Spark不僅是一顆芯片,而是整個棧的最小載體,背後連接着遊戲側的DLSS、Reflex、Game Ready驅動等遊戲基礎的支持。創作側亦是如此,RTX Spark N1X Blackwell視頻引擎支持4:2:2專業格式硬件加速,可以輕鬆實現編解碼加速,並且在創作應用中也能使用DLSS,Blender 5.3的降噪就是其中很好的例子。同時NVIDIA Broadcast、RTX Video通過文件處理器、攝像頭補幀、超分辨率、音棚音效(Studio Voice)音色等功能,配合Studio驅動,確保創作得以穩定運行。
NVIDIA是最有機會提供完整的本地AI全棧自研閉環方案。這得益於GPU天然擅長的AI算力,以及引入的NVFP4數據格式,即4-bit浮點格式,把模型體積壓到原來的幾分之一。例如同一個FLUX2.Dev模型中,BF16需要128GB內存、FP8需要64GB以上,NVFP4僅需要32GB內存即可運行,這給端側AI提供了可能性。
另外第五代Tensor Core本身就原生支持加速NVFP4,這也對應了RTX Spark N1X的1 PFLOPS FP4算力只有在NVFP4模型上才能完全釋放。軟硬件協同設計讓RTX Spark有了更多機會。
最後是Day-0模型合作構成的生態護城河。NVIDIA與模型廠商合作,新模型發佈即針對RTX優化,這和遊戲Game Ready驅動是一樣的做派。目前RTX Spark N1X已經能夠很好的支持Qwen3.8 27B、Qwen3.8 Flash Next、Nemotron Bolt,並且擁有針對Spark預調優配置的NVIDIA Local AI Recipes倉庫,加上llama.cpp/Windows ML雙推理路徑,RTX Spark變得順理成章。
有意思的是,整個行業的技術節點和需求也發生了悄然變化。OpenClaw、Hermes這類智能體項目的星數在極短時間內垂直拉昇,超過了Linux、PyTorch這些時代最重要的軟件項目。
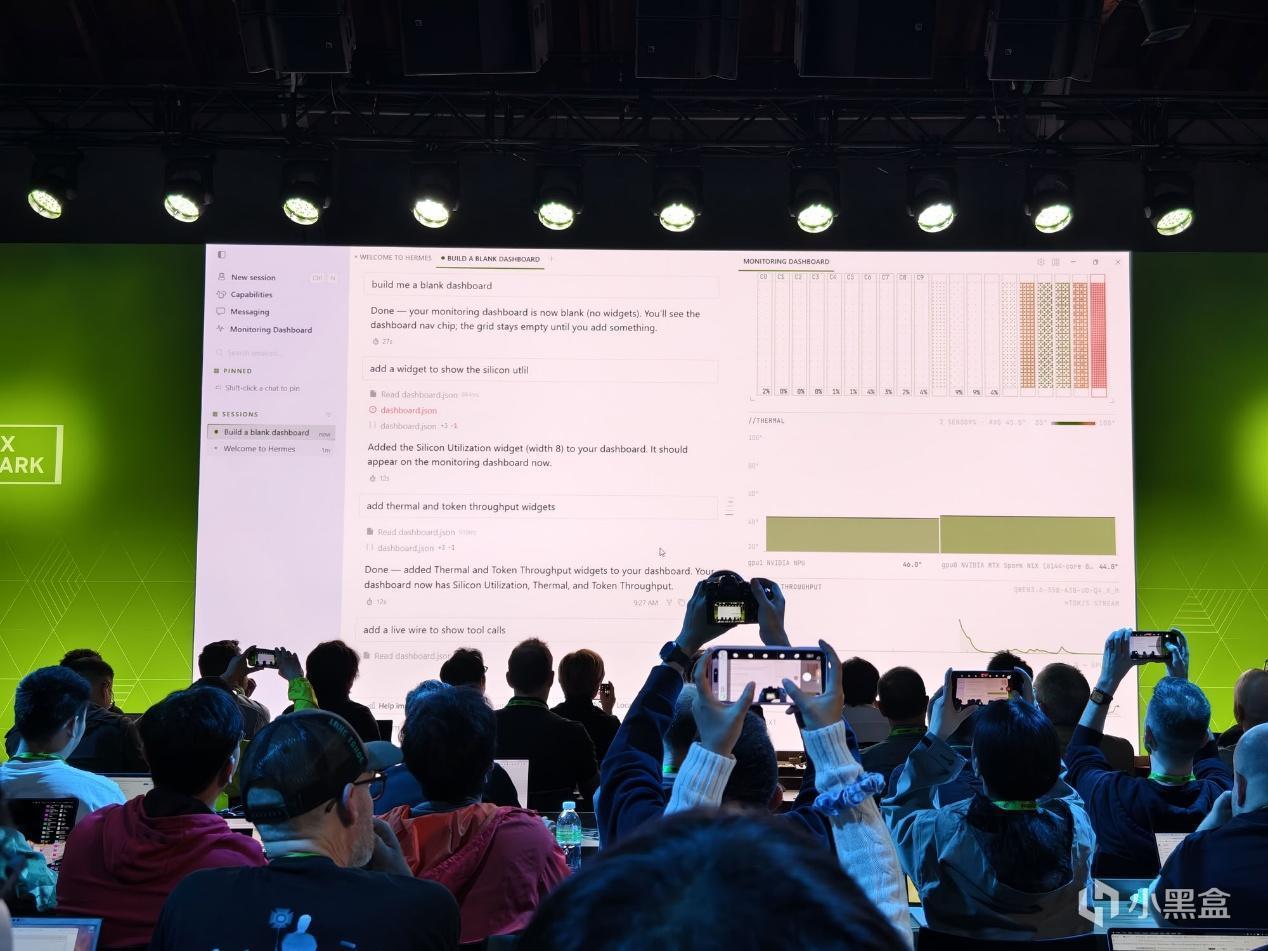
更有意思的是,本地模型並沒有大幅落後雲端模型,在一系列優化與蒸餾之後,今天的本地小模型,已經能達到幾個月前前沿雲端模型的智能水平。雖然落後幾個月,但由於本地模型不消耗Token,並且免費、離線、無延遲,吸引力自然變得更大。特別是從現在的大趨勢看,本地模型的能力每3個月就有質變,舉個不太恰當的例子,幾個月前我們還在讚揚的ChatGPT Images 2.0的在線生成效果,現在本地運行的Qwen‑Image‑2.1也已經能夠做到相當的水準了。
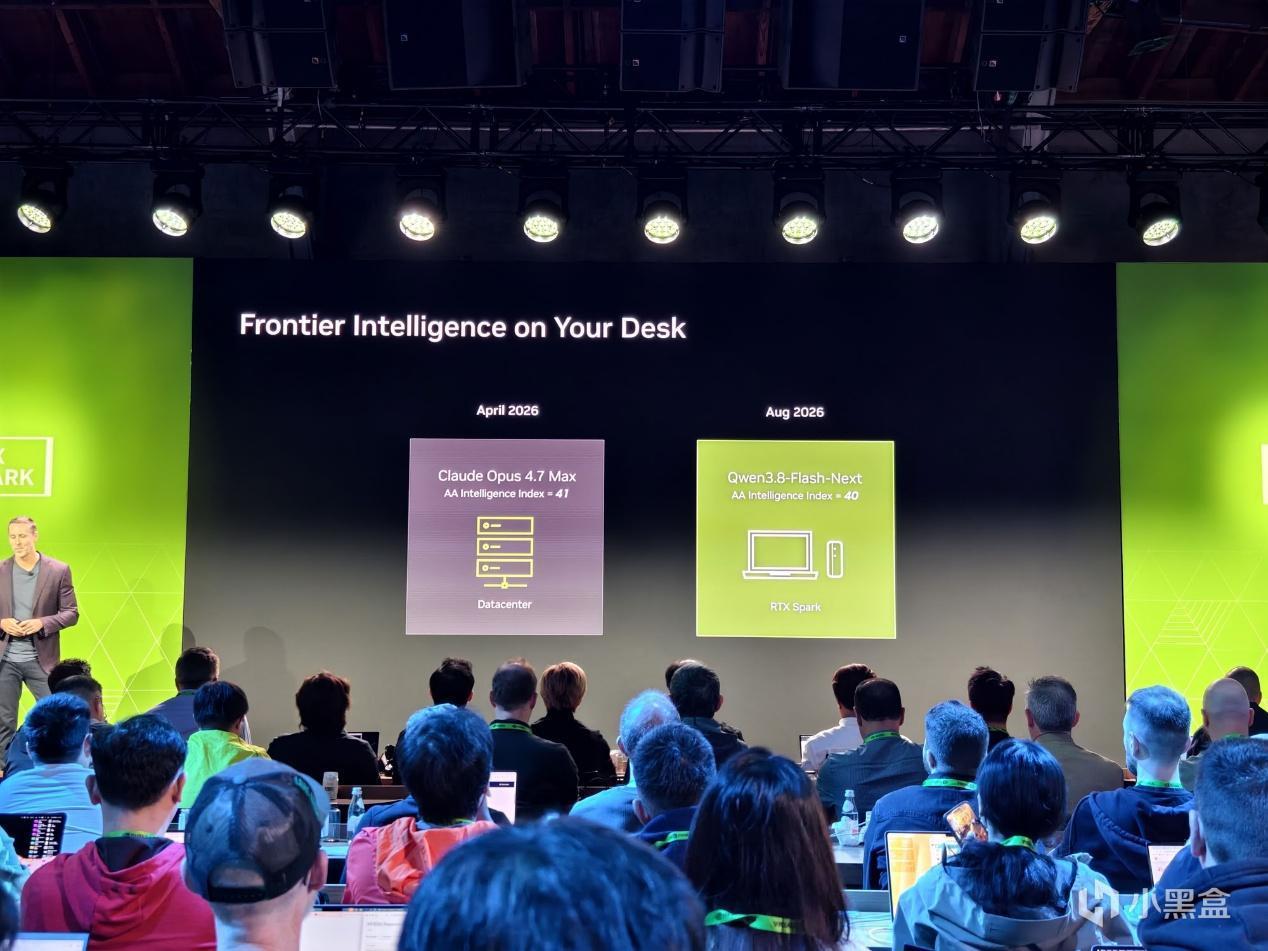
這時候我們就會發現一個問題,目前大模型的發展本質上是智能在貶值、算力在升值,今天的免費本地模型,就是半年前別人按Token付費的智能,需要一個明確的實體化產品承接這部分空窗期。
這裏NVIDIA也引用了Hugging Face的模型下載數據,發現相比去年,今年本地模型下載量成5倍的增長,並且現在只是10月份,意味着實際本地模型下載量還能更高,端側運行變得勢在必行。無論從哪個角度出發,RTX Spark將成爲填補端側AI的一款重要產品。
RTX Spark架構淺析
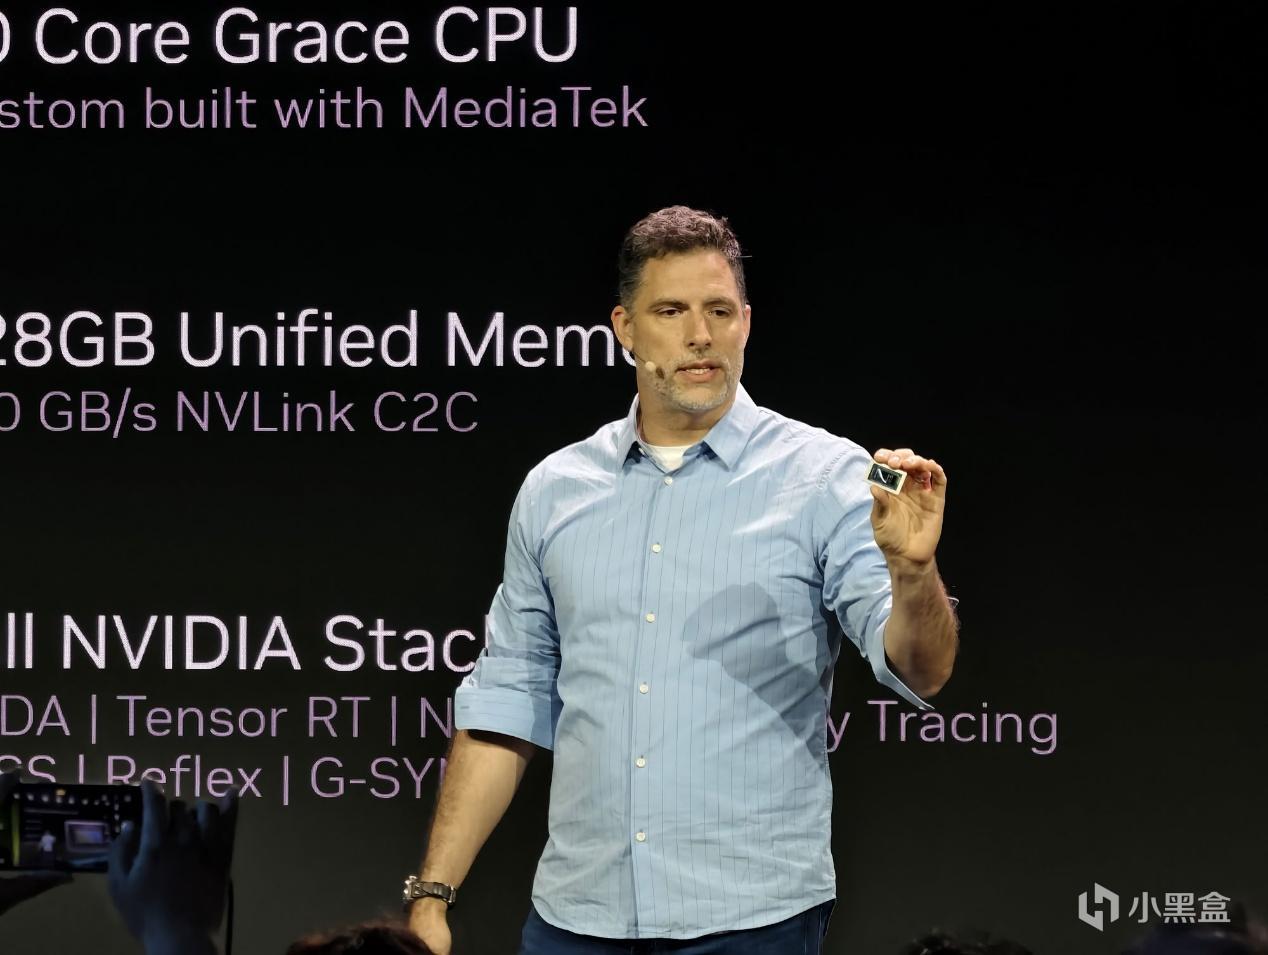
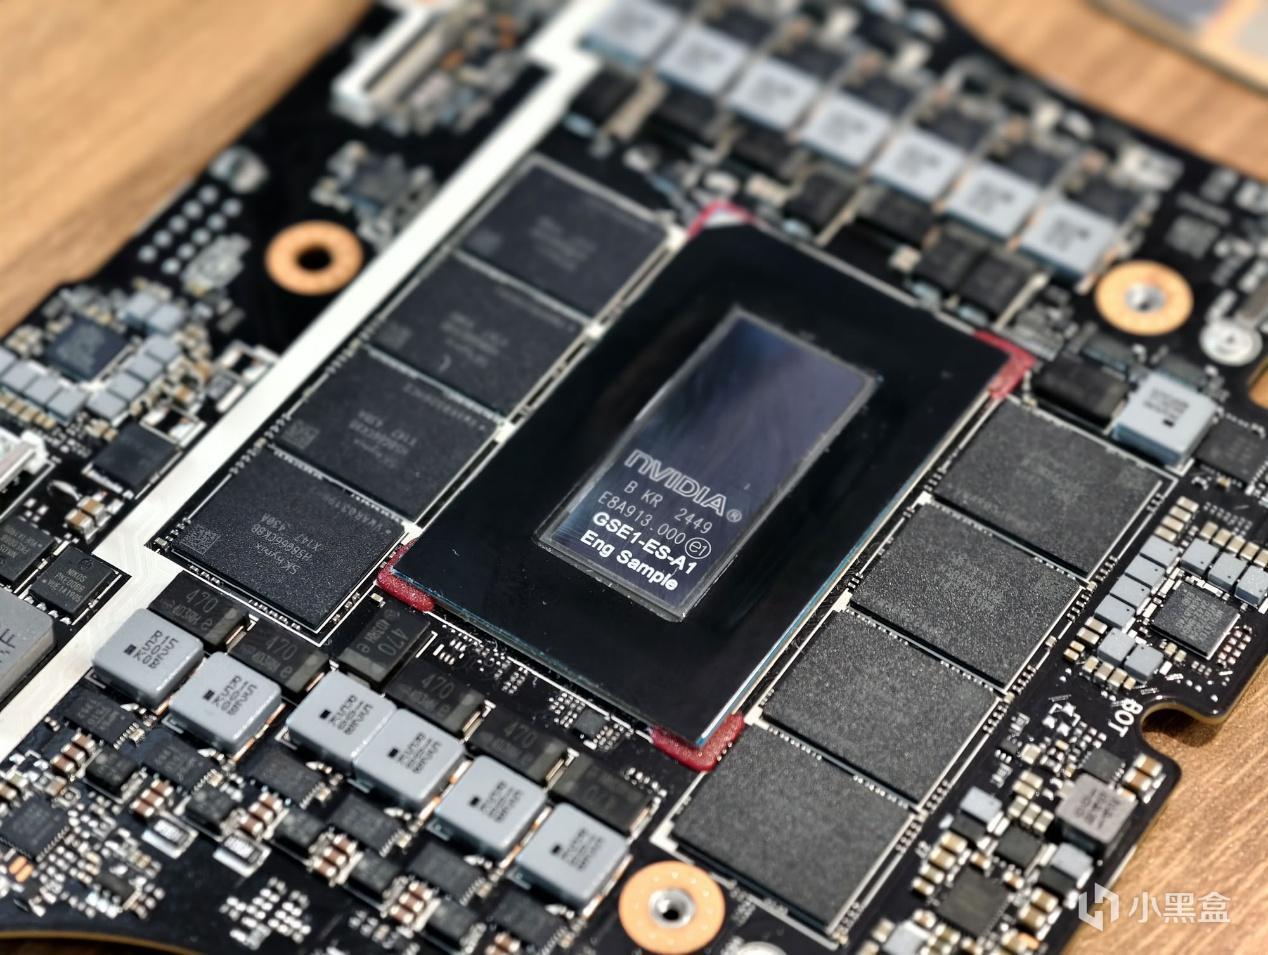
NVIDIA在Keynote中多次強調RTX Spark是一顆超級芯片,而不是普普通通的SoC,它把最新一代Blackwell RTX GPU、與聯發科聯合設計的Grace CPU、以及統一內存架構融合在一起,並完整繼承RTX技術棧。
這相當於NVIDIA把數據中心Grace-Blackwell超級芯片的設計理念下放到消費級產品中。NVIDIA數據中心的打法本質上是圍繞Grace CPU + Blackwell GPU + NVLink-C2C的組合展開,RTX Spark和DGX Spark都相當於這個思路的延伸版本。
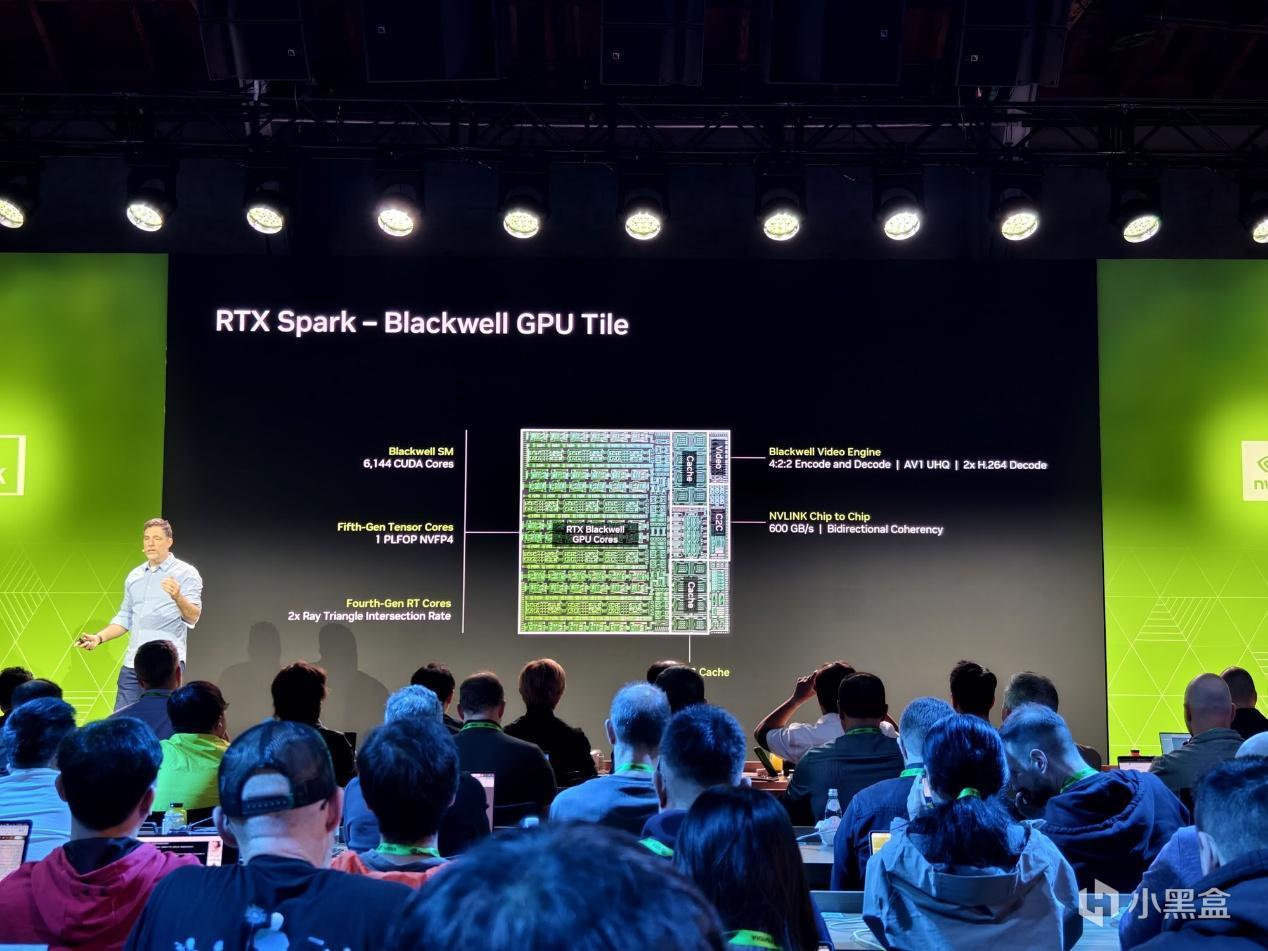
RTX Spark N1X由兩顆die(芯粒)組成CPU和GPU,兩顆die均爲臺積電3nm製程。
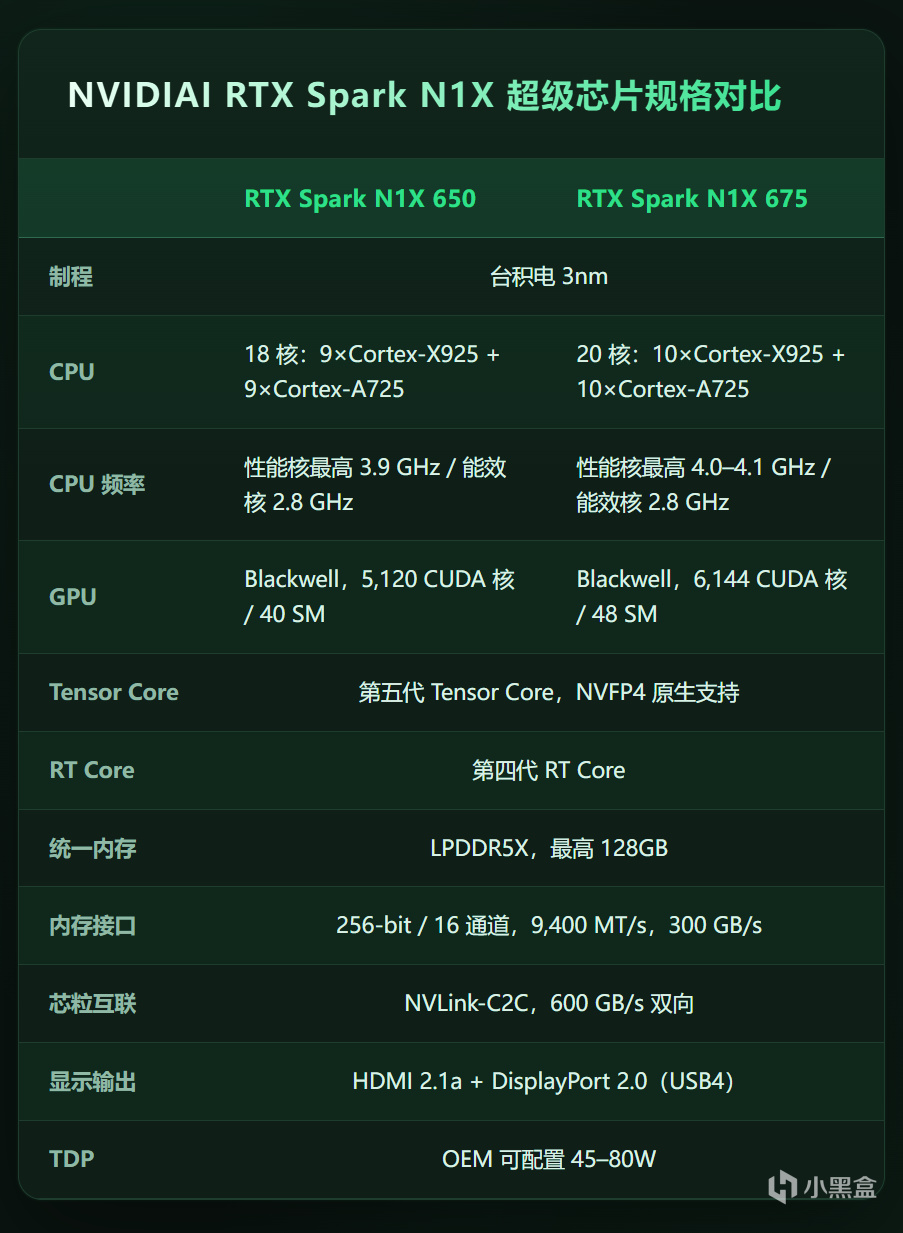
其中Blackwell GPU tile是完整的Blackwell圖形與AI計算陣列,滿血版擁有6,144個CUDA核心,對應48組SM(流式多處理器),另一個版本擁有5,120個CUDA核心,對應40組SM。其中48組SM的規模相當於桌面版GeForce RTX 5070的級別,但由於內存容量、帶寬、功耗和運行策略都不相同,所以不能將RTX Spark N1X滿血版與GeForce RTX 5070桌面版劃等號。
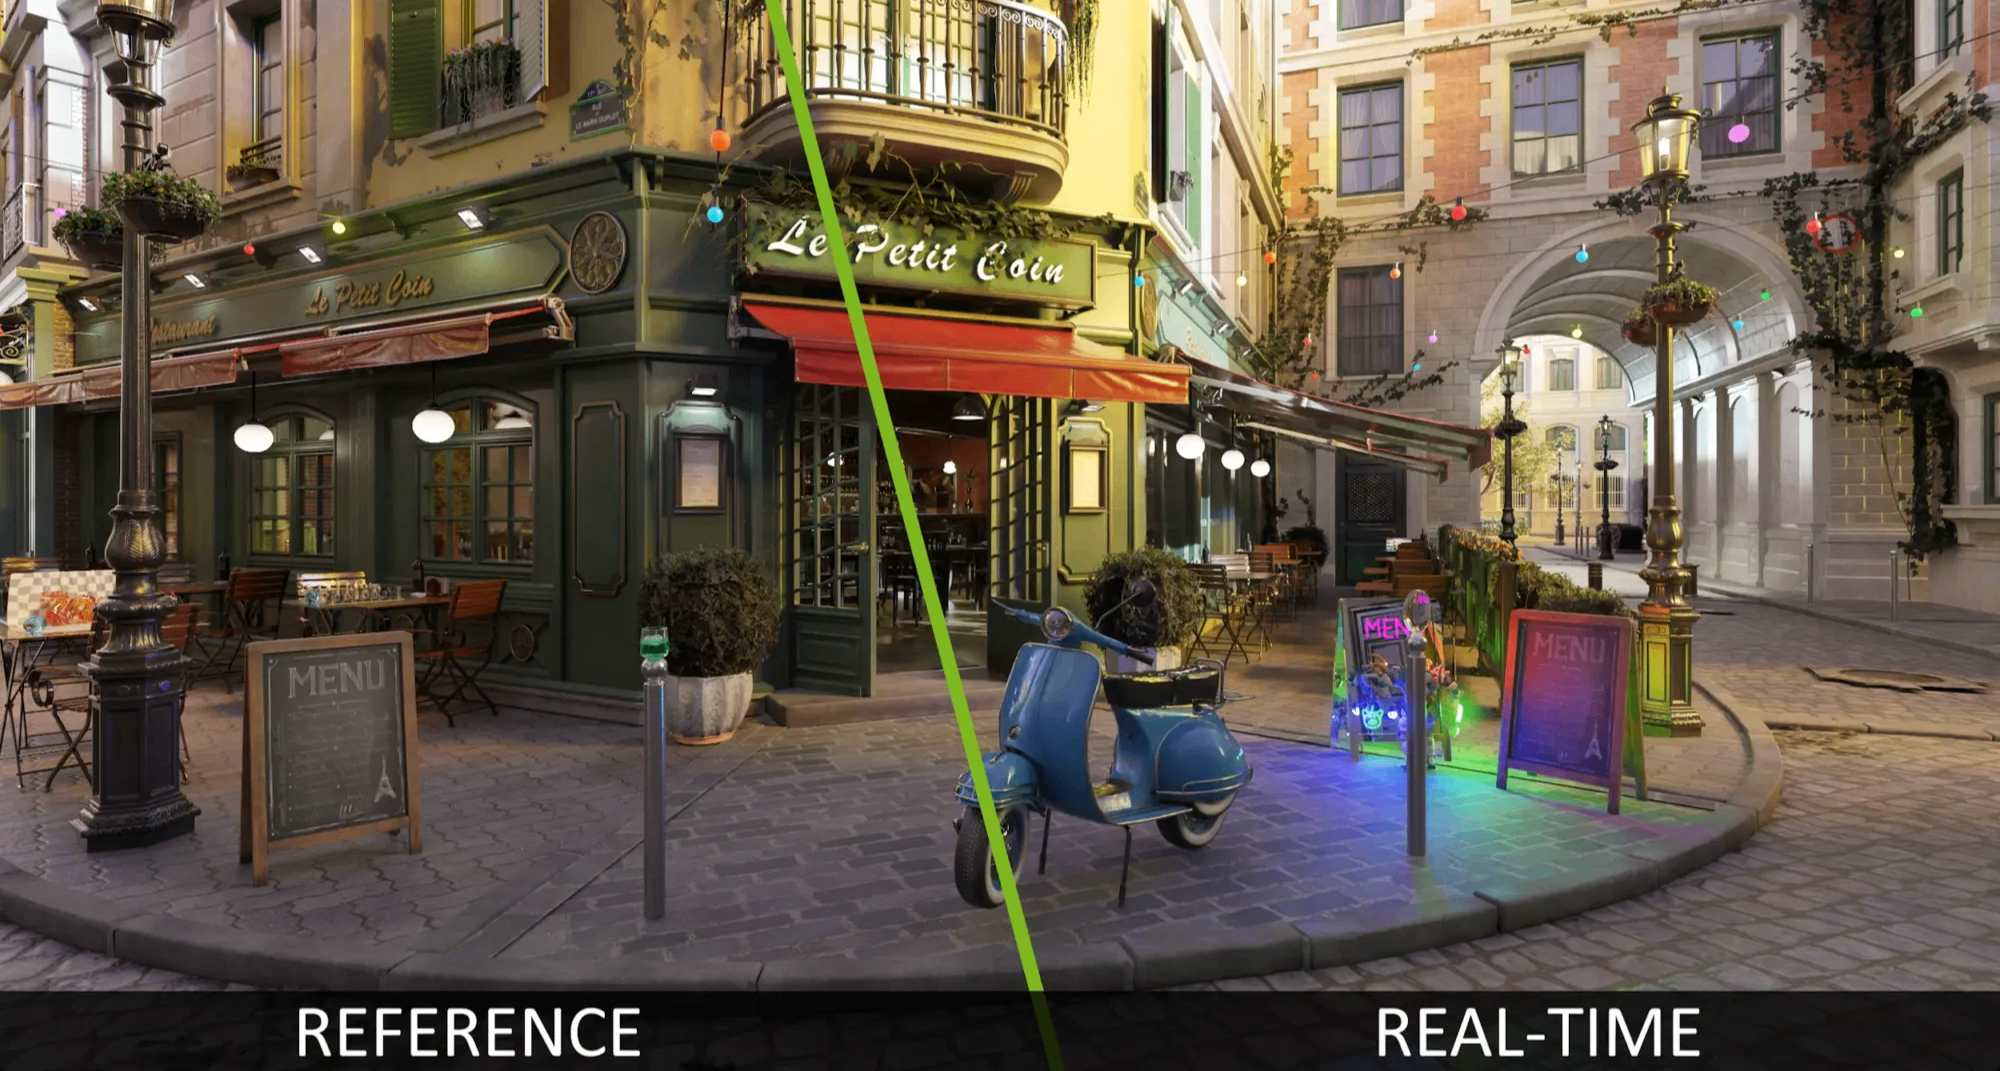
這塊Blackwell GPU tile擁有第五代Tensor Core,其AI算力在NVFP4精度前提下達到1 PFLOPS,當然前提是第五代Tensor Core以及AI應用本身都需要對FP4提供原生支持。同時GPU還擁有第四代RT Core光線追蹤核心,光線-三角形求交速率比上一代翻倍。求交運算是光追最底層的計算,這個翻倍直接決定光追遊戲的幀率上限。然後就是前面提到Blackwell視頻編解碼引擎,支持硬件編解碼,包括面向專業剪輯的4:2:2格式加速,這是內容創作者的剛需,此前的消費級GPU只能軟解相機4:2:2採樣的素材。
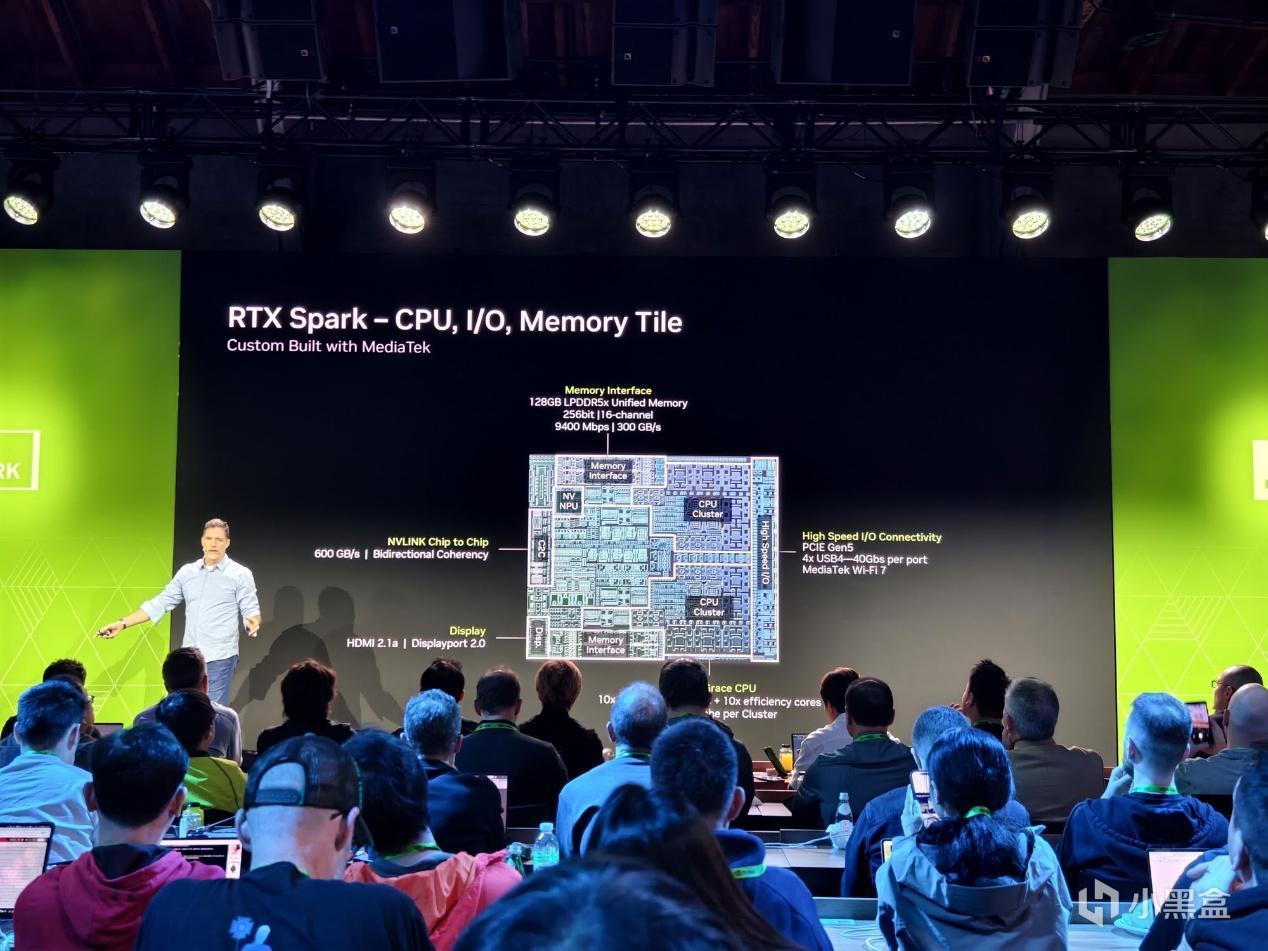
Blackwell GPU tile通過NVLink-C2C與Grace CPU連接。NVLink-C2C被認爲是RTX Spark N1X的技術靈魂。NVLink-C2C擁有雙向600GB/s帶寬,作爲參照,普通筆記本里CPU和獨顯之間 PCIe 5.0 x16只有約64GB/s帶寬,NVLink-C2C高出近一個數量級。
同時NVLink-C2C具備雙向一致性(bi-directional coherency)。CPU和GPU可以同時操作同一份數據,並且硬件自動保證兩邊看到的緩存副本是一致的。沒有這個能力時,CPU改完數據要靠軟件顯式同步給GPU,依靠程序員手動管理緩存,又慢又容易出錯。而有了硬件級一致性,編程模型大幅簡化、通信開銷大降。對AI負載的意義尤其大,因爲在推理過程中,CPU側的控制邏輯和GPU側的張量計算要高頻交換數據。
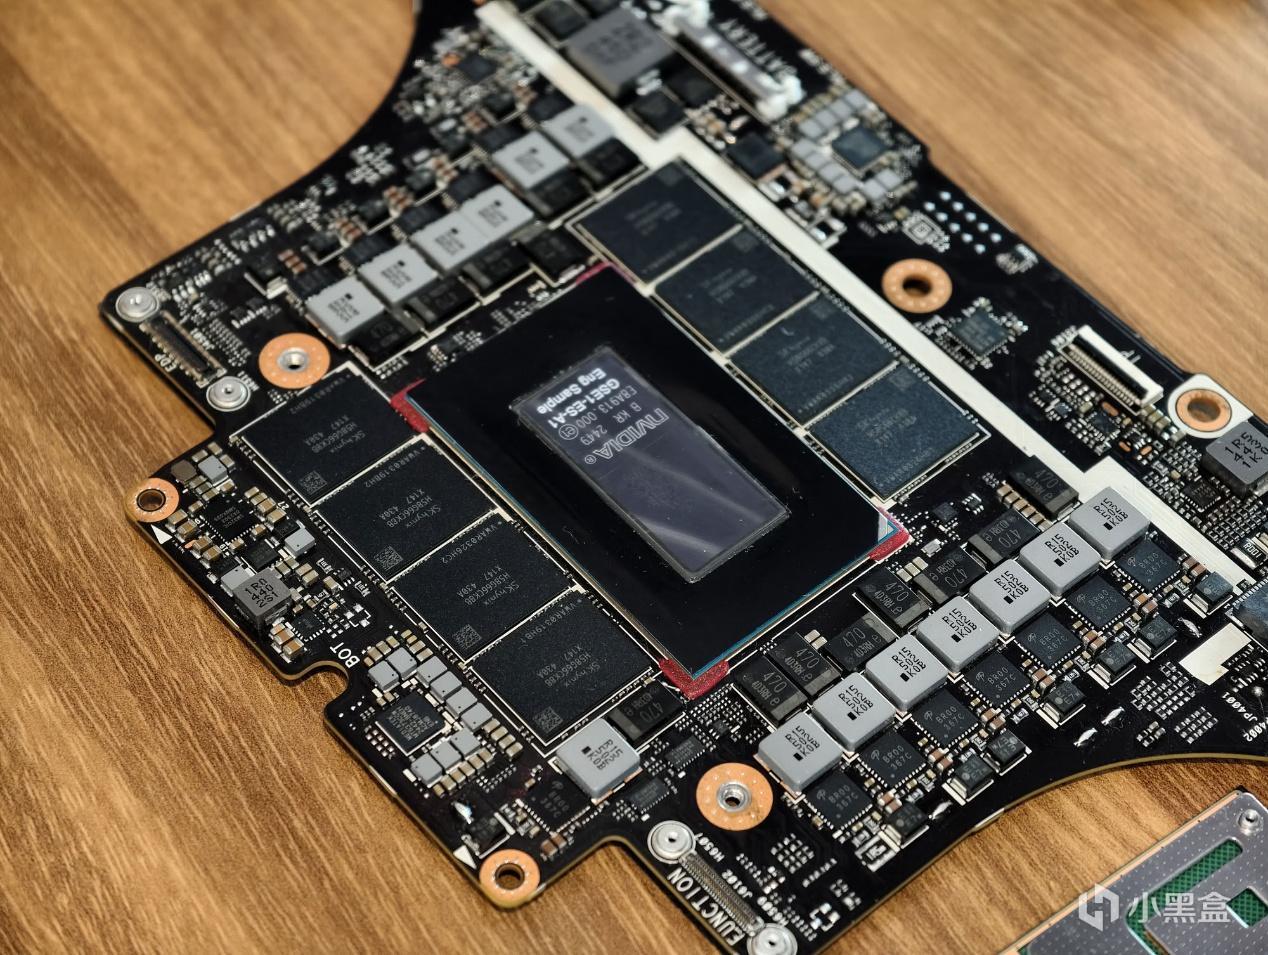
NVLink-C2C效能還比PCIe數據傳輸高出25倍,因爲統一內存架構本身搬運數據是不耗電的,這25倍就是統一內存經濟性的來源。
RTX Spark N1X擁有20核Grace CPU,分兩個簇,每簇10核,即10個性能核和10個能效核,每簇配備16MB緩存。其中性能核由Arm Cortex-X925構成,能效核由Arm Cortex-A725構成,性能核最高4.0–4.1 GHz、能效核2.8 GHz。另外18核版本的RTX Spark N1X由9個性能核與9個能效核構成,性能核最高3.9GHz。
值得說明,Arm Cortex-X925和Arm Cortex-A725是Arm 2024年發佈的公版核心設計組成,與天璣9400同代。有理由相信NVIDIA Grace CPU通過Arm公版設計、聯發科設計經驗,以及NVIDIA定製需求共同協作,從而在短時間內完成CPU開發,以節約開發週期。
RTX Spark N1X內存接口最高支持128GB LPDDR5X統一內存,256-bit位寬、16通道,速率最高9,400 MT/s,峯值帶寬300GB/s。統一內存是AI敘事的關鍵,CPU和GPU共享同一片內存池,GPU有機會動用更多的顯存,這是同規模的GeForce RTX 5070 16GB顯存所羨慕不來的。
但這樣設計的代價也很明顯,300GB/s的帶寬遠低於桌面獨顯,例如GeForce RTX 5070顯存帶寬約672GB/s,旗艦型的GeForce RTX 5090更是擁有1792GB/s,統一內存換來的是容量而非帶寬,這是因爲AI推理對容量敏感、遊戲對帶寬敏感,這個取捨決定了RTX Spark註定是一款AI優先的產品。
另外IO與顯示引擎也放在CPU tile上,支持HDMI 2.1a和DisplayPort 2.0,其中DisplayPort 2.0通過USB4實現。
最後讓我們繪製一個完整的對比表格:
在保持強大性能的同時,RTX Spark N1X也兼顧優秀的能效表現,這也是其能夠塞進筆記本的重要原因。其中與手機同源的LPDDR5X低功耗內存遠比GDDR7顯存省電不少,基於Arm的Grace CPU在能效上有着先天的優勢,Arm架構搭配性能核、能效核分工,讓RTX Spark N1X更爲省電。另外NVLink-C2C省下的25倍傳輸能耗,也是常規的獨顯+CPU的筆記本無法比擬的。
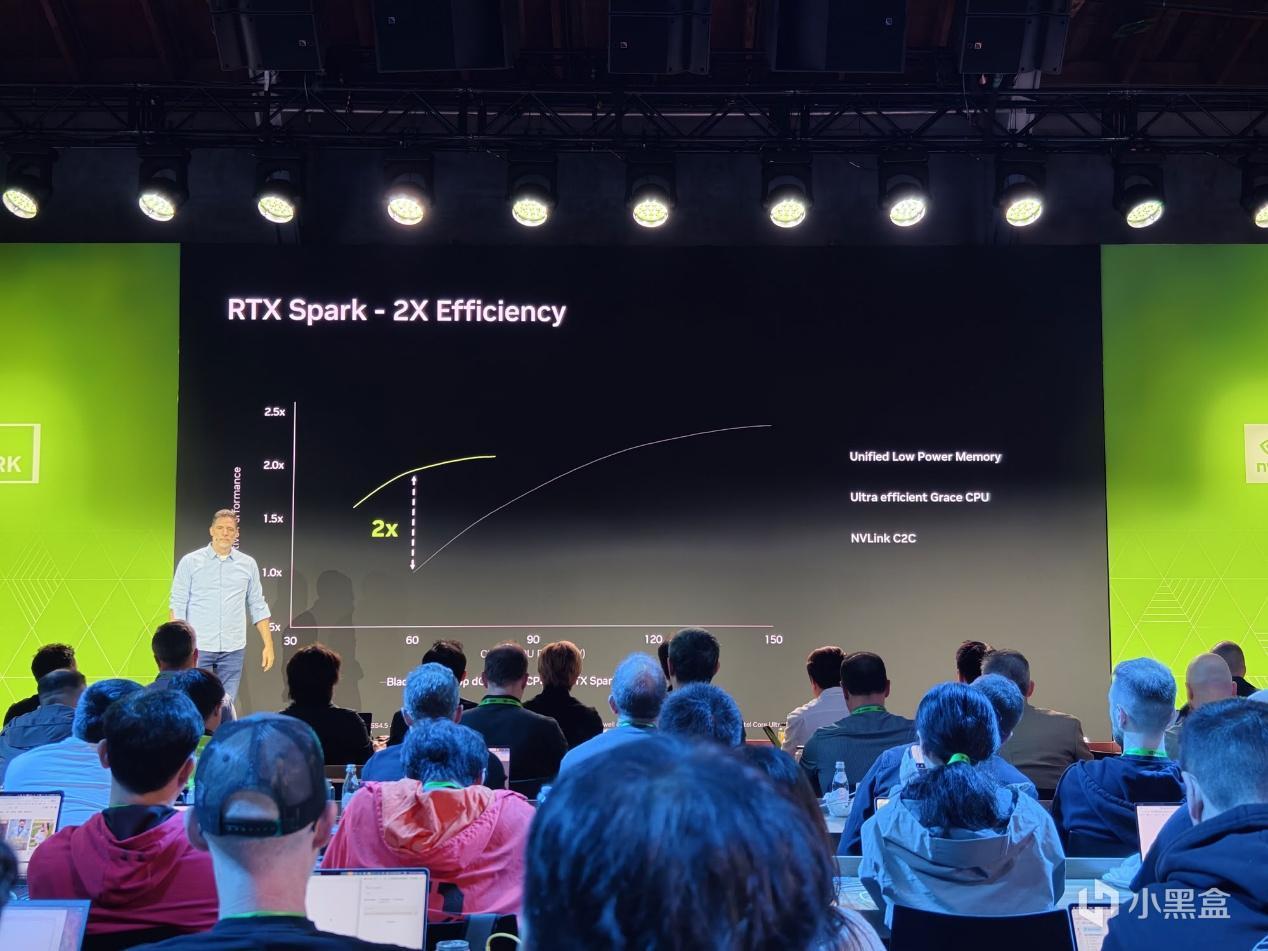
這樣的設計在典型的100W電池供電範圍之內,這讓RTX Spark N1X拔了電也能跑接近滿性能。在後續的聯想 YOGA Pro 15 RTX Spark首發評測中,我們將進行詳細說明。
5倍於歷代Windows SoC
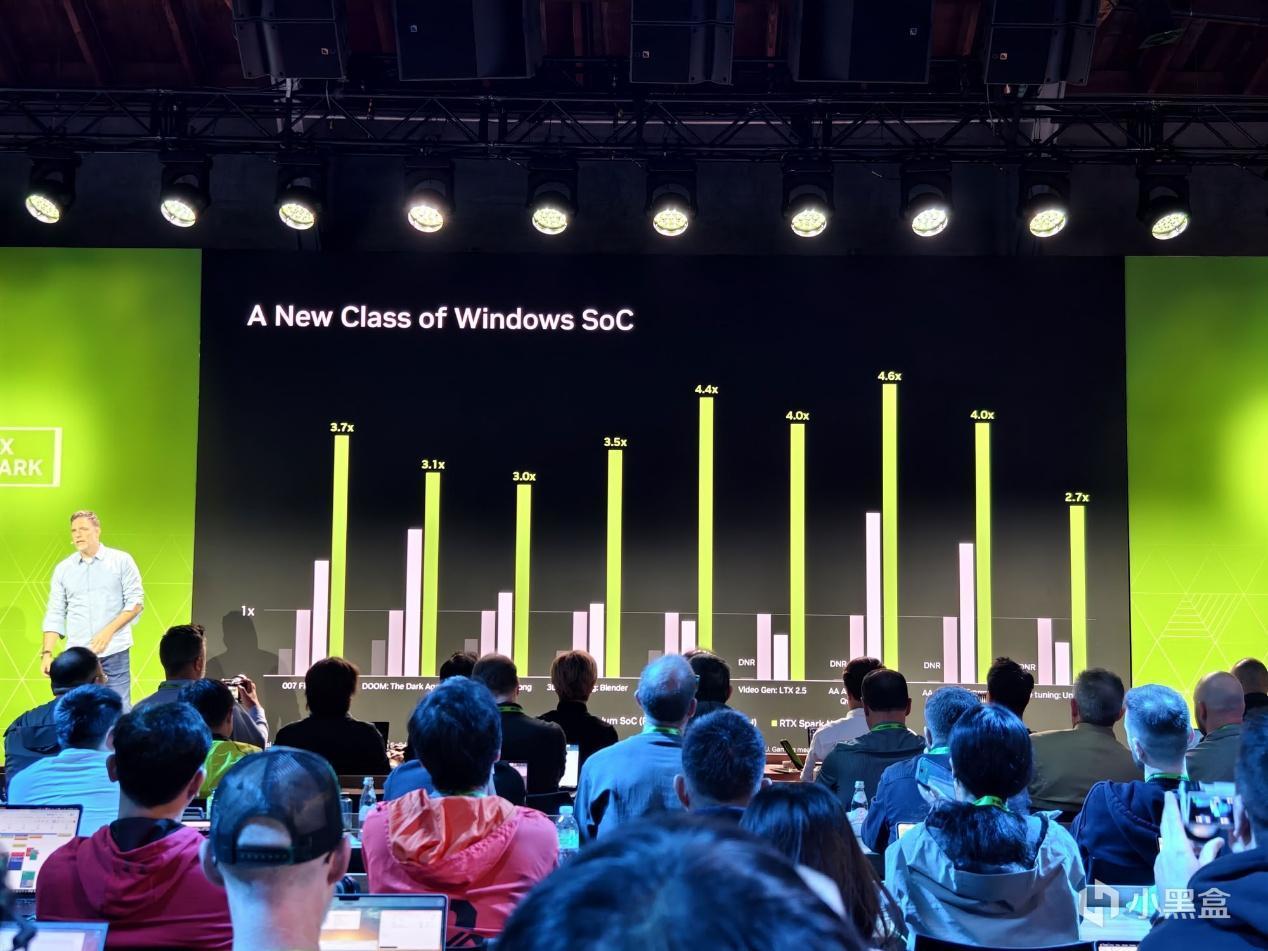
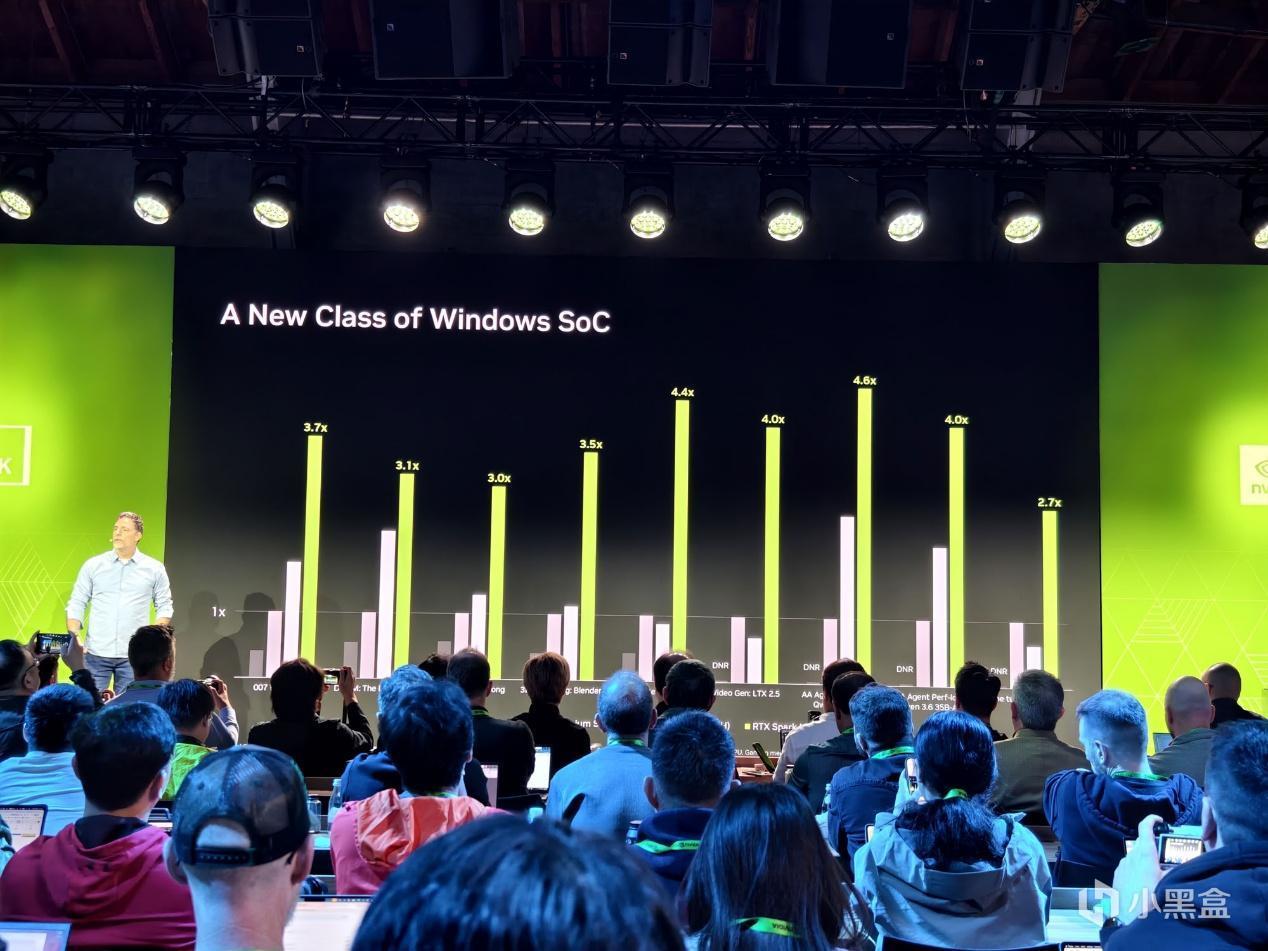
按照NVIDIA的說法,RTX Spark N1X將優於當前任何一款Windows SoC的3到5倍性能表現。這裏的性能表現圍繞的是跨負載的綜合區間展開,即包含遊戲、創作應用、智能體和本地模型推理,不是單一的跑分對比。也因爲如此,RTX Spark開闢了一個全新的性能斷層,讓Surface Laptop Ultra、聯想 YOGA Pro 15 RTX Spark這樣輕薄且具備獨顯的性能成爲可能。
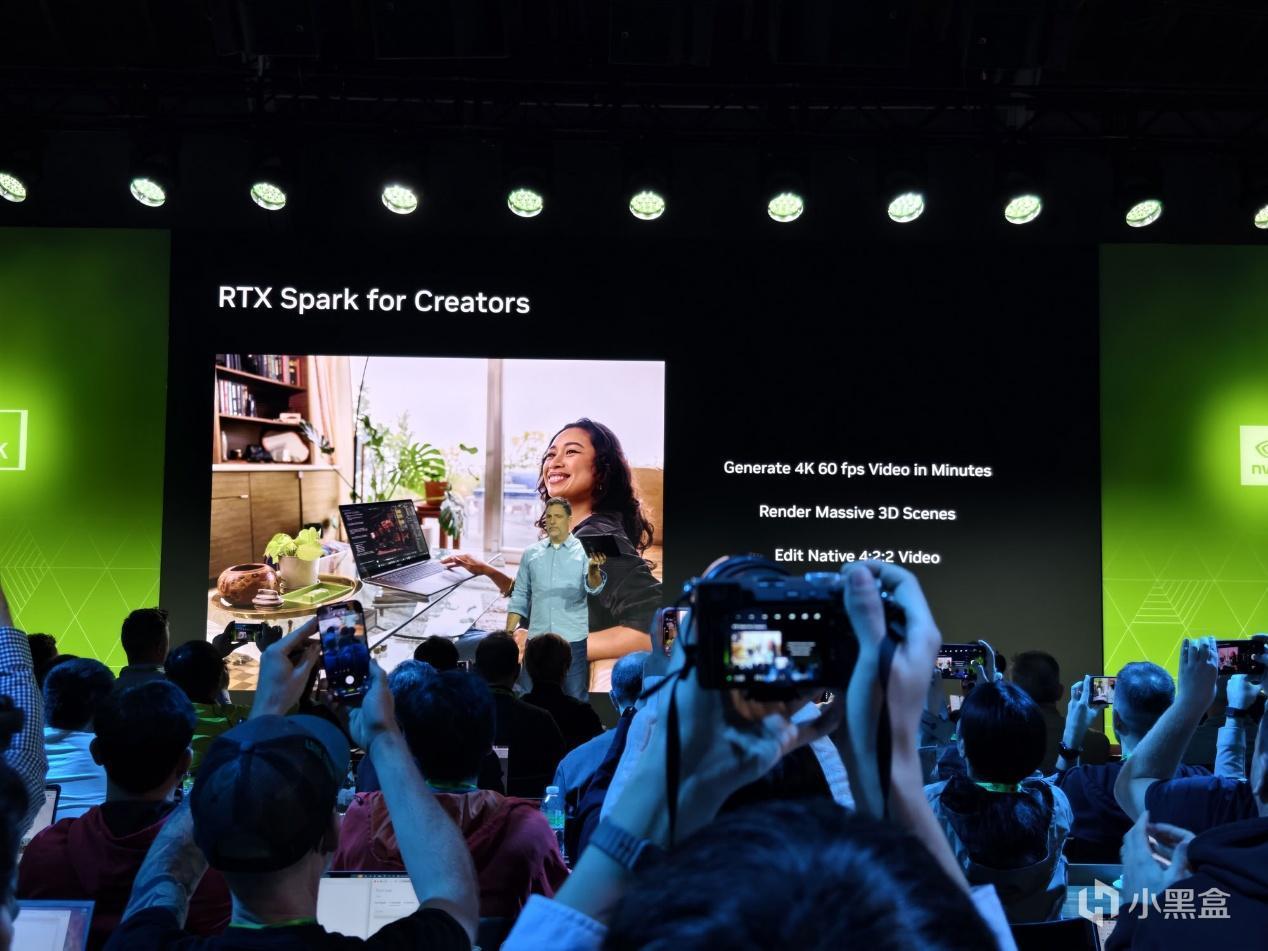
在負載演示中,NVIDIA展示了數分鐘內通過AI視頻生成模型生成4K 60fps視頻,這裏麪包括ComfyUI + LTX 2.5 + RTX Video超分辨率/補幀的工作流,本質上是模型出低分辨率 + AI超分辨率到4K的形式,效率出衆。
另外一個演示就是加速4:2:2專業視頻,通過Blackwell編解碼引擎,給當前的相機素材編輯場景提供了更多可能性。
在遊戲領域,RTX Spark N1X可以做到1440p分辨率下具備超過100FPS遊戲幀率的表現。這是因爲RTX Spark N1X本身帶着完整的RTX技術棧,DLSS 5、Reflex等技術都是原生支持的。重點是,這套運行方式可以在輕至1.36kg、14mm的輕薄本中實現。我們知道目前有諸如機械革命耀世/翼龍15 Air之類的機型將GeForce RTX 5060 筆記本電腦 GPU的獨顯本做到了1.5kg,也有理由相信RTX Spark N1X在工程經驗豐富之後,輕薄性進一步降低到1.3kg以下,直接威脅核顯輕薄本的生存環境。
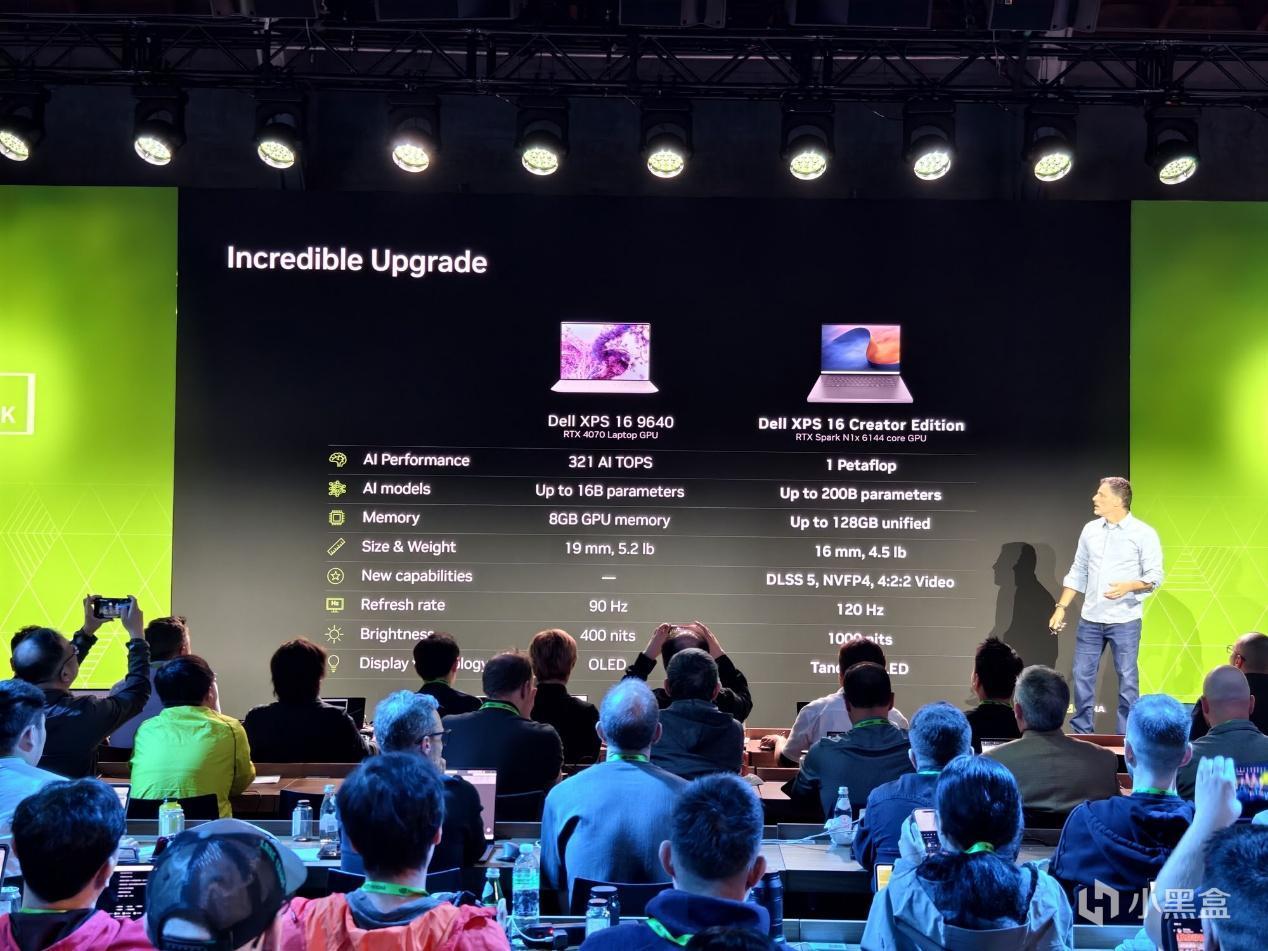
本機運行120B參數級以上的先進模型也同樣出現在RTX Spark N1X的現場演示中,這本來是工作站和服務器的應用範圍,但依靠128GB統一內存和NVFP4量化,RTX Spark N1X讓輕薄型筆記本也做到了。
在現場,NVIDIA用大約三年前的GeForce RTX 4070 筆記本電腦 GPU筆記本作爲對比,RTX Spark N1X的輕薄本可以做到三年前這款遊戲本的3倍綜合性能,3倍電池續航能力,12倍可運行模型規模,高達128GB的統一內存則是以前顯存加內存都無法比擬的。重點是RTX Spark N1X拋開了遊戲筆記本的厚重,更小、更輕、更薄。
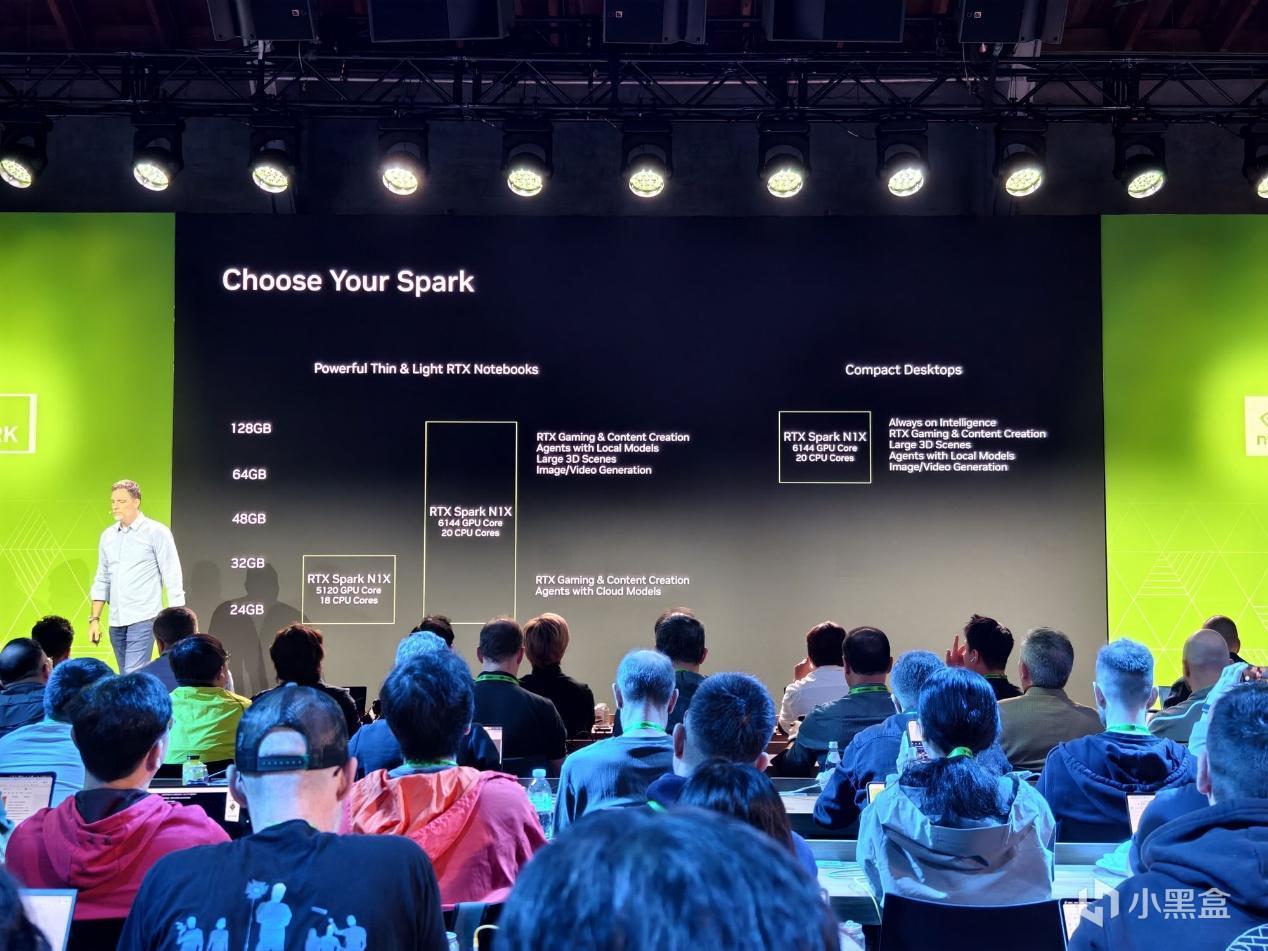
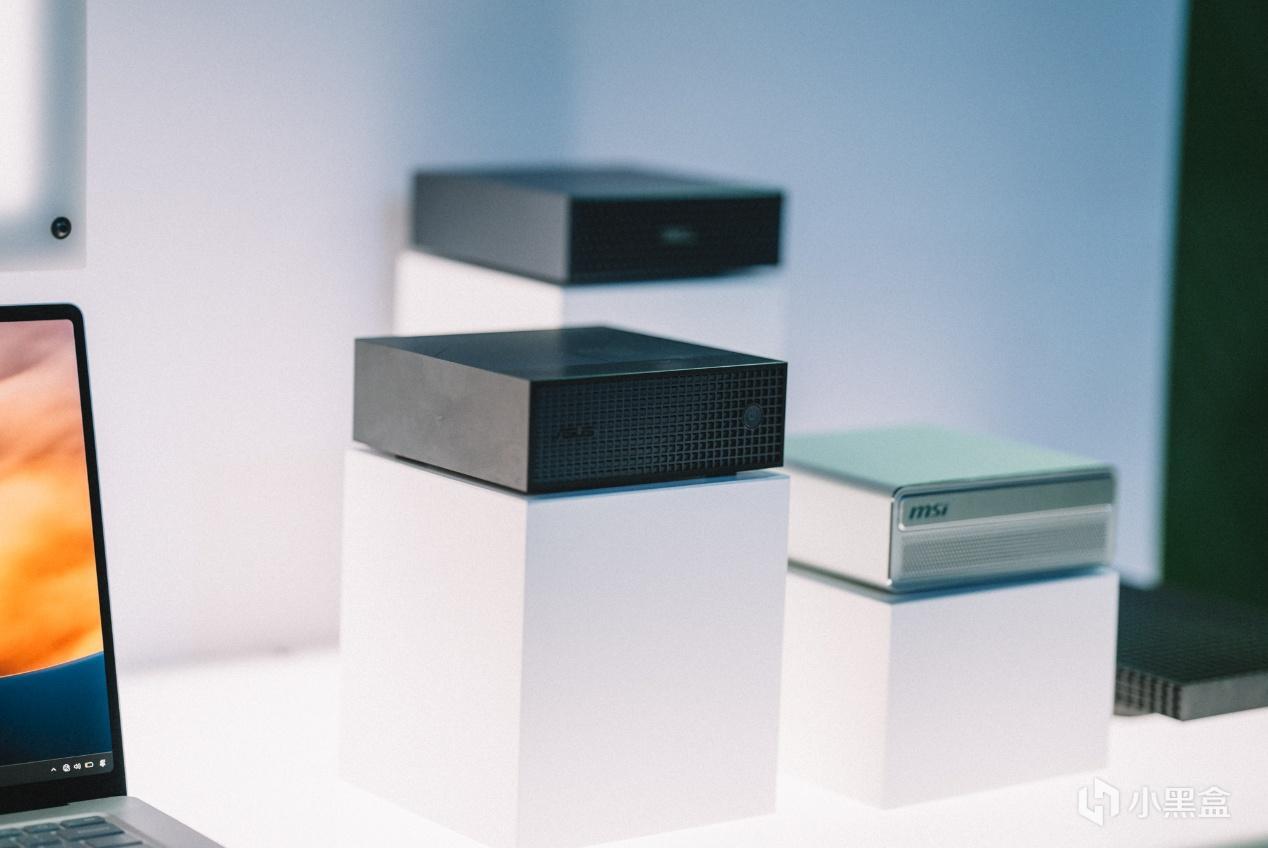
RTX Spark N1X的定位根據內存與核心數量也略有不同,比如RTX Spark N1X 650就能夠很好的滿足輕薄、遊戲、創作、智能體的輕薄本需求。RTX Spark N1X 675配128GB統一內存則可以運行大模型、大型複雜3D場景、動畫與視頻生成模型,同時也已經能夠兼顧緊湊桌面主機的需求,放在家裏、辦公室中長期開機,長期運行智能體,成爲家庭的算力中樞,成爲任何場景下的7x24小時常駐算力。
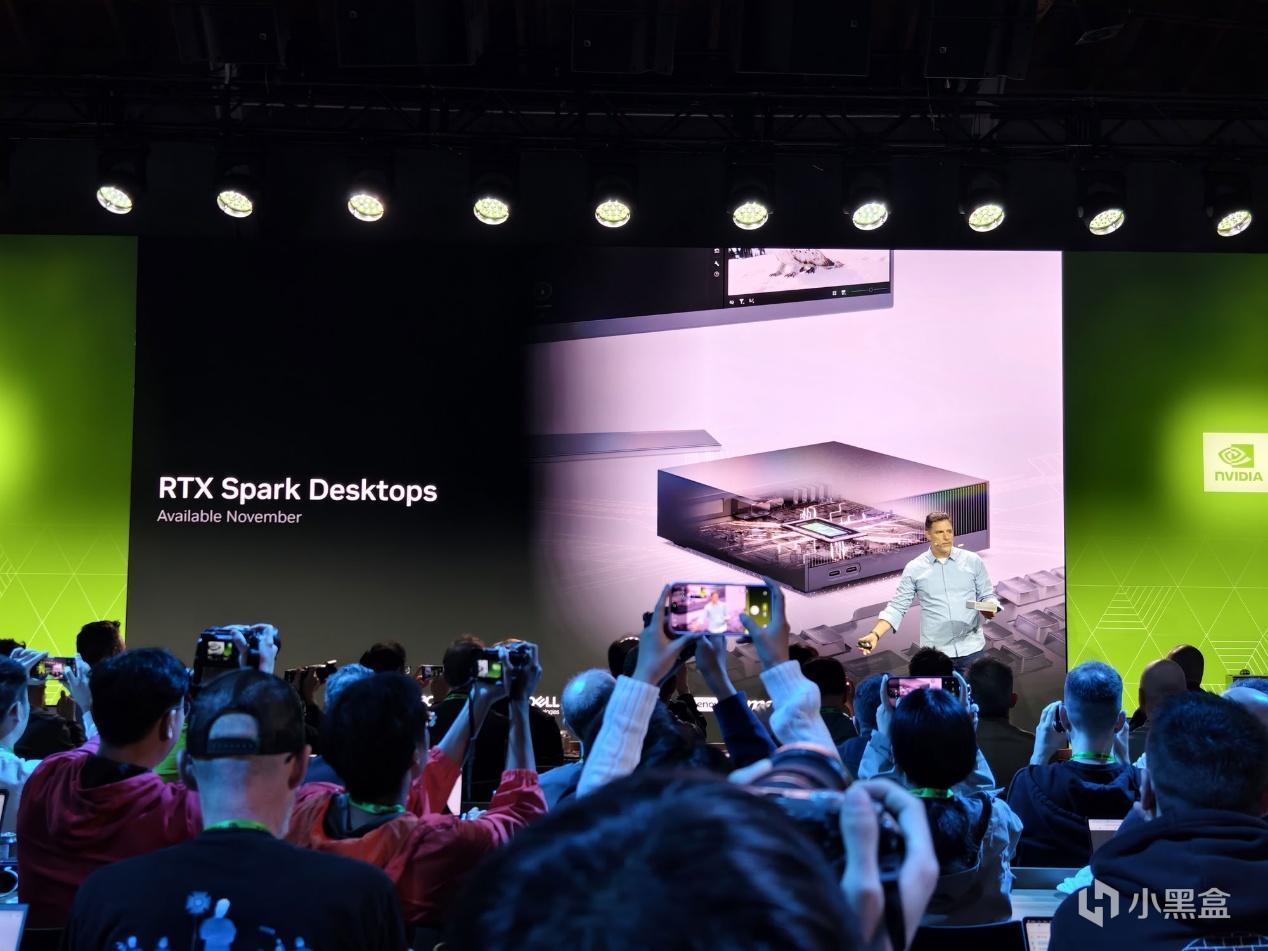
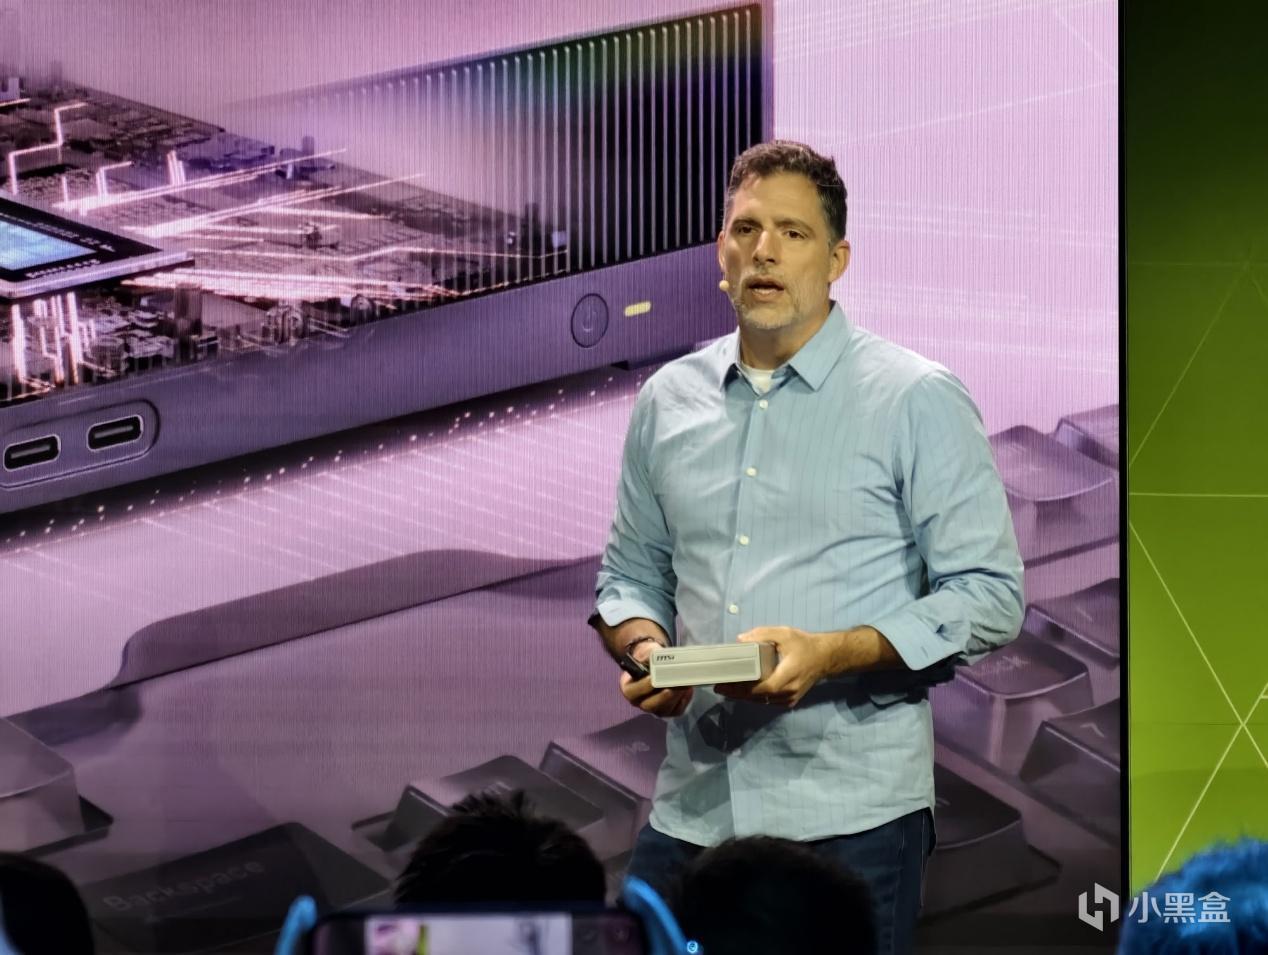
事實上NVIDIA也確實這麼做了,NVIDIA NeMo Switchyard模型路由器和NVIDIA PAIR軟件就是用來構建家庭、辦公室本地網絡AI推理集羣所準備的,RTX Spark也更好的匹配這樣的使用需求。
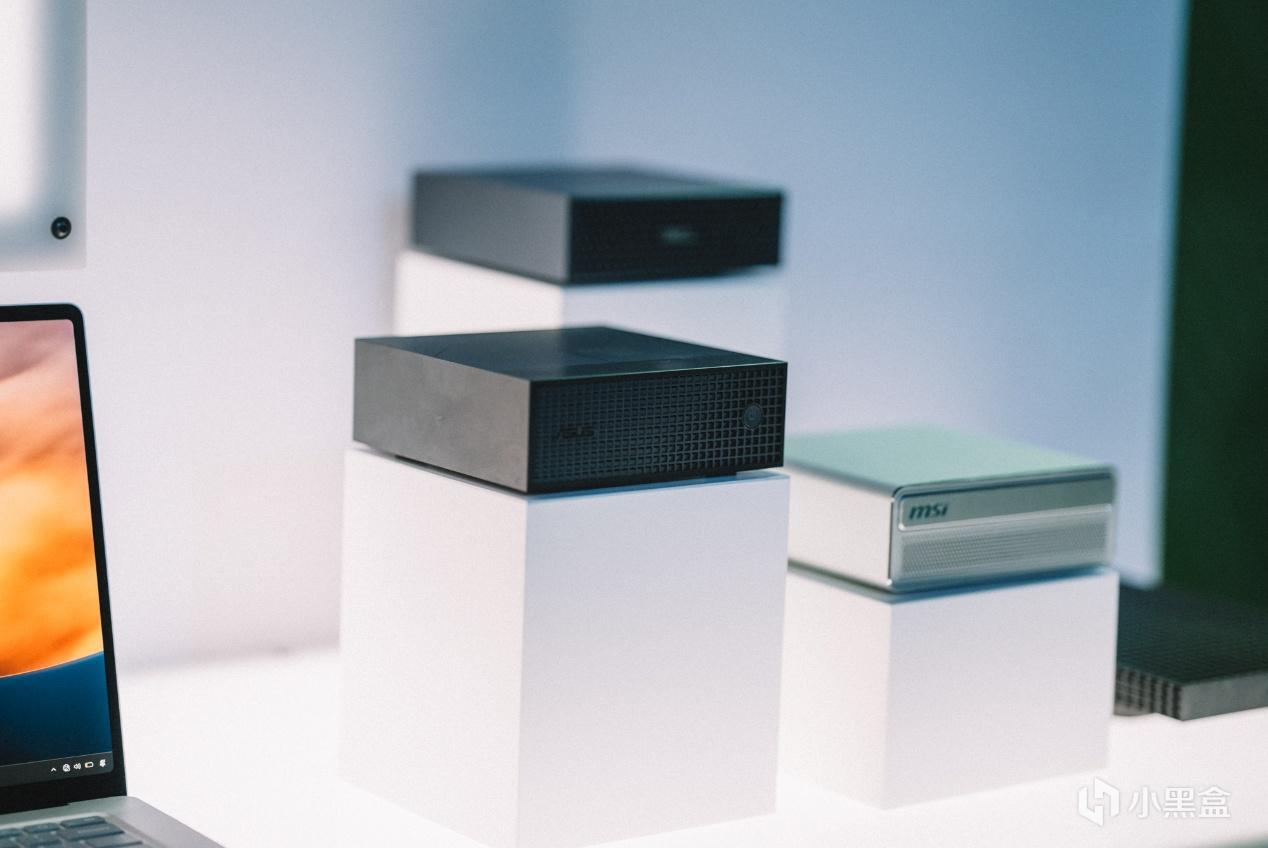
目前爲止,除了剛剛提到的微軟Surface、聯想,華碩、戴爾、惠普、微星等一衆廠商均已經推出了RTX Spark相關的OEM機型。並且作爲第一款RTX Spark,衆廠商下足了猛料,不僅質感好,並且漂亮、不易沾指紋、輕薄、全天候續航、插電拔電性能一致。從現場體驗來看,現場的OEM筆記本都給筆者留下了非常好的印象,也對得起首發不低的價格。
智能體生態
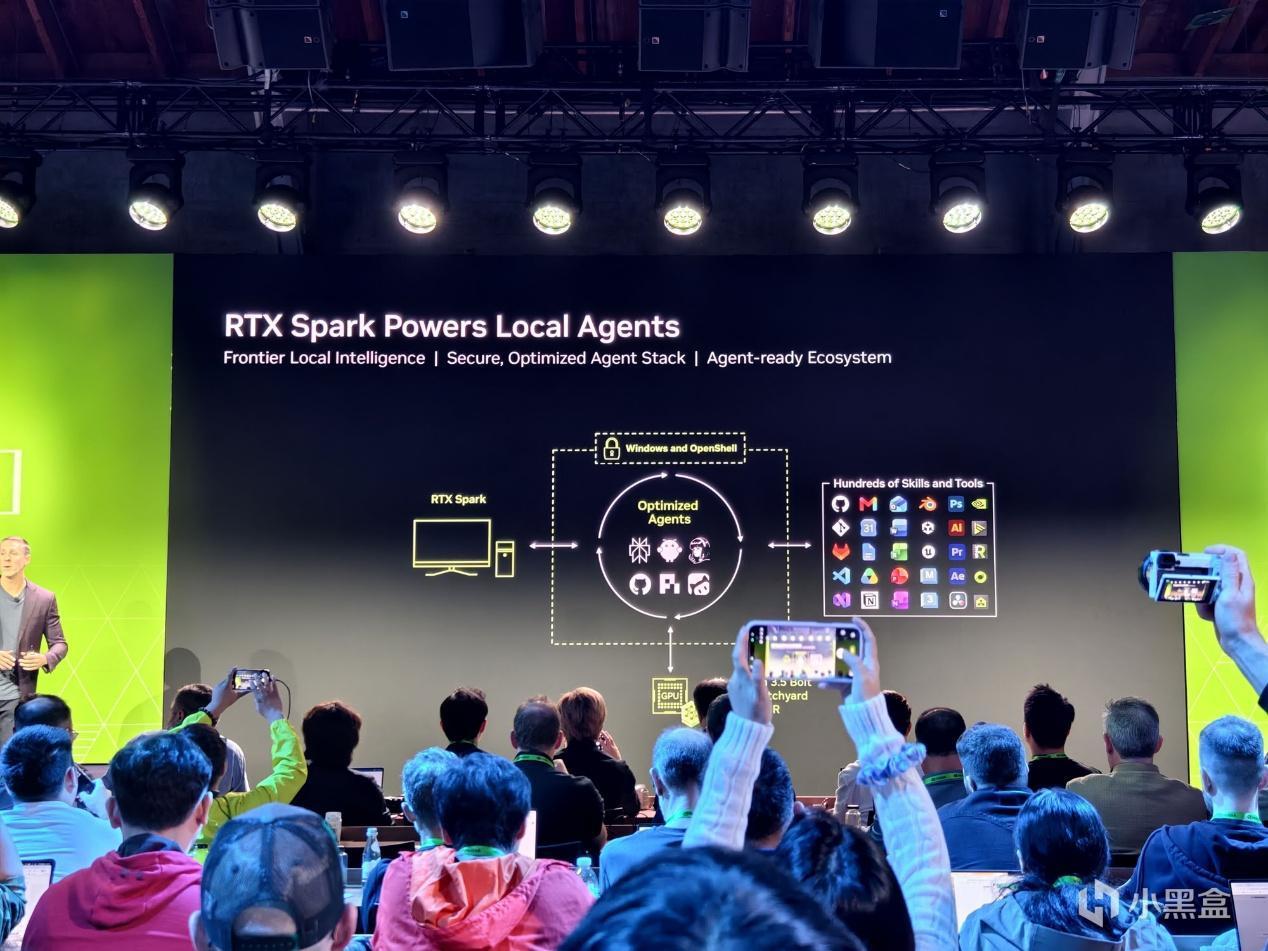
NVIDIA將智能體拆分成五個組成部分,即輸入(Input),智能體框架(Agent Harness),大語言模型(LLM),工具(Tools),安全框架(Security Framework)。後面我們提到的微軟MXC、NVIDIA OpenShell、Hermes、MCP生態都可以對應到層級中的某個層面。
其中,輸入(Input)不只是自然語言的文字和語音,還包括用戶的知識、策略(policy)、甚至應用的實時狀態,智能體實際看到的世界比聊天框大得多。智能體框架(Agent Harness)承載推理-行動循環的應用,例如Perplexity、OpenClaw。大語言模型(LLM)是智能體調用來完成思考的部分,模型可以是本地的,也可以連接雲端前沿模型。工具(Tools)是智能體調用來執行動作的能力,既可以是Blender這樣的應用程序,也可以是系統級工具。最後是安全框架(Security Framework),作爲至關重要的一部分,它將決定智能體能在用戶PC上實際採取行動、能訪問真實數據,所以必須在 OS 層確保智能體的行爲限定在用戶允許的範圍內。
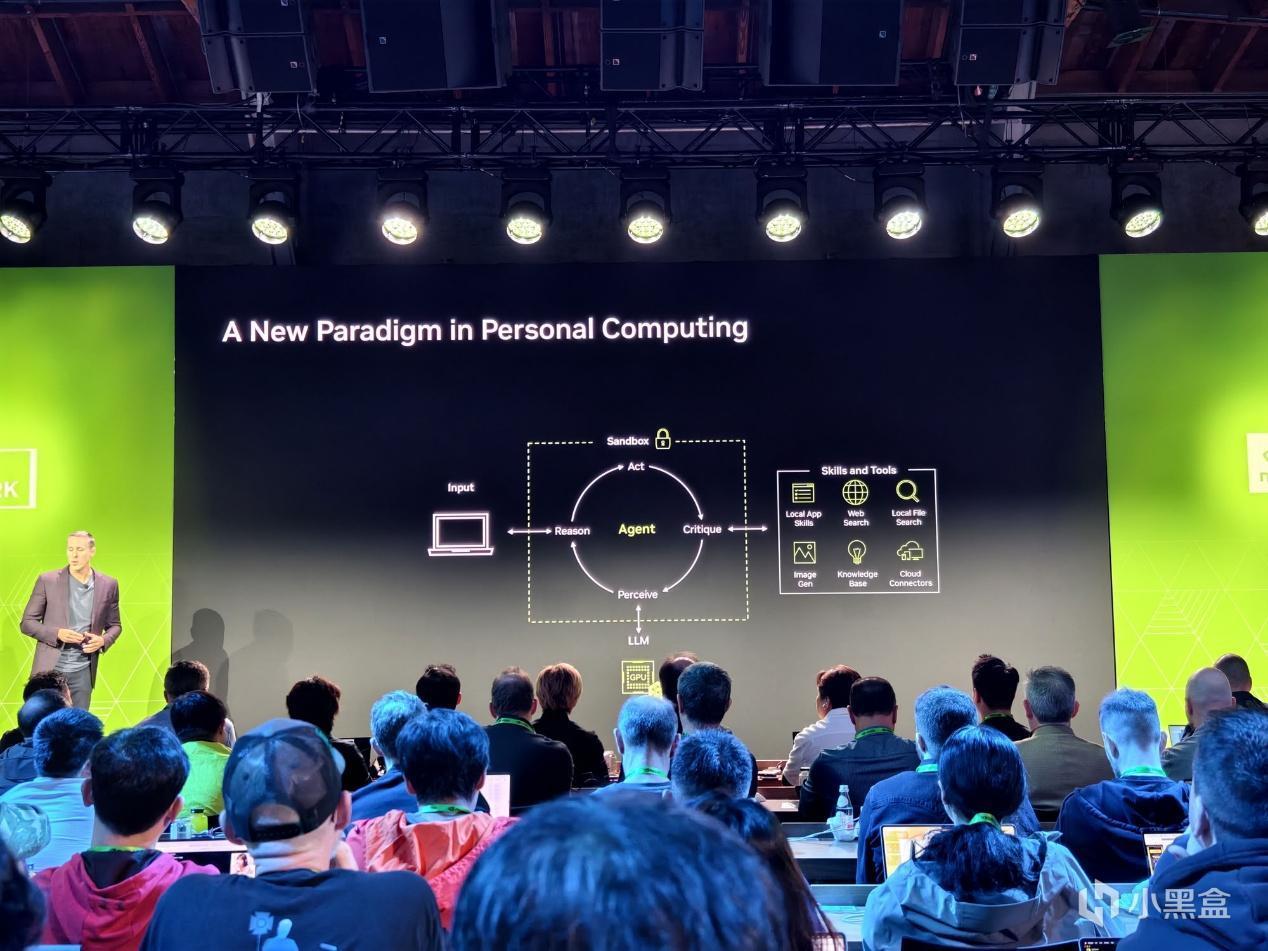
本地運行智能體有很多好處,它可以確保數據、個人文件、甚至屏幕上的內容,都不離開設備,並且在無網絡的狀態下也能運行。同時本地智能體沒有Token限額焦慮,不用實時盯着用量,一次性硬件投入之後,使用幾乎是免費的,對於普通用戶、創作者、開發者而言,從常規的日曆、郵件管理、到工作流搭建、再到修代碼Bug,本地智能體最有機會將PC從工具變成隊友。
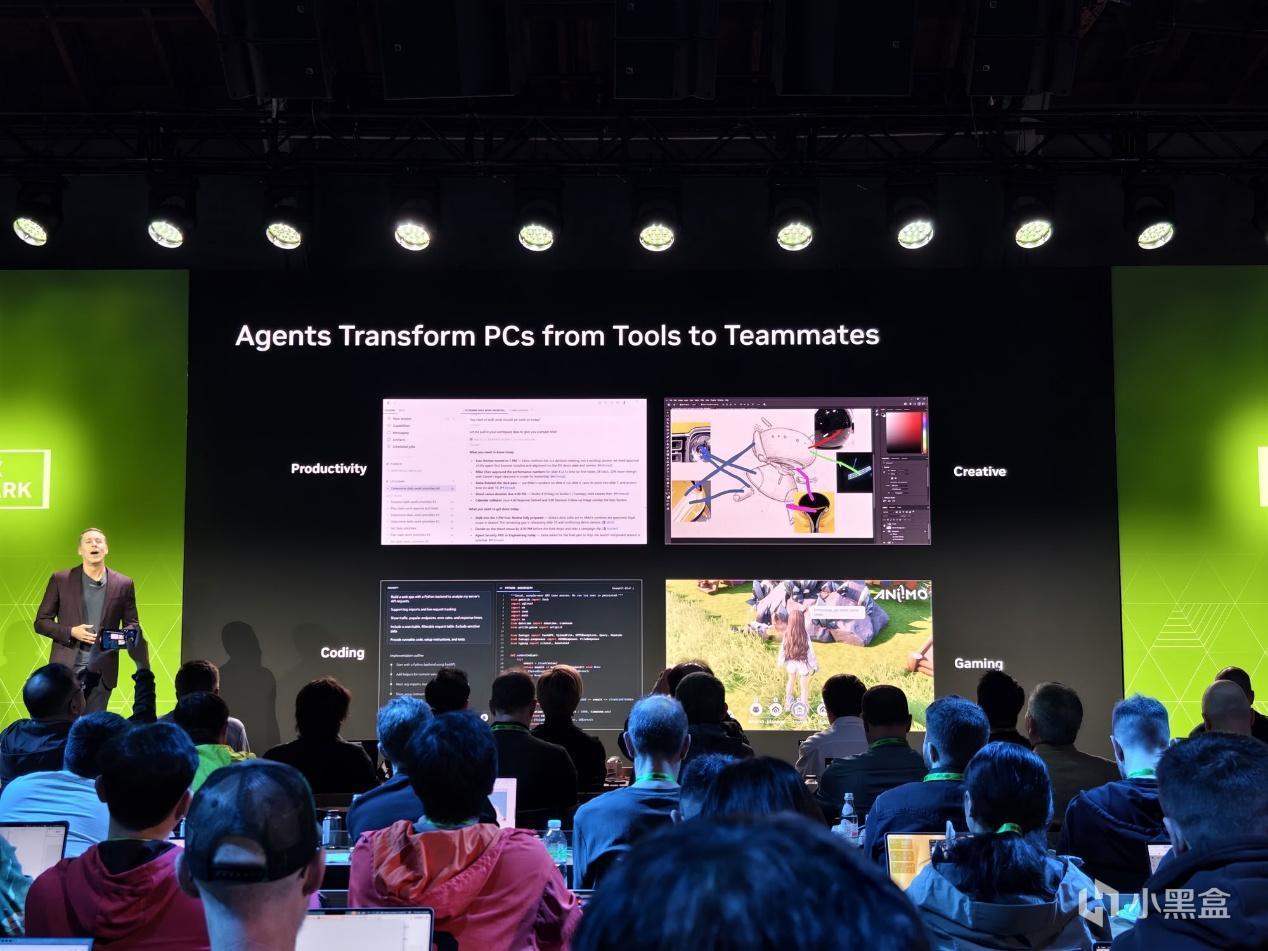
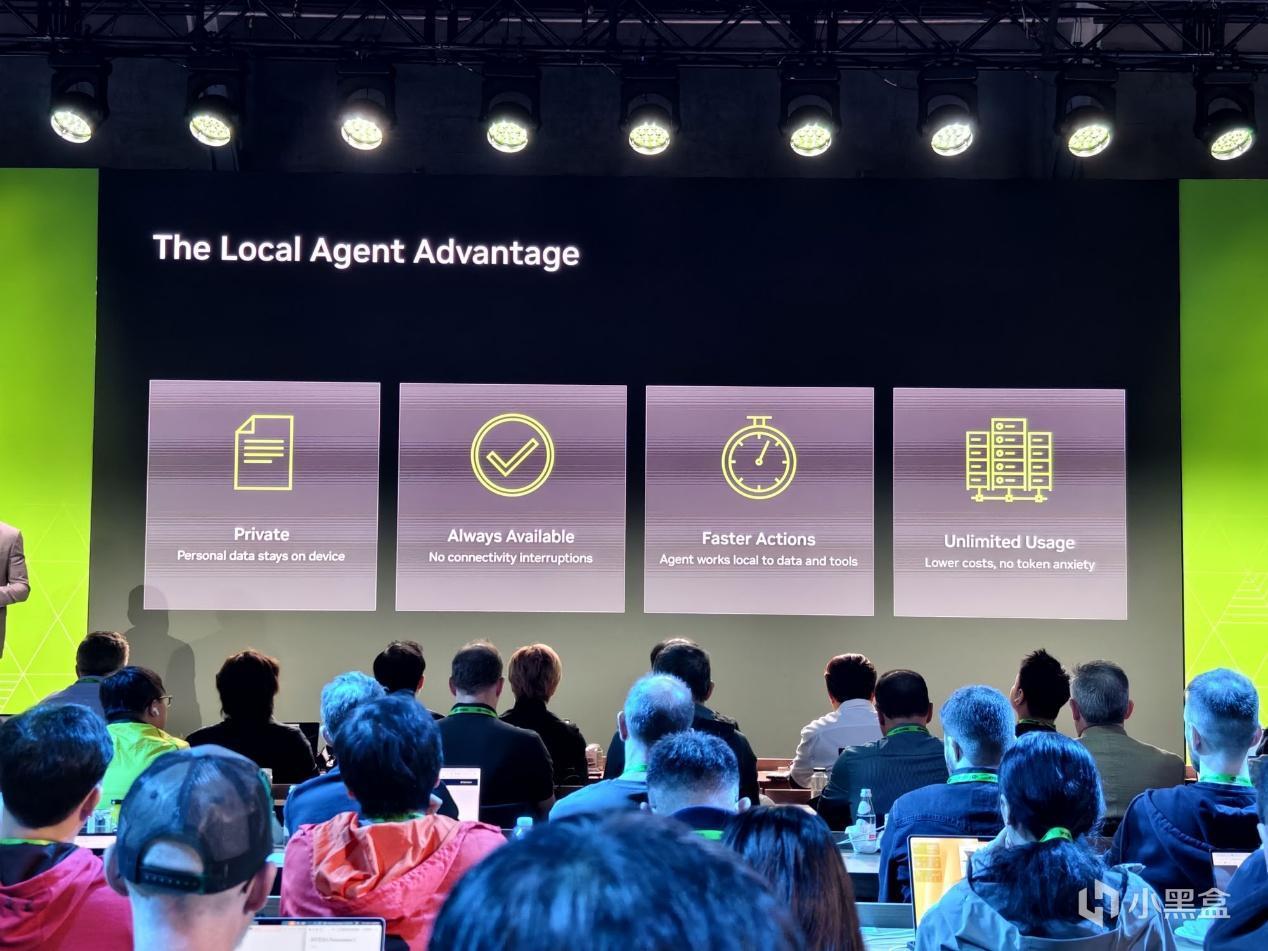
同時本地智能體的發展速度很快,它往往比雲端智能體晚4到6個月,比如某個雲端智能體型號在發佈4個月後,基於本地運行的Qwen3.8 Flash Next就達到了同樣的水平,而今天典型雲端訂閱用戶實際用的就是默認模型,這意味着如果這一類用戶付費訂閱日常用的那個模型,實際上和本地能跑的模型是一個級別的。
RTX Spark筆記本可以看成是一臺個人Token工廠,一臺RTX Spark本地跑Qwen3.8 Flash Next,月產出約6,100萬token,電費成本是可以忽略不計的。但走同等量的雲端訂閱,成本可能高達數千美元。因此NVIDIA認爲RTX Spark不只是創作和遊戲設備,它是一臺token 發電機,幾個月就能自己賺回本錢。
當然本地也不是萬能的,一旦超過一定閾值,雲端模型就會介入。這時候系統裏有一個評判模型(judge),智能體收到用戶prompt後,本地模型先作答,judge評估回答質量,夠好就直接返回用戶,不夠好再升級。同時用戶可以爲需要前沿推理的少數查詢設置升級策略,且路由時可以按隱私策略脫敏。
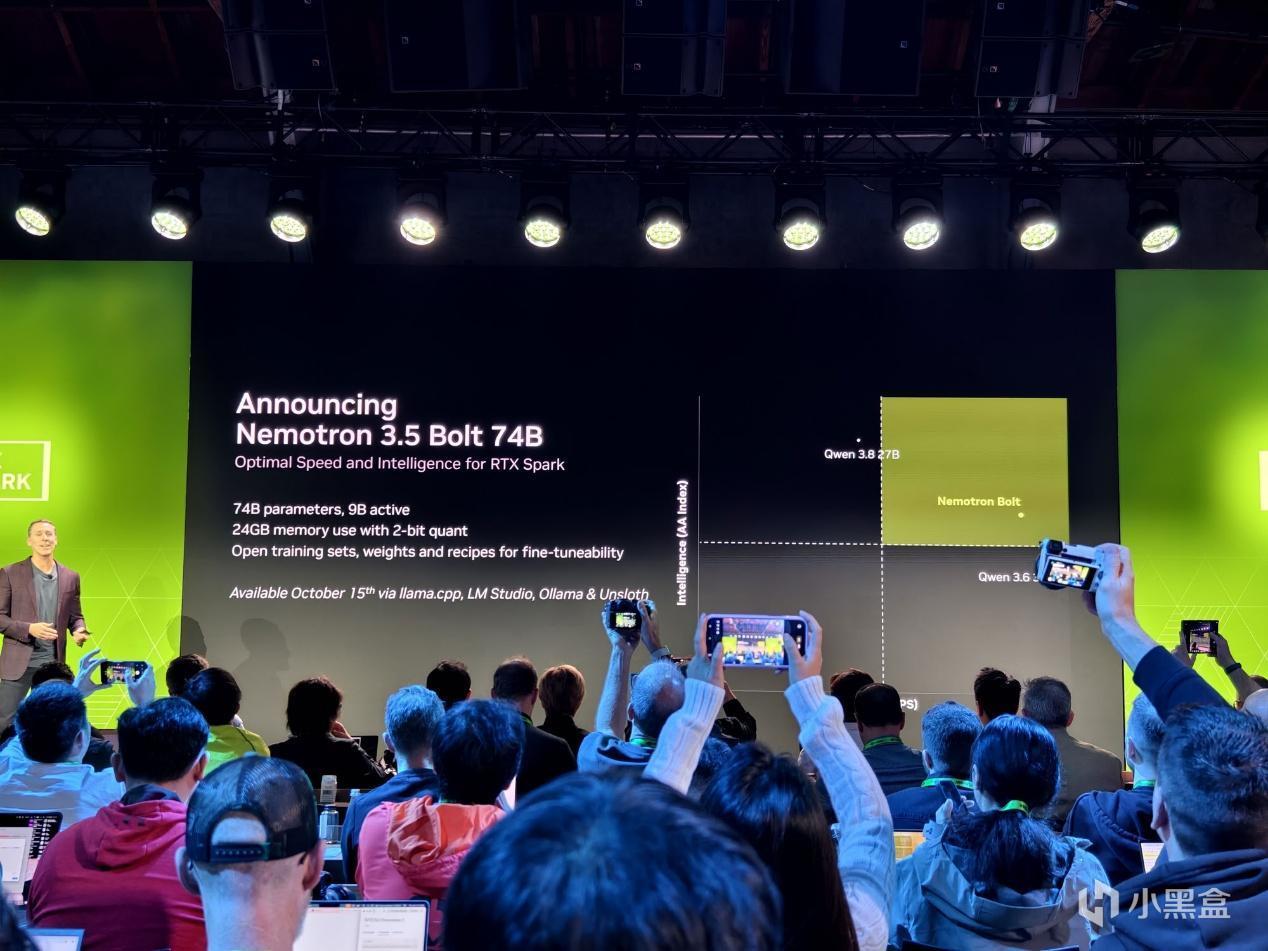
在現場,NVIDIA還發布了全新的Nemotron Bolt模型,採用MoE架構,總參數740億,任意時刻僅激活90億參數,通過稀疏激活換推理速度。這是因爲常規量化下它會佔用大量內存,2-bit量化後壓縮到可在RTX Spark上舒適運行。這套模型專爲RTX Spark調優,並已經實現Day-0匹配。
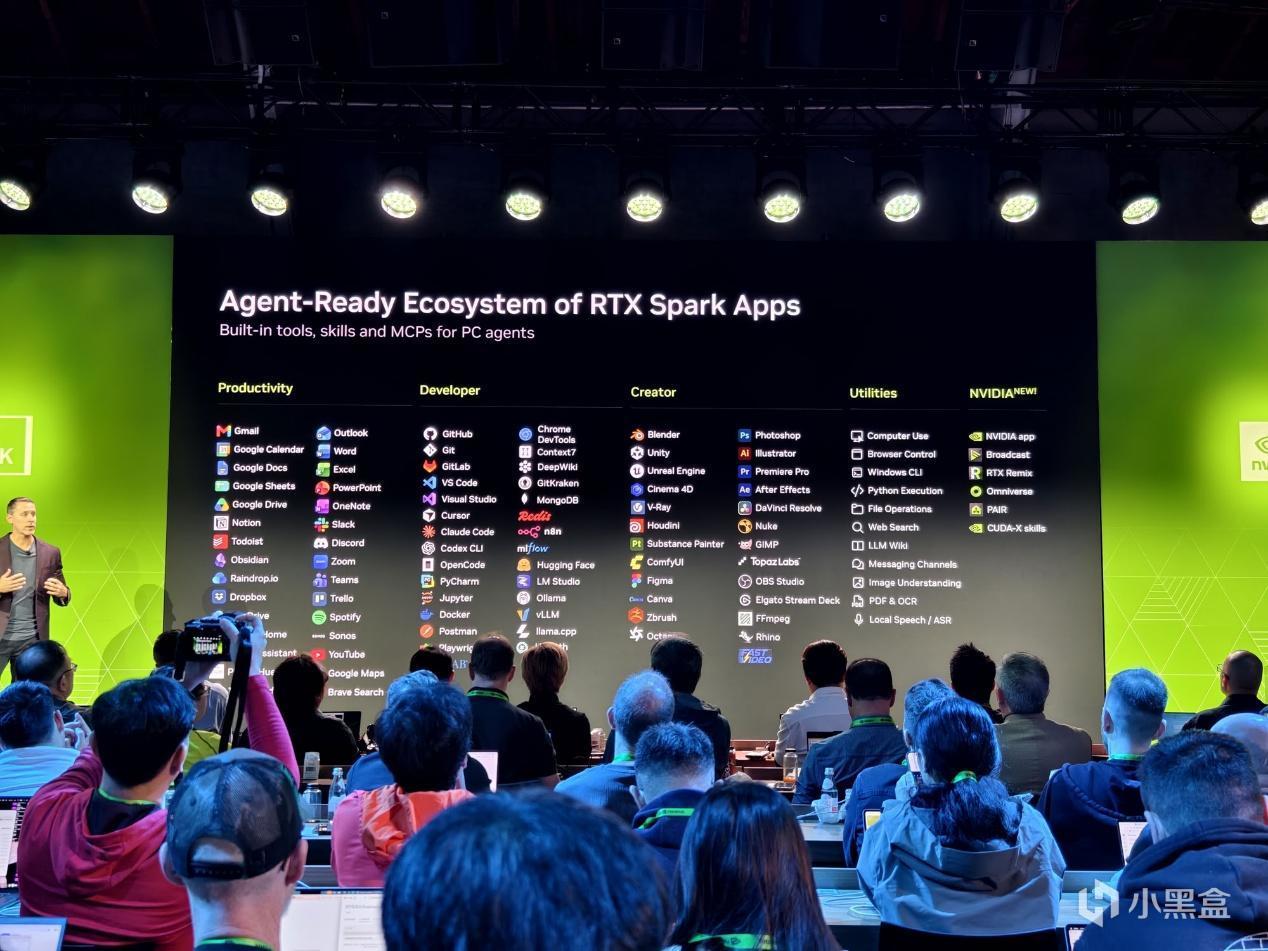
爲了讓智能體有更多開箱即用的工具,NVIDIA爲頭部應用準備了MCP服務器和命令行接口。例如針對開發者的GitHub系工具,創作者的Blender、Unreal Engine、ComfyUI,系統級別的瀏覽器操作、文件搜索。同時NVIDIA自家全家桶都開放了MCP,包括Broadcast、RTX相關庫。NVIDIA App和Broadcast均內置本地MCP服務器,也方便我們後續使用騰訊WorkBuddy時候可以直接調用。
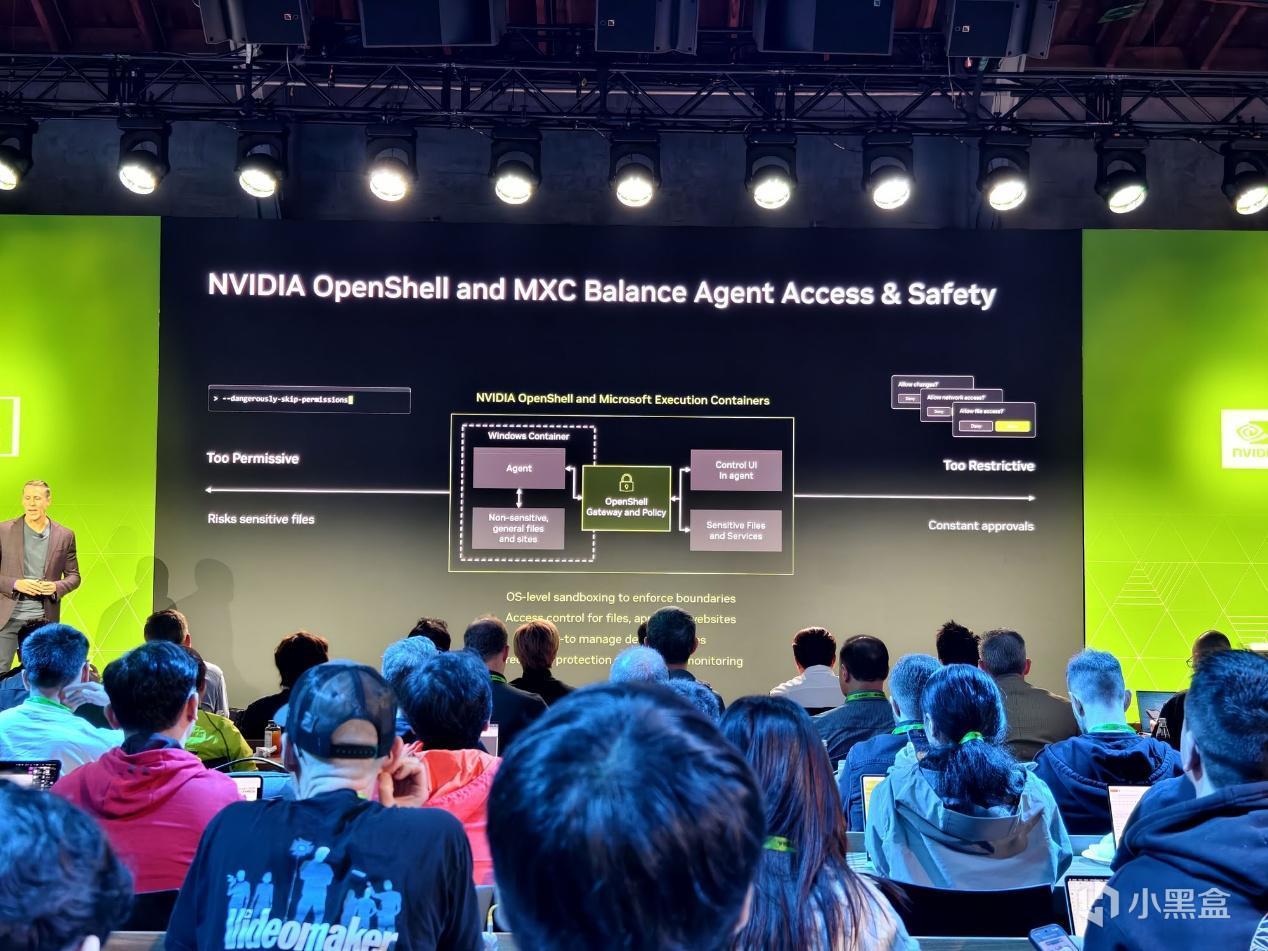
安全部分NVIDIA先匹配了時下兩種流行但都不合適的模式。一種是小龍蝦的YOLO模式即全部自動放行,這樣方便但等於裸奔,智能體會拿着用戶權限橫衝直撞。另一種是事事詢問,每個動作都彈窗要權限,體驗拉胯。
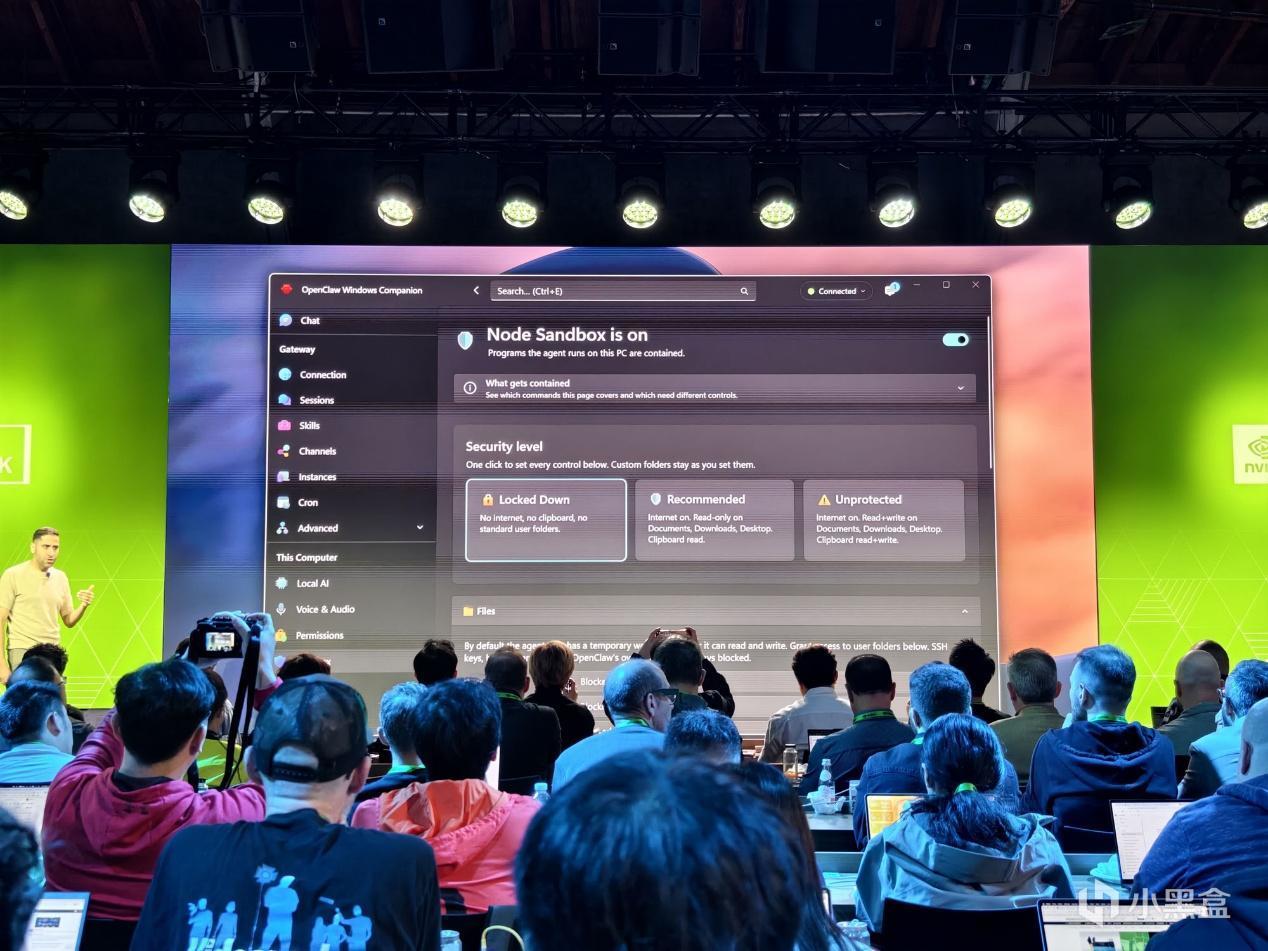
這裏NVIDIA與微軟給出了一套雙層方案,在底層基於微軟MXC(Microsoft Execution Containers)進行,通過強制劃界,安全不依賴智能體自覺,容器自動攔截對敏感文件和系統文件的訪問,用戶明確定義哪些文件、哪些應用對它開放。上層則基於NVIDIA OpenShell,這是基於MXC的治理層,提供更細顆粒度的控制,包括網絡訪問管控、憑據保護、安全監控。這樣可以做到智能體有足夠的權限幹活,不必幾秒鐘來煩用戶一次,同時敏感數據始終在安全範圍內。
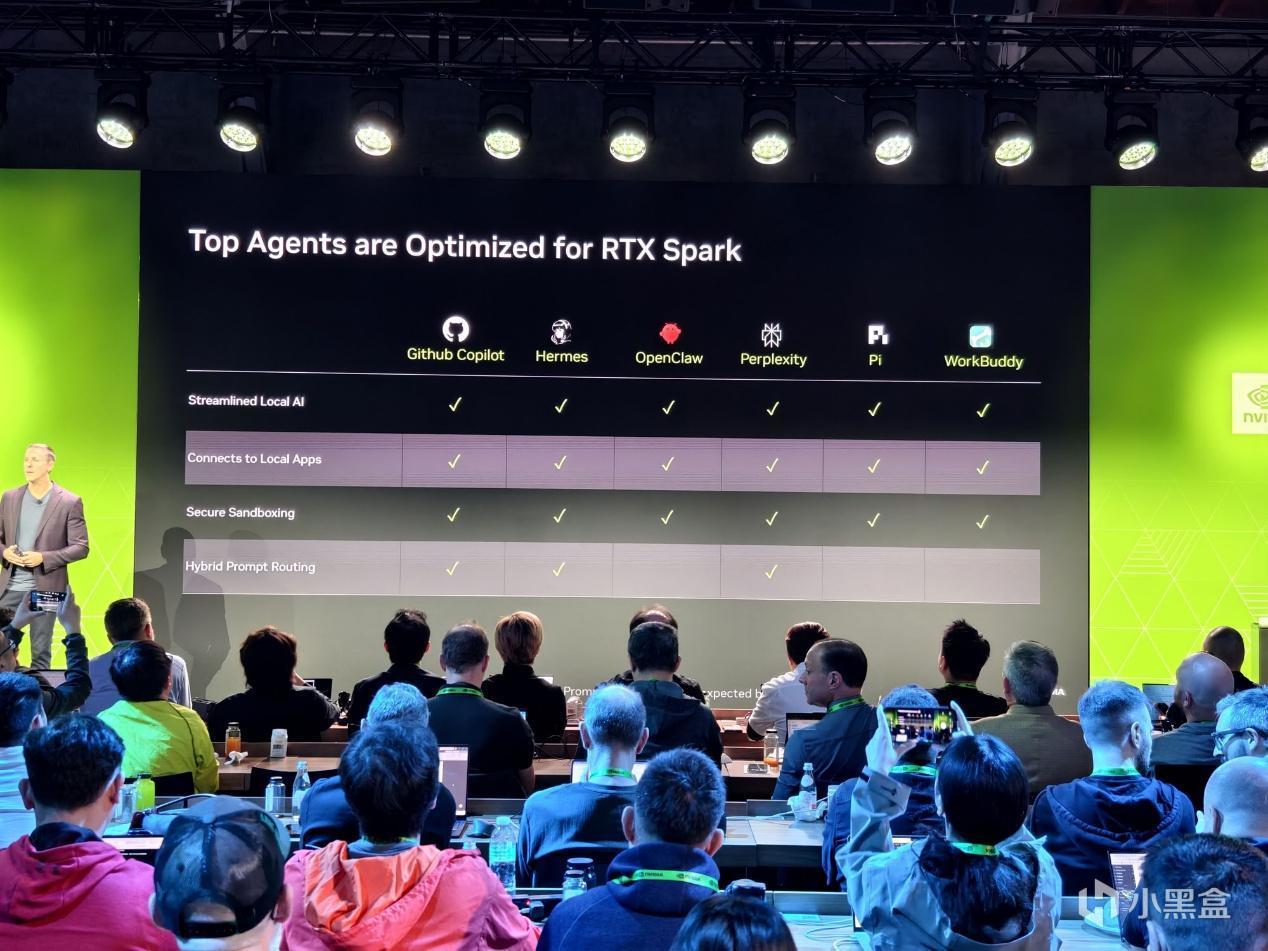
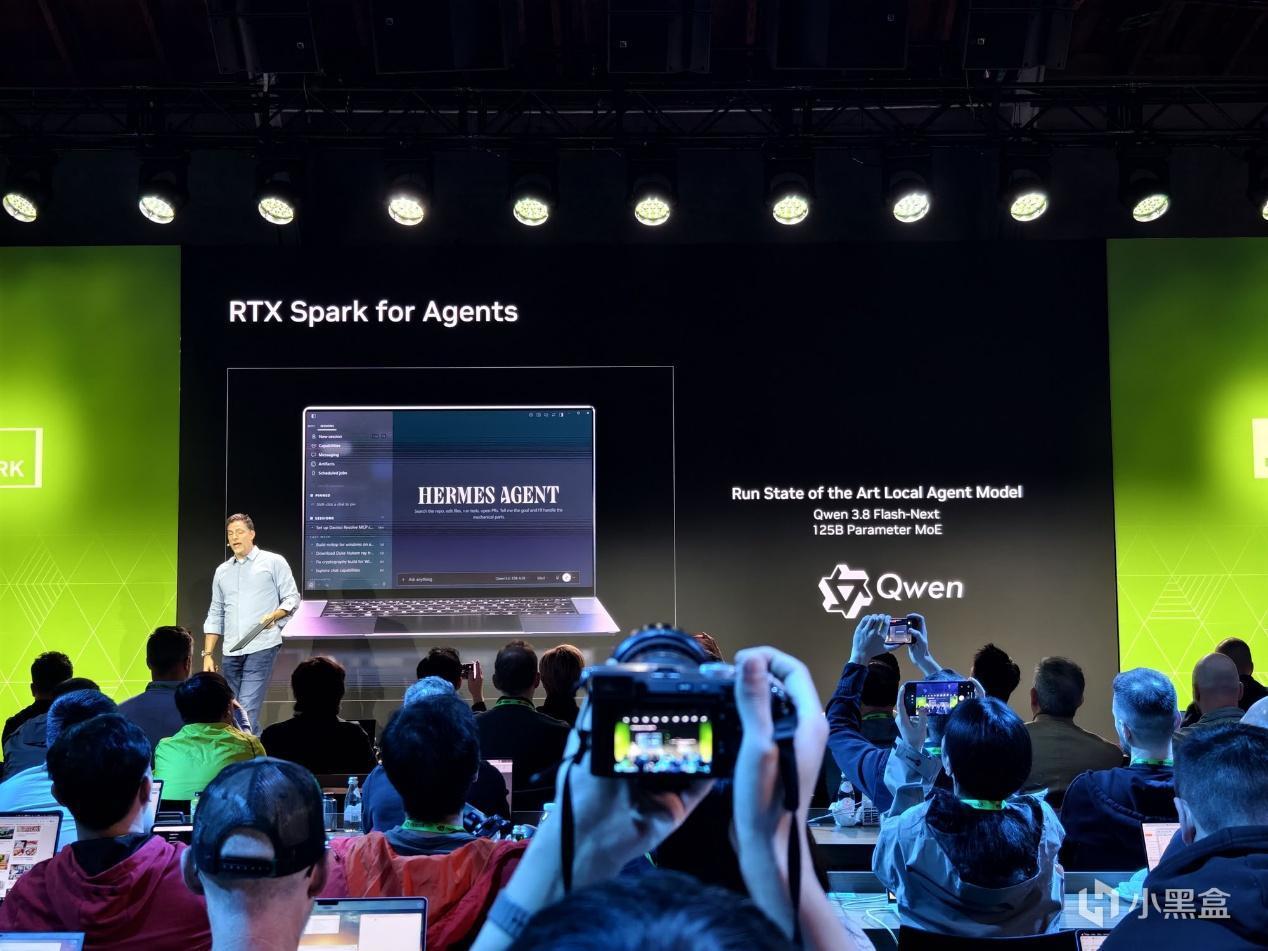
在RTX Spark筆記本上,優化過後的Windows on Arm首次開機有引導式對話,幫用戶跑通第一個智能體,例如Hermes。同時Playbooks可以按用戶角色預置的技能與工具清單,託管在build.nvidia.com,也預設在Windows菜單中,在上手的一小時內就能幫用戶通過智能體完成幾件有意思的事。
目前首批完成本地優化的智能體名單包括GitHub Copilot、OpenClaw、Hermes、Perplexity,以及面向中國用戶的WorkBuddy,它們均開箱即優化的本地模型配置、本地Windows 應用連接、簡化的工具安裝 UI、MXC 沙箱,並通過NVIDIA OpenShell治理、混合路由本地和雲端模型分配。
進階:家庭智能體
在媒體分享會上,NVIDIA技術副總裁Jason Paul把智能體的存在層級分成三層,分別是個人智能體、家庭智能體和團隊智能體。
個人智能體即擁有用戶的個人知識、品味與偏好,能訪問用戶的私人數據;家庭智能體獨立於個人智能體單獨存在,它承載整個家庭共享的知識,認識家裏的成員,能控制每一臺智能設備。由於家庭數據不屬於任何單個成員,權限和知識邊界天然不同;團隊智能體則是團隊協作中的共享機制,適用於公司和小微企業。
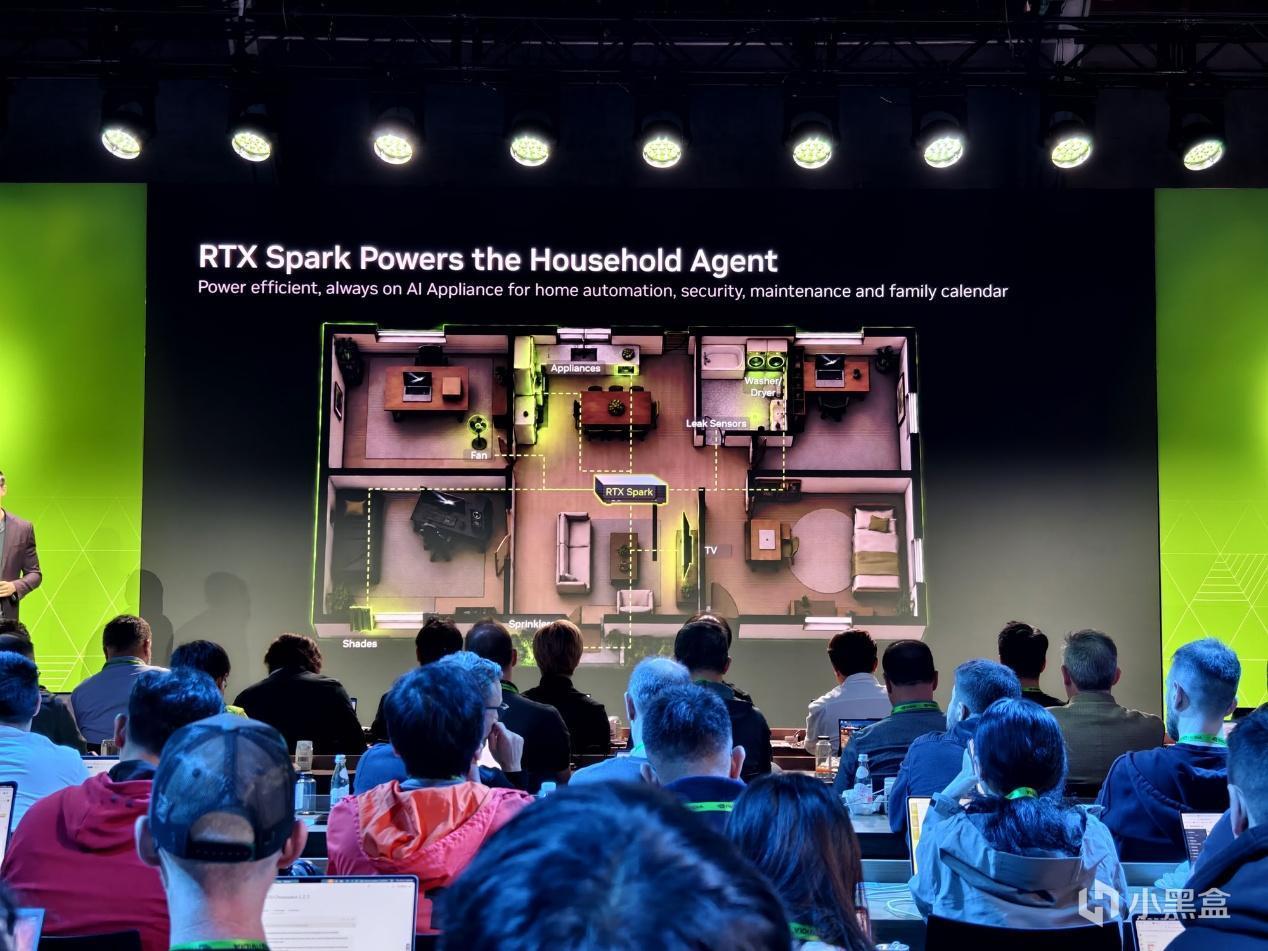
這裏NVIDIA主要關注家庭智能體的發展,並圍繞此推出了NVIDIA PAIR。
在NVIDIA定義中,家庭智能體有四個應用場景,包括智能家居控制的自然語言化,安防本地化,家庭日曆,以及門鈴與包裹事件應對。
其中最重要的是智能家居控制的自然語言化。在當下配置智能家居要手寫一大堆規則、在一堆難用的App裏來回設置,家庭智能體可以通過推理取代手寫規則,利用自然語言入口管住所有設備。
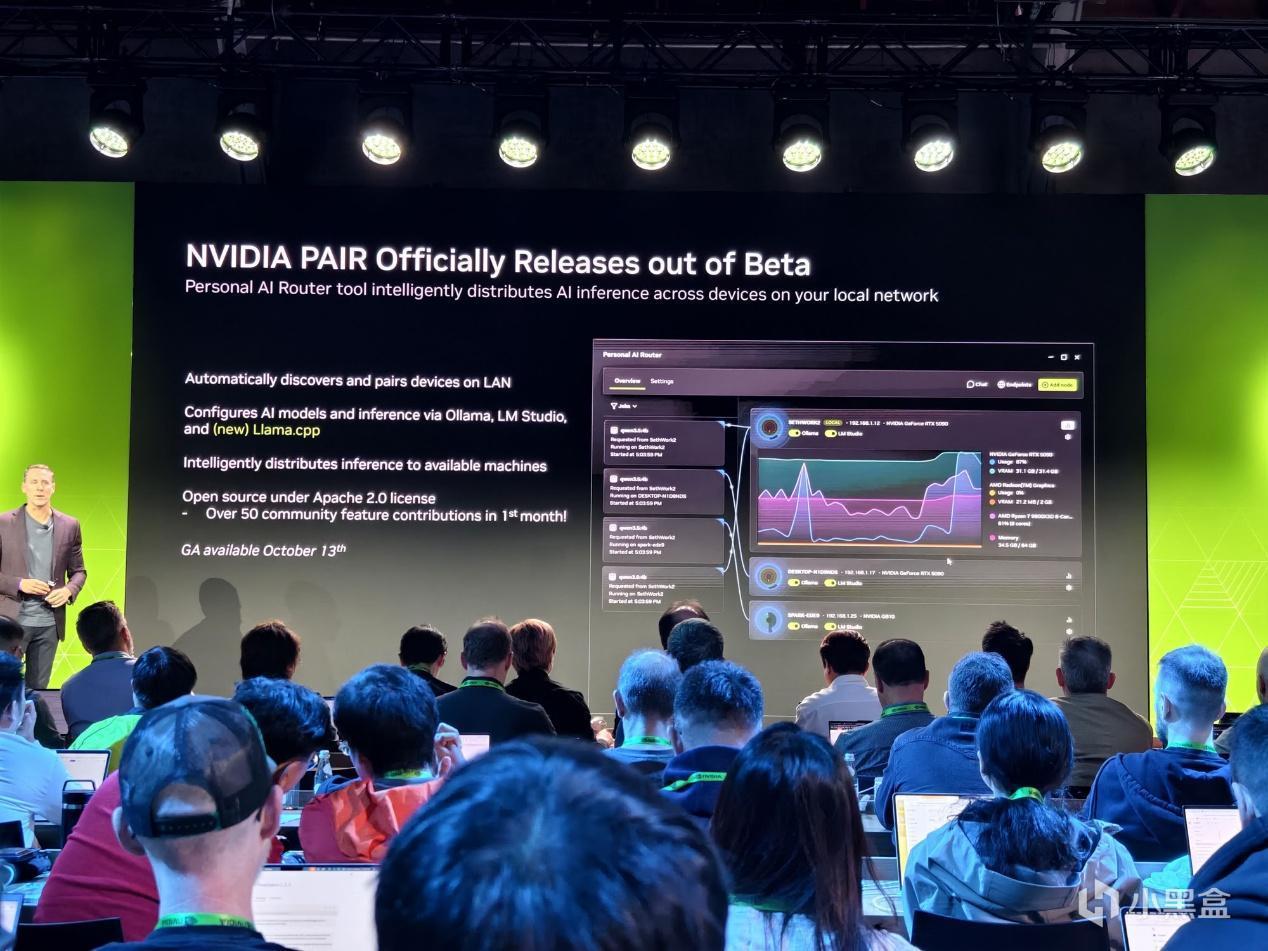
安防本地化是家庭智能體的另一個應用場景,監控攝像頭的數據可以留在本地、不上雲,家庭敏感的隱私數據不會被曝光。家庭日曆則可以共享日程的管理與提醒。最後是門鈴與包裹事件,當門口有人、包裹時自動識別,並通知用戶,或者代替用戶給訪客留言。
這四個應用場景需要一套家庭算力網絡提供支持,RTX Spark可以作爲中樞使用,它既可以成爲用戶的個人智能體的常駐運行地,又是一個閒置算力池的調度者。同時閒置設備可受邀加入,家裏其他成員的PC,例如遊戲本,在有餘力的時候可以加入到算力池子中。整個過程可以執行任務級分發,來自團隊任一成員的智能體任務流不斷進來,同時任務被拆分成子任務,派發給家中的各臺設備並行執行。
創作與生產力
在2010年CUDA首次被應用在Adobe Premiere Pro CS5的播放引擎中,讓創作者第一次不用等渲染就能看到自己的內容。到了2020年前後,通過DLSS 2.0僅需要渲染四分之一的像素就能預覽專業軟件中的畫面, Broadcast更是把AI降噪和背景效果帶給日常麥克風和攝像頭。到了2024年後,大生成模型落地設備端,NVIDIA與Black Forest Labs合作把FLUX.1從23GB壓到10GB(NVFP4),本地生成變得更爲可行,這就讓RTX Spark的128GB統一內存和1 PFLOPS FP4 AI算力有了更多潛力。
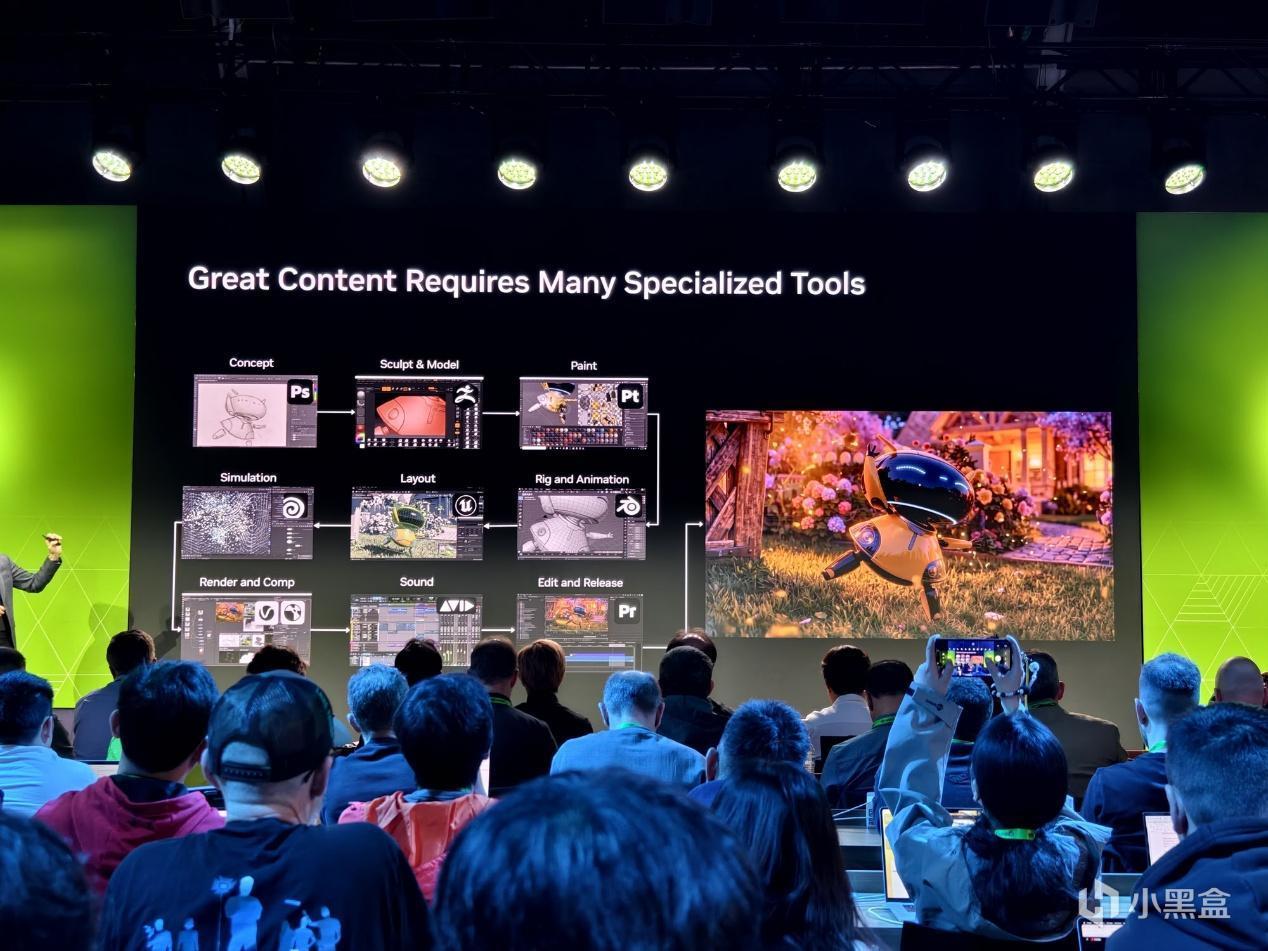
創作者有品味、有野心、有想表達的東西,但常常被執行能力卡住,指望一個人精通當今複雜管線的每一個工具是不現實的。RTX Spark通過創作應用、生成式AI、創意技術三個方面涵蓋創作與生產力。
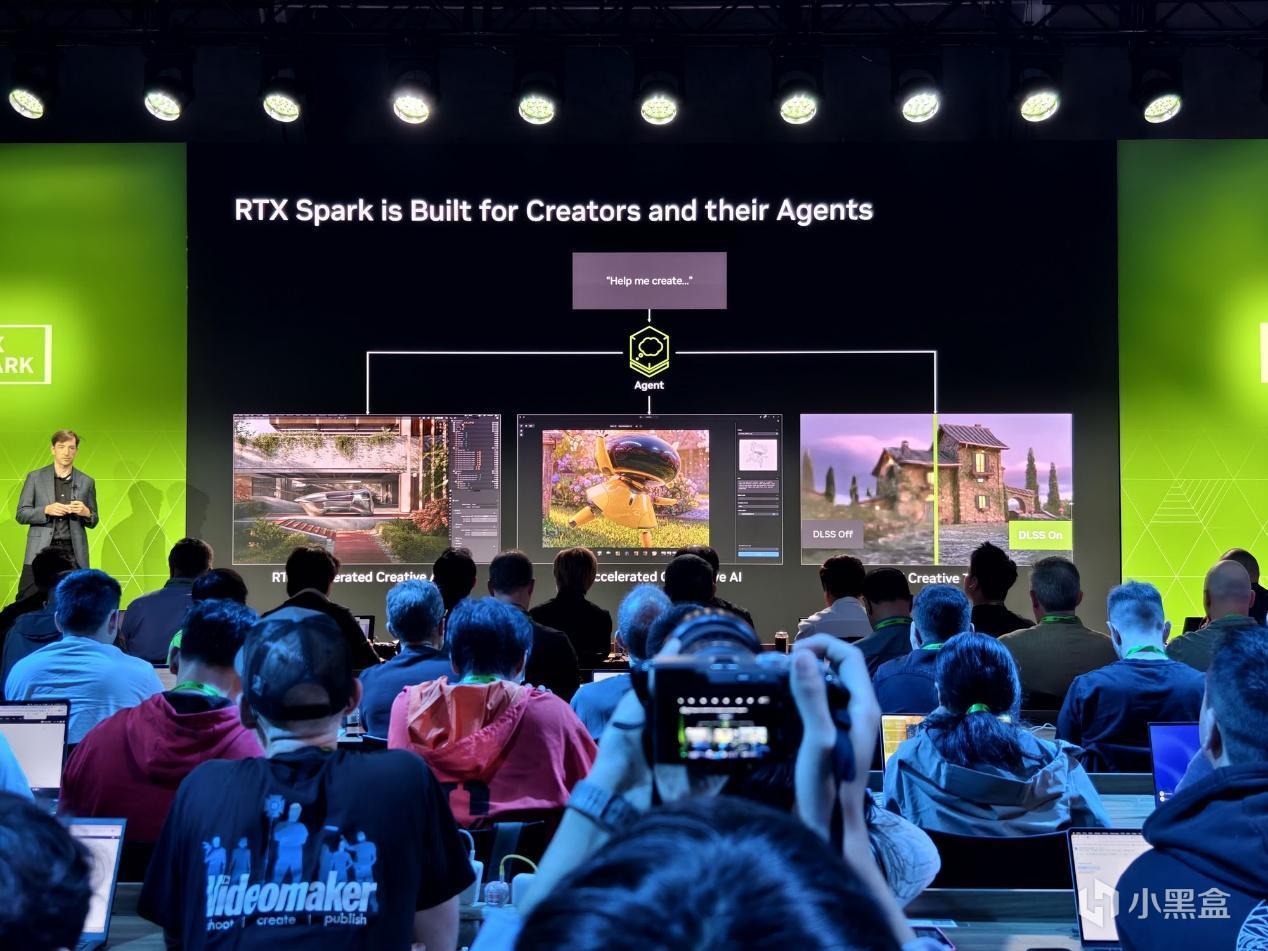
目前爲止,已經有超過130款RTX加速創作應用提供支持,包括Premiere、Photoshop、Blender、虛幻引擎、達芬奇等,且當天許多應用宣佈或已發佈MCP服務器,開放智能體控制。在現場展示中,RTX Spark N1X可以很好的運行虛幻引擎編輯器內一個70億量級多邊形的曼哈頓地圖大場景,通過DLSS 4.5實現120FPS的幀率,要知道,這可是一款輕薄型筆記本。
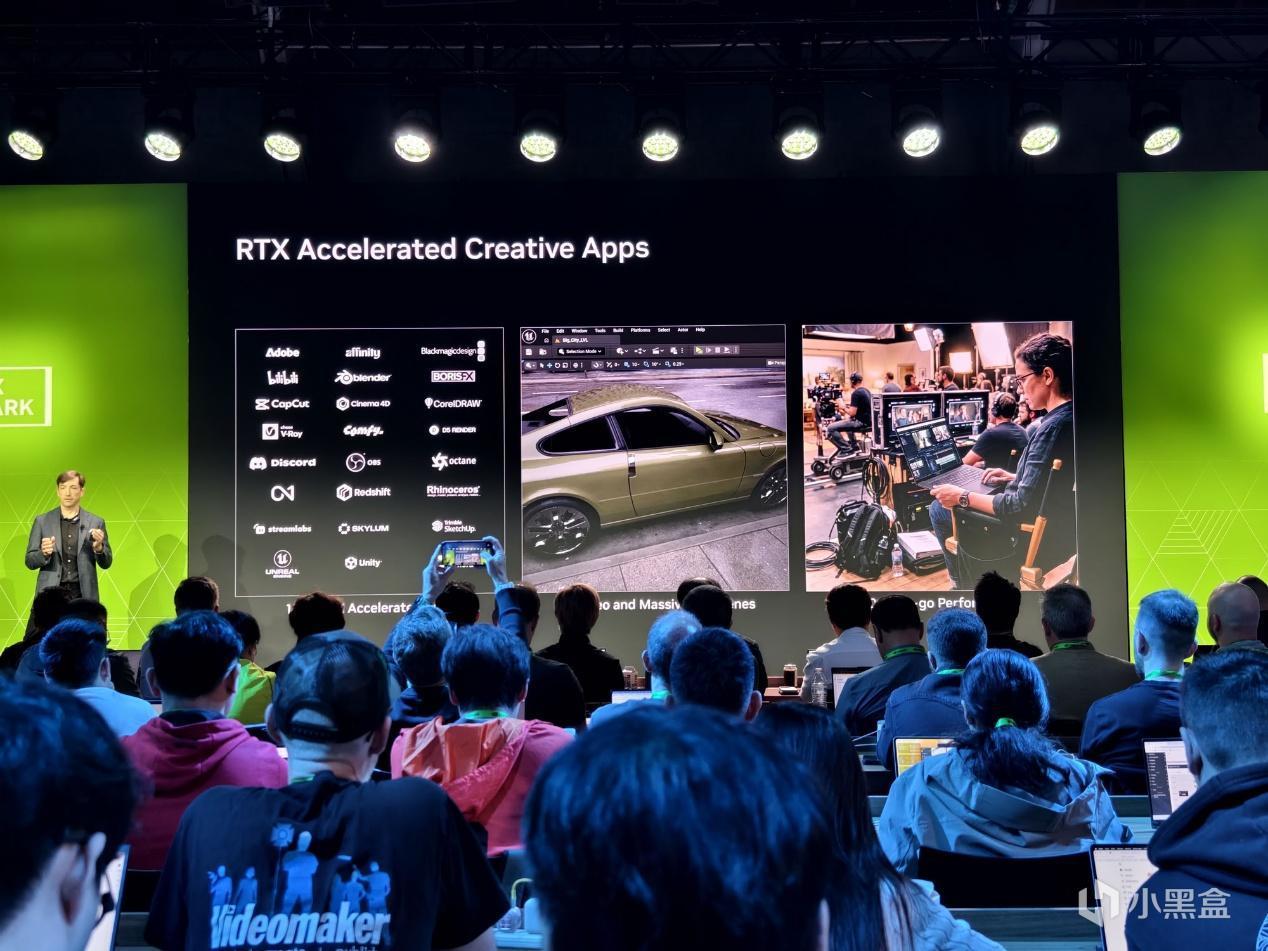
同時NVIDIA也強調,由於整機功耗在100W以下,在拔電狀態下,體驗也是沒有衰減的。當然這也得益於軟硬件對NVFP4的支持,因爲FP4模型更小、質量相當、性能還能提升1.5倍,128GB統一內存可同時常駐多個模型隨取隨用,且本地生成不按次數收費。
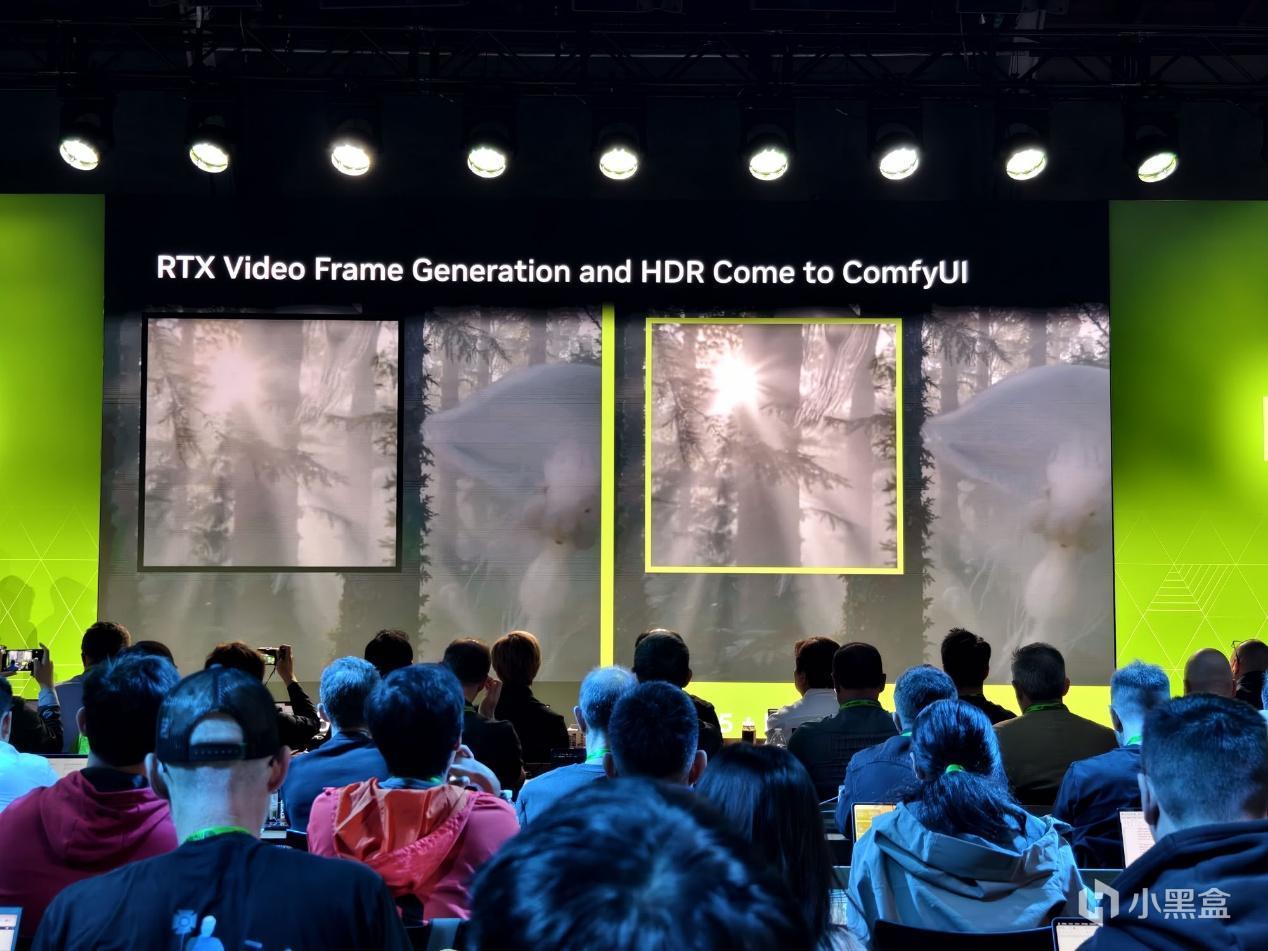
ComfyUI也已經宣佈支持RTX Spark和所有GeForce RTX平臺,原生內置視頻超分辨率與幀生成,支持1080p 30fps的攝像頭實時提升畫質與幀率,提供音棚音效 三種音色、離線文件處理器,以及基於MCP服務和Skill的智能體支持。
DLSS 4.5光線重建則已經引入Blender 5.3中,Cycles視口可以實現交互式路徑追蹤級預覽。NVIDIA強調,知道想做什麼和知道怎麼讓每個工具做是兩回事,智能體的價值是在用戶的專業知識斷檔處接上技術協助,只需要說一句“渲染出來、做真實些”,剩下的讓智能體自己去社區找ComfyUI管線並跑起來。
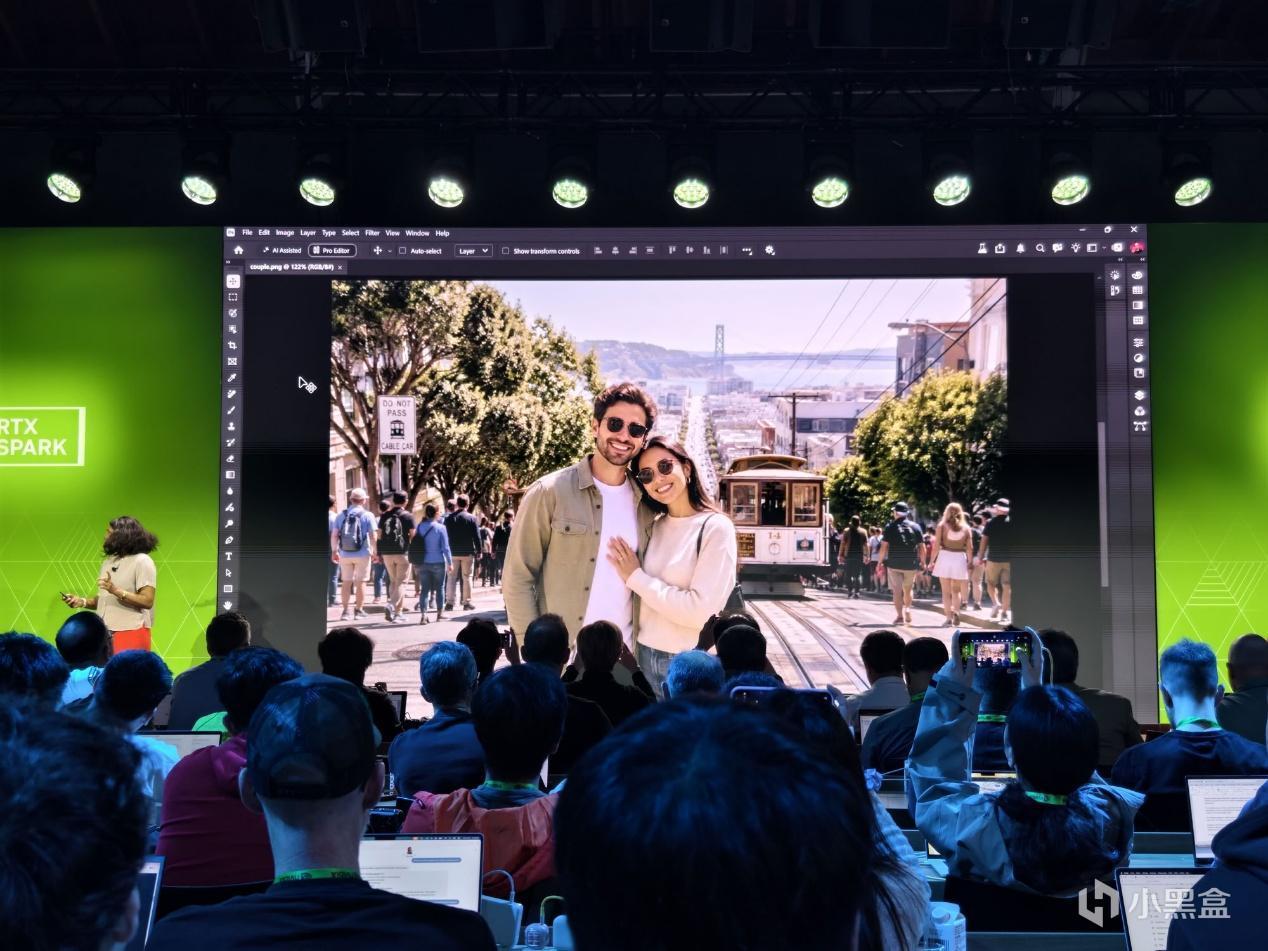
創作者被要求多模態的壓力也是前所未有的。幾乎每個項目都要混合圖像、視頻、音頻、動效和3D,AI正貫穿構思、創作、生產全流程,創作者掌舵眼光、品味和判斷,智能體則充當助手的角色。目前Adobe Photoshop、Premiere、Substance 3D已經針對RTX Spark優化,AI編輯特效最高2倍提速。
開發者部分亦是如此。NVIDIA表示開發者不再逐行手寫代碼,而是指揮寫代碼的智能體,單一開發者由此能掌控更復雜的平臺。目前全球大約有1,500萬開發者,但未來如果不用編程,只通過自然語言與AI 智能體完成軟件開發,這將是一個巨大的市場。
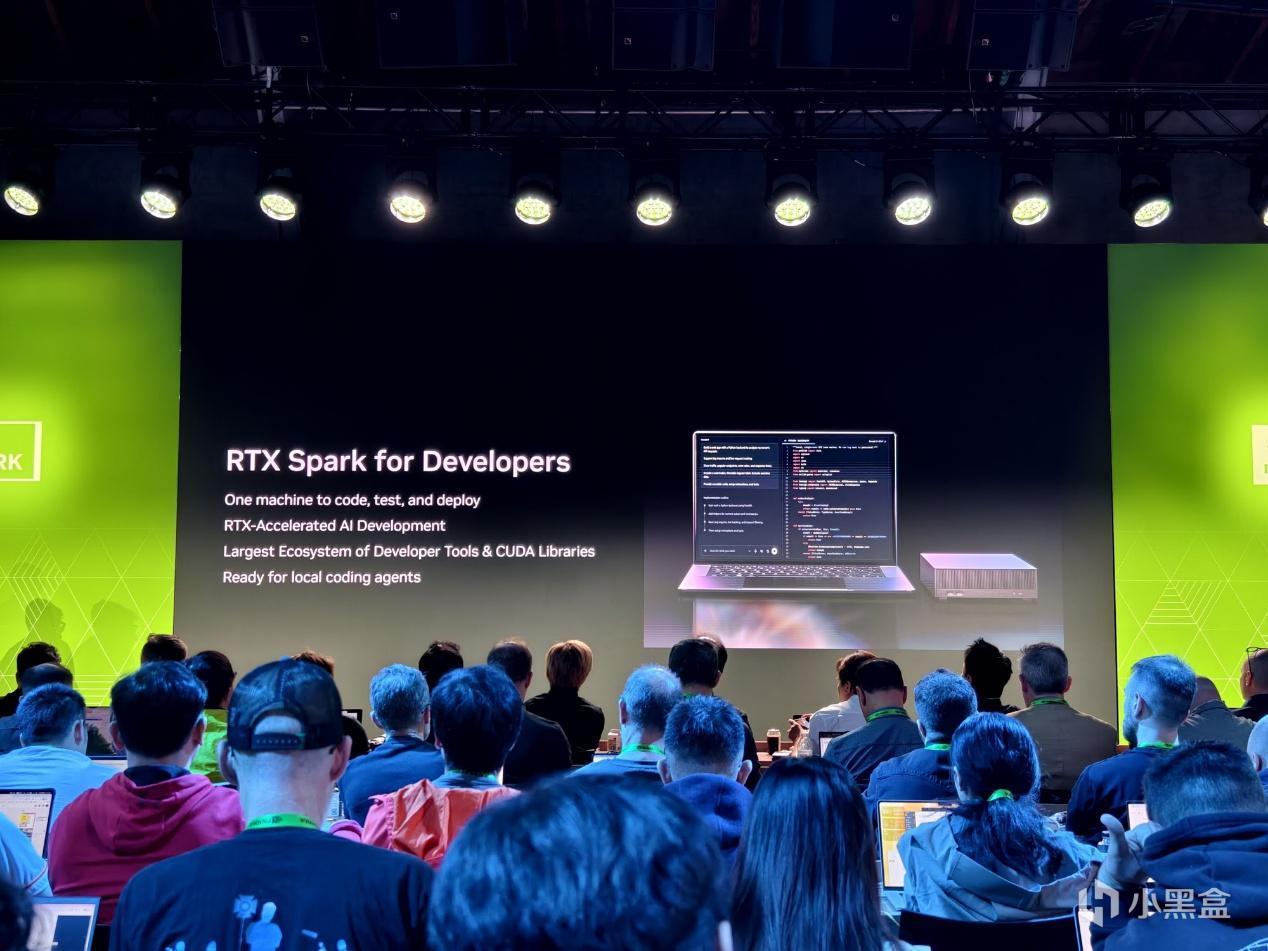
RTX Spark在其中承擔起完整的開發流程,編碼、測試、部署可以在同一臺機器上閉環。Windows開發者配置,外加WSL打通Linux框架與雲端發佈。並且在RTX Spark上驗證,等於直接面向超過1.5億RTX裝機量的目標平臺,沒有遷移門檻。
NVIDIA還與微軟合作把PyTorch生態搬上Arm,超過2000個Arm原生開發包已經完成適配。NVIDIA Agent Skills還爲所有CUDA庫製作技能包,讓智能體自己會調用CUDA生態,並內置進OpenClaw和Hermes,即使用戶完全不懂CUDA,智能體也能協助完成。這意味着庫的價值不再取決於人會學,而取決於智能體是否會用。
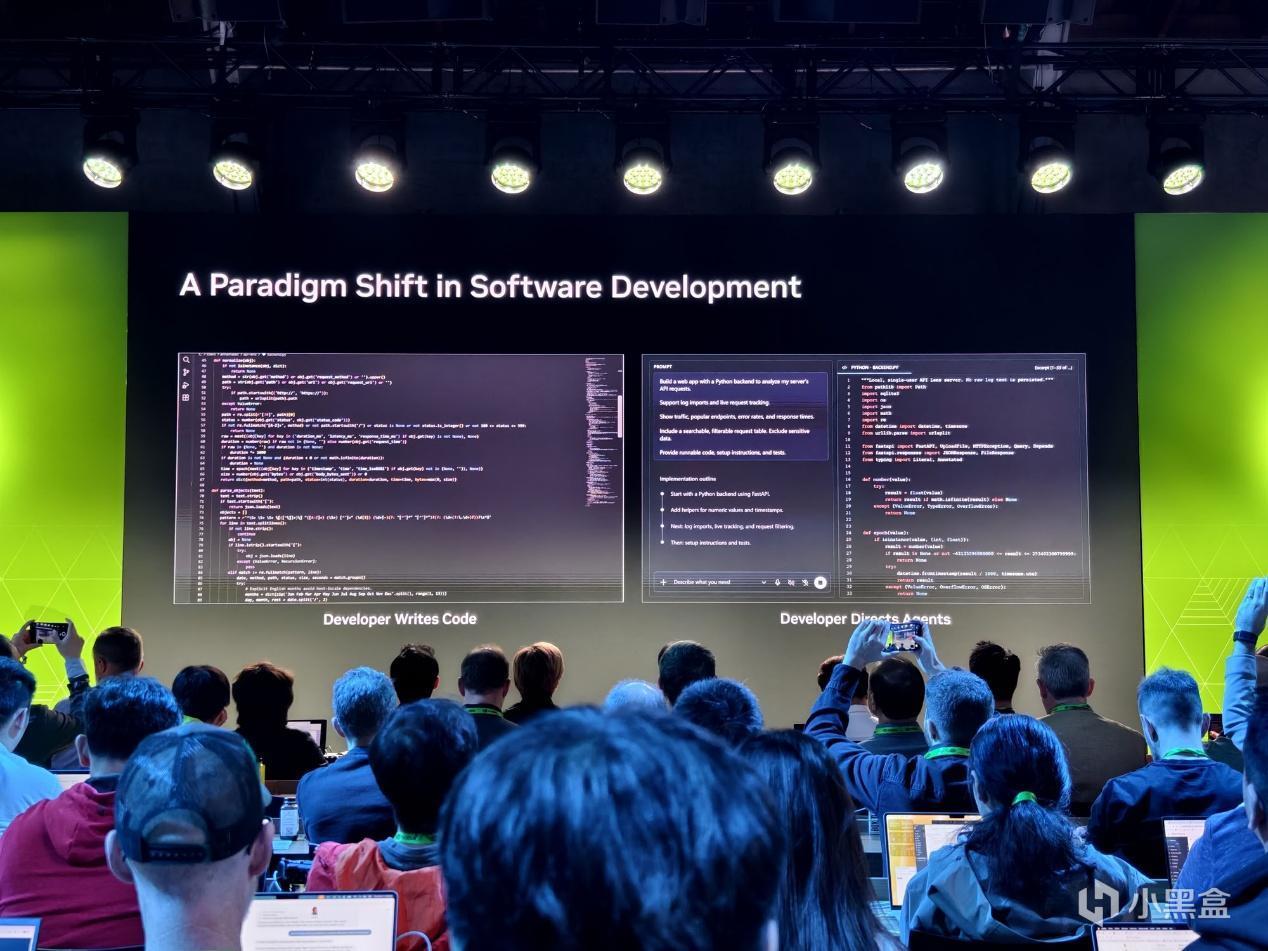
NVIDIA認爲未來將是目標導向編程(goal-oriented programming),開發者不下具體指令,只聲明目標,智能體自己跑完整個流程。只是這個過程的隱患在於你不知道智能體要跑多少輪,雲端按token計費時這就是賭博,本地免費運行成了更理想的解決方案。同時決策模型(Decision Models)可以快速做出下一步動作,從而避免長推理鏈才能得出的結論,從而加速開發進程。
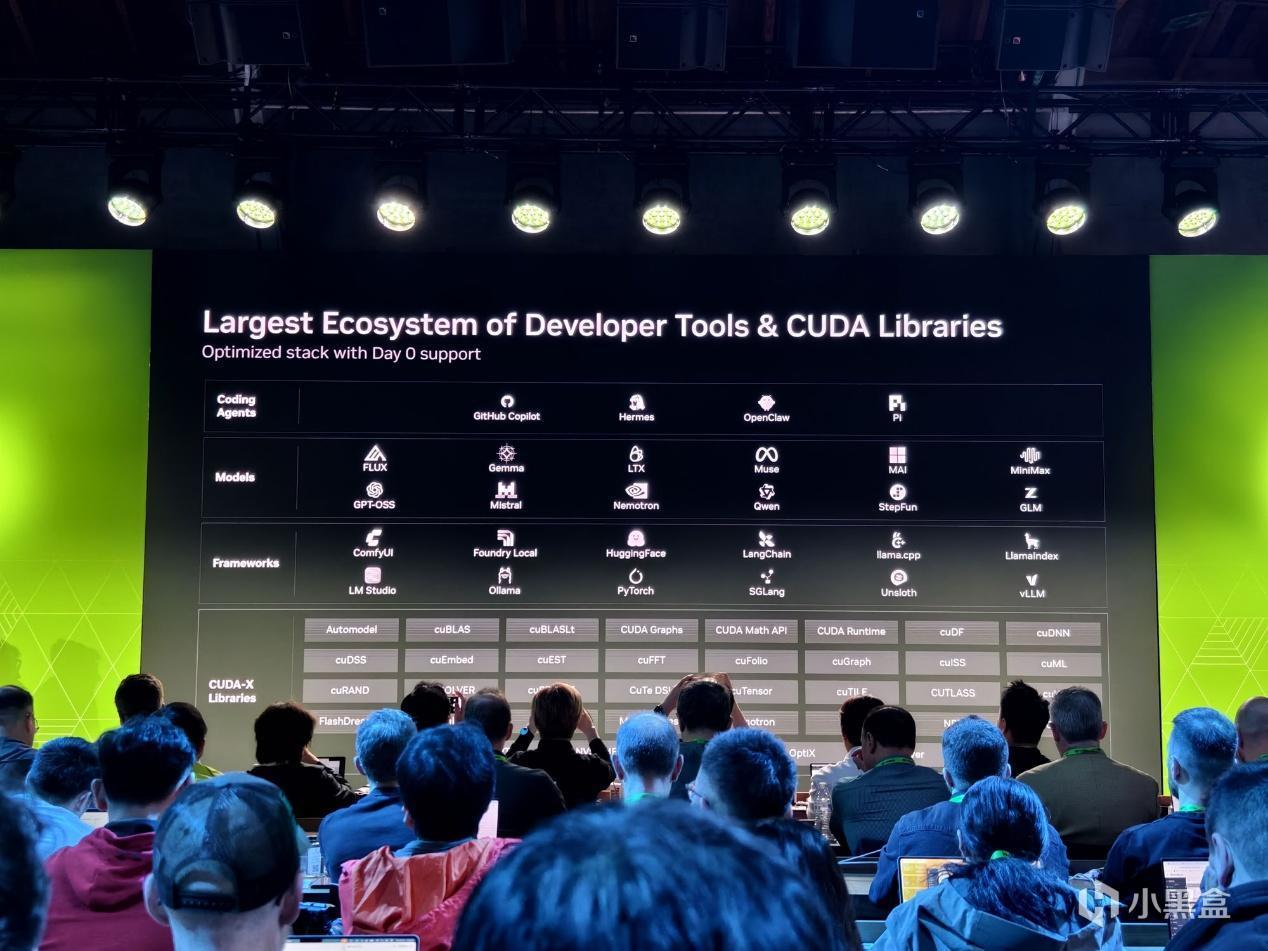
今年早些時候發佈的DGX Spark已經能夠很好的運行GLM-4.6 Flash級別的模型,今年底推出的DGX Station也將推出對Windows支持,這讓全球的Windows用戶和開發者可以藉此構建GB300級的前端智能應用。
RTX Spark遊戲
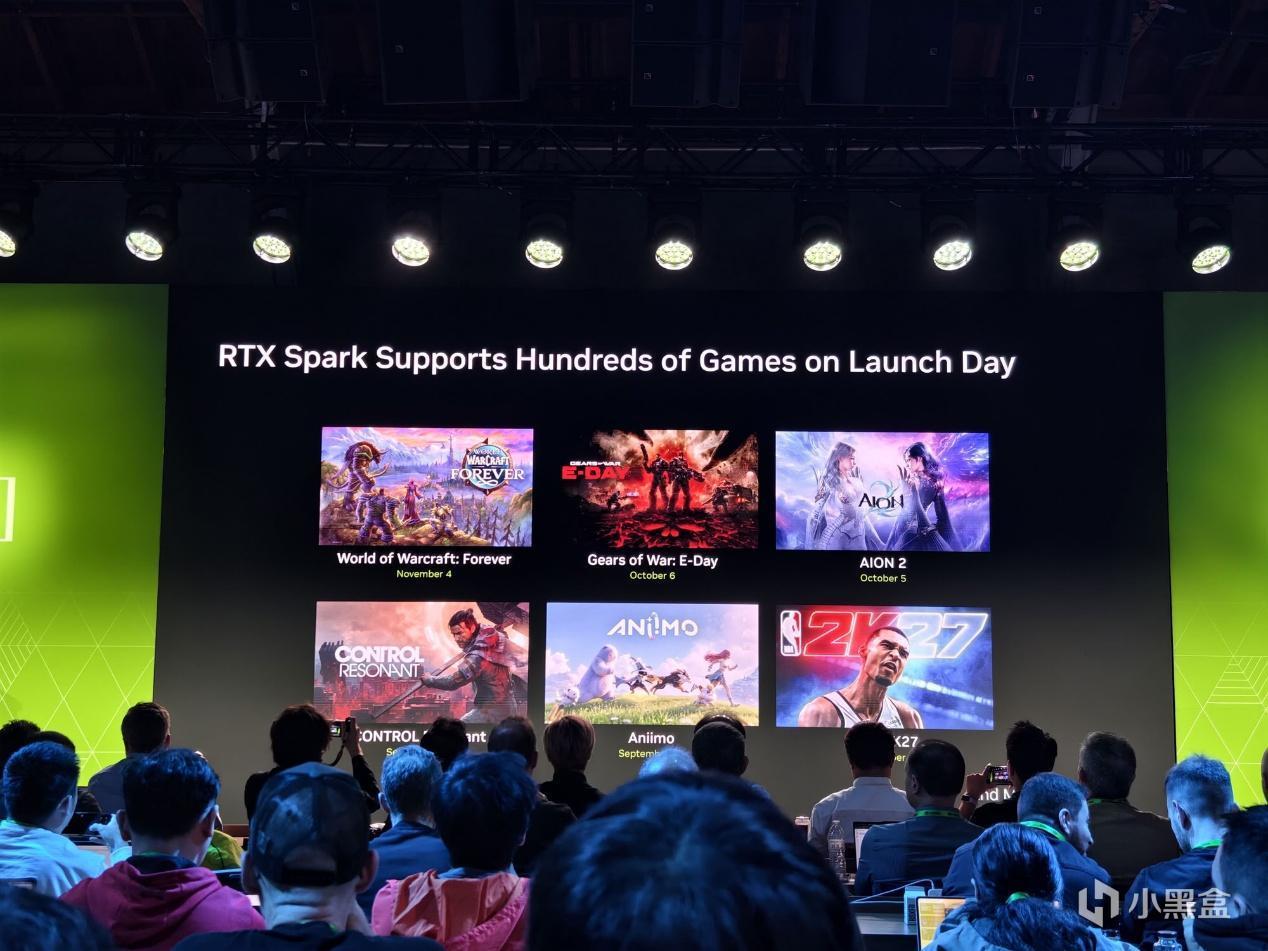
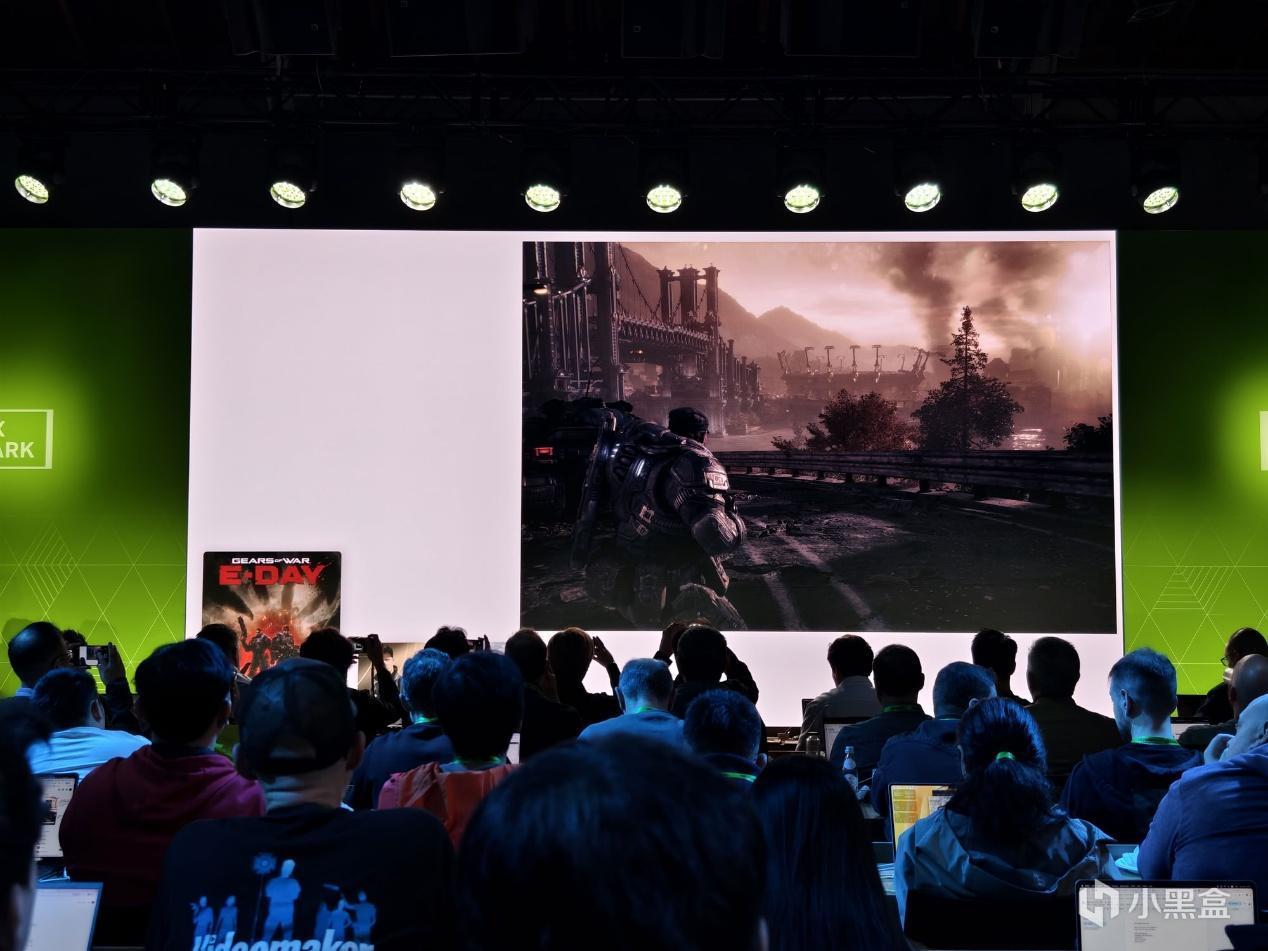
這是普通消費者最關心的部分,Windows on Arm已經開始打通Arm和x86的隔閡,接下來則越來越快。RTX Spark則可以承接2018年以來的RTX硬件血統,通過RT Core和Tensor Core搭配,以及遊戲工作室的適配,讓RTX Spark筆記本發佈首日就可以支持數百款遊戲,包括《戰爭機器:E-Day》《紀元117》《NBA 2K27》《控制:共振》。
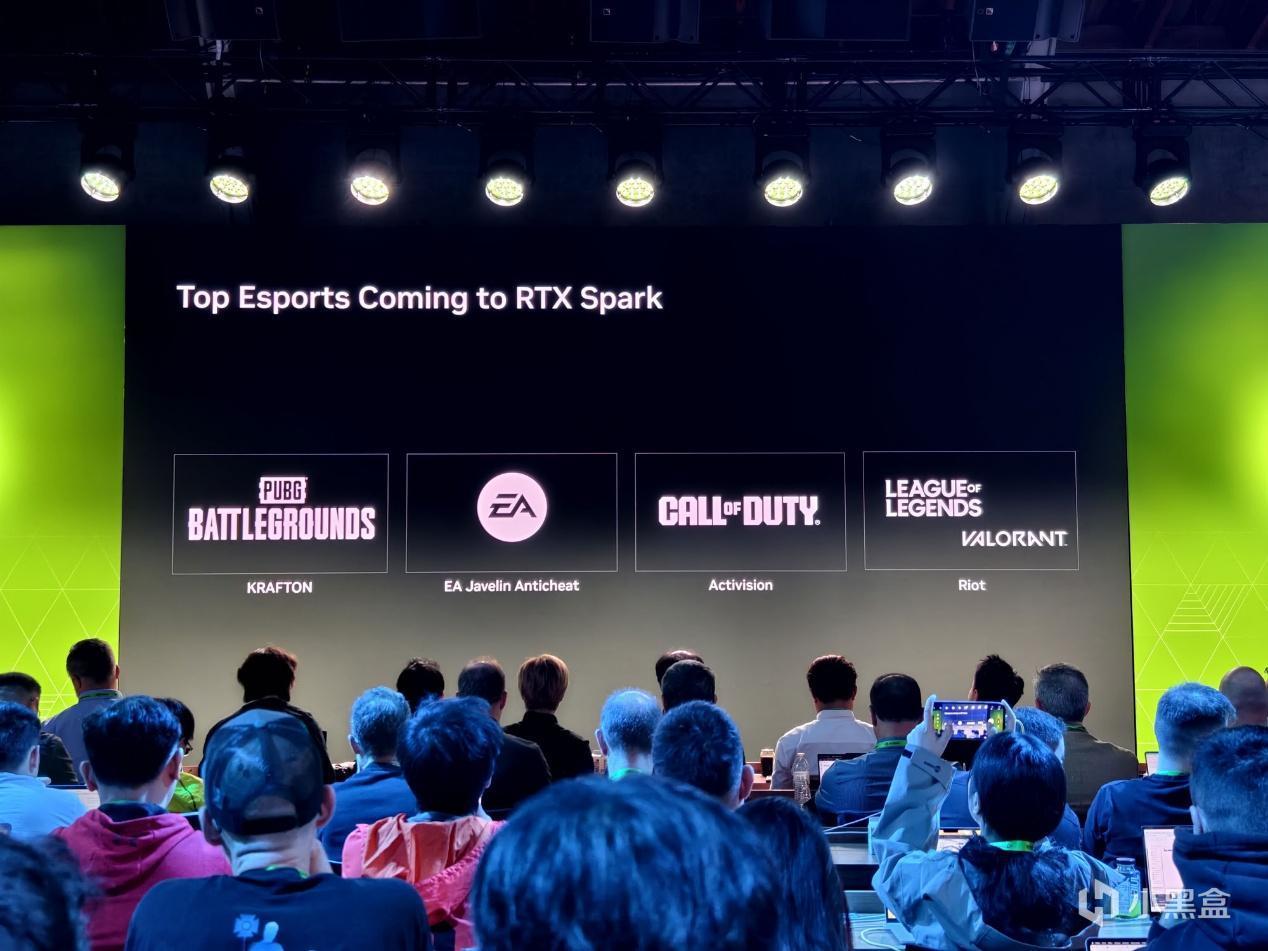
而讓更多玩家關心的內核級反作弊需要底層工程整合、硬件驗證與嚴格安全測試。NVIDIA 與微軟及頭部反作弊廠商完成了關鍵一步,目前已經能夠支持《堡壘之夜》《ARC Raiders》《漫威爭鋒》,在今年秋天《PUBG》《英雄聯盟》與《無畏契約》也將會落地。
微軟在其中也發揮了相當重要的作用,例如攻克內核級別反作弊,讓Arm設備也獲得信任。持續着色器投遞(Constant Shader Delivery),與Xbox團隊合作,將下載遊戲、啓動,着色器自動編譯並投遞到設備,這項推廣將會應用到RTX Spark及所有RTX GPU中。
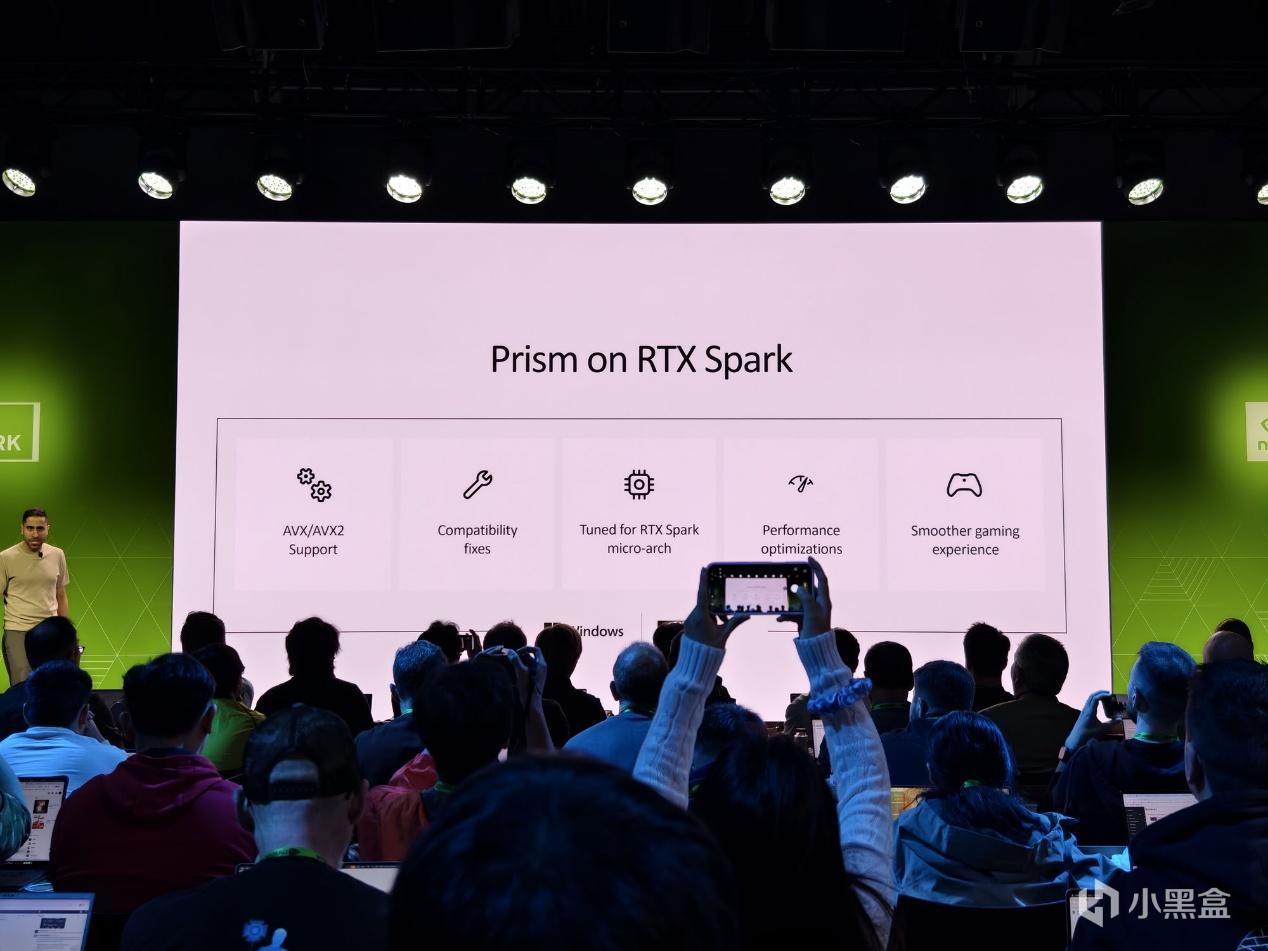
關於Arm所需要的Prism翻譯層,目前Windows上有數十年遊戲遺產要兼容。去年已爲CPU密集型應用補齊AVX/AVX2指令集模擬,並且每月推送兼容性和模擬器更新。微軟表示,翻譯將針對RTX Spark N1X微架構深度優化,特別是1% low幀率優化和平均幀率優化,爲遊戲體驗一致性提供保障。首發的陣容包括《戰爭機器:事變日》《007初露鋒芒》《天國:拯救 2》。
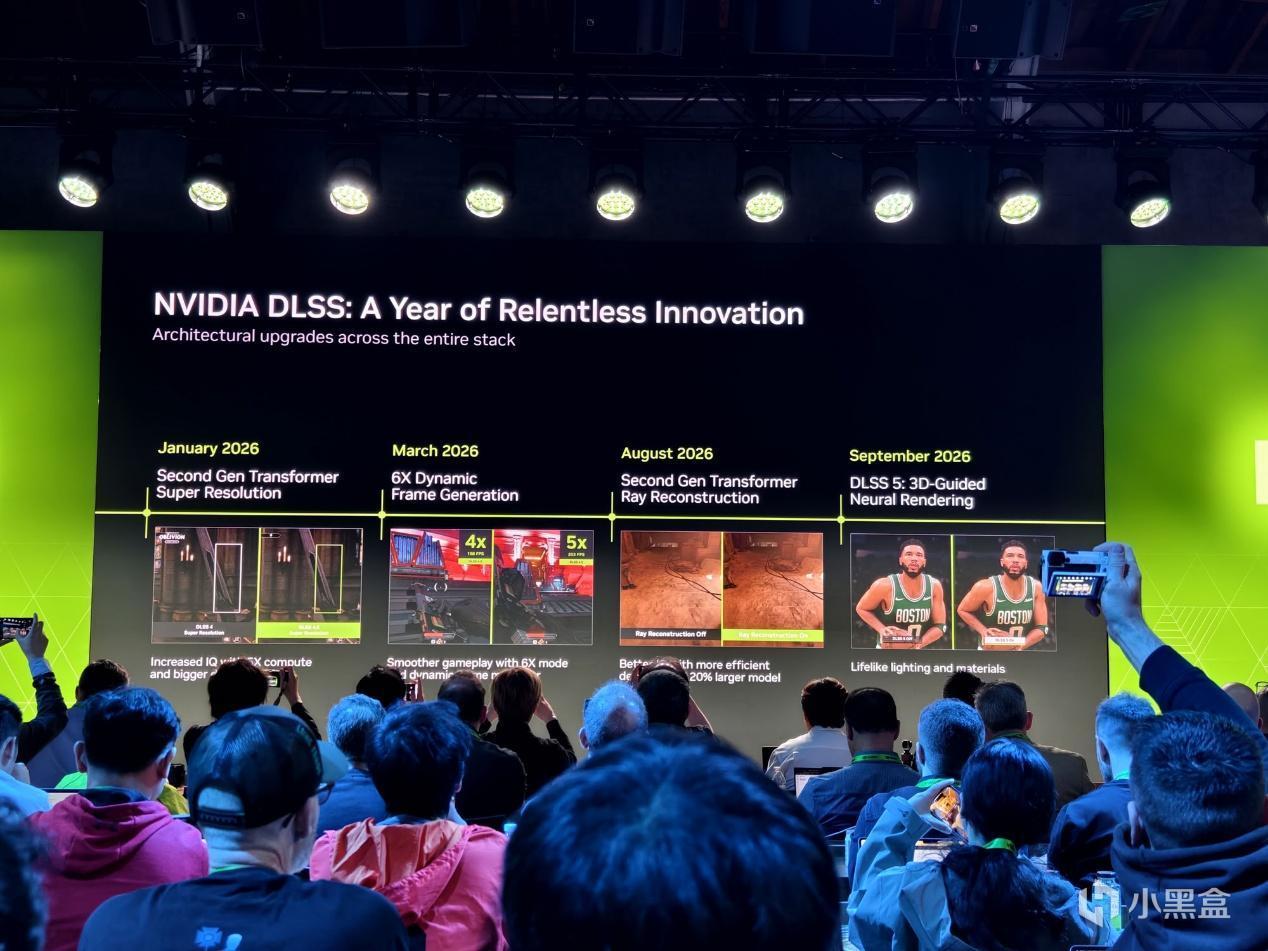
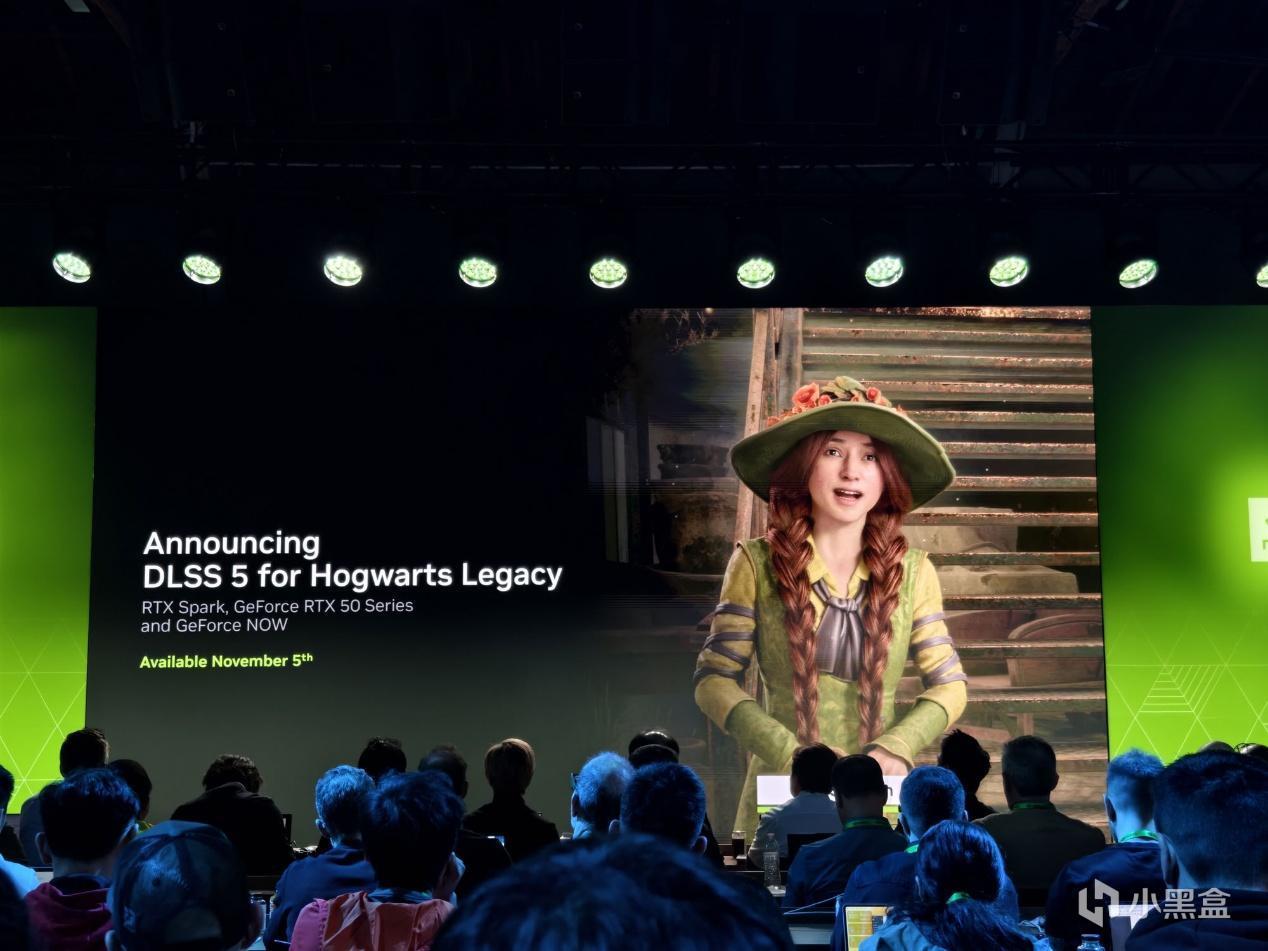
RTX Spark在支持DLSS 4.5的同時,也完成對DLSS 5的匹配,Transformer模型速度提升2倍,幀生成性能模式提速33%。另外《霍格沃茨之遺》《原神》都將在近期完成對DLSS 5的支持。
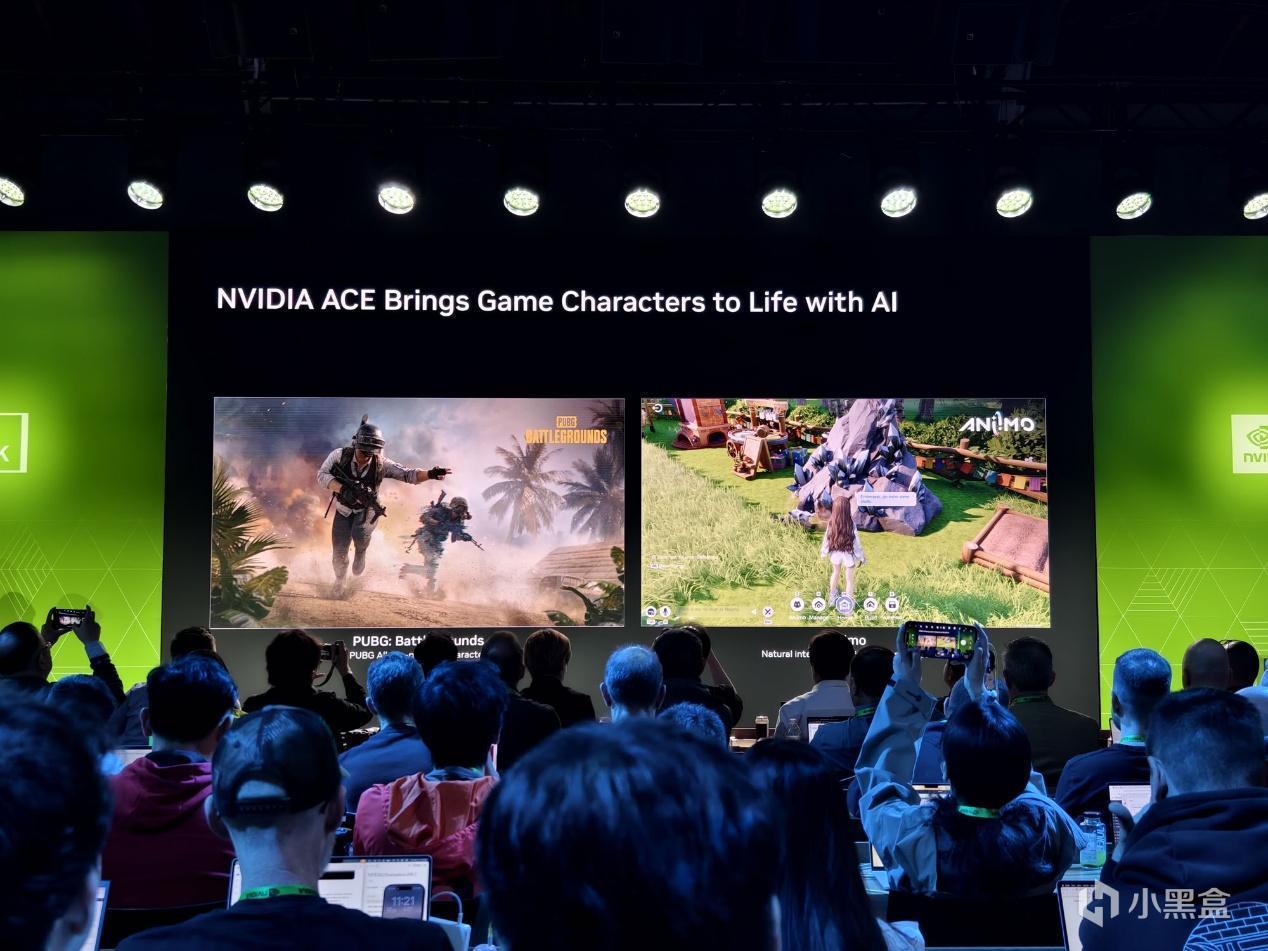
遊戲智能體也是RTX Spark的另一個應用方向。AI隊友PUBG Ally在今年夏天已經公測,通過自然語音交互就能幫助新玩家完成喫雞。第二代Nemotron模型則應用在寵物和基地經營類遊戲中,而第三代小語言模型Nemotron 3.5 Nano專爲更聰明、更快的AI角色打造,對話式智能體任務準確率提升1.5倍,支持可調的對話推理模式,開發者在精度與性能間自己權衡。模型基於Google Gemma構建,訓練配方開放,開發者可用自有數據針對遊戲內容微調,10月23日經Ollama、Unsloth、llama.cpp等渠道發佈。
另外MOD社區也誕生了兩條MOD生態,通過實時AI把原本遊戲中的NPC火起來,另一個則是通過AI編碼智能體讓老遊戲獲得RTX兼容,這也是過去一年中RTX兼容項目翻倍的原因。
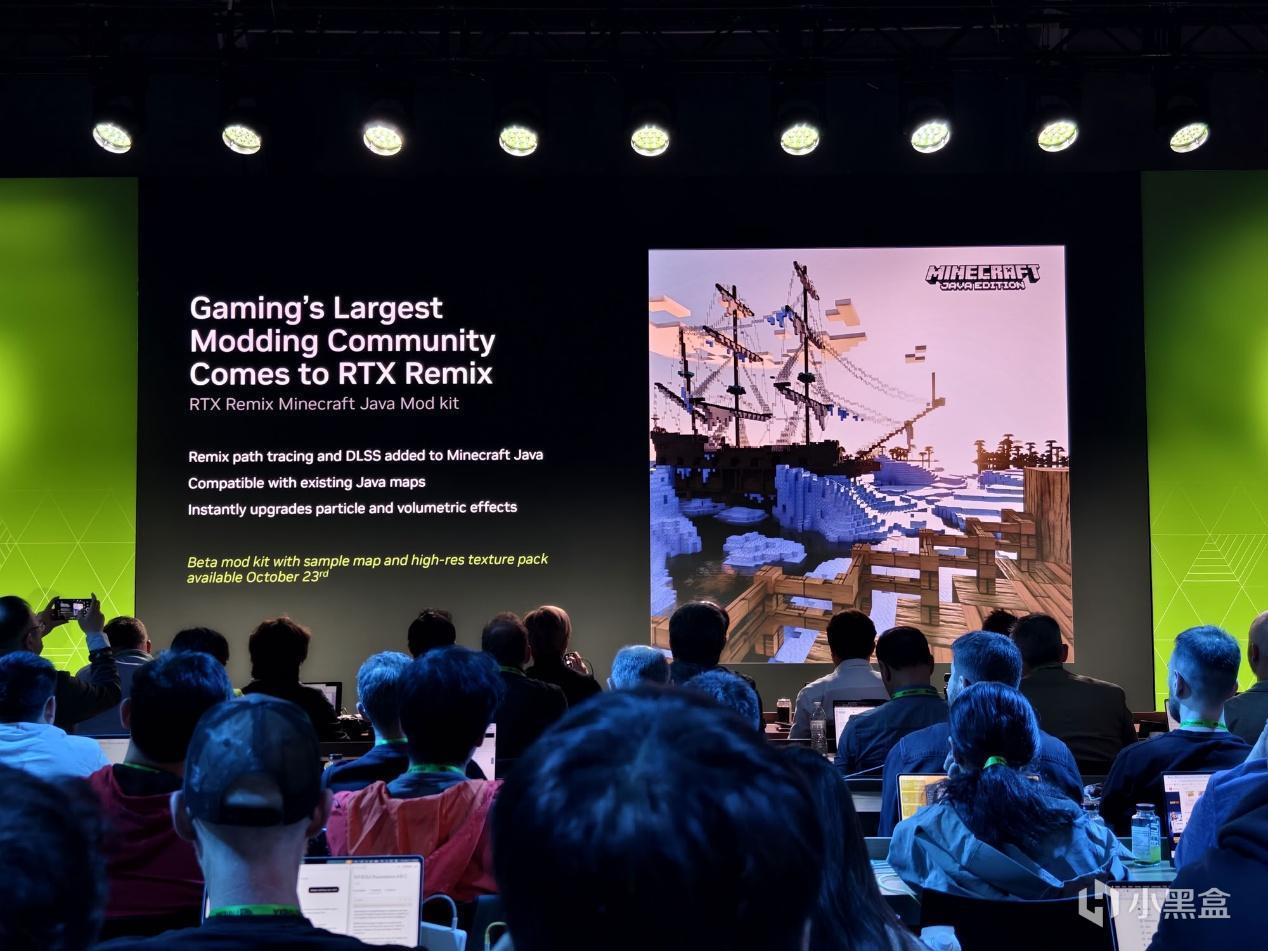
在活動現場還展示了《我的世界》Java版Mod Kit和《我的世界》DLSS 5,Java版Mod Kit AI智能體可加速mod開發,兼容存量Java mod,並讓mod獲得路徑追蹤與DLSS升級。《我的世界》DLSS 5實驗版本已經在9月份開始測試,在10月23日將會全量推出。
Windows AI 智能體架構與混合智能
RTX Spark筆記本的推動少不了Windows支持,事實上微軟也希望通過這一步提升Windows on Arm對行業的影響力。
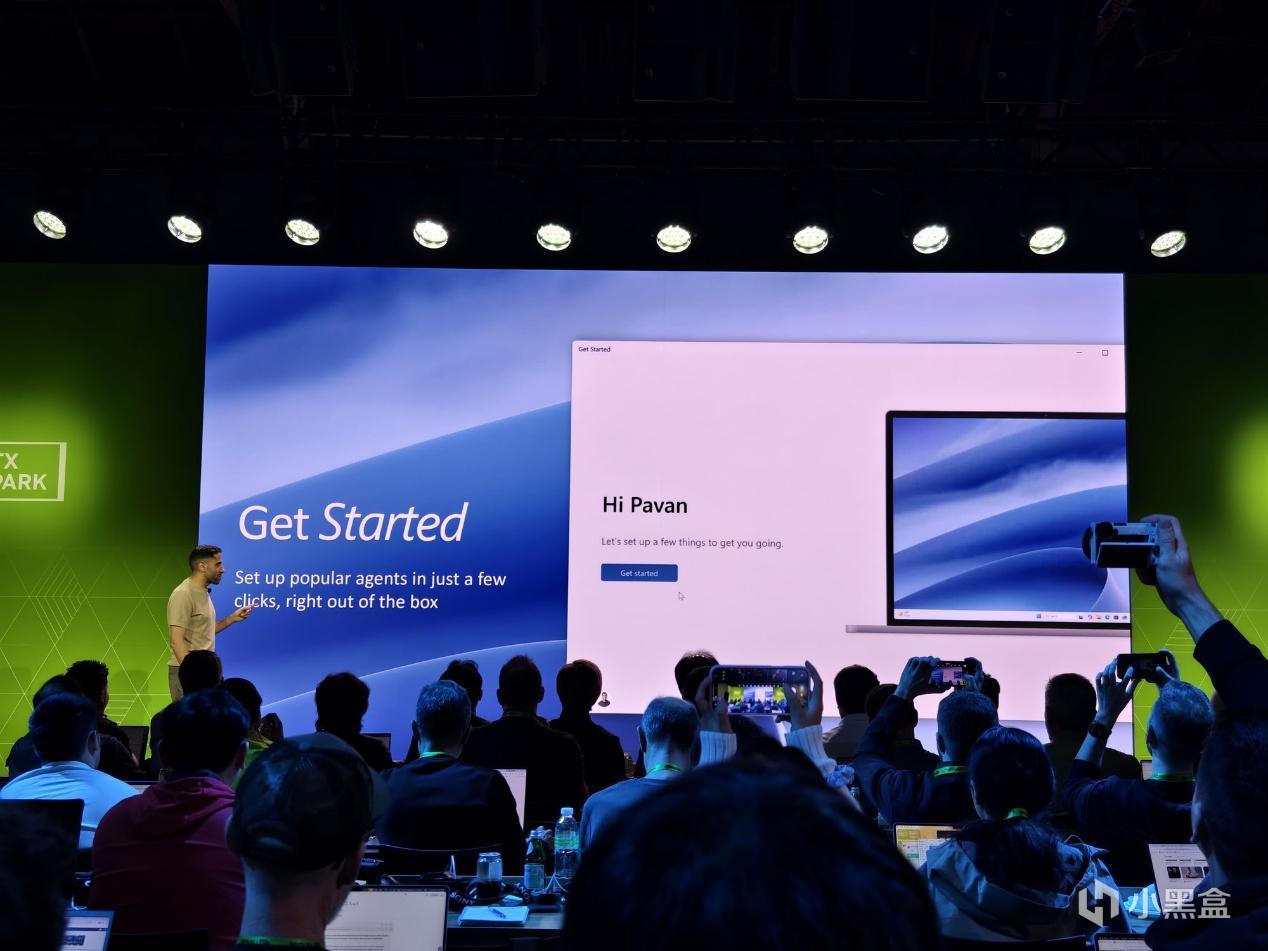
首先改變的是極簡單的智能體開箱體驗。通過Windows首次登錄時候的彈窗入門引導,智能體安裝到啓動只需要2次點擊即可完成。微軟表示智能體納入Windows管理,裝好的智能體像系統組件一樣被Windows託管——安全更新、功能更新自動下發,用戶不用自己惦記着升級。如前面所言,Hermes、Perplexity、OpenClaw已經在默認的支持列表中。國內WorkBuddy也很快成爲選擇之一。
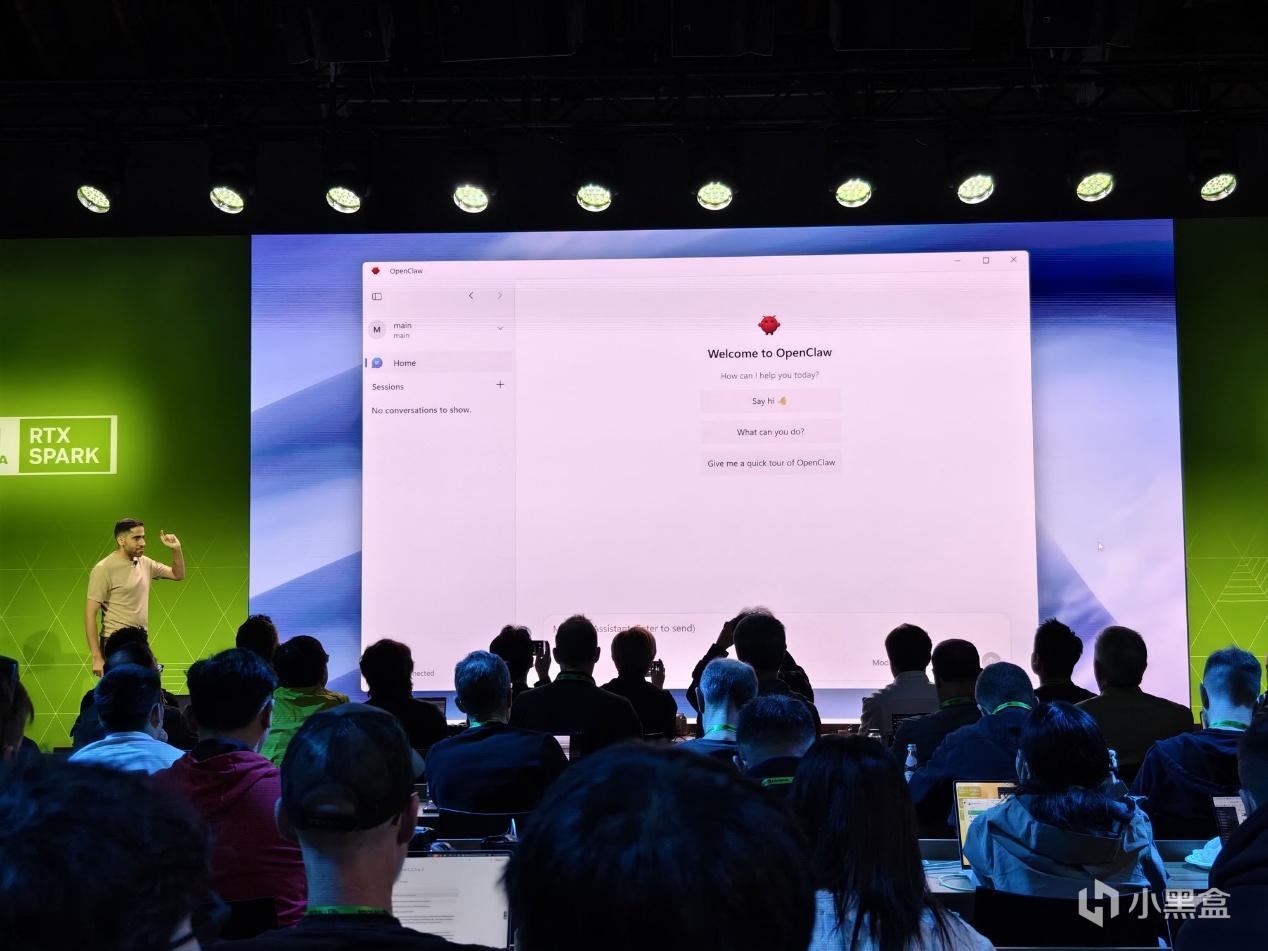
智能體的入駐,也改變了Windows的安全結構。微軟MXC的做法是對智能體做出隔離,把每個智能體放進獨立容器,用戶精細定義它能碰什麼。第二個就是給智能體另一個用戶的身份,會話級隔離讓智能體拿到自己的身份和憑證,而不是借用用戶的,從而進行更好的控制。第三個則是IT部門對智能體的規模化策略管理,爲接下來的企業部署鋪路。
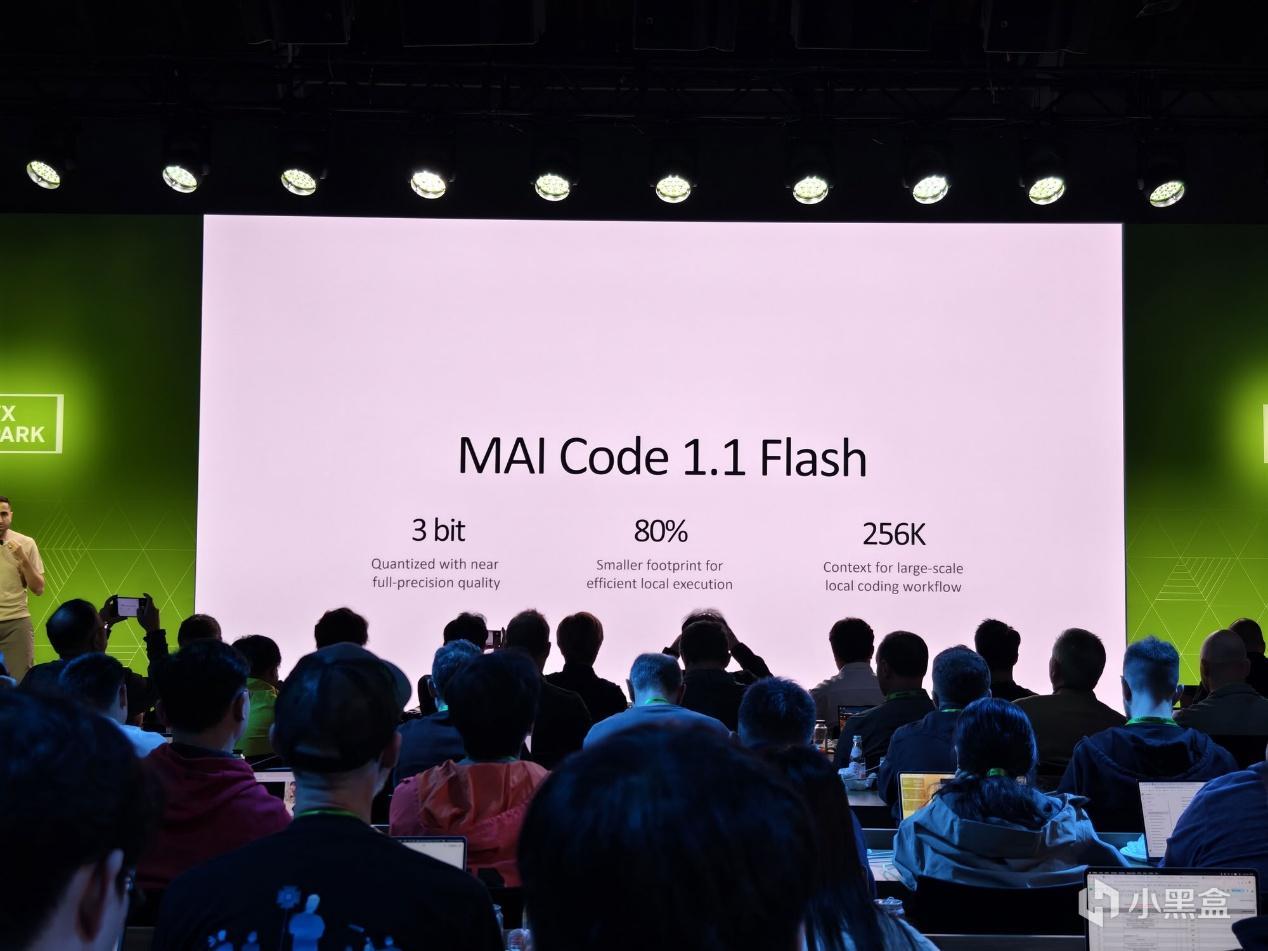
同時Windows採用混合智能(Hybrid Intelligence)與Copilot自動編排策略,系統根據任務複雜度與設備上可用模型動態決定推理發生在本地還是雲端。微軟還推出了MAI-Code-1.1-Flash本地版,這是微軟自研的137B參數編程模型推出3-bit量化模型,體積比雲端版小約80%,保留超長上下文,專爲編碼與複雜任務本地運行準備。
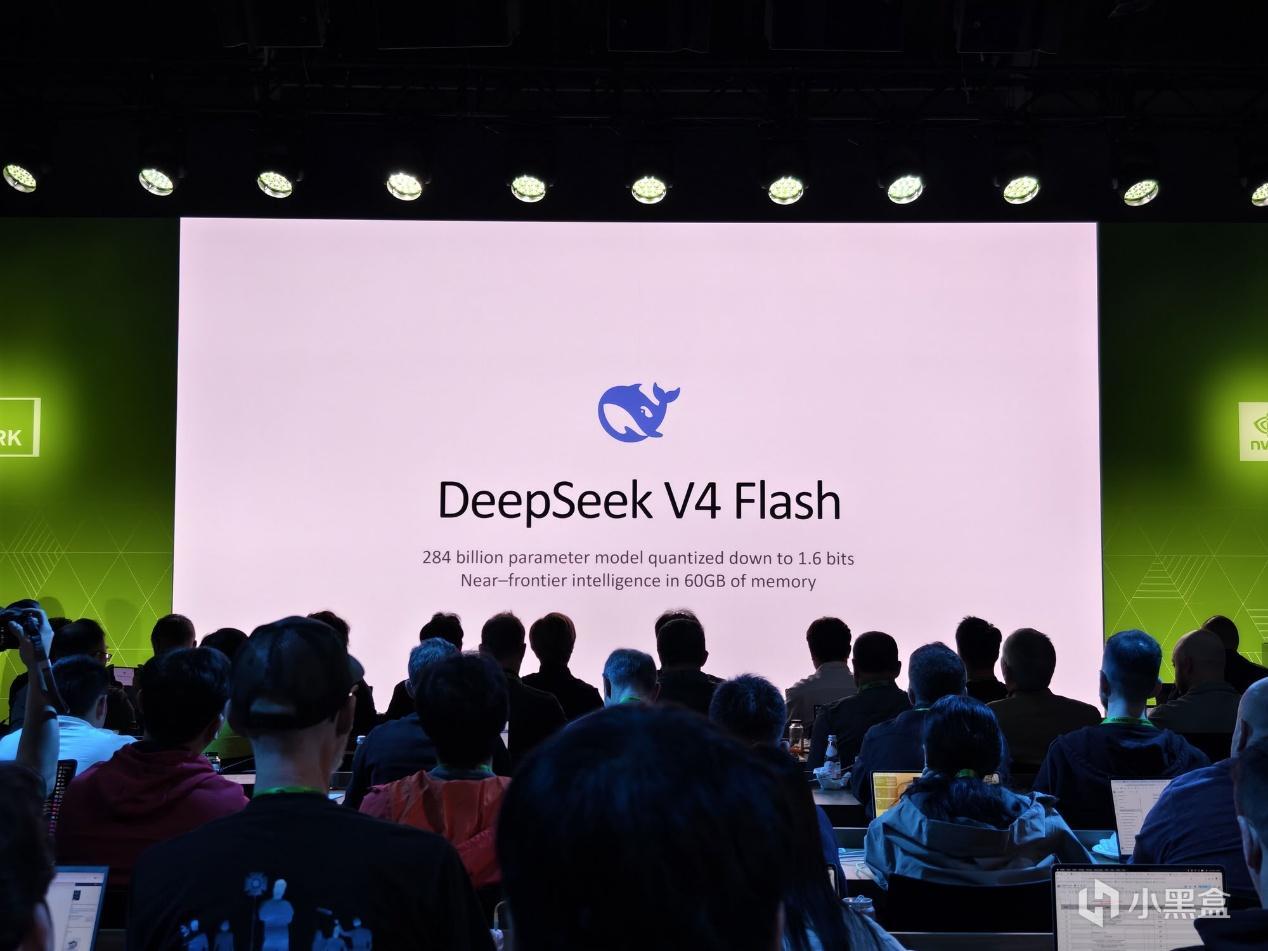
另外微軟也嘗試把DeepSeek V4 Flash 2,840億參數的前沿模型量化到約1.6 bit,跑在RTX Spark上,讓RTX Spark筆記本也存在一定的能力表現。
在平臺層面,llama.cpp已經獲得Windows ML支持,用戶喜歡的開源模型可以通過llama.cpp在Windows ML上運行。
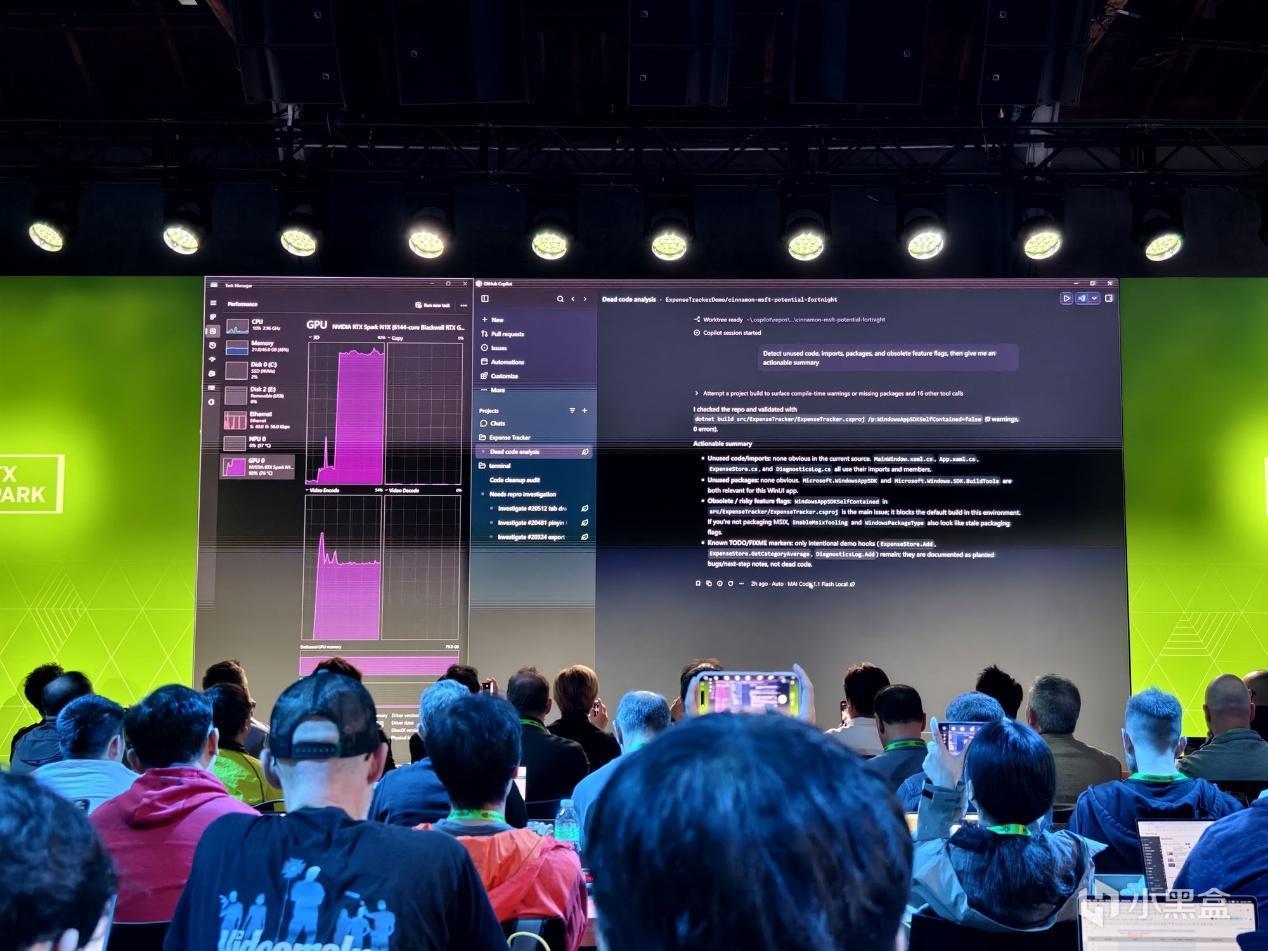
Windows搜索功能也獲得了更新,首次引入動作搜索(action search),用自然語言直接執行操作,比如移動任務欄、切換深色主題,或者以Xbox模式啓動遊戲。搜索欄和任務欄將成爲用戶發起任何操作的入口。
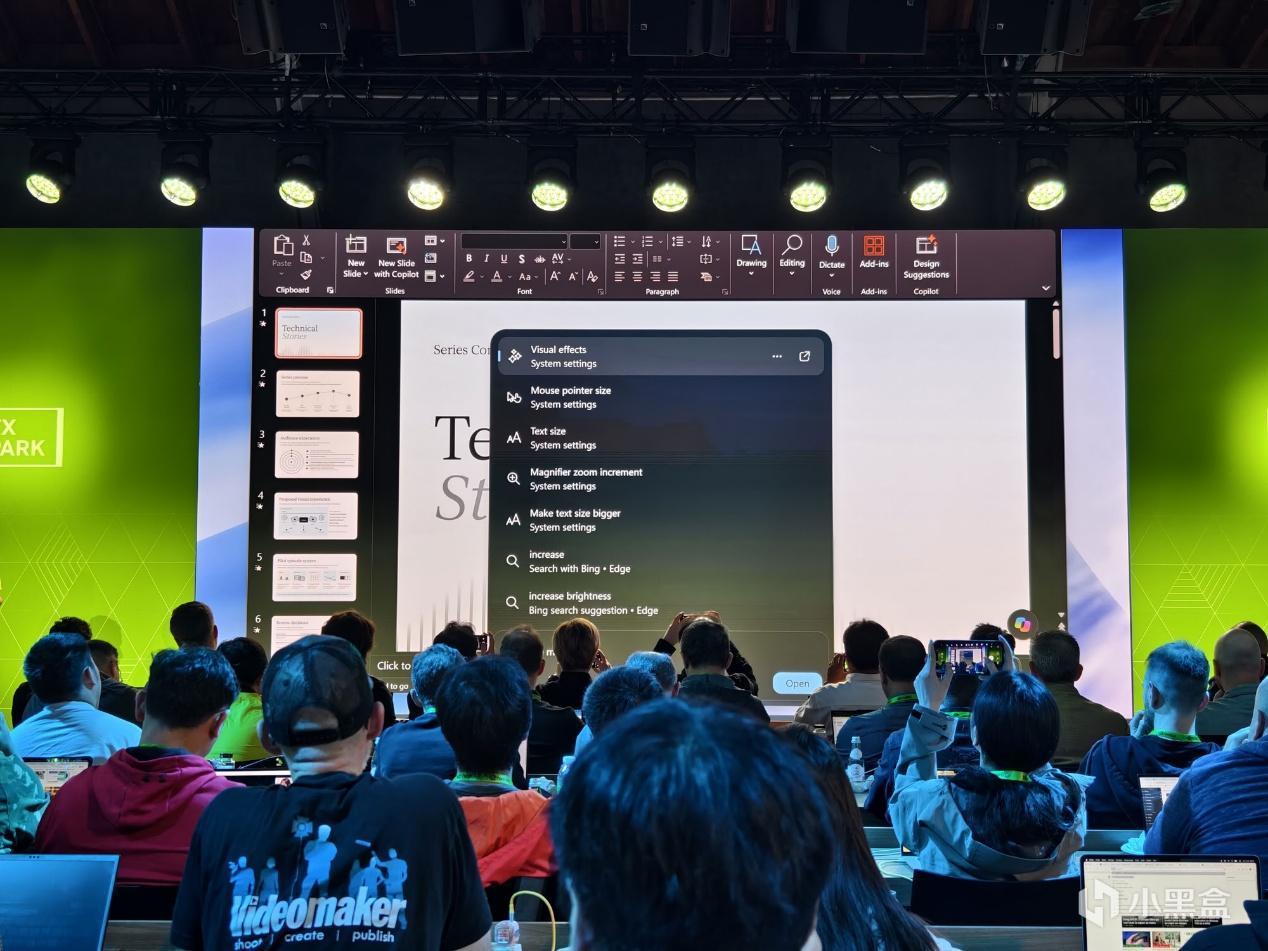
爲了讓RTX Spark的128GB統一內存塞入更大的模型,微軟做了許多工作,同時刻意保留一部分空間給系統和應用,確保持續流暢不卡死,內存常駐策略針對不同加速器分別優化。在過去一年中,Windows on Arm的電源、性能、續航、模擬器的全面優化打磨,所有的改進都會在RTX Spark筆記本出貨時付諸實踐,包括WPS調度、MPTF電源熱框架、GPU可訪問內存上限提升、DX12神經網絡渲染等條目。
寫在最後
回到最初的問題:RTX Spark筆記本到底是一臺什麼樣的PC?
硬件上,RTX Spark是NVIDIA把數據中心級Blackwell架構塞進45–80W功耗筆記本的一次工程秀。但真正讓這臺機器成立的,是軟硬件的組合拳。Windows on Arm爲智能體重寫了隔離與身份機制,Blender、Adobe、DaVinci等創意工具鏈已經完成了原生遷移。而NVIDIA獨門祕籍DLSS 4.5和DLSS 5、Reflex、路徑追蹤硬件天然就對遊戲提供了很好的適配。
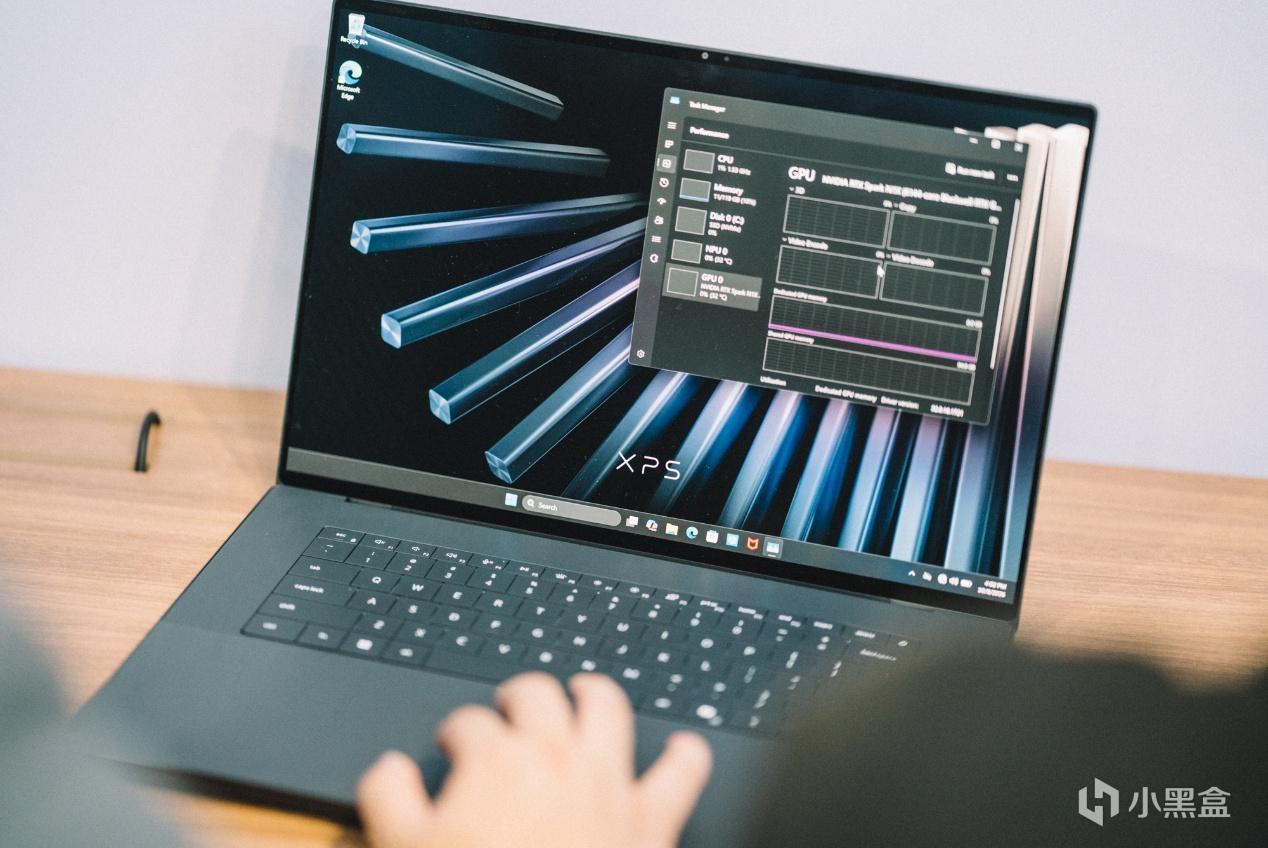
不僅如此,128GB統一內存做到了大多數桌面顯卡也辦不到的AI應用擴展,而Switchyard與PAIR則把視野伸向了更遠的地方,讓家裏的每一臺設備都成爲個人AI的算力來源。
當然,超過1.5萬元的起售價意味着它註定不是大衆產品,但這樣的嘗試非常值得,這也是近十年來PC新品少有的能給筆者帶來莫名的興奮感。完全有理由期待RTX Spark筆記本以及其終端設備對移動娛樂、遊戲、創作和AI生態帶來的變化,正如Spark“星星之火”的寓意那般,點燃下一場PC行業的變革。
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com