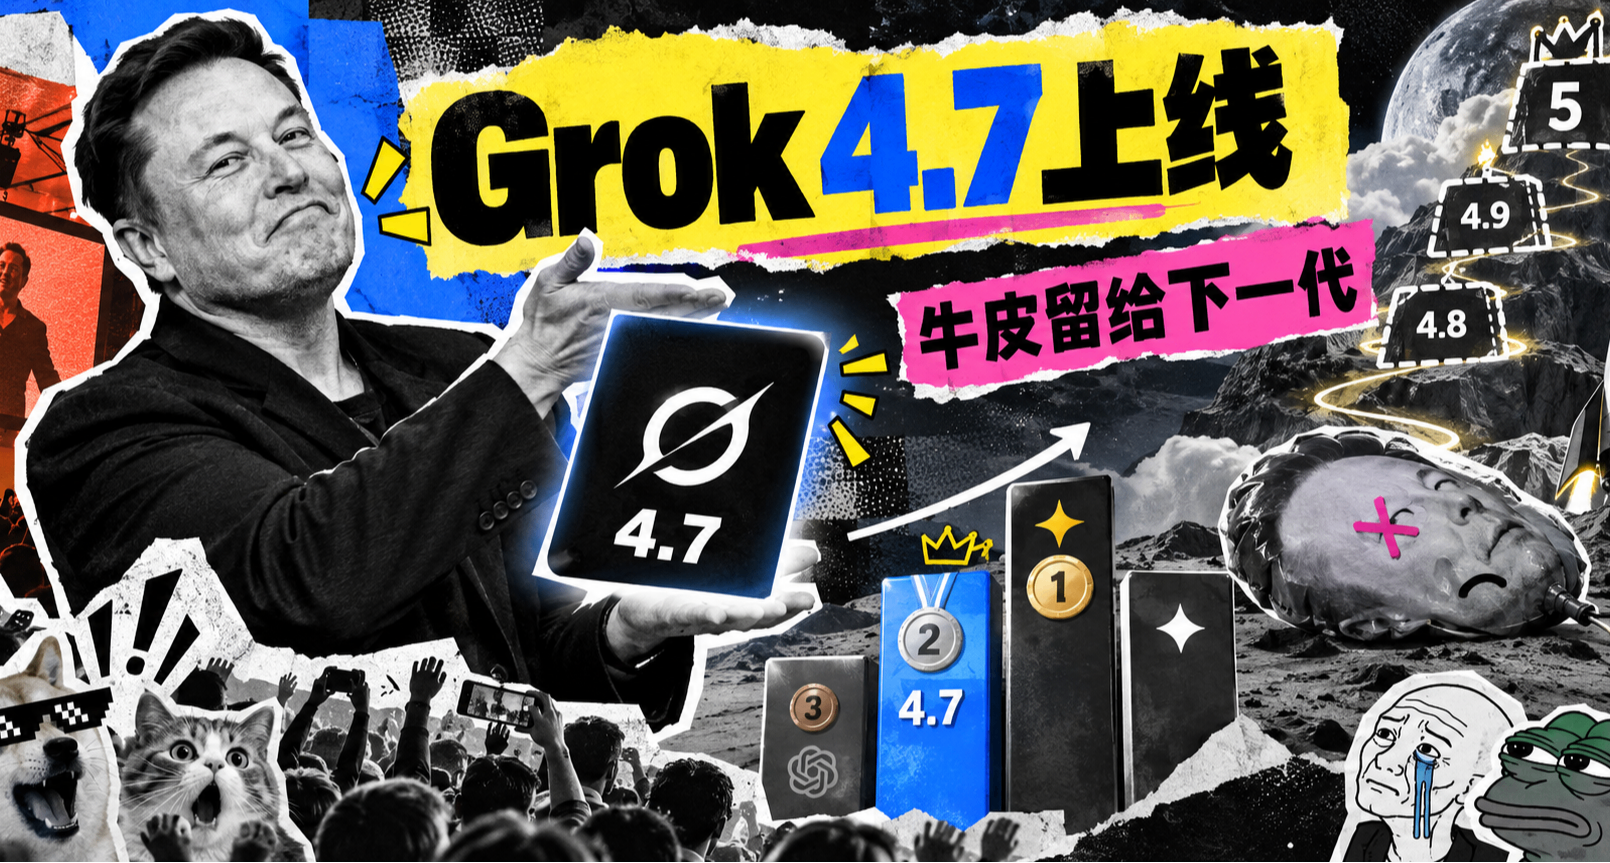
9月21日,Grok 4.7终于上线了。
看完这次升级,社区反响平平,我觉得它有点冤,,,能力涨了,价格没动,长任务有进步——
偏偏,老板提前把话说满了(发布时间吹牛、能力吹牛)。
还是先说模型:这次API标准价和4.6一模一样,每百万token输入2美元、输出6美元,提示词达到20万token后翻倍。按我的感受,这个性价比,仍然挺能打。
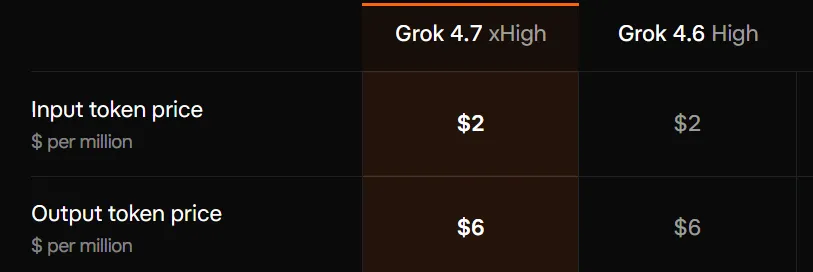
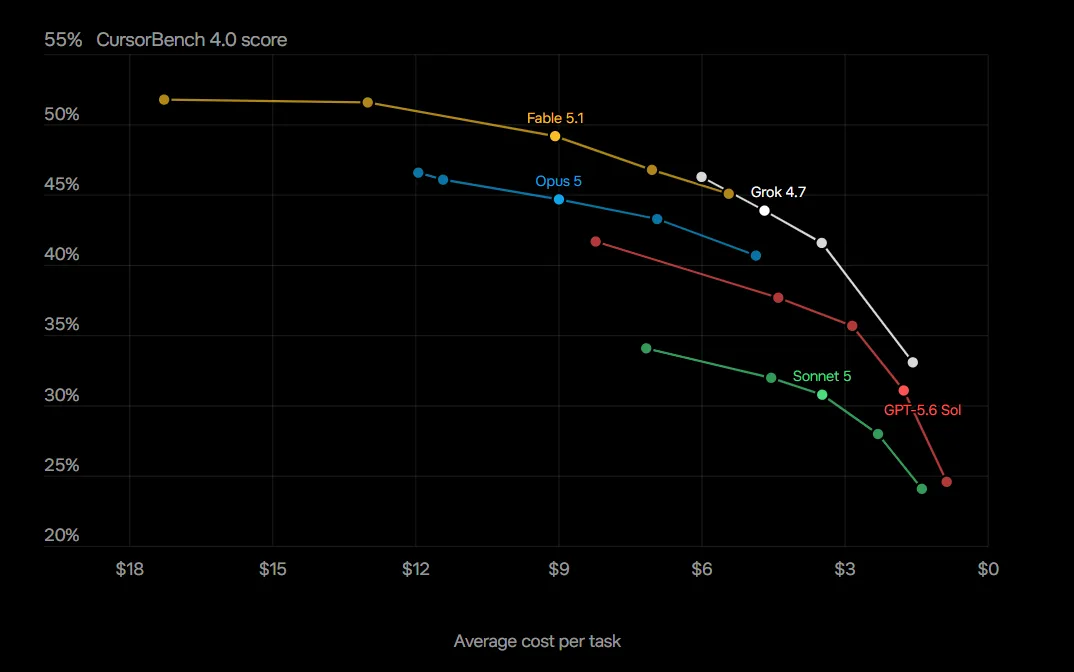
官方测的Terminal-Bench 4.0,从20.3%涨到38%;Cursor编程测试,从40.4%涨到46.3%,反复改代码、检查结果的长活,相比之前确实更能打了一些,但官方放出的张表用4.7的xhigh档对比4.6的high档。。
独立机构Artificial Analysis(但存在充钱加分的情况),在综合智力测试中测到,4.7的xhigh档每题平均输出8.1万token,4.6同档约3.8万,单价没涨,平均用量翻了倍还多,这点各位在使用的时候也得注意。
我们自己实际使用发现消耗量也上去了
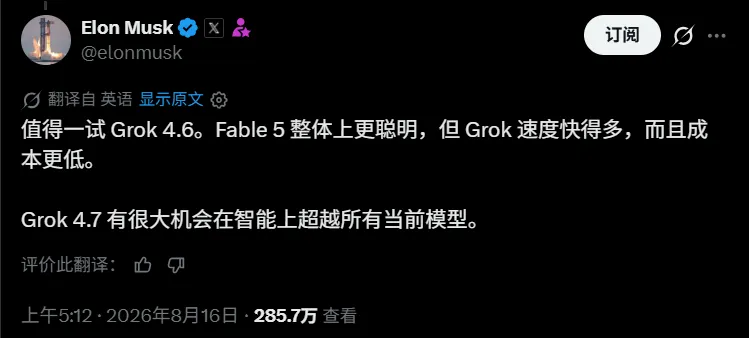
我们再来聊聊这次的老马,众所周知,马斯克一向是喜欢吹牛皮的,8月12日,他在X上说,Grok 4.7 will exceed all current models。
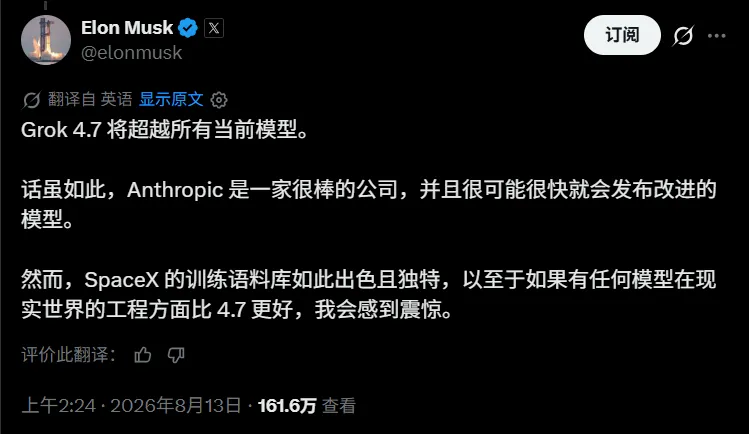
超过当下所有模型(倒也没吹太离谱)。
结果,我们都知道了,一个月后,GPT出了Astra,A\出了Fable5.1,。
但发布时的成绩,确实撑不起那股横扫全场的气势——Grok4.7显然是没打过Fable5和Sol。
AA综合智力给4.7打了46分,Fable 5.1和GPT-6 Astra都是53分,编程agent按各家原生工具环境测。
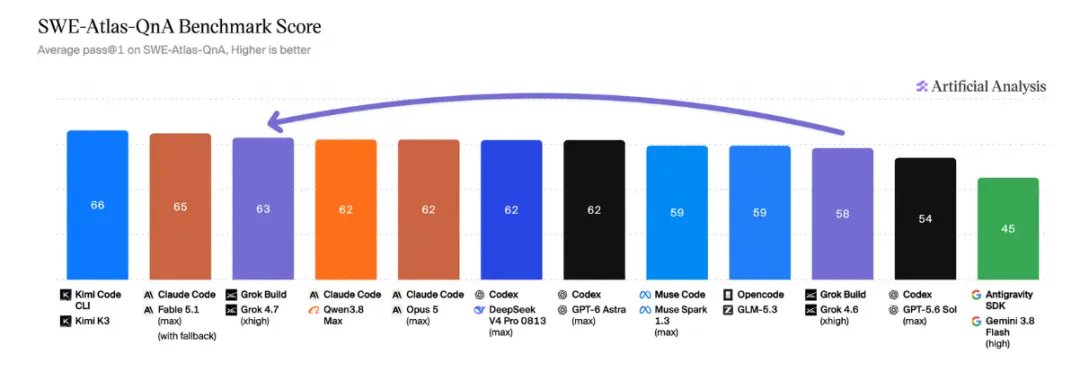
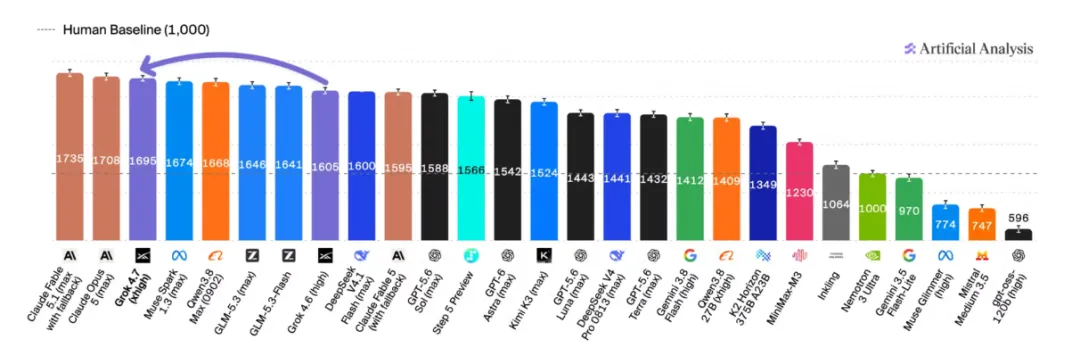
甚至官方自己的表上,Fable的Cursor成绩是51.8%,多小时终端任务是57.9%。
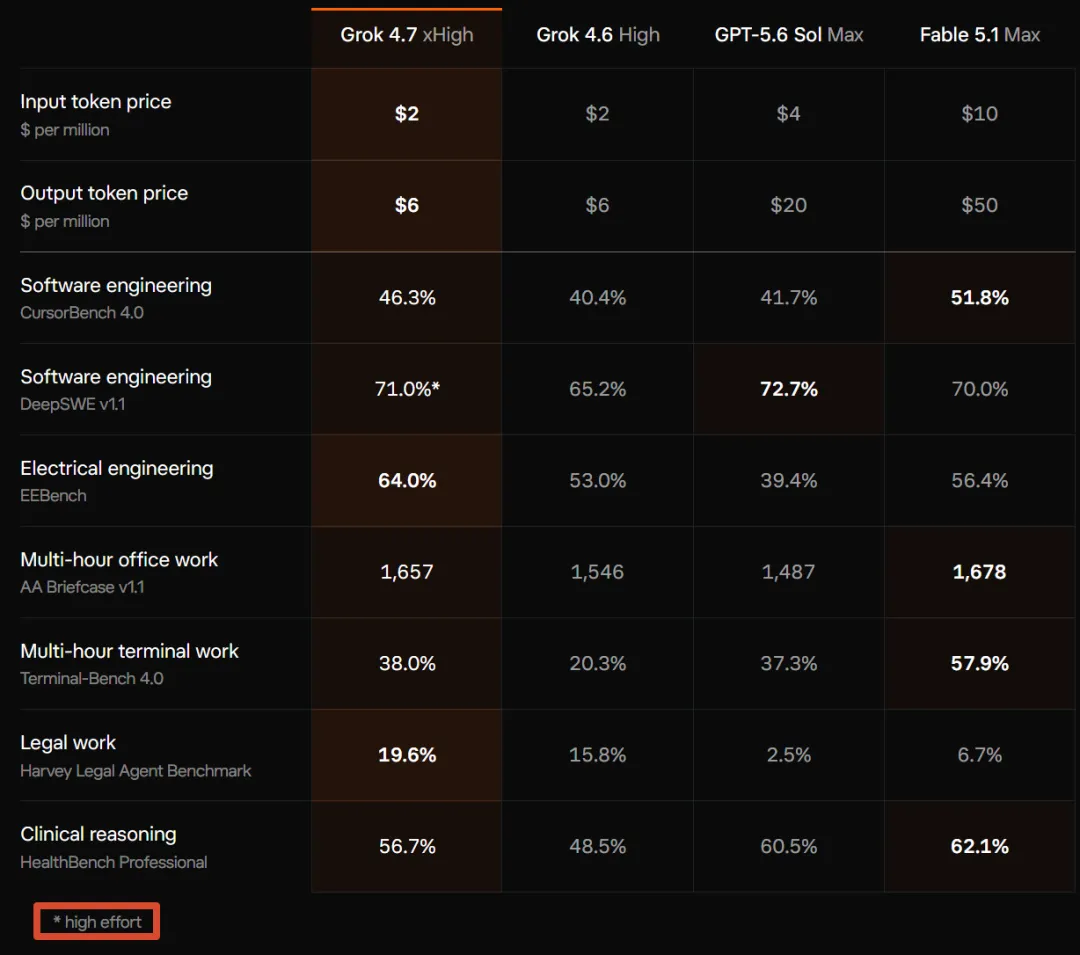
4.7有进步,也还在看人家的背影。
更有意思的是,这牛皮,都不用别人戳,他自己就一点点收回去了。
8月15日,will exceed变成了has a good chance,有不错的机会,马斯克还承认,当时Fable 5总体更聪明,Grok的优势是快和便宜。
到了9月14日,4.7还没发,他已经说,这代大概对齐Opus 5.0,不是5.1,多模态还得加强,,,,然后话锋一转,4.8会明显更好,4.9大概能到Astra、Fable那一档,Grok 5也许比什么都强。
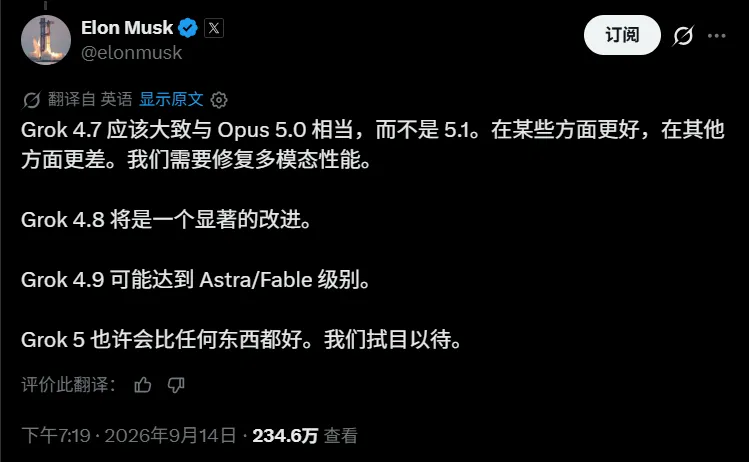
这代的成绩还没出来,,,后三代的庆功宴又先排上了。
发布当天,口径终于落地了。他说SpaceXAI在编程agent上排第三,加上速度快、成本低,很适合当日常主力。这里第三说的是实验室,Anthropic有两个模型在前面,按模型算仍是第四。
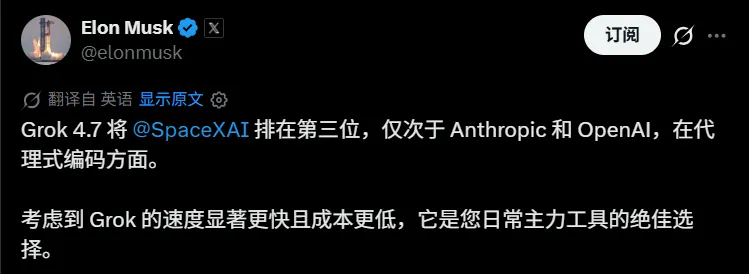
说真的,这个定位有什么不好呢?
挑模型,能把活干好、价格合适,在现在的Agent时代,这就很有吸引力了,,可偏偏奈何马斯克实在是太喜欢提前开香槟,导致大家对Grok的观感都不那么好了。。
Grok 4.7的进步是真的。
还是看看远处的Xiaomi MIMO 2.6和TRAE偷传代码事件吧。
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com