這一個月,先有人在Radeon 上跑通了 DLSS 的一部分特性,接着 OptiScaler社區把 FSR 4.1.2 搬上了 Intel 的 Arc 顯卡,A770 跑《巫師3》重製版,1080p 質量檔,FSR 4.1.2 Lite 出 101.5 幀,超分耗時 0.75 毫秒;Intel 自家的 XeSS SR 是 101.1 幀、0.84 毫秒。
以前i卡也能跑 FSR 4,走 DP4A,靠常規 shader 硬算神經網絡,沒有原生喫 XMX的XeSS用起來舒服。還跟畫面渲染搶同一批 shader 單元,過去一年i卡跑 FSR一直停在嚐鮮,並沒有形成太大的規模,當然i卡本身也沒什麼份額。
轉機在AMD 這邊。十月下旬的 Adrenalin 26.10.1 把 FSR 4.1 下放給 RX 6000、Ryzen APU 和一批掌機,隨之放出的 INT8 庫裏多了個 FSR 4.1.2 Lite。這個 Lite 本是爲功耗受限的移動芯片和核顯準備的,網絡壓得更小,畫質儘量保住。模組作者做的事是改執行路徑,讓它在 DX12 下直接對 XMX 下指令。
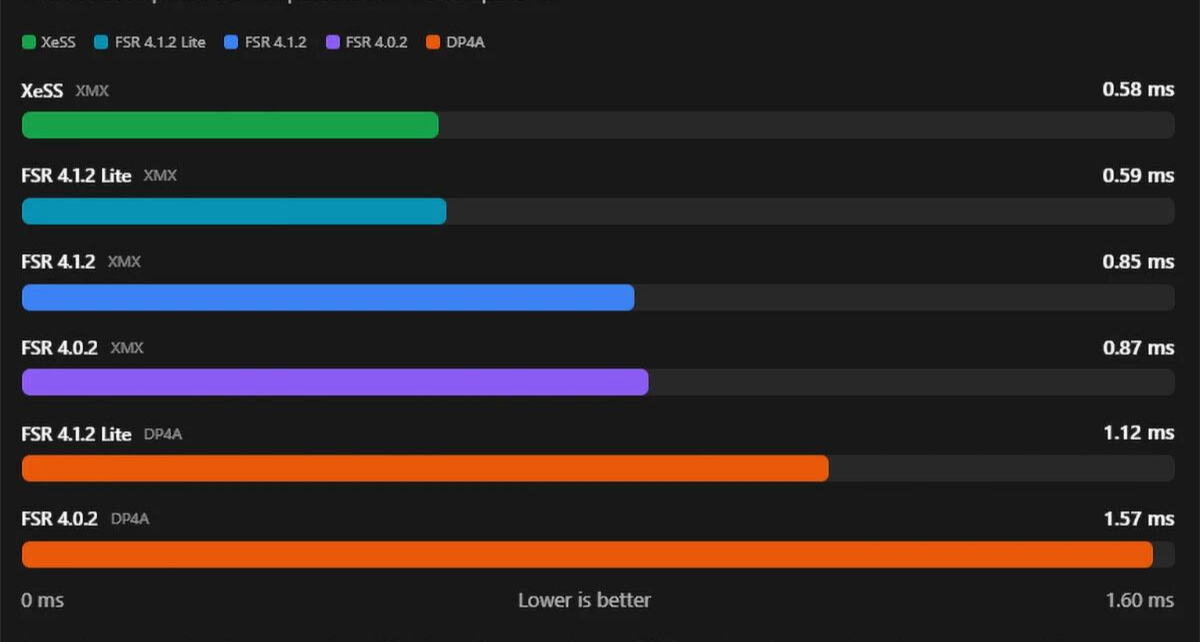
Lite 和 Arc 的匹配算巧合也算必然。XMX 本來是爲 XeSS 的矩陣運算設計的,跑大網絡喫力,欺負一個青春版的模型也是毫無問題。B580 跑《光與影:33號遠征隊》1080p 平衡檔,Lite 超分 0.59 毫秒,XeSS SR 0.58 毫秒,打平;完整版 0.85 毫秒,老的 4.0.2 是 0.87。A770 上完整版 98.6 幀、1.11 毫秒,4.0.2 是 98.0 幀、1.17 毫秒。兩組測試是兩張卡、兩個遊戲分開做的,不能橫向比卡,只能看同一張卡內部的差距。
0.26 毫秒的差距,60幀下一幀有16.7 毫秒,沒感覺;要到 120 幀以上,一幀8毫秒出頭,完整版留給 60 幀檔,Lite 是給高刷準備的。Lite 在幾乎不掉畫質的前提下把成本壓到了 XeSS 同一檔。
畫質目前全是主觀結論。社區裏有人說FSR 4.1.2 在 XMX 上比原生 XeSS 乾淨,邊緣和細節保留得更好,Lite 也保住了大半觀感。這些我信一半:模型確實更新,方向上的優勢說得通,但沒有跨遊戲、跨分辨率的受控對比,幾張截圖和幾個人的眼睛不夠。真正該盯的是樹葉、鐵絲網、雨絲這類高頻細節,以及鏡頭平移時畫面穩不穩,那纔是超分容易露餡的地方。
還有把它和XeSS 幀生成疊着用,A770 在《刺客信條:奧德賽》4K 開四倍幀生成跑到120 幀,大半是插出來的幀,限制很多,只能用DX12,有反饋《紅色沙漠》會閃退崩潰,並且改過的 DLL 換個驅動可能失效,DLL 的路子在多人網遊裏有風險,單機離線折騰問題不大,只適合折騰玩玩。
XeSS 的問題從來不是畫質,是遊戲數量,沒有 XeSS 的作品 Arc 用戶只能退到 DP4A 或者關掉超分。現在多了一條路,成本幾乎爲零,再往深看,三家的 AI 硬件架構差別遠小於營銷話術:矩陣單元就是矩陣單元,INT8 就是 INT8。
對Intel來說還是很尷尬的,民間開發出來的東西,用作自家硬件跑對手的模型,比自家軟件還順,大勢去矣!
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com