这一个月,先有人在Radeon 上跑通了 DLSS 的一部分特性,接着 OptiScaler社区把 FSR 4.1.2 搬上了 Intel 的 Arc 显卡,A770 跑《巫师3》重制版,1080p 质量档,FSR 4.1.2 Lite 出 101.5 帧,超分耗时 0.75 毫秒;Intel 自家的 XeSS SR 是 101.1 帧、0.84 毫秒。
以前i卡也能跑 FSR 4,走 DP4A,靠常规 shader 硬算神经网络,没有原生吃 XMX的XeSS用起来舒服。还跟画面渲染抢同一批 shader 单元,过去一年i卡跑 FSR一直停在尝鲜,并没有形成太大的规模,当然i卡本身也没什么份额。
转机在AMD 这边。十月下旬的 Adrenalin 26.10.1 把 FSR 4.1 下放给 RX 6000、Ryzen APU 和一批掌机,随之放出的 INT8 库里多了个 FSR 4.1.2 Lite。这个 Lite 本是为功耗受限的移动芯片和核显准备的,网络压得更小,画质尽量保住。模组作者做的事是改执行路径,让它在 DX12 下直接对 XMX 下指令。
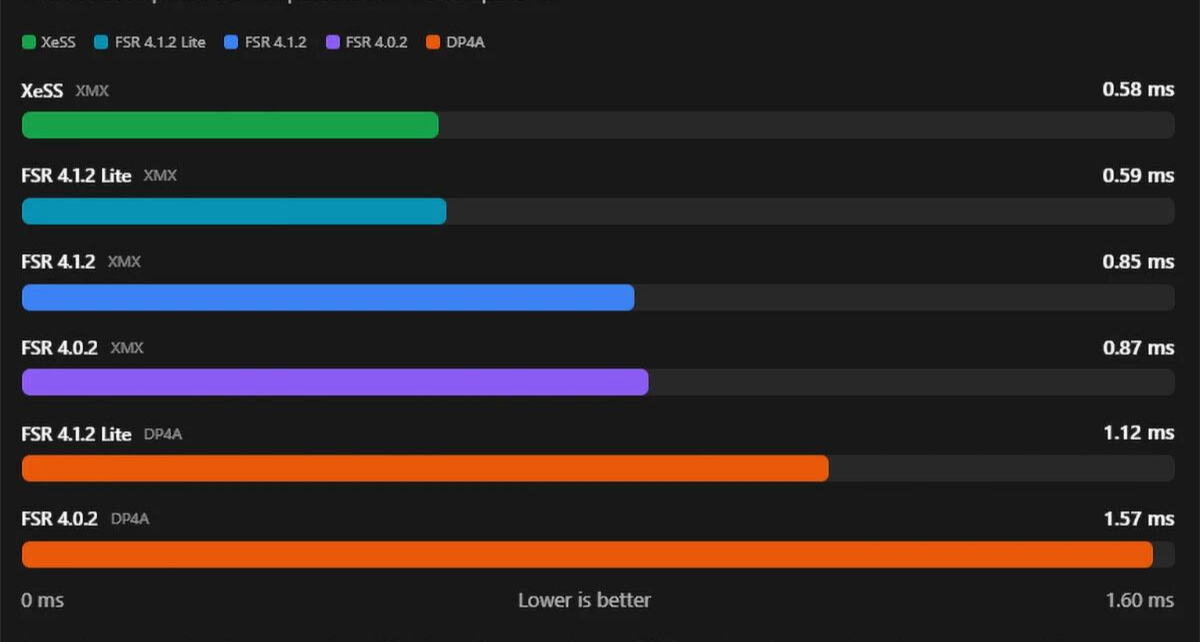
Lite 和 Arc 的匹配算巧合也算必然。XMX 本来是为 XeSS 的矩阵运算设计的,跑大网络吃力,欺负一个青春版的模型也是毫无问题。B580 跑《光与影:33号远征队》1080p 平衡档,Lite 超分 0.59 毫秒,XeSS SR 0.58 毫秒,打平;完整版 0.85 毫秒,老的 4.0.2 是 0.87。A770 上完整版 98.6 帧、1.11 毫秒,4.0.2 是 98.0 帧、1.17 毫秒。两组测试是两张卡、两个游戏分开做的,不能横向比卡,只能看同一张卡内部的差距。
0.26 毫秒的差距,60帧下一帧有16.7 毫秒,没感觉;要到 120 帧以上,一帧8毫秒出头,完整版留给 60 帧档,Lite 是给高刷准备的。Lite 在几乎不掉画质的前提下把成本压到了 XeSS 同一档。
画质目前全是主观结论。社区里有人说FSR 4.1.2 在 XMX 上比原生 XeSS 干净,边缘和细节保留得更好,Lite 也保住了大半观感。这些我信一半:模型确实更新,方向上的优势说得通,但没有跨游戏、跨分辨率的受控对比,几张截图和几个人的眼睛不够。真正该盯的是树叶、铁丝网、雨丝这类高频细节,以及镜头平移时画面稳不稳,那才是超分容易露馅的地方。
还有把它和XeSS 帧生成叠着用,A770 在《刺客信条:奥德赛》4K 开四倍帧生成跑到120 帧,大半是插出来的帧,限制很多,只能用DX12,有反馈《红色沙漠》会闪退崩溃,并且改过的 DLL 换个驱动可能失效,DLL 的路子在多人网游里有风险,单机离线折腾问题不大,只适合折腾玩玩。
XeSS 的问题从来不是画质,是游戏数量,没有 XeSS 的作品 Arc 用户只能退到 DP4A 或者关掉超分。现在多了一条路,成本几乎为零,再往深看,三家的 AI 硬件架构差别远小于营销话术:矩阵单元就是矩阵单元,INT8 就是 INT8。
对Intel来说还是很尴尬的,民间开发出来的东西,用作自家硬件跑对手的模型,比自家软件还顺,大势去矣!
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com