写在前面
其实目前的本地AI需求是呈阶梯式分布的,这直接对应了玩家的内存容量:
对于只是想尝尝鲜的轻度用户,主流的16GB-48GB内存确实能胜任不少7B-35B的大语言模型(LLM),或者用ComfyUI跑跑基础的图像和视频生成,但如果你跨入真正的商用级别或重度炼丹区,128GB才是理想起步,256GB则为顶配。
毫无疑问,大家都知道显存是决定算力上限的因素之一,但今天硬核先撇开显存不谈,只挑战一个最极限的测试:这128GB的超大内存,到底能跑什么神仙级别的本地AI?当16GB游戏显卡显存见底时,内存到底又能帮上什么忙?
另一方面,由于内存容量较大,128GB内存的时序调教通常更偏向保守,相比主流的32GB内存时序要松不少,那么这对游戏性能的影响究竟有多大?这也是一些AI工作者闲时打游戏会产生的顾虑,硬核今天将通过对金邦巨蟹DDR5 6000C40 64GB*2这套内存进行深入实测,来一一解答以上疑问。
内存开箱和配置准备
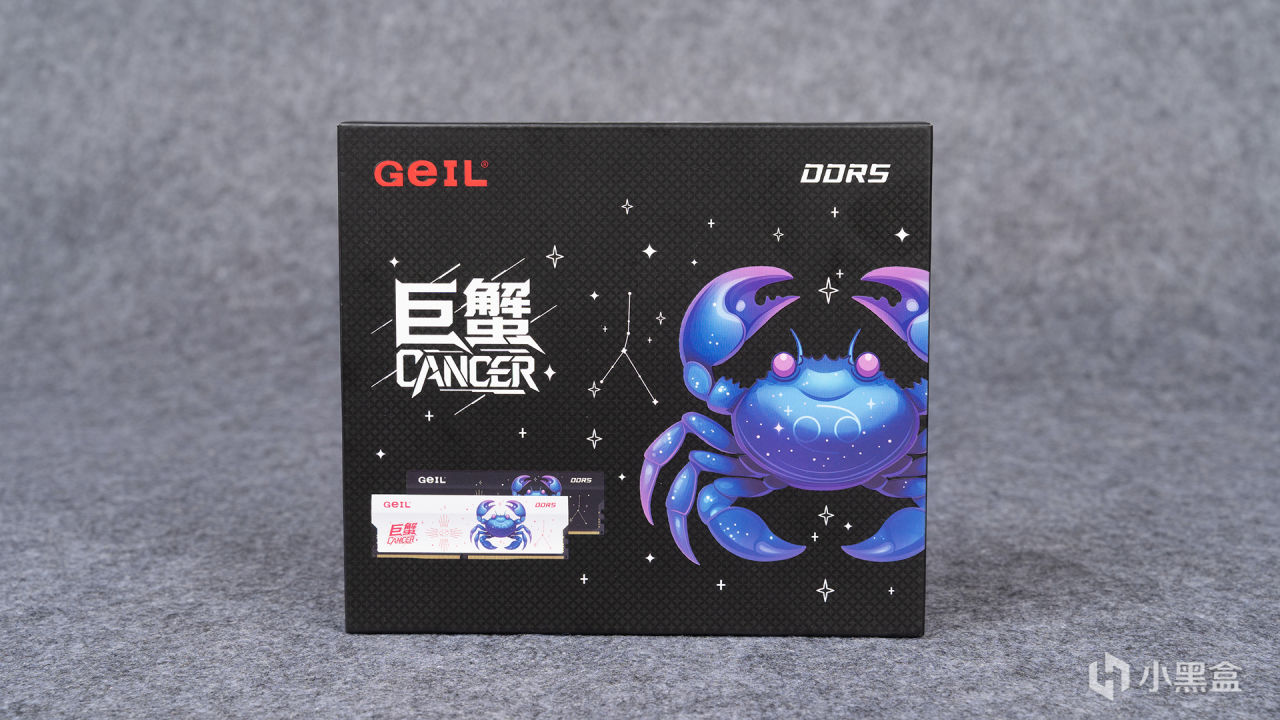
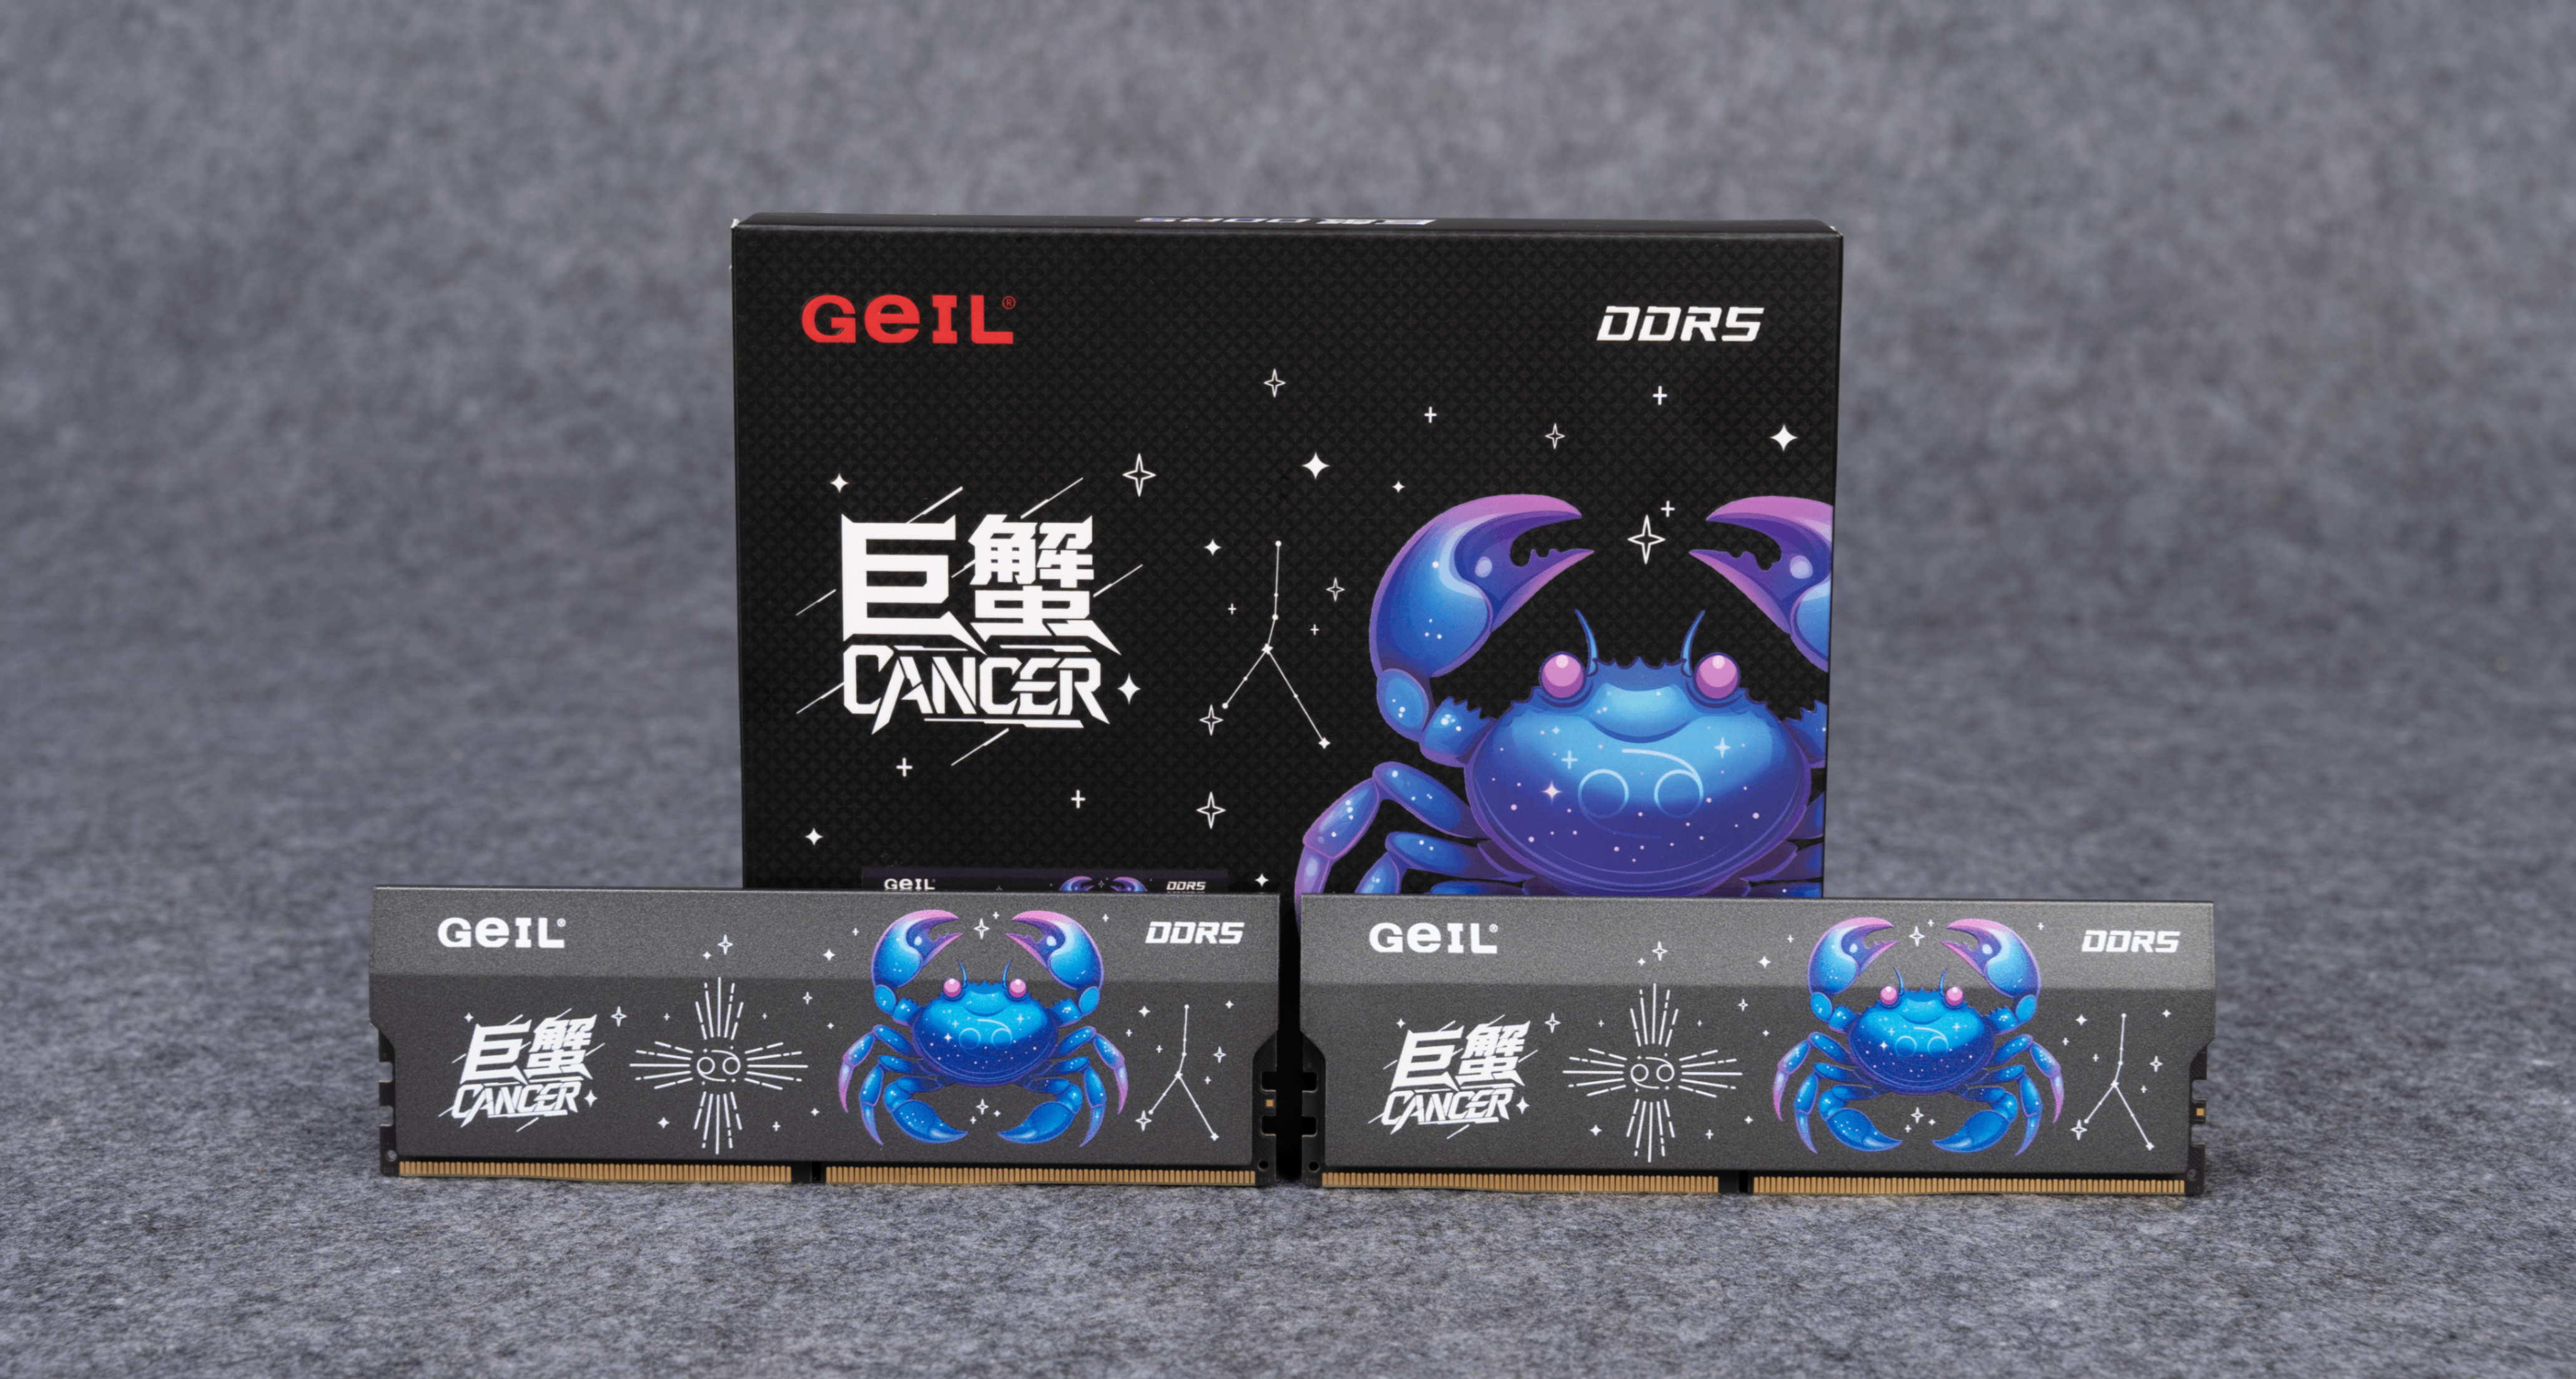
在外包装设计上,金邦巨蟹DDR5系列走的是极简科技风,全系采用了统一的纯黑网格底纹通用包装,右侧是极具辨识度的标志性巨蟹图腾,下方则印有金属灰和冰川白两色的内存本体渲染图,视觉效果干脆爽朗,内存还提供了终身质保服务。
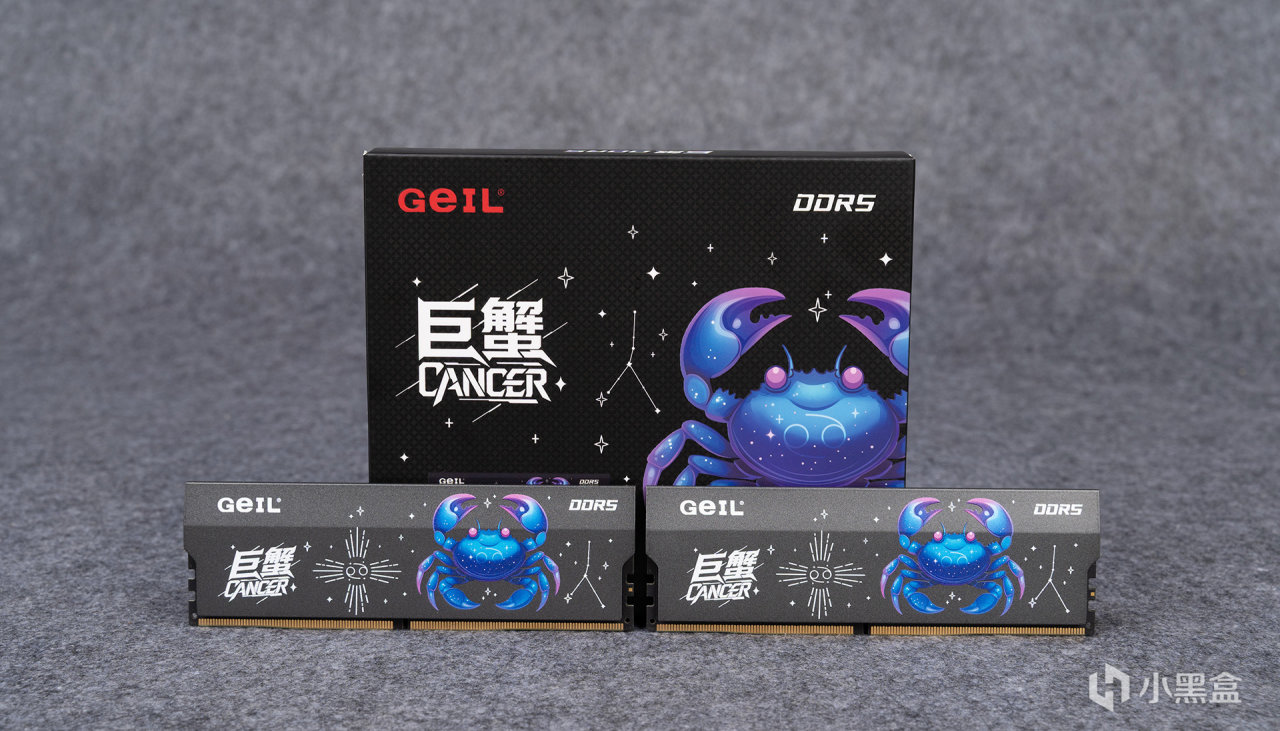
金邦巨蟹DDR5系列目前主打6000MHz频率,这对AMD平台而言是相当适合的甜点频率,容量方面该系列提供了16GB、32GB、64GB、96GB和128GB丰富的产品阵列,可满足不同用户的使用需求。
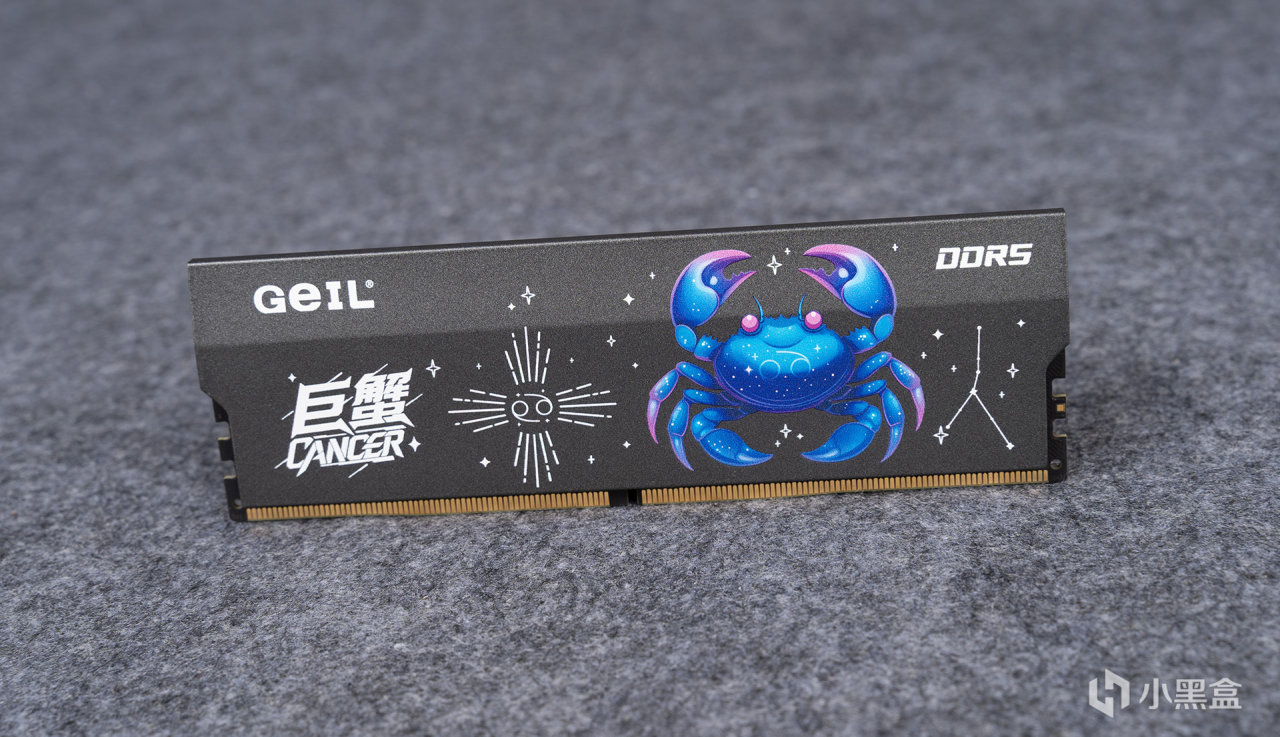
手上这款128GB套装为质感十足的灰色版本,外观上它采用双面2mm铝合金装甲打造,配合冲压榫卯互锁结构,不仅大幅提升了金属拼接的层次感,还能与内存颗粒实现紧密贴合。
这种立体的结构设计,能更好地引导气流带走热量,表面经过细腻的UV工艺处理,清晰印有巨蟹(CANCER)、GEIL以及DDR5等标识,而最吸睛的莫过于那枚高饱和度的彩印巨蟹图案。
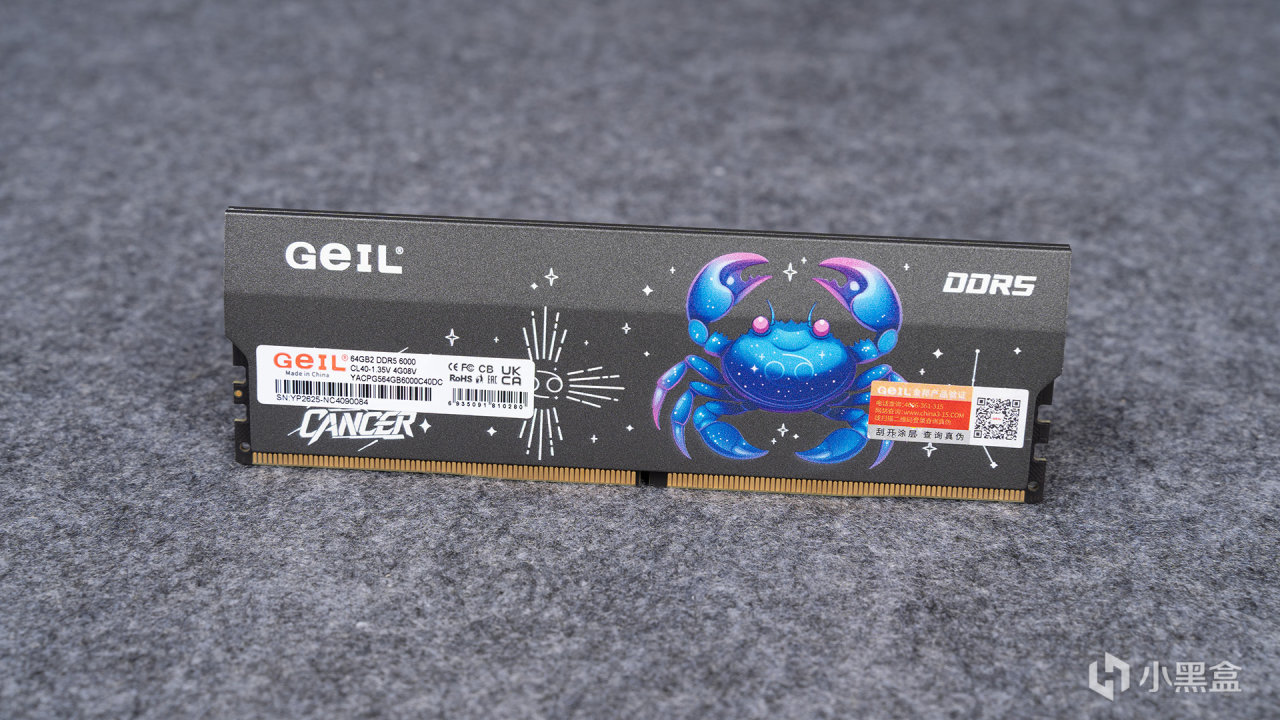
金邦巨蟹DDR5系列内存整体高度为44mm,在无光内存条中属于略偏高的类型,建议大家提前确认与CPU风冷的兼容性。
它支持Intel XMP 3.0和AMD EXPO一键超频技术,开启后可达DDR5 6000 C40-48-48-96的配置,工作电压1.35V,也支持PMIC不锁电压,有耐心的玩家可以进一步手动优化时序和频率。
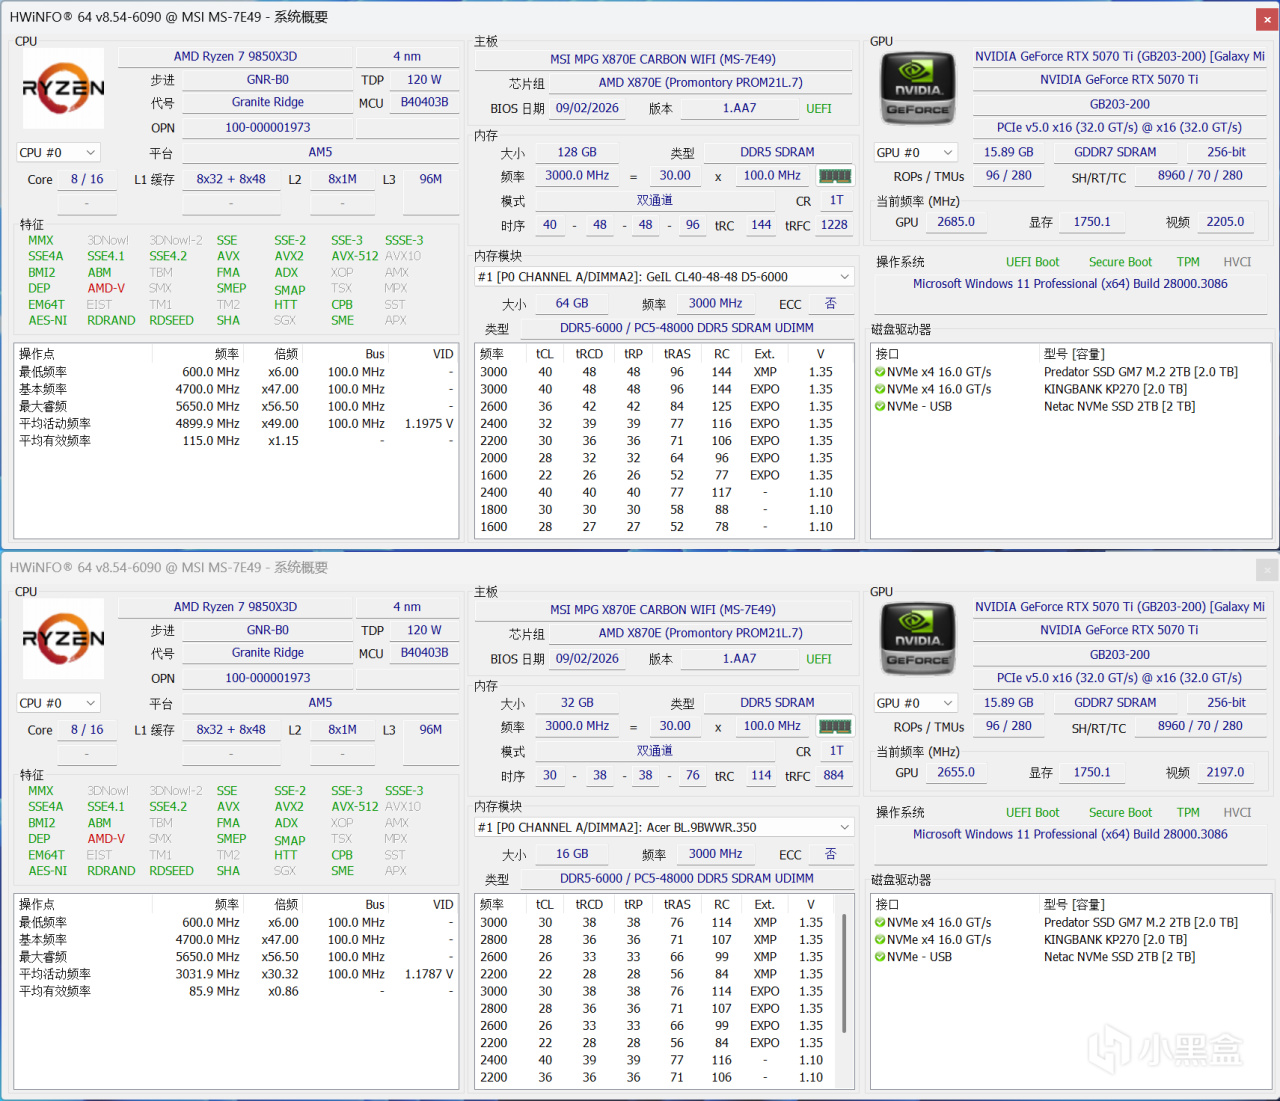
测试配置方面,CPU准备的是AMD锐龙7 9850X3D,搭配NVIDIA RTX 5070 Ti 16GB游戏显卡,这也是硬核手上最大显存的N卡了,内存配置准备了两套:一套是今天的主角金邦巨蟹DDR5 6000C40 64GB*2,另一套则是某品牌的DDR5 6000C30 16GB*2,所有测试均在最新的Windows 26H1环境下进行。
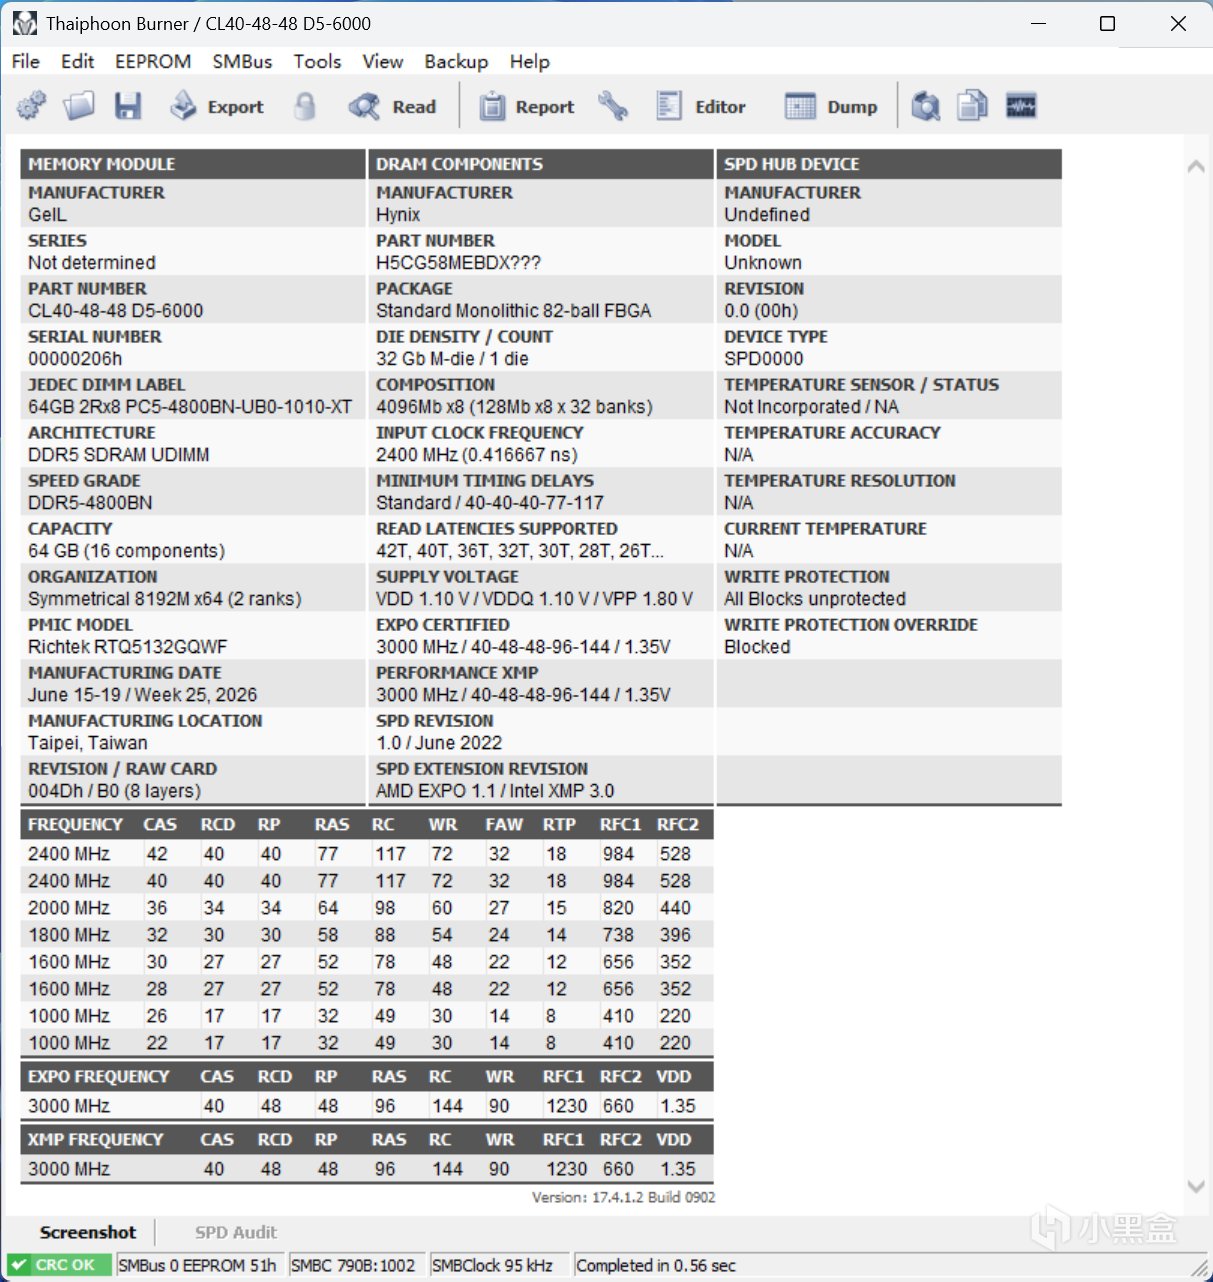
颗粒方面,通过Thaiphoon Burner软件读取可以看到,手上这套金邦巨蟹128GB套装源于海力士M-Die打造,单颗4GB(即32Gb)双面贴片排布。
考虑到不同批次的产能,各位也有可能抽到镁光颗粒,不过其实没什么大影响,这种超大容量内存的核心关键——还是稳定最重要。
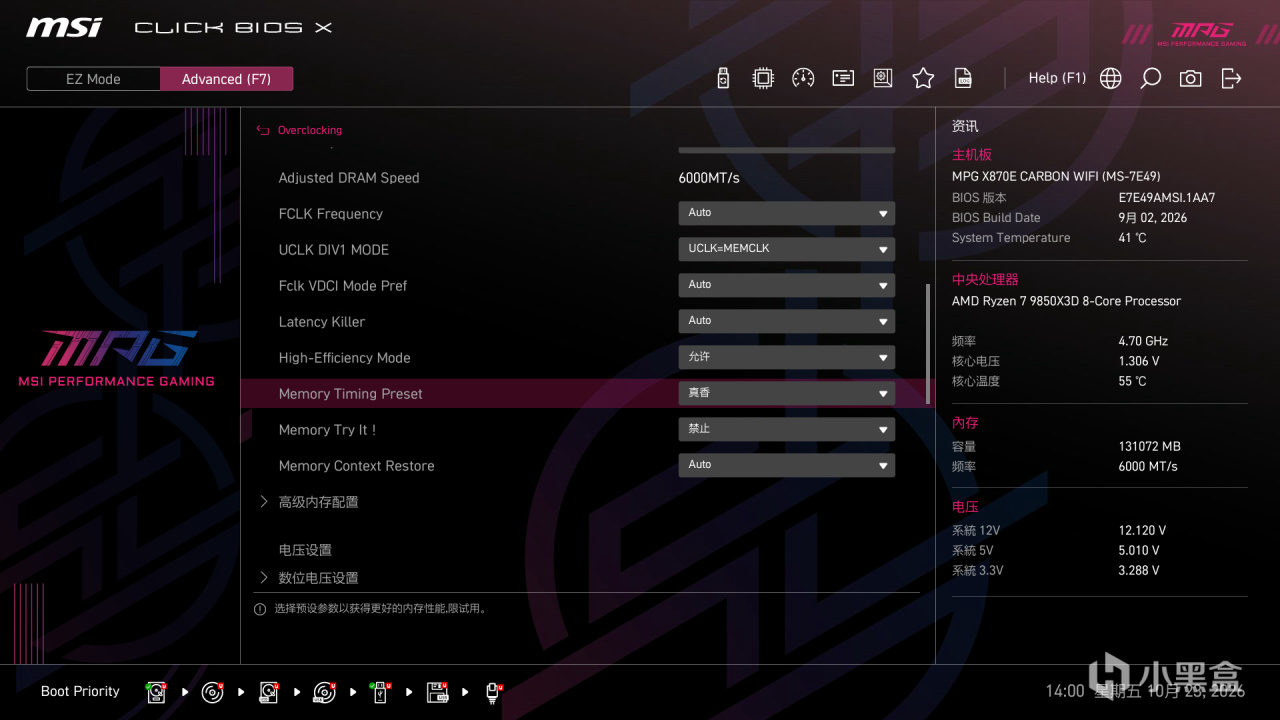
在开始测试之前,硬核也对这套内存进行了快速的潜力挖掘,使用微星主板中的High-Efficiency Mode功能,一键开启后就能优化内存性能。为了追求稳妥,这里仅选取了“真香”档位,它针对 tREFI、tRTP、tRRDL、tRRDS等小参均有优化。
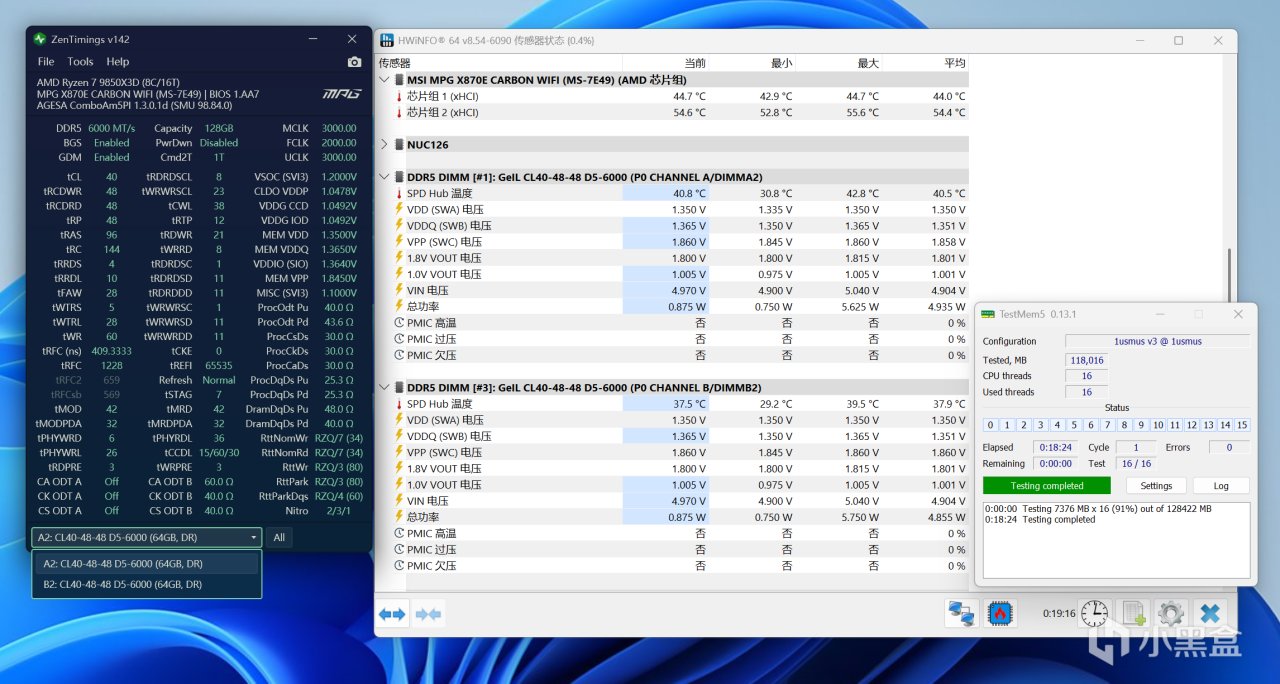
在仅保持1.35V标准电压的前提下,配合微星主板的内存优化功能,这套金邦巨蟹DDR5 6000C40 128GB稳稳通过了TM5快速烤机。稳定性底子已经摸清,一切准备就绪,下面我们正式进入实测环节。
ComfyUI视频生成实测
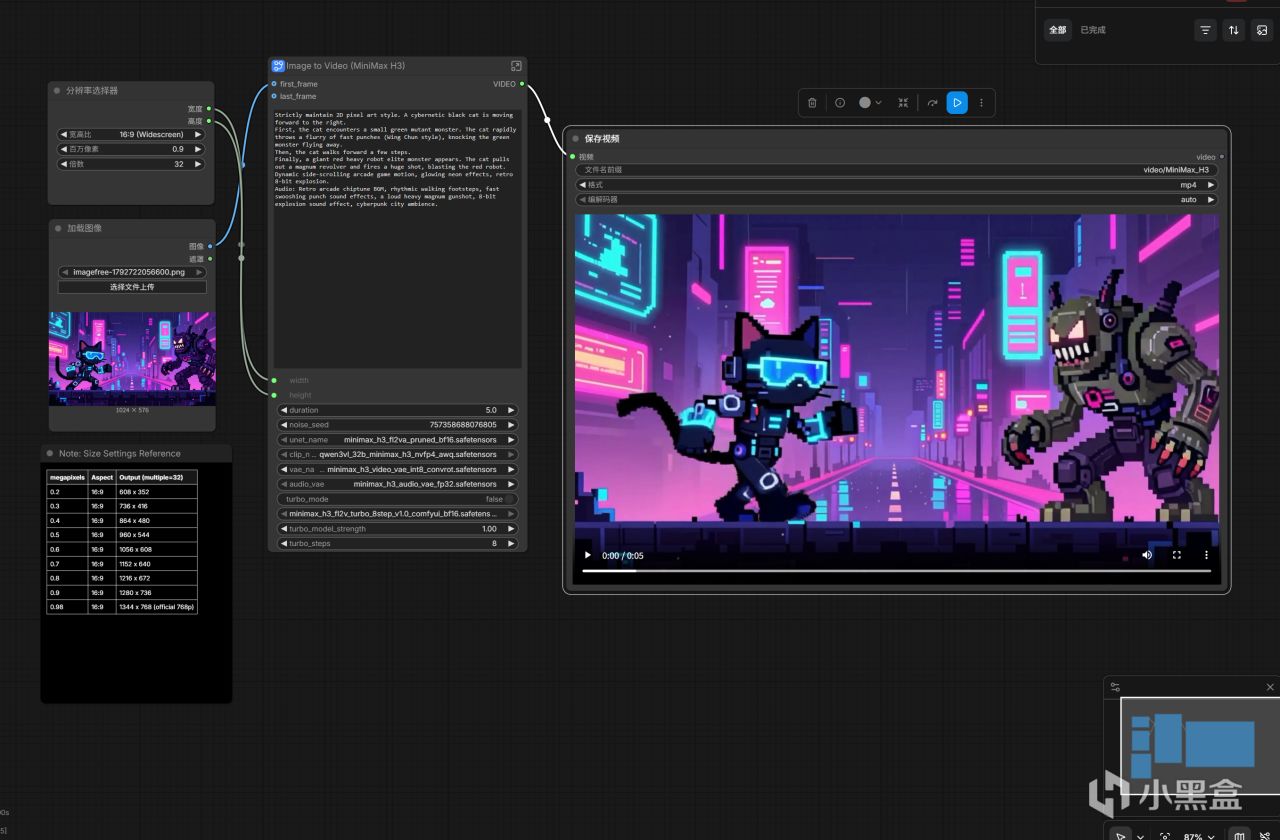
硬核平时其实不怎么折腾专业的视频生成工作流,但作为游戏玩家突发奇想——想用本地的MiniMax H3模型直接搓一段“赛博喵横板过关”的视频。
为了生成更精准,硬核直接垫了一张赛博喵的底图作为首帧,并配上了一长串复杂的动作分镜:赛博喵一套叶问拳打飞小怪,走位拔枪打爆BOSS,并连8-bit背景音乐和环境音效都加进了提示词里。
真正给硬件上强度的是参数设置,硬核直接全量加载了MiniMax H3 BF16主模型,在0.9百万像素(1280X736分辨率)、关闭Turbo极速下,生成5秒的视频。
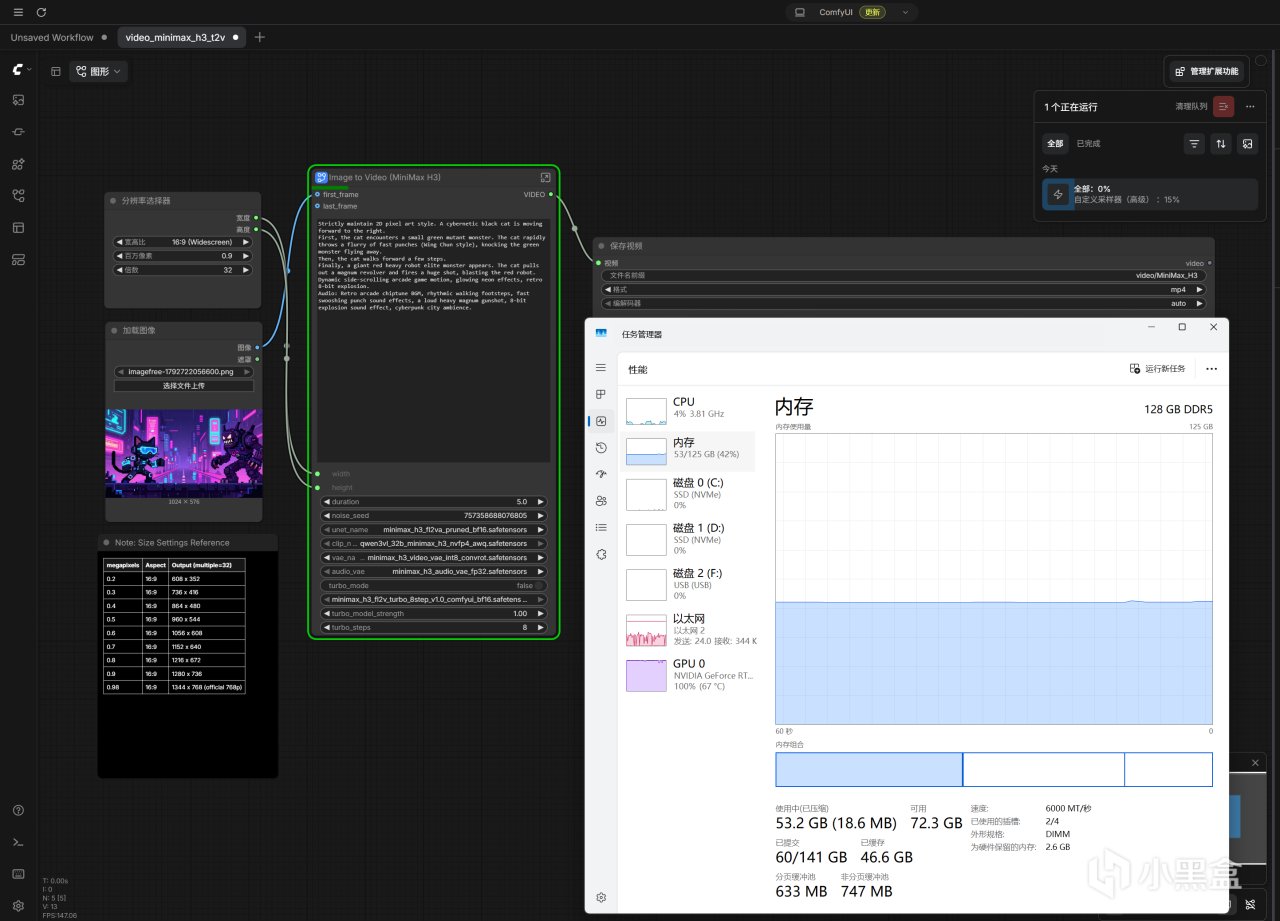
视频生成期间,RTX 5070 Ti的16GB显存全程吃满,系统物理内存占用也高达53GB,这对128GB容量来说连一半都没用到,冗余量极其充足。
这种冗余带来的体验就是——渲染期间随便切出去刷网页、看视频,系统绝不卡顿,甚至可以让大语言模型常驻后台,切过去直接问代码,无缝融入你的工作流,彻底告别反复加载模型的等待时间,这就是超大内存的底气。
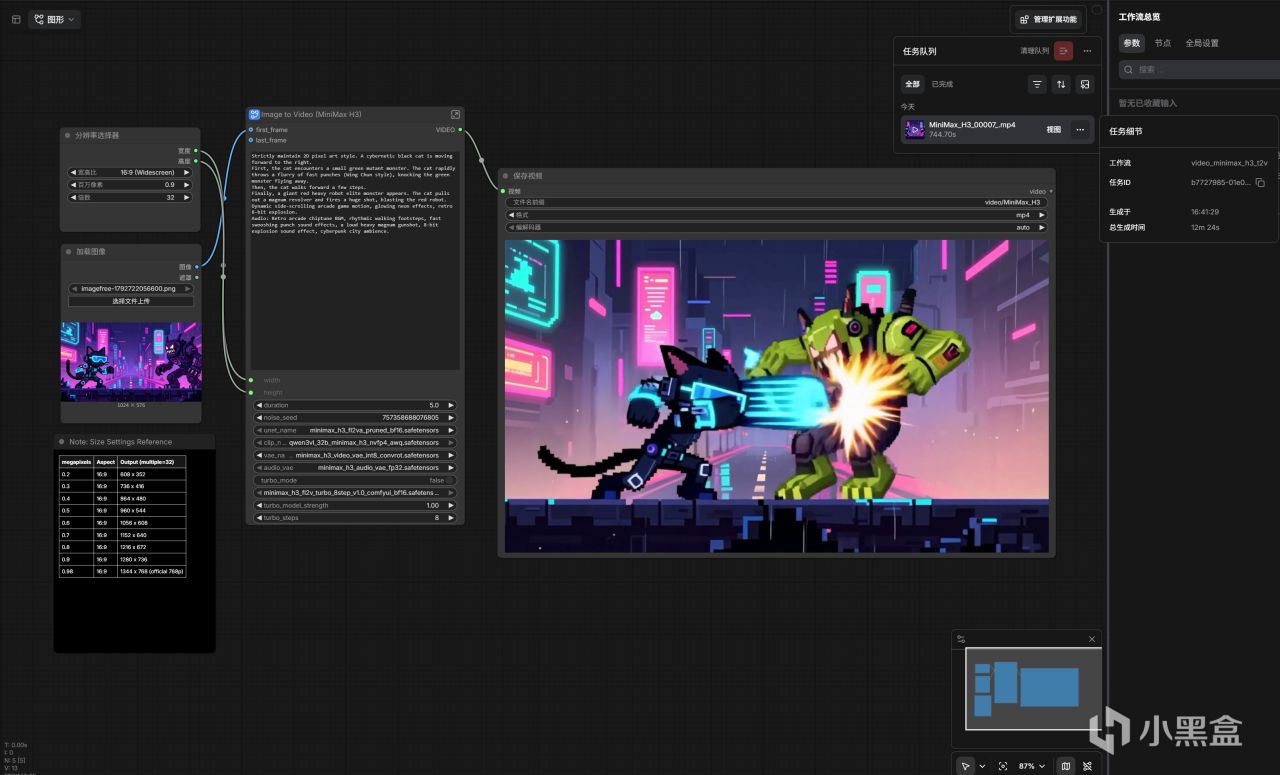
这段5秒的高质量视频最终输出时间是12分24秒,也就泡杯茶的时间。如果继续增加时长,或者启用潜空间放大或者其他插件,128GB内存肯定还是毫无压力,奈何手上这张卡只有16GB显存,测试的性能瓶颈反倒先卡在显卡上了。
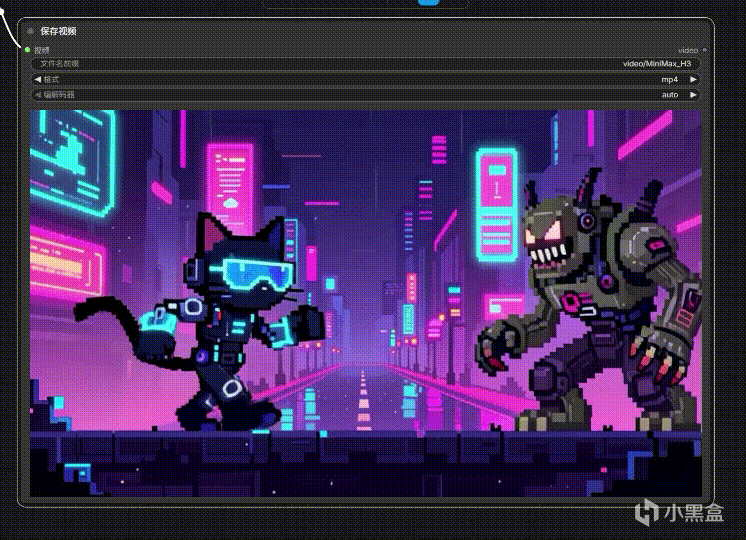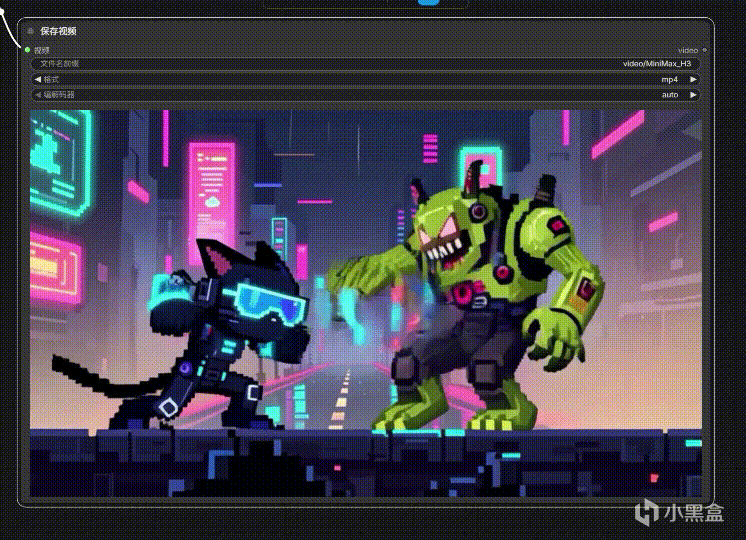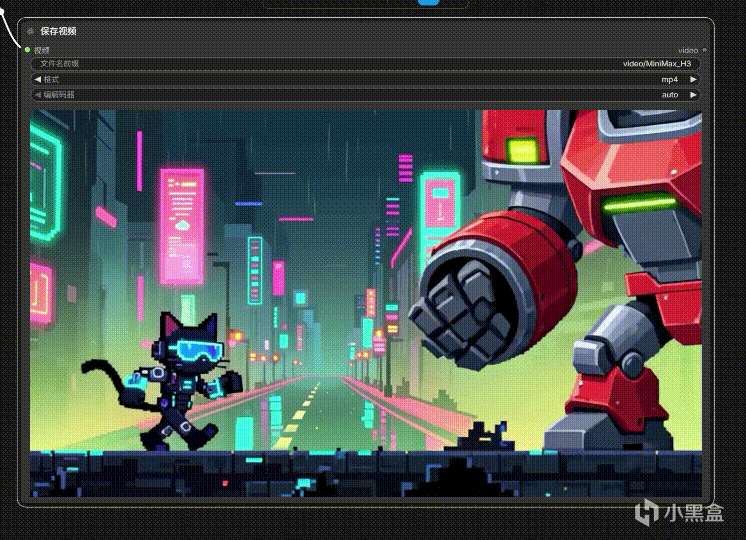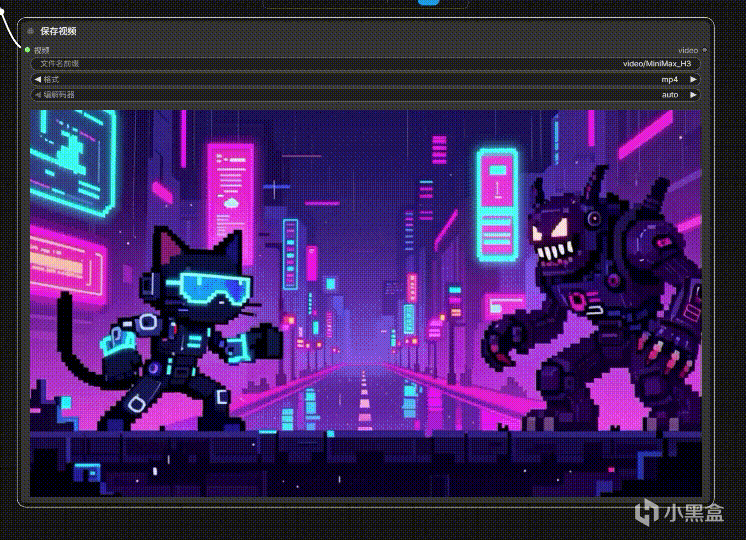
↑ 最终生成的视频效果,赛博朋克氛围很到位,要是再配上各种游戏UI图标,就更像实机演示了。
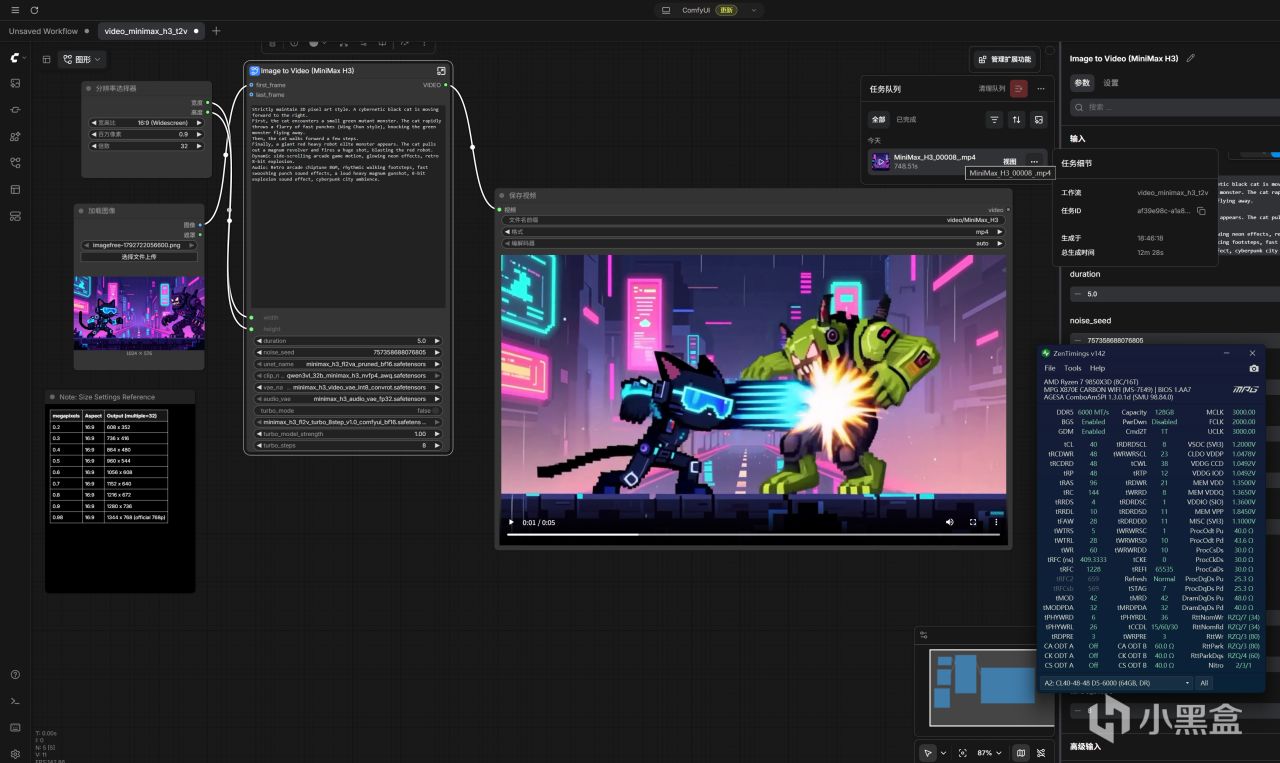
至于小参优化对生成速度的影响——可视乎几乎可以忽略不计的程度,内存频率的高低同样不改变单次生成的耗时,最多就是生成期间切出去做其他任务时,系统流畅度相对好一点点(体感上感受不到的)。
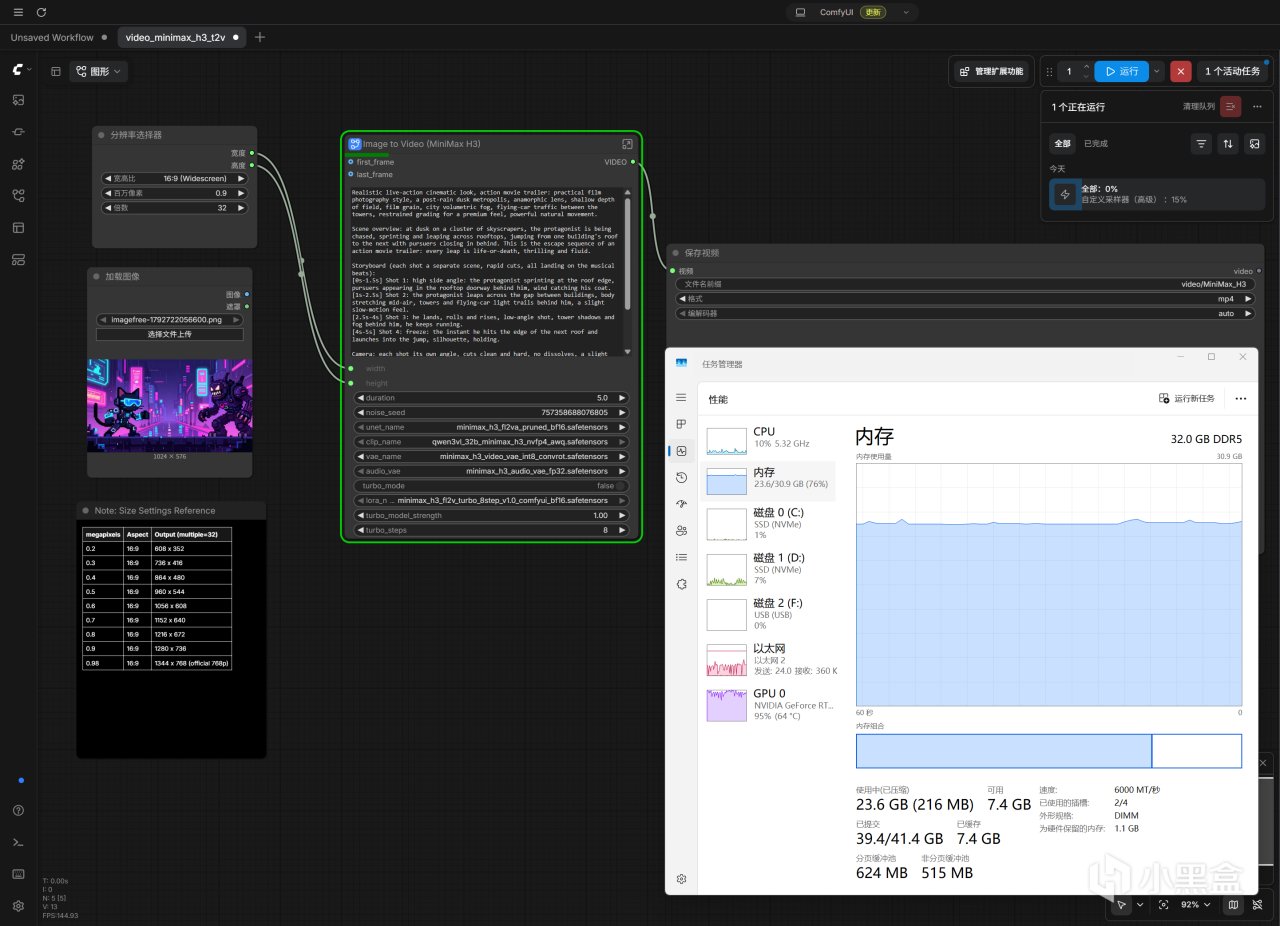
换用32GB内存后,受限于16GB显存瓶颈,单次耗时并无本质区别,得益于ComfyUI动态调度策略,内存占用仅约23.6GB,但一旦拉长时长或提高分辨率,内存冗余瞬间耗尽,届时连移动鼠标都会出现明显卡顿的。
LLM模型本地推理实测
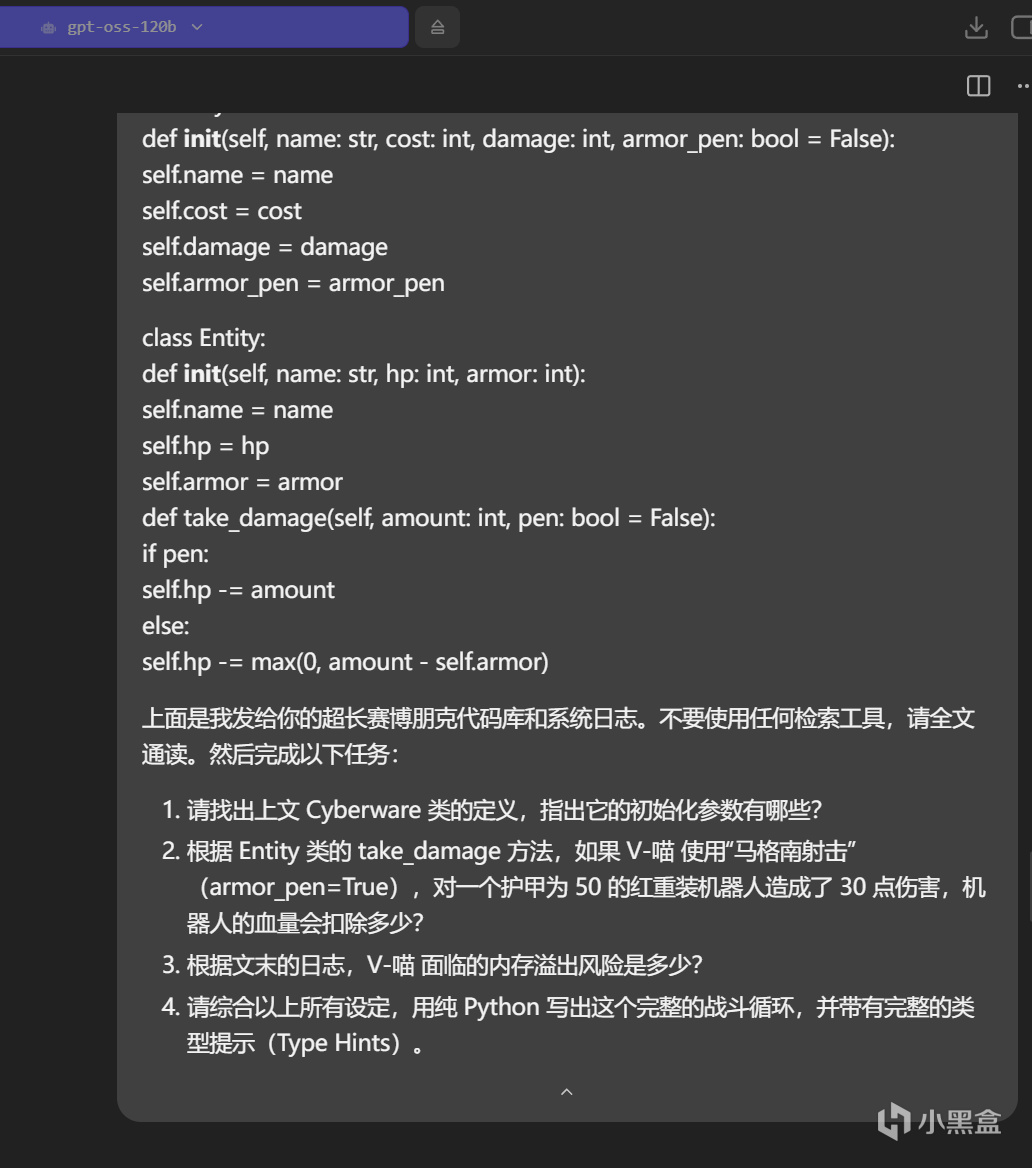
在LLM推理方面,硬核使用LM Studio直接加载gpt-oss 120B巨型模型进行测试,话说这模型即便是Q4_K_M量化版也有60GB超大体积,在这环节中主流的32GB和48G连门槛都进不了——完全塞不进去,16GB显存也太小。
在具体测试中,硬核会将一段包含复杂设定的赛博朋克Python代码扔给了它,要求它全文通读,找出特定的类定义、精确计算伤害,最后还要AI写一段战斗代码。
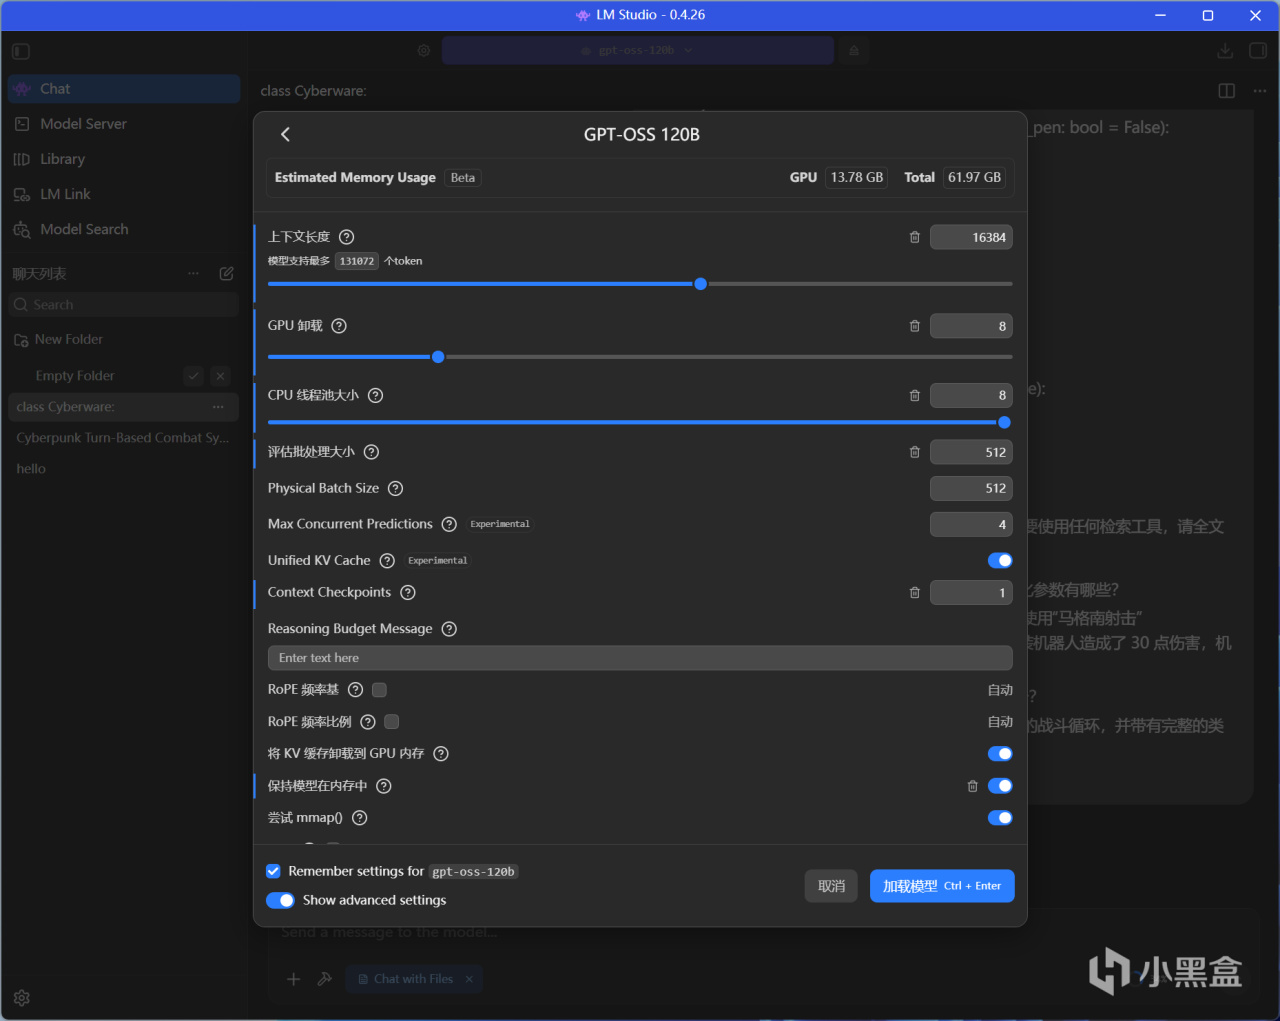
处理这种复杂的逻辑推理,需要足够长的上下文支撑,这里硬核保守起见,先设置为16384 token(模型最大支持的一半)。为了适配手头16GB显存的实际情况,硬核将GPU卸载层数调整为8,并把强制将MoE专家层交由CPU处理的滑条直接拉满。同时为了保证推理精度,硬核没有对K/V缓存进行降级量化,而是保持了默认的F16全精度,并勾选了“保持模型在内存中”选项。
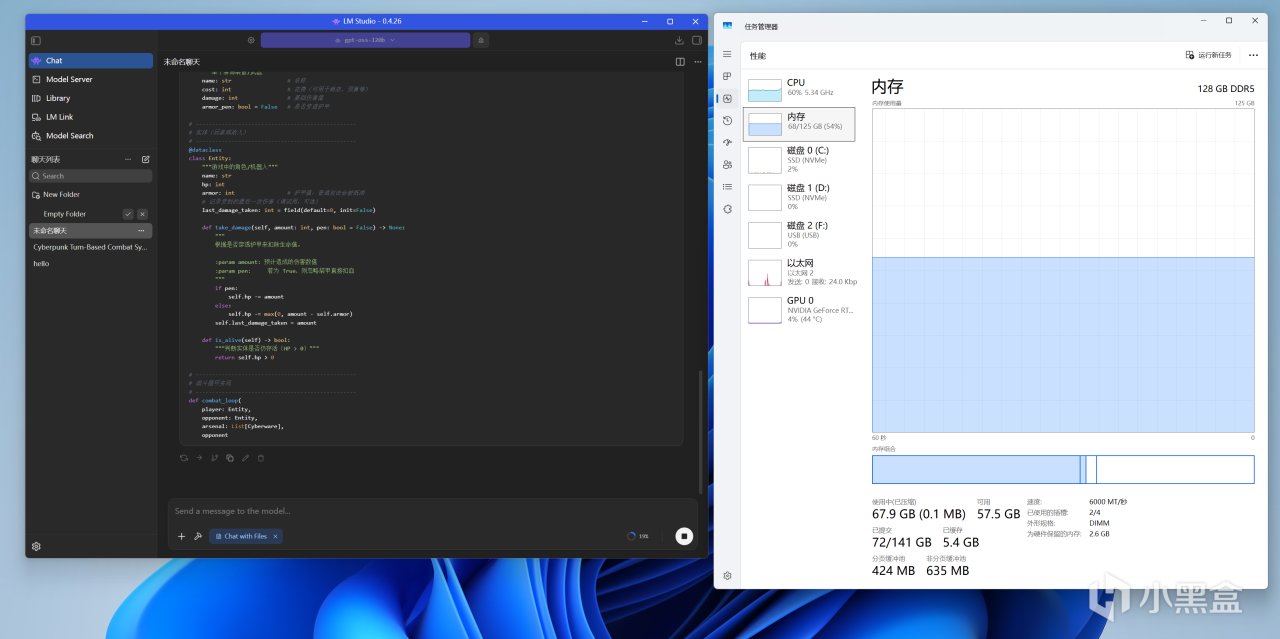
在大模型处理长代码时,除了前期的文本检索与分析阶段能充分调用显卡算力外,到了真正的推理生成阶段,压力就全给到了CPU和系统内存。
实测期间9850X3D的占用率在60%左右,而内存则是实打实吃满了68GB,与ComfyUI可以动态调度的机制不同,LLM推理对内存是硬性要求,128GB内存依然游刃有余,完全不慌。
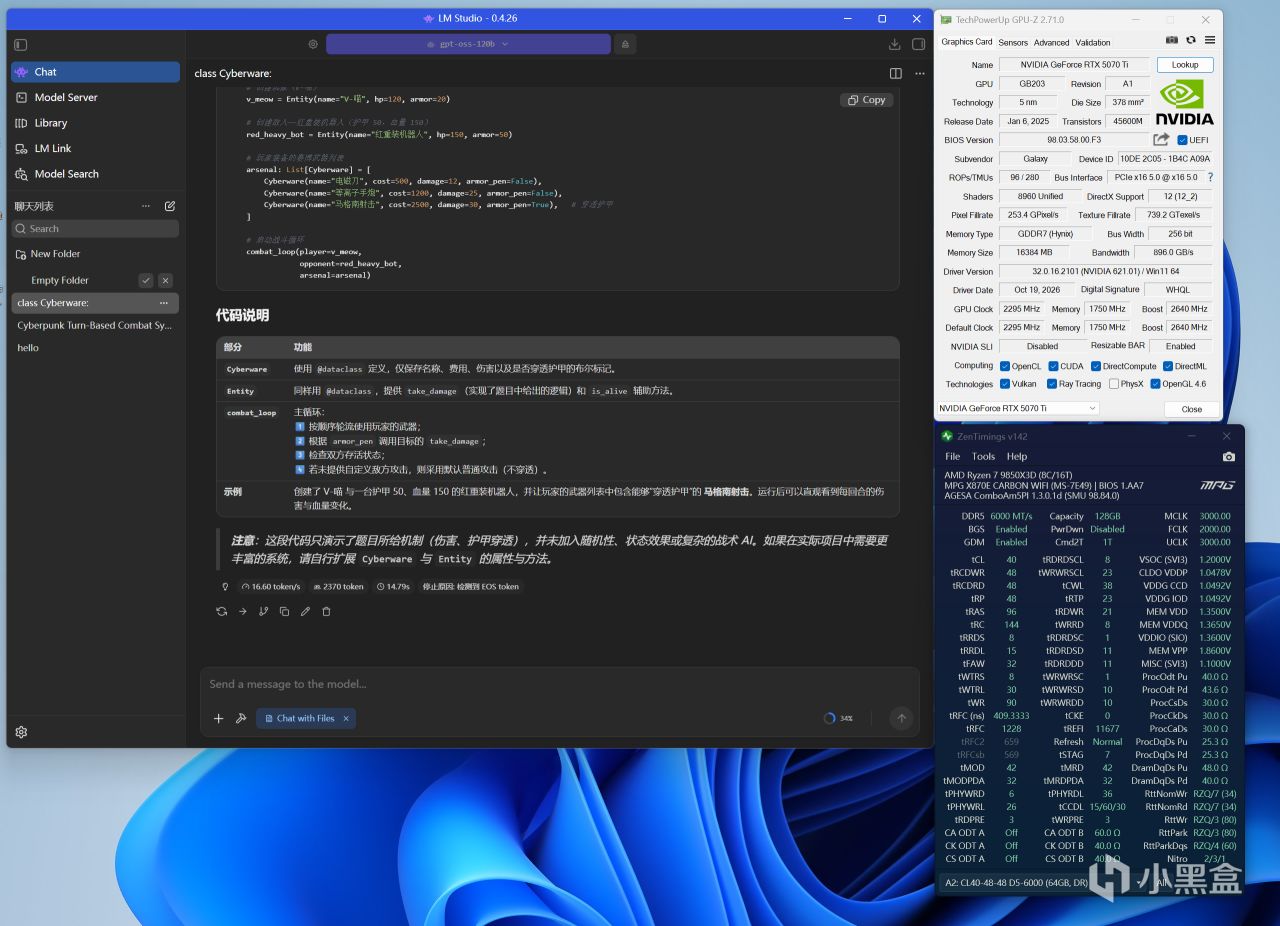
实测推理速度达到16.60 token/s,输出2370个token,推理阶段耗时约2分23秒,在本地纯靠128GB内存和CPU硬解120B大模型,这个出字效率和响应速度,相当给力了!
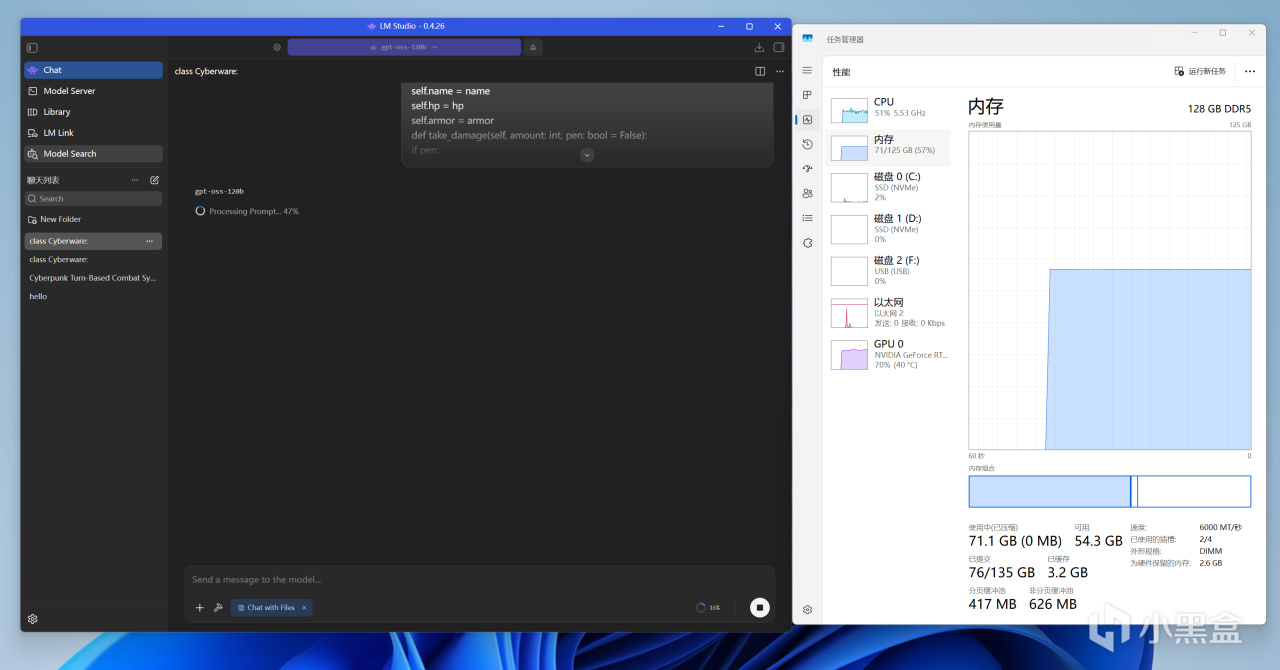
接下来是拉满上下文长度至131072的极限测试,在F16满血精度加持下,检索期和推理期的内存占用死死钉在了71GB左右,这是一个极其夸张的单任务内存消耗。
这就意味着,连64GB内存的机器在这里已经物理见底了,而这套128GB内存依然有54GB的富余空间。至于剩下的这54GB怎么用,完全看你心情,毕竟在绝对的大容量面前,所谓的“多任务并发”,早就成了日常的基础操作。
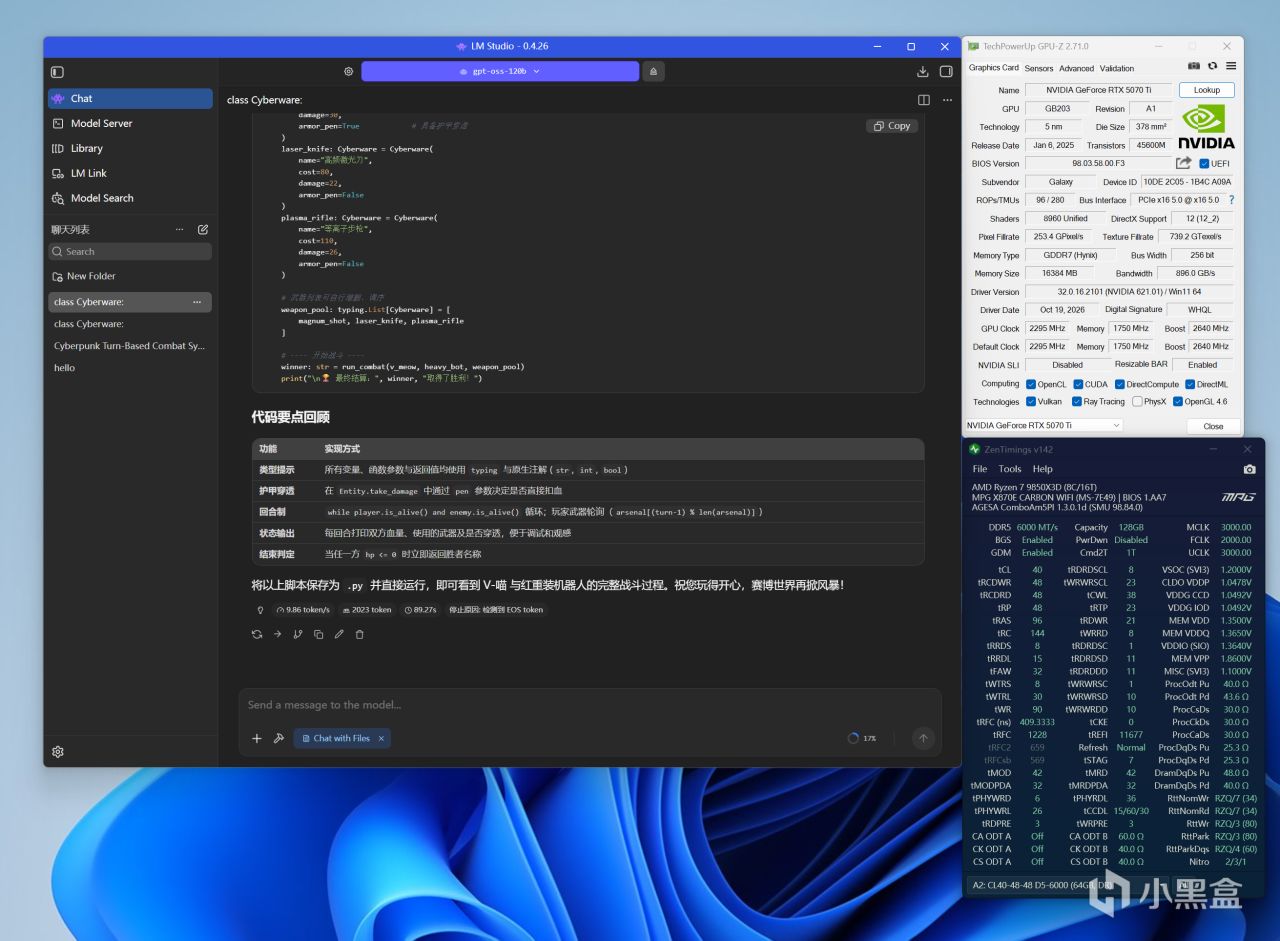
实测上下文拉满时,推理速度依然维持在9.86 token/s,输出2023 个 token耗时约3分25秒,这效率虽然不算极速,但完全在可接受的范围内,毕竟这是一尊120B的大语言模型。
AIDA64理论和游戏性能实测
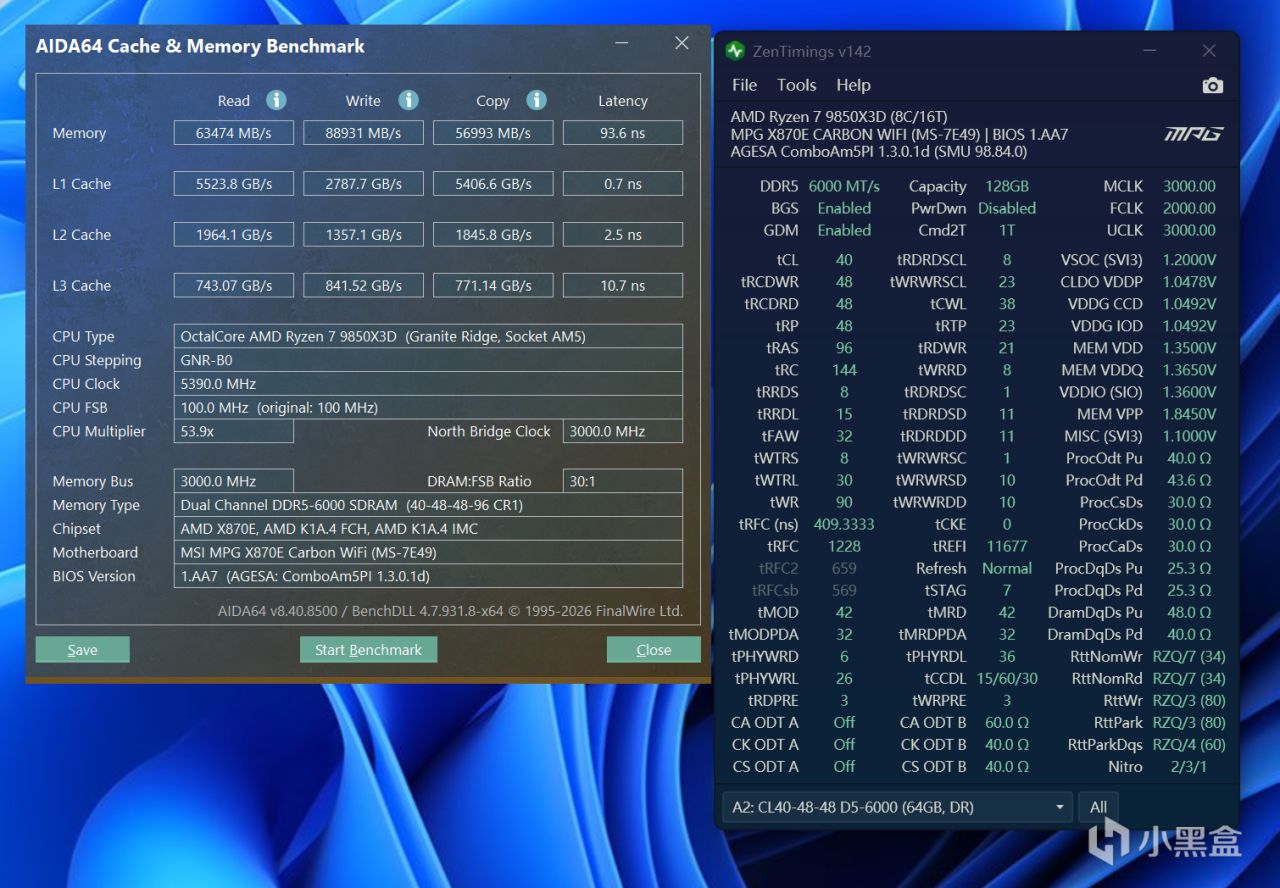
AIDA64内存和缓存测试,金邦巨蟹DDR5 6000C40 64GB*2开启EXPO配置,读取为63474 MB/s,写入为88931 MB/s,复制为56993 MB/s,内存延迟为93.6 ns。
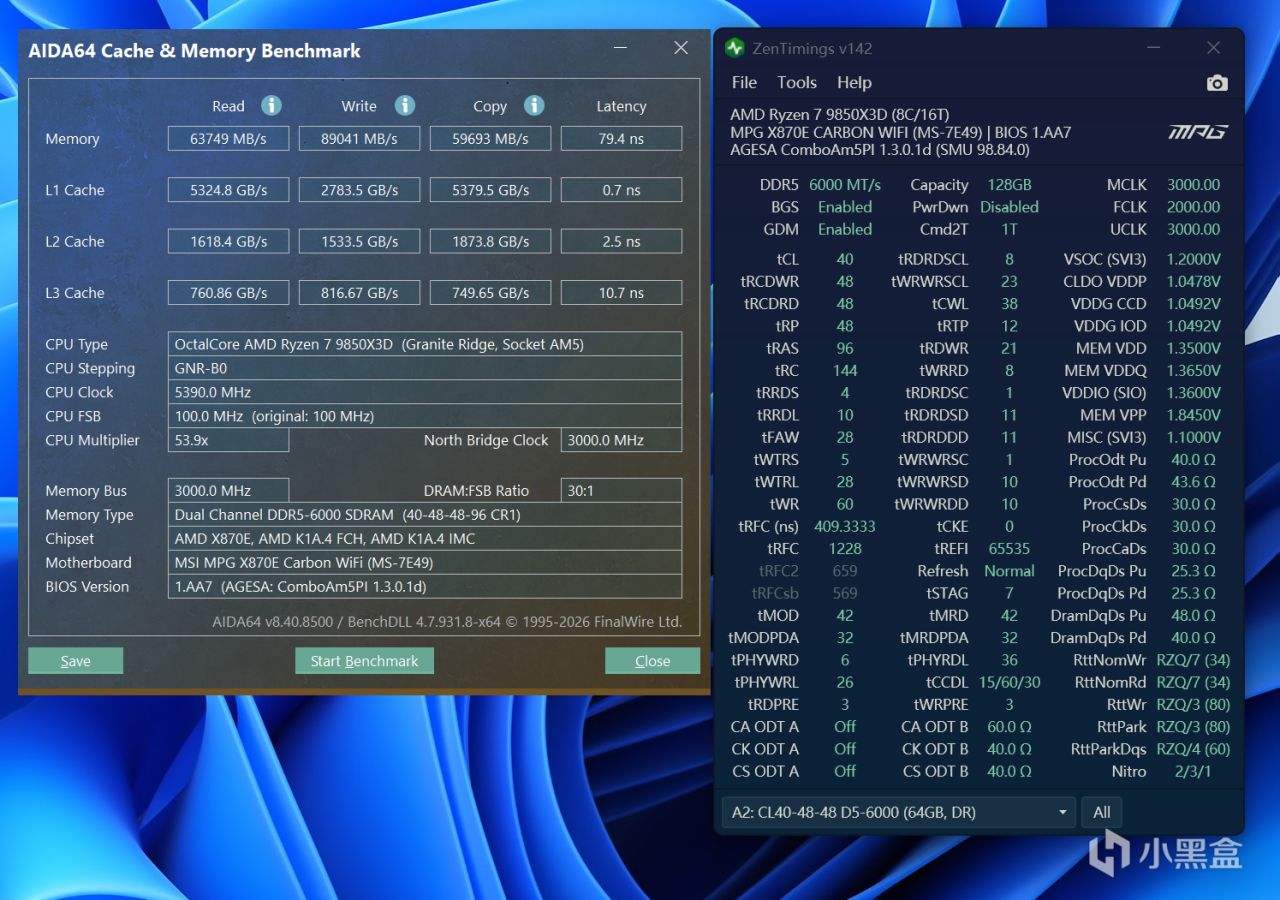
AIDA64内存和缓存测试,金邦巨蟹DDR5 6000C40 64GB*2开启EXPO配置+微星内存优化功能,读取提升至63749 MB/s,写入提升至89041 MB/s,复制提升至59693 MB/s,内存延迟大幅降至79.4 ns。
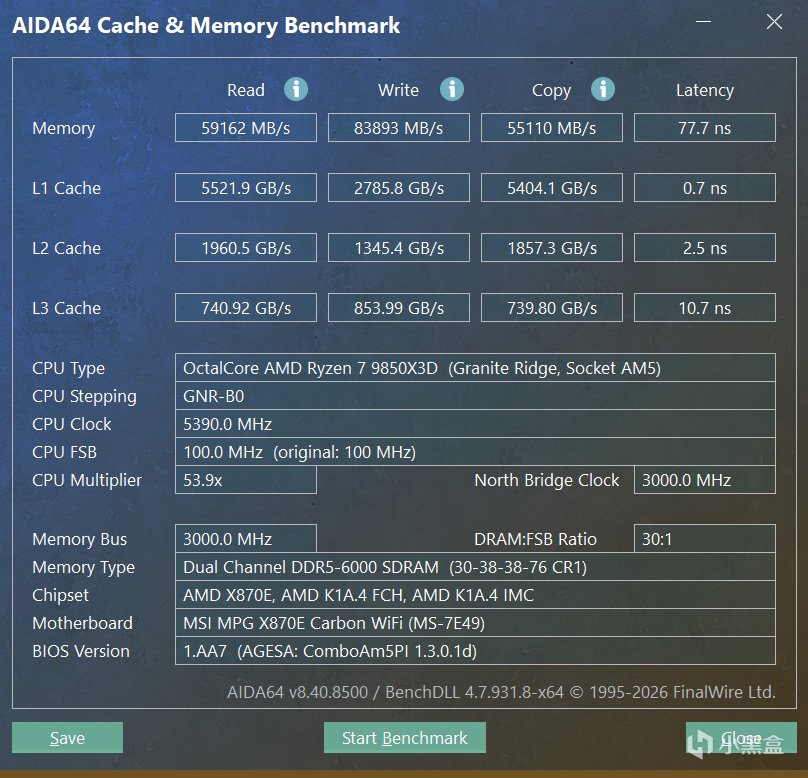
AIDA64内存和缓存测试,主流DDR5 6000C30 16GB*2内存开启EXPO配置,读取为59162 MB/s,写入为83893 MB/s,复制为55110 MB/s,内存延迟为77.7 ns。
同样都是开EXPO,6000C40时序那么松,跑分肯定不如C30,但稍微把底下的小参优化优化,差距瞬间就抹平了。最后测出来,除了延迟仅仅多出2 ns之外,其他的读取、复制等带宽性能,反而比那套C30还高了一点点。
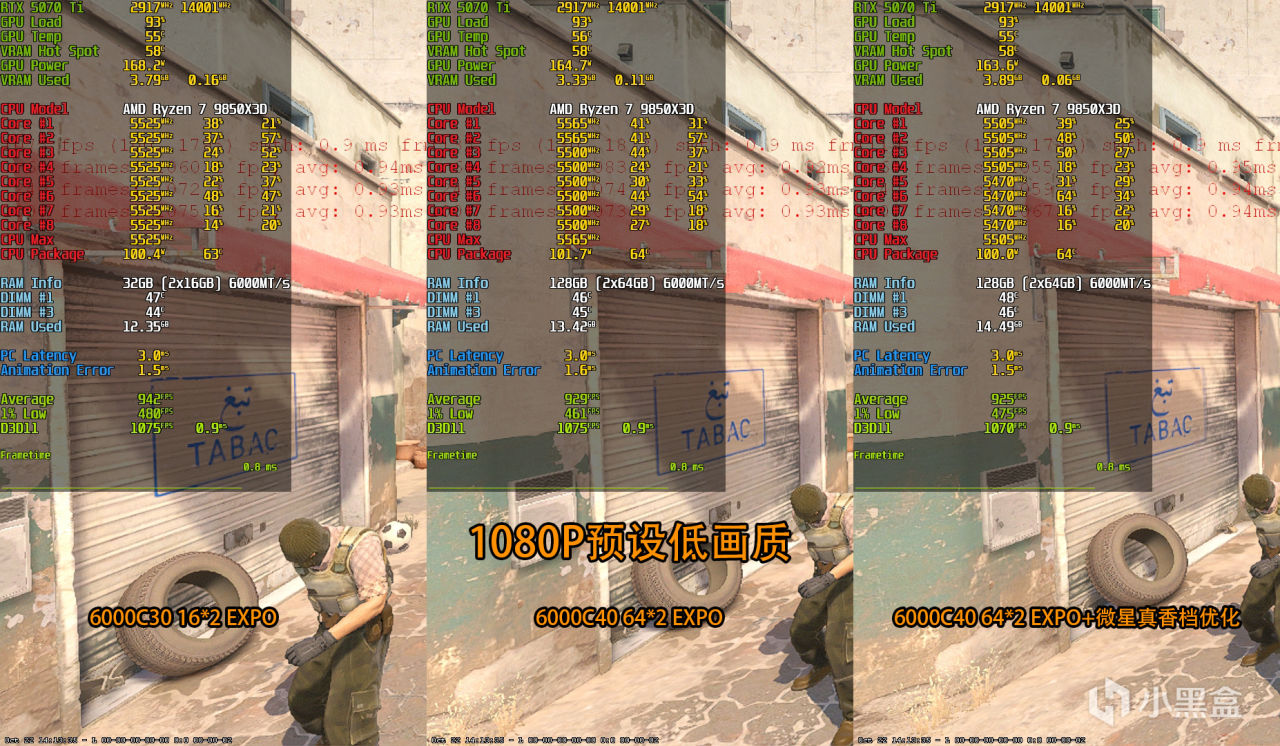
↑ 《Counter-Strike 2》游戏对比实测
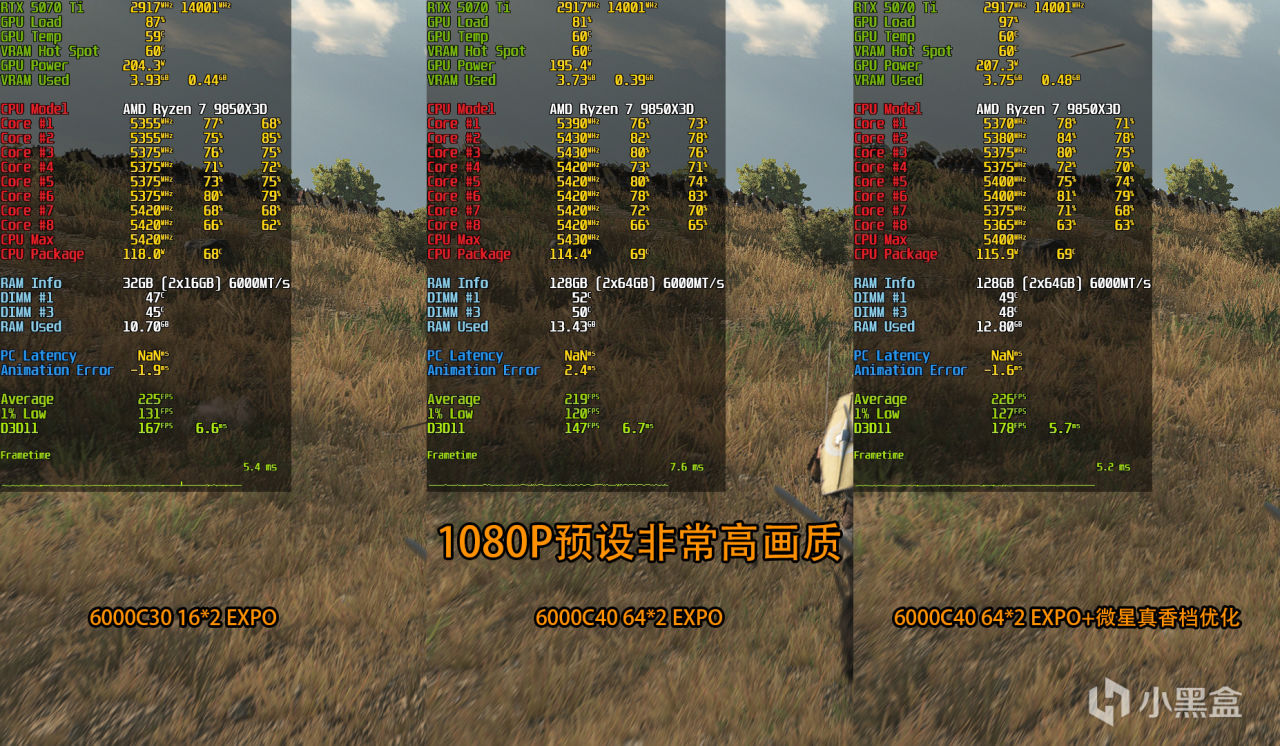
↑ 《骑马与砍杀2》游戏对比实测
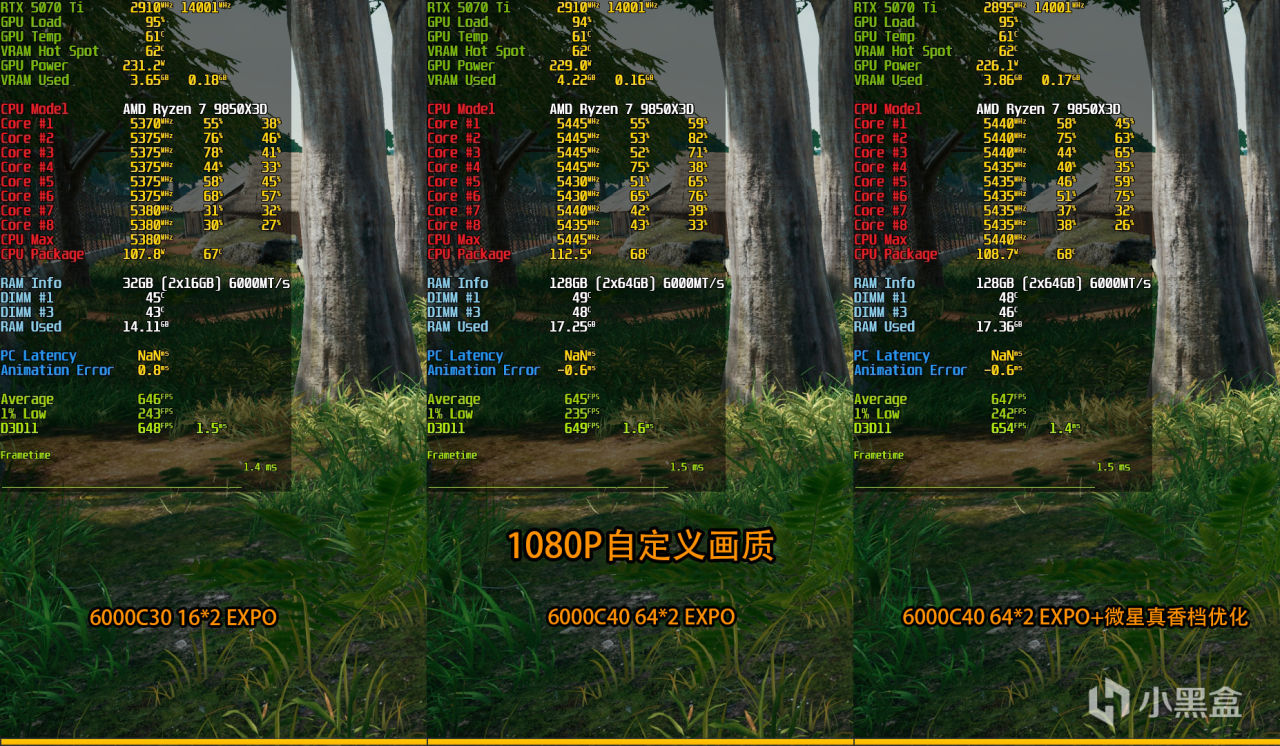
↑ 《PUBG》游戏对比实测
最后,硬核通过《Counter-Strike 2》、《骑马与砍杀2》和《PUBG》这三款对内存性能较敏感的游戏进行了实测。
从平均帧来看,32GB 6000C30确实凭借低时序占据优势,但128GB 6000C40无论是默认还是优化后,与其最大差距也不过 3%左右。
至于代表卡顿的1% LOW方面,除了在《骑马与砍杀2》中128GB C40与C30出现了约 8%的落差(开启优化后缩至3%),其他两款游戏的差距均不明显。
事实证明,有了9850X3D强大的3D V-Cache兜底,大容量双面内存的时序劣势被极大地抹平了,对于“双修党”来说,这套128G内存既能狂飙AI生产力,又不用在游戏性能上做任何妥协,真正做到了全场景通吃。
总结
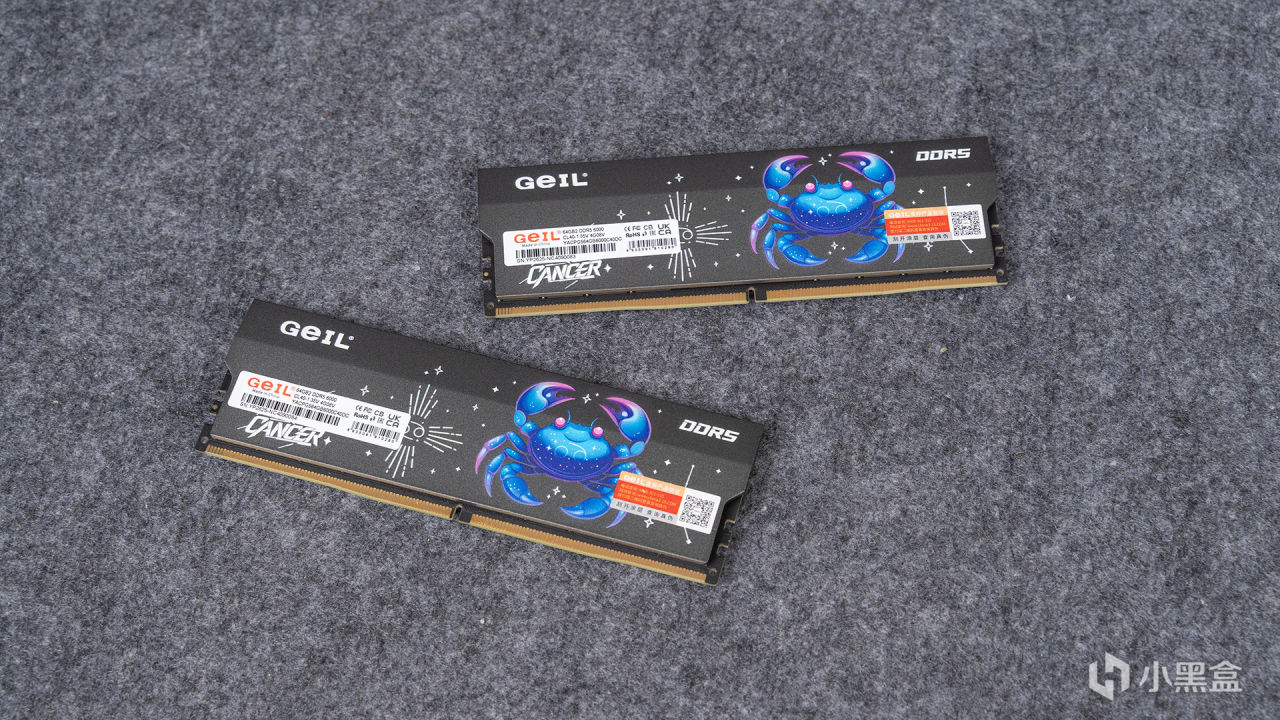
总的来说,金邦巨蟹这套DDR5 6000C40 128GB内存,就是为重度AI生产力量身打造的。
受限于本次16GB显存的显卡,在ComfyUI视频生成中,128GB内存主要解决的是“跑得稳、不卡顿、多开无压力”的底线问题,而视频生成的效果和效率上限,依然需要更大显存的专业显卡来支撑。
而在LLM大模型推理中,它是绝对的主场——面对GPT-OSS 120B这类超大规模模型,消费级游戏显卡根本塞不下,全靠内存兜底,实测拉满131072极限上下文,内存占用仅71GB,且依然保持了相当不错的推理速度。
游戏表现方面,由于搭配了X3D处理器,有它强大的缓存兜底,即便默认开启EXPO使用,大部分游戏和主流32GB 6000C30的差距也在可控范围内,如果对帧数有极致追求,只需通过主板自带的内存优化功能稍作调教,性能表现就能无限逼近同频低时序内存。
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com