刚刚过去的 9 月,手机芯片圈打完年度三连发:苹果率先掏出 A20 Pro——台积电第一颗 2 纳米手机芯片,装进 iPhone 18 Pro;
高通跟着端上骁龙 8 Elite Gen 6,联发科压上天玑 天玑 9600 Pro
每年一场,已经连续卷了十几年。
尤其是最近
回头看数字,依旧像在做梦。
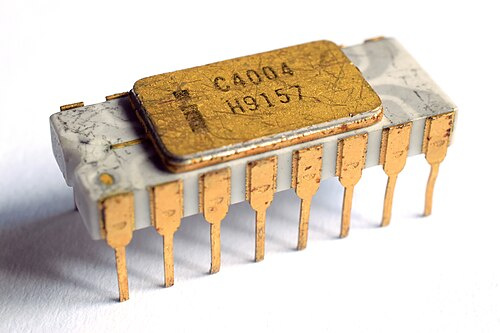
1971 年 11 月 15 日,英特尔发布世界上第一款商用微处理器 Intel 4004:
2300 个晶体管,主频 740 千赫,售价 60 美元。
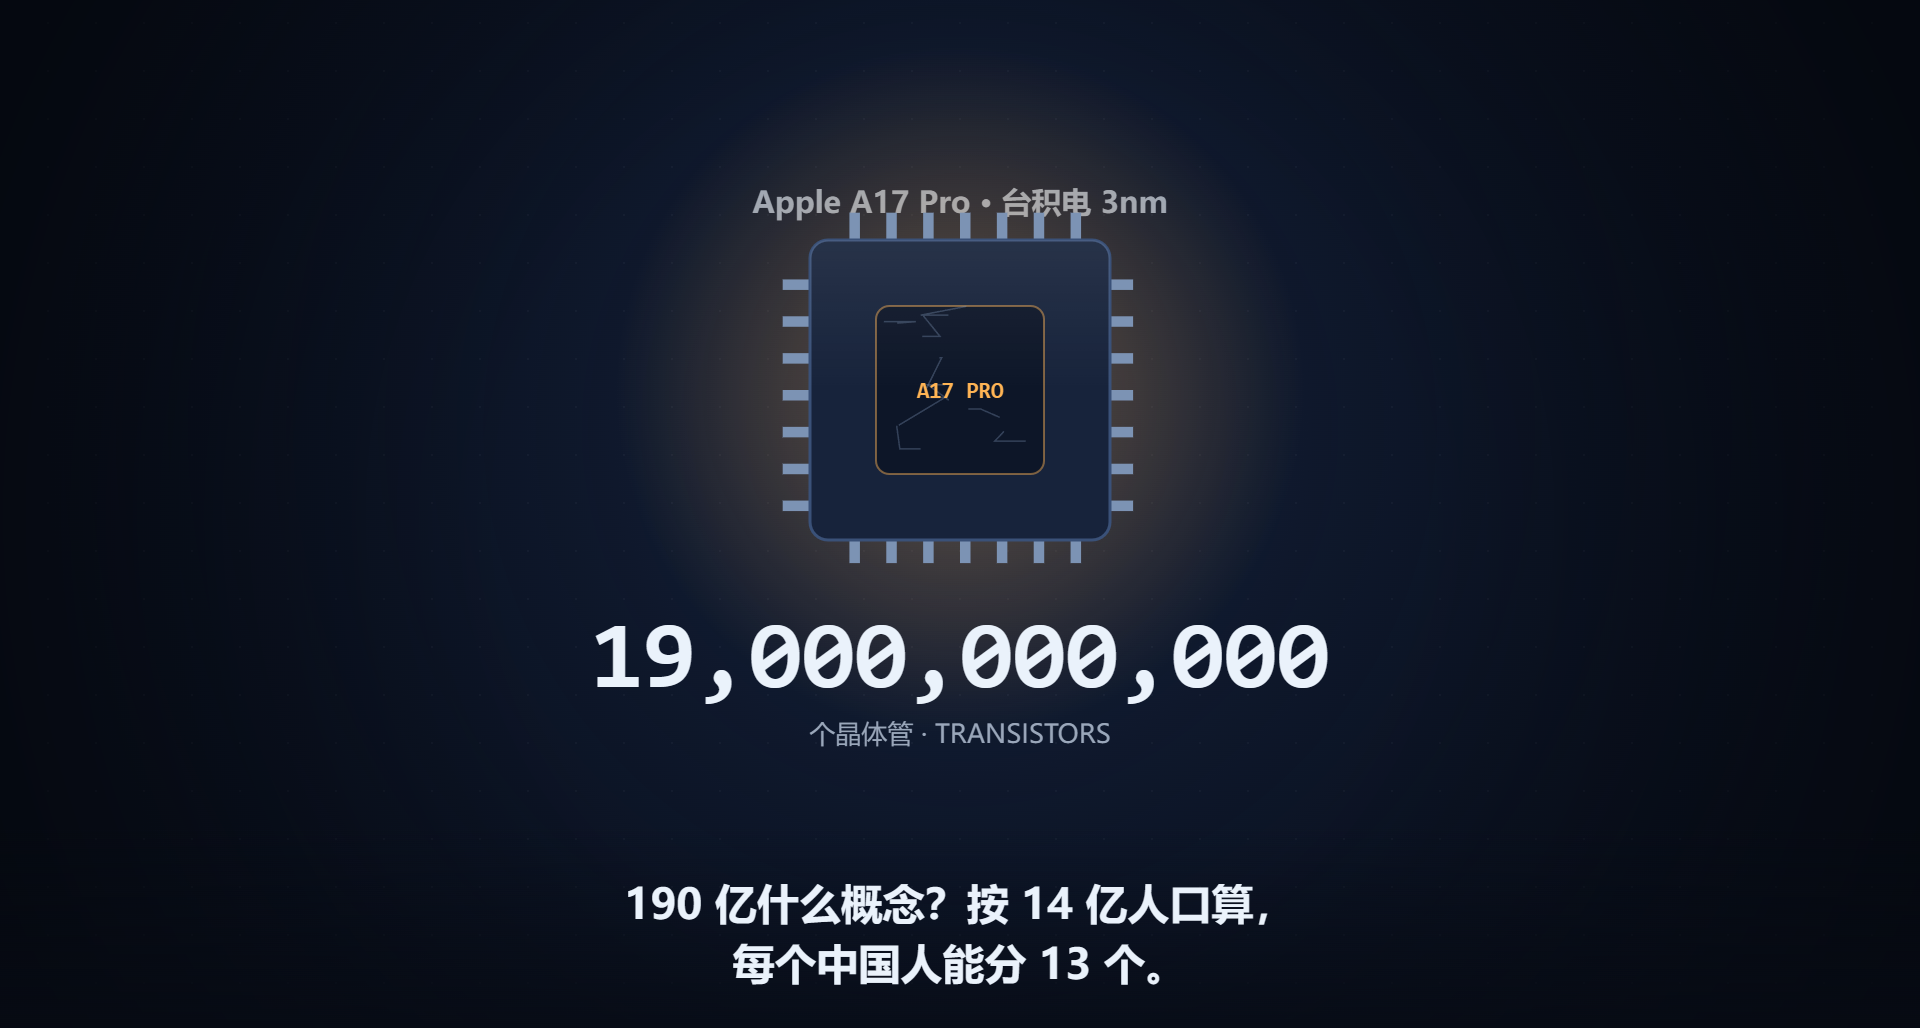
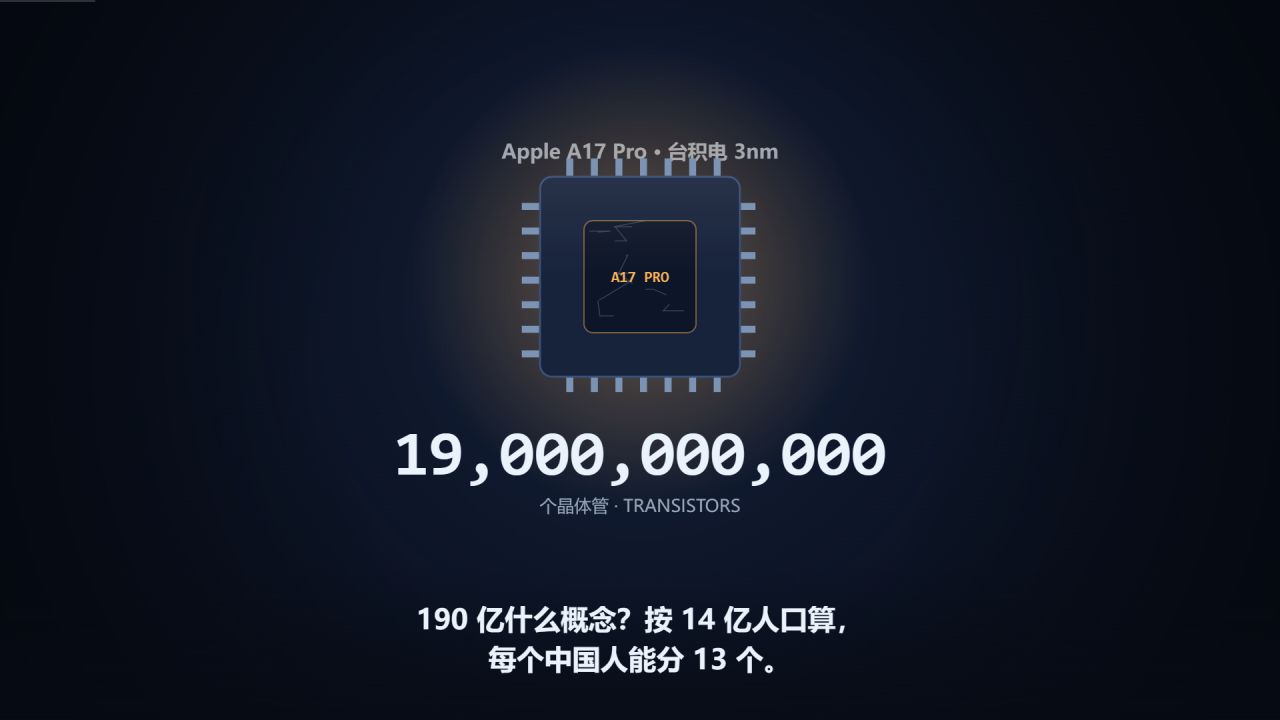
2023 年发布的苹果 A17 Pro,塞进 190 亿个晶体管;
一年后,安卓阵营的骁龙 8 Elite 把超大核主频顶到 4.32 吉赫。52 年,单颗芯片的晶体管数量涨了 800 多万倍,主频涨了 5800 多倍。
但在芯片的命名里,藏着一件多数人没细想过的怪事:
CPU、GPU、SoC 都被叫作"芯片",干的却像是三种活
它们到底谁包含谁?谁负责干活,谁负责管人?
把这三个名字讲清楚,你就能看懂手机厂商每年发布会的全部底气,也能看懂参数表上哪些数字是真金白银。
一颗芯片上挤着上百亿晶体管的微观世界,靠光刻机一层层"盖章"印出来
每一步对齐精度都以纳米计
一场塞厂运动
先说 4004。
它原本是给日本 Busicom 计算器做的定制件
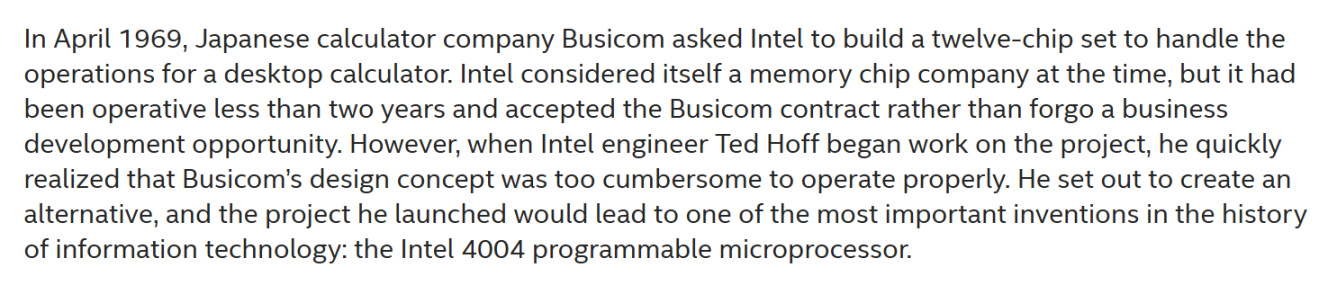
工程师把一屋子设备才能完成的计算,压成了一片指甲盖大的硅片:4 位 CPU,10 微米工艺,每秒执行约 9 万条指令。
英特尔后来买回版权对外发售,"微处理器"这个物种就此诞生。
PS:独家买回来只花了6000 美元
2300 个晶体管是什么概念?
今天一颗旗舰手机芯片的晶体管数是它的 800 多万倍。
换句话说,把 A17 Pro 缩小 826 万倍,才是 1971 年那个开创者。
芯片是怎么造出来的?
一句话:用光磨出来的
工厂先做出直径 30 厘米的圆形硅晶圆,再用紫外光把成百上千颗芯片的电路图案一层层"盖"上去,最后切开封装,才得到一颗颗芯片。
所谓 10 微米、3 纳米,说的是这道"刻痕"的精度——4004 的 10 微米,约等于一根头发丝直径的七分之一;今天的 3 纳米,只有头发丝的两万多分之一。
刻痕越小,同样面积能塞的晶体管就越多,每个开关也越省电。
这就是全行业几十年来死磕制程的全部理由——塞得下,才活得下。
从 4004 出发,整个行业干了 50 多年,本质上只做一件事:往同一片硅片里,塞进更多的东西。
52 年间,单颗芯片的晶体管数从几千个涨到上百亿个
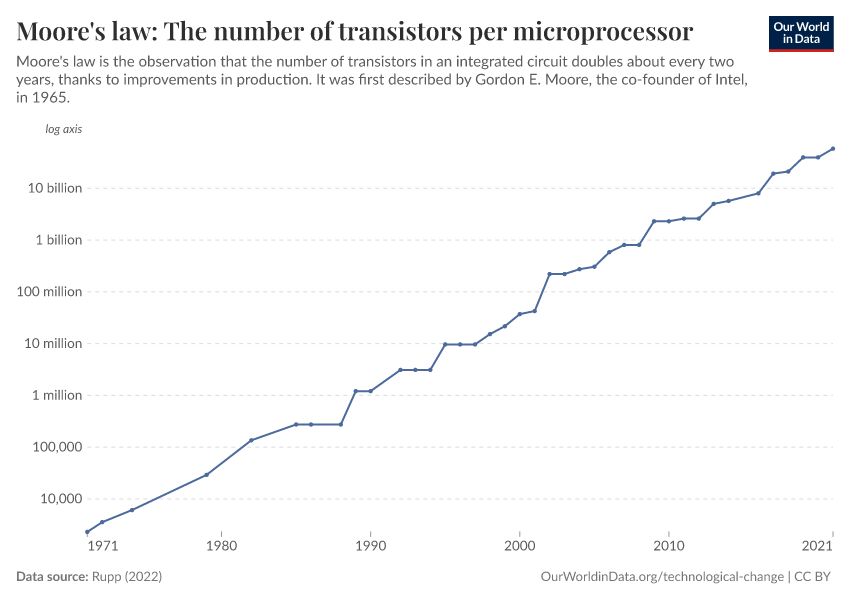
1965 年,英特尔联合创始人戈登·摩尔(Gordon Moore,1929—2023)在一篇论文里提出:集成电路上可容纳的晶体管数量,大约每两年翻一番。
这条后来被称为"摩尔定律"的经验法则
当然,摩尔定律不是物理定律,全靠企业自律。
现在的芯片制程严格意义上来讲是诈骗
50 多年里它被预言"到头"许多次,又被新材料、新结构一次次续命——就算真跑到头,塞厂运动也不会停,只是换个塞法。
就比如华为新出的τ定律
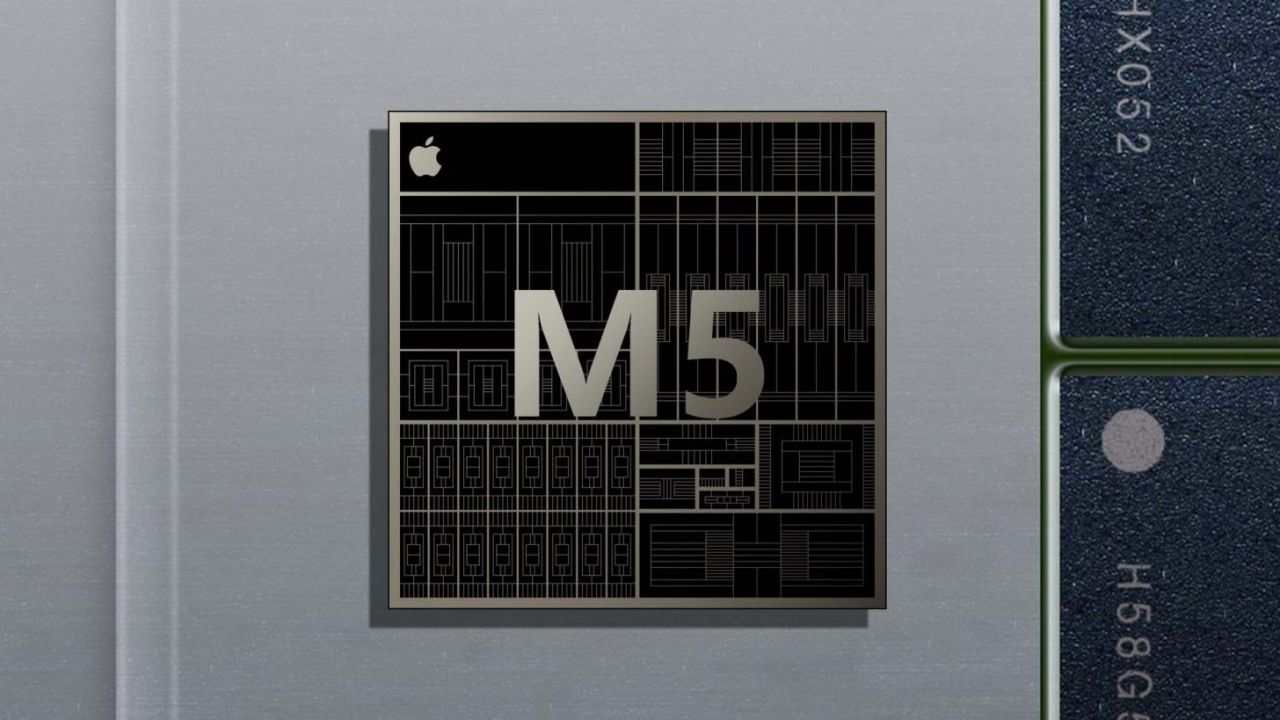
苹果M5系列芯片
芯片到底长什么样?
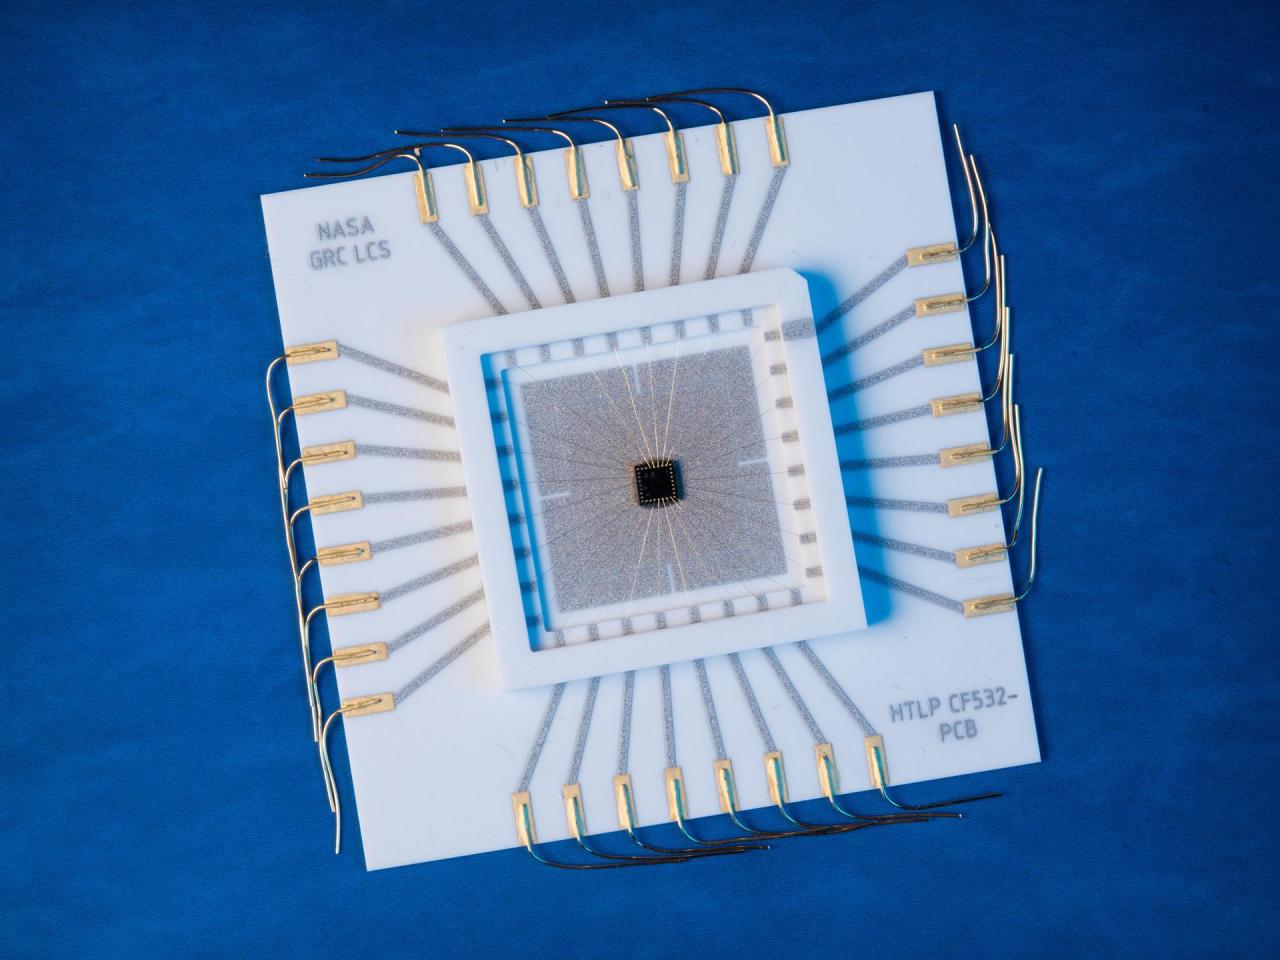
NASA 格林研究中心的这张微距照片给了个直观答案:
中央那个黑色小方块是芯片本体,几十根金线像蜘蛛网一样把它焊接到白色陶瓷基板上——所谓"芯片",就是一块被接线封起来的硅片。
NASA 研发的碳化硅耐高温集成电路,专为金星地表这类极端环境设计
中央黑色小片是芯片本体,金线负责把它接进电路
(图:NASA,Public Domain)▼
PC 时代,"塞"的思路是各自为政:
CPU 插在主板的插座上,显卡、内存、声卡各自一张卡,想升级哪个换哪个。
这也是装机党最有幸福感的年代。
但现在不是了,现在的等等党有福了
但手机没这个福气。
主板就巴掌大,电池、摄像头、屏幕全在抢地方,还要控发热、控功耗。
怎么办呢?
2010 年,苹果用收购来的 PA Semi 团队做出 A4 芯片,装进初代 iPad,随后是 iPhone 4。
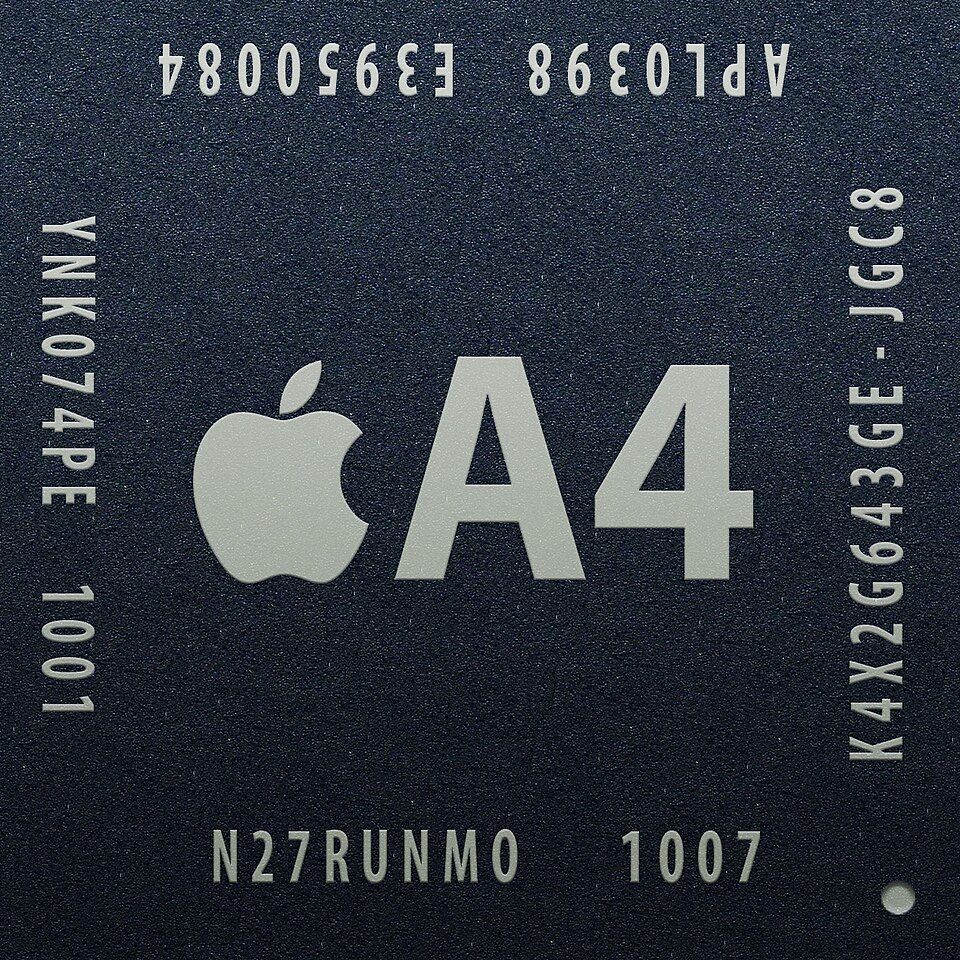
这是苹果第一颗自研片上系统:ARM 架构,1 吉赫主频,三星 45 纳米制造,CPU、图形、内存控制器打包在同一片硅片上——内存芯片还像三明治一样,直接叠在它的背上。从此"手机芯片"的形态被定了下来——不是一颗芯片,而是一整套系统。
此后十年,高通、联发科、三星全员跟进,各自的骁龙、天玑、Exynos 把"谁的模块塞得更巧"卷成了一门柯学。
2010 年那颗 A4,成了今天这场芯片军备赛真正的起跑线。
三兄弟
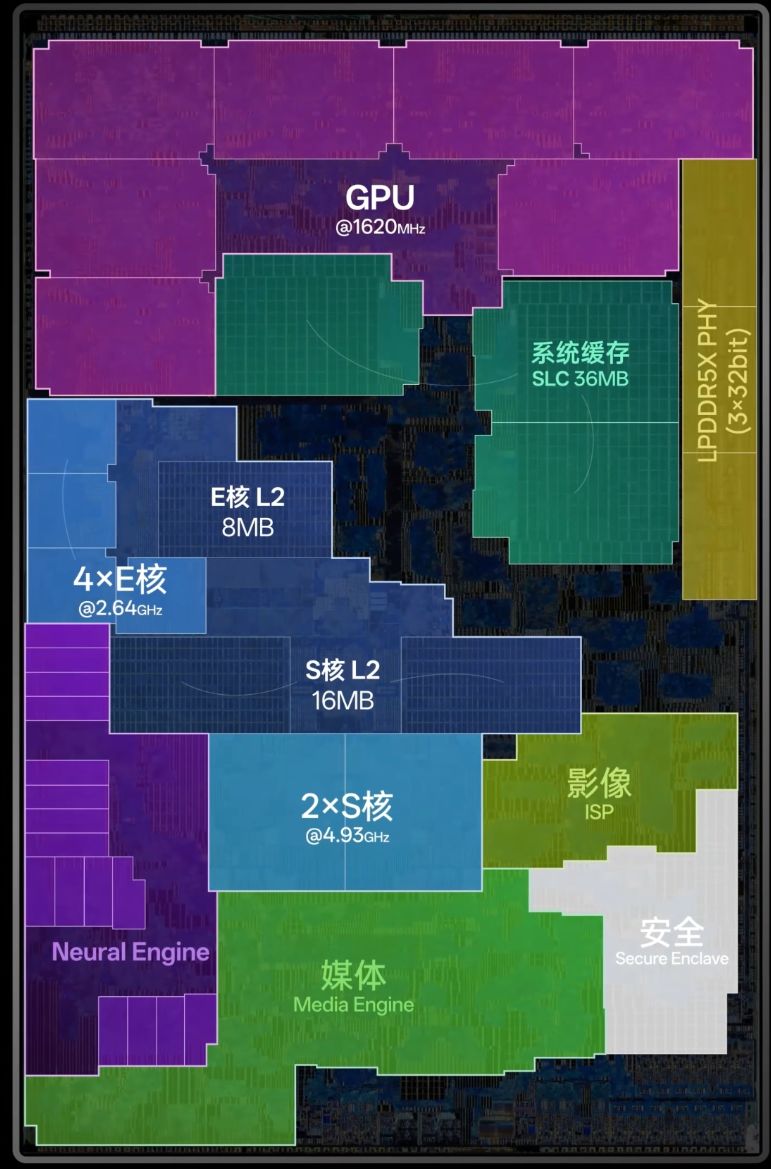
SoC 的全称是 System on a Chip,片上系统——它不是和 CPU、GPU 并排的"第四种处理器",而是把 CPU、GPU 和一整个班子统统装进去的"全家桶"。
先说 CPU,中央处理器。
它是手机里的脑子🧠:系统响应、打开 App、逻辑判断,全靠它拍板。
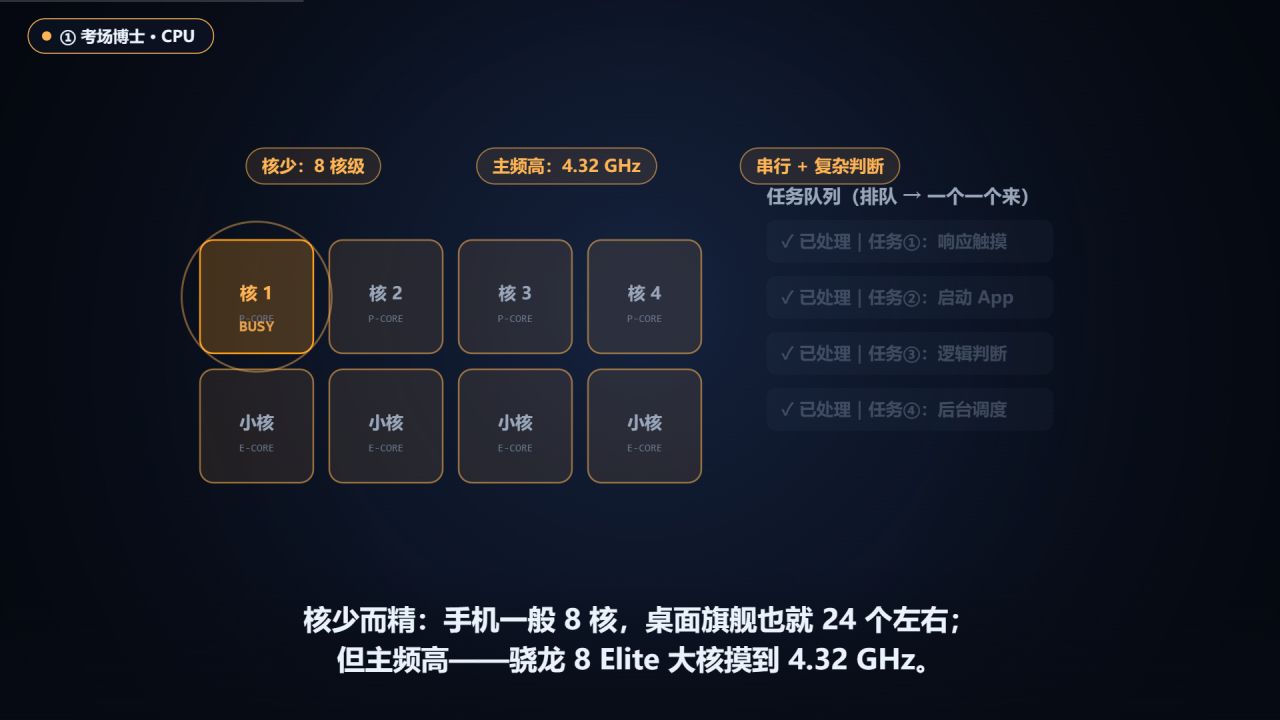
它的核心不多——手机 CPU 一般 8 核,桌面旗舰也就 24 个左右,但单核主频高。
2024 年发布的骁龙 8 Elite,超大核主频摸到 4.32 吉赫。
这是什么概念?
你每秒数 1 个数,要数上 137 年,才能数完它一秒钟的节拍。
CPU 的脾气是"深"而不是"广":一步接一步、充满"如果……那么……"的判断链,是它的主场。
像你有一张嘴,啥都能吃,但你一次只能吃一样东西
既然堆核心这么管用,CPU 为什么不学 GPU,一口气堆几千个核?
我力大飞砖不香吗
答案是划不来:核心越多,芯片面积越大、功耗越高,而大多数日常任务本来就是一条条排队的流水线,堆再多核也派不上用场。
(所以你的手机是 8 核,而不是 8000 核——不是不想,是不值。也可能是你买不起)
CPU 的干活方式:任务排队,核心一个一个处理
核少而精,主频高,擅长复杂的串行逻辑
GPU 正好是它的反面。
图形处理器的老本行是画屏幕:
1080P 一帧 200 多万个像素,60 帧就是每秒 1.2 亿个像素,还得同时算出来。
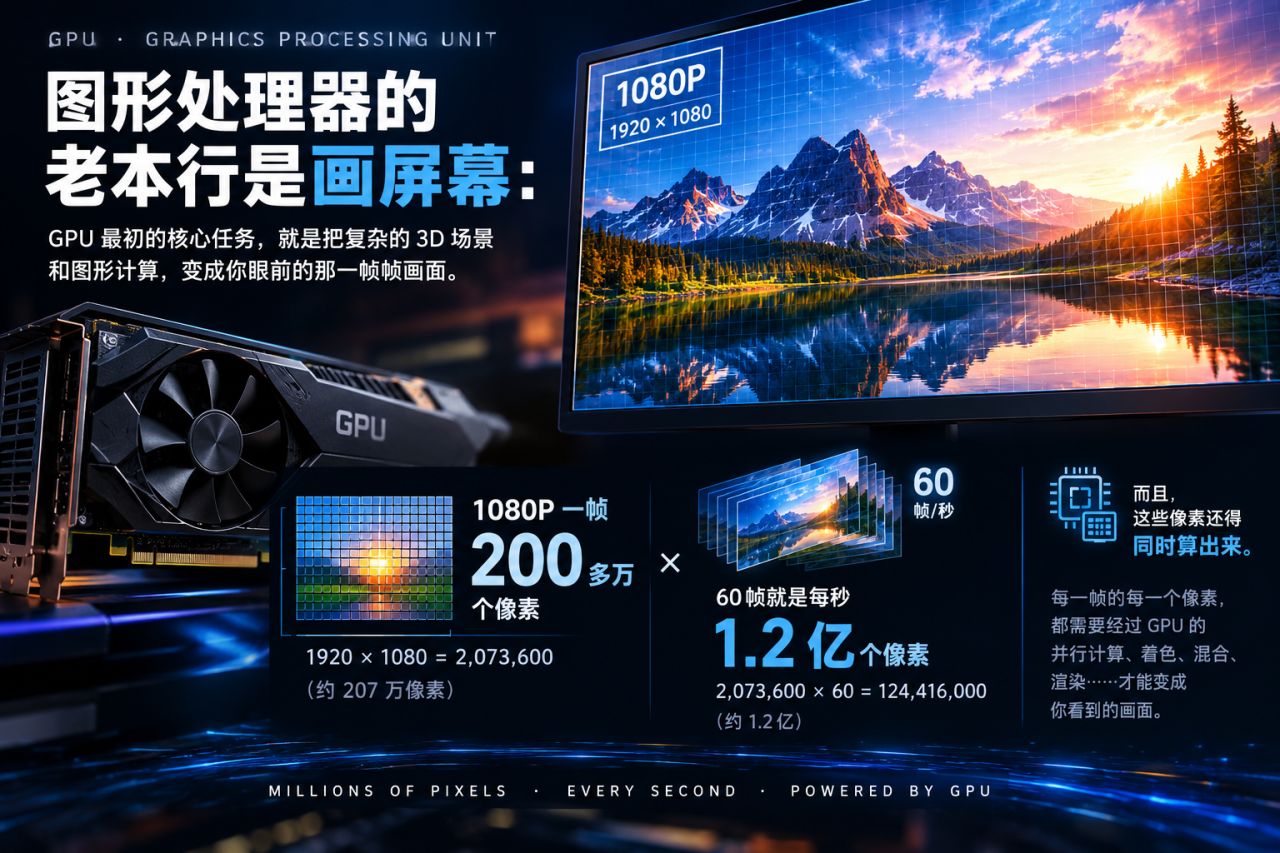
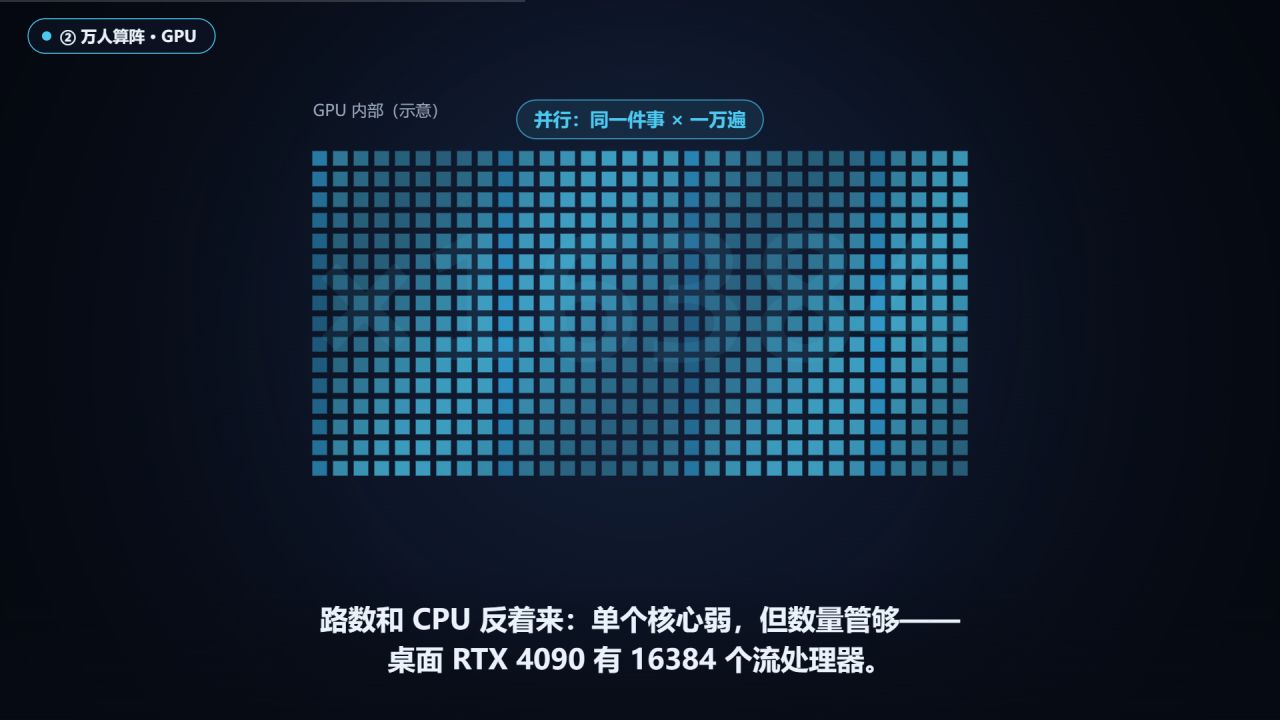
这条路数靠堆核心——桌面显卡 RTX 4090 有 16384 个流处理器,手机 GPU 也是成百上千个小核心一起上。
同一件事做一万遍,正是它的主场:
像一万个小学生同时算乘法口诀,每人一道,噼里啪啦一起交卷。画游戏、跑 AI、炼大模型,全是这种活——大模型训练本质就是天文数字的乘加运算,恰好全都长着 GPU 爱吃的样子。
这几年的 AI 狂潮里,先富起来的正是显卡厂商。
顺便说一句,GPU 这个名字问世也不算久:
1999 年,英伟达发布 GeForce 256,第一次把"GPU"写进产品名——那时它专职伺候游戏画面,谁也想不到 20 多年后,全世界的 AI 实验室都得排队买它的后代。
手机芯片里的 CPU 还有个心思:大小核。
骁龙 8 Elite 是 2 个超大核加 6 个性能核,天玑 9500 更是 1 加 4 加 4 的三簇结构——重活让大核上,刷微信、听歌这类轻活交给小核凑合,没人的时候干脆让大核睡觉。
省电这件事,确实想了很多办法
GPU 的干活方式:任务切成千上万份,核心同时开工
人多力量大,专门对付"重复"
(但让 GPU 替你决定"下一个任务干啥"?它能把决策过程画成马赛克。)
一个负责拍板,一个负责出力气,那 SoC 呢?
它是那个把大管家和苦力们安排进同一间屋子的人。
同住一屋的经济学
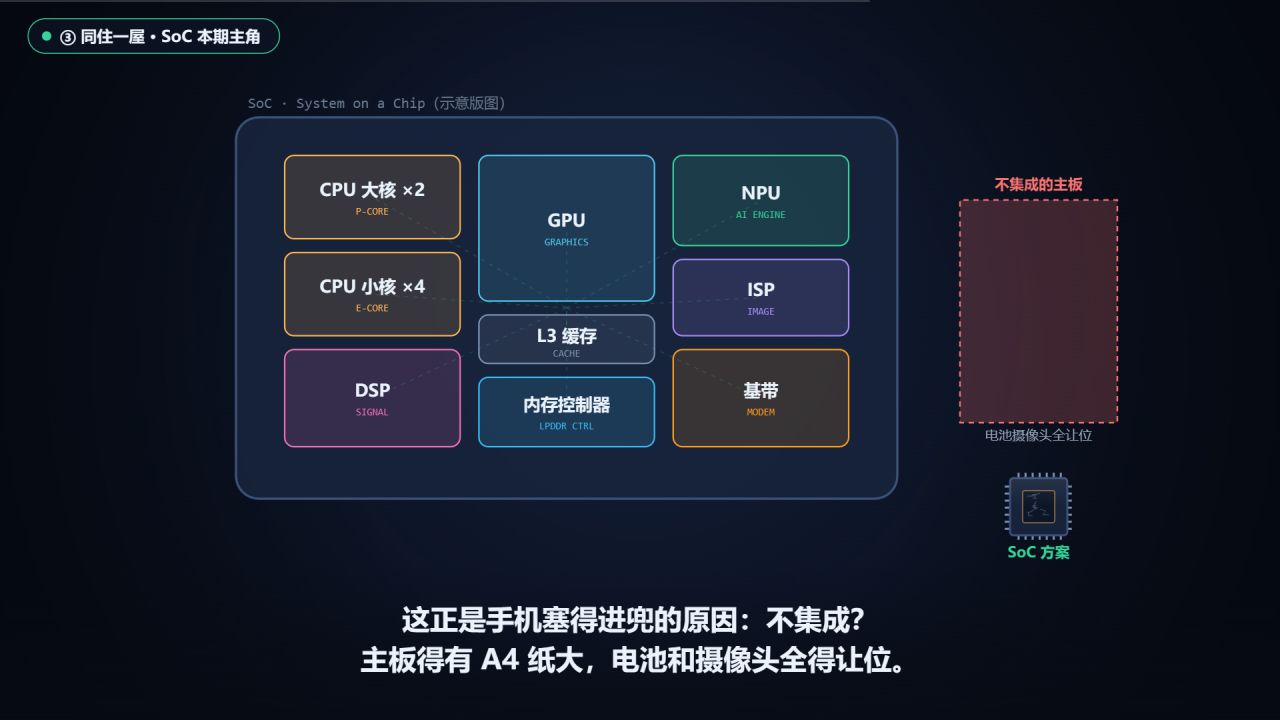
拆开一颗手机 SoC,里面挤着的远不止 CPU 和 GPU:NPU 负责跑 AI,ISP 负责相机成像,基带负责打电话上网,还有 DSP、缓存、内存控制器……一整箱专用模块,全部同住一片硅片。
主打的就是省地方
手机 SoC 的内部版图(示意)
各模块各司其职,中间靠片内互连线通信▼
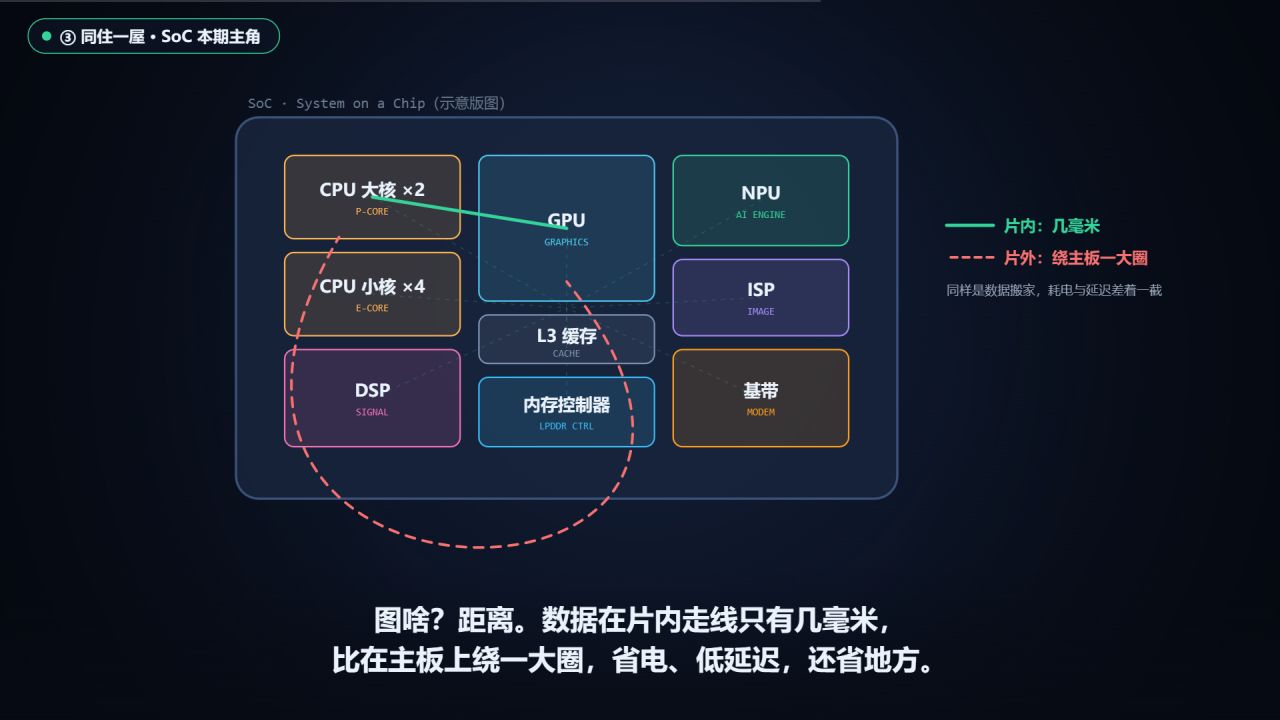
图什么?
图距离。
数据在片内走线只有几毫米,而如果各模块是独立芯片,数据就得在主板上绕一大圈。同样一次"数据搬家",片内直连省电得多、延迟低得多,还省地方。
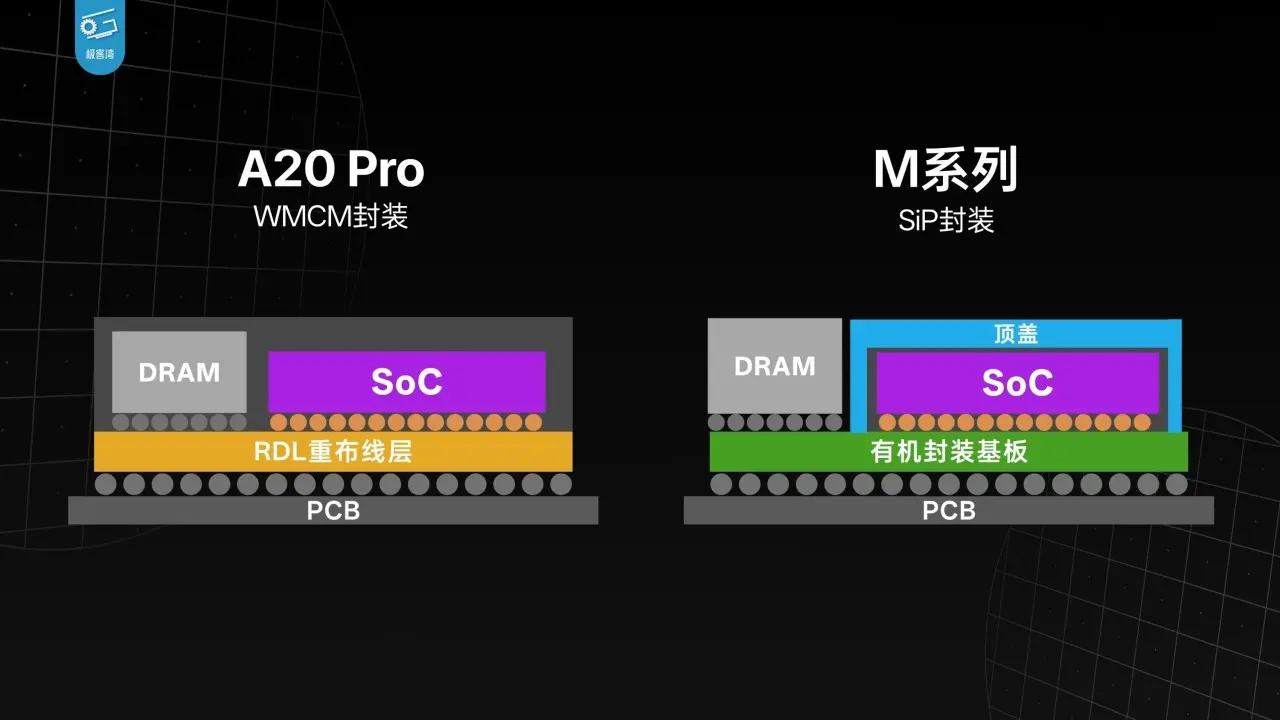
片内直连和片外绕圈,差的不只是距离
是每一毫安时电池的去向▼
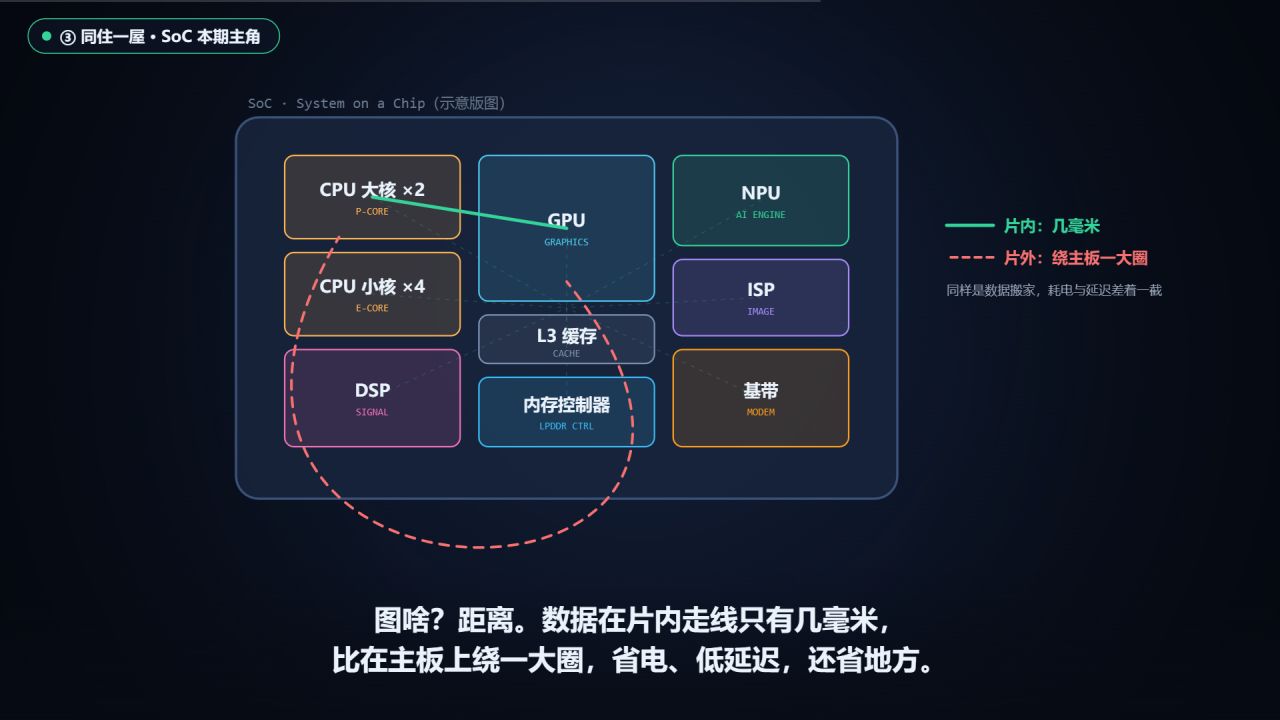
这直接决定了手机的形态。
要是像 PC 那样分芯片各自为政,主板得有 A4 纸大——电池和摄像头全得让位,你的手机就得变成对讲机。
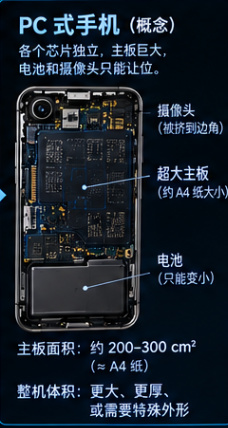
不集成的主板和 SoC 方案,占用空间差着量级
手机塞得进兜,靠的就是这份"抠"
集成还带来分工红利。缓存好比给每个核心配的小冰箱,常用的食材放在手边,不必每次都跑楼下超市;
数据:请照顾老年人
ISP 专管夜景成片,NPU 专管 AI 抠图,CPU 专心调度——专属硬件干专属的活,比"啥都让 CPU 干"省电得多。
CPU:终于能歇着了
神经网络运算拆到最底层,就是亿万年方不断的乘法和加法,CPU 的通用电路干这个又贵又慢,NPU 干脆把乘加单元排成阵列,一次吞吐一片数据——能效比通用核心高出一大截。
你手机里的人脸解锁、照片搜索、实时翻译都是靠它
2025 年,先进制程(7 纳米及以内)芯片已经占到全球手机处理器出货的 51%——每卖出两颗手机芯片,就有一颗是"超级全家桶"。
这也是为什么同样一块电池,有人能亮屏一整天,有人下午三点就得找充电宝:芯片的能效,就是手机的命。
不过,有一件东西常年不住在这间屋子里——基带。
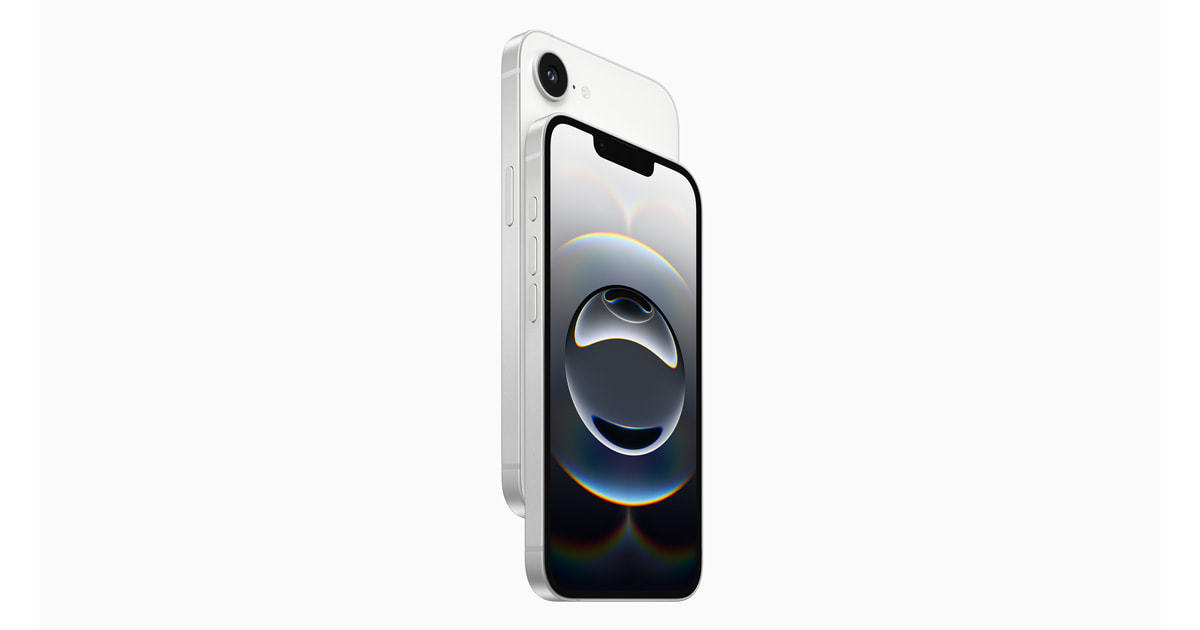
iPhone 用了十几年外挂高通、英特尔基带,直到 2025 年 2 月的 iPhone 16e,苹果才拿出第一颗自研基带 C1。
按苹果官方说法,C1 是 iPhone 上能效最好的基带,而它至今仍是一颗独立芯片,没有塞进 A 系列主芯片里。
首发自研 C1 基带的 iPhone 16e
苹果向"整机自研"又挪了一步,但基带仍独立于主芯片
然后到现在有的型号其实还在用高通基带
基带难自研是业内共识:
它要在全球各种网络制式、频段、信号强度下都稳定工作,想要玩转费用惊人
苹果为补这一课,2019 年花约 10 亿美元买下英特尔的基带业务,磨了六年才交卷。
(全屋定制再豪横,也有一间屋子给别人)
2020 年 11 月苹果把同一条思路搬回电脑:
M1 芯片 5 纳米工艺、160 亿个晶体管,CPU、GPU、神经网络引擎共享同一块内存池,数据不必在芯片之间来回拷贝。
这套在手机上练了十年的功夫一出手,MacBook Air 的续航肉眼可见地拉长,Mac 从此换了一副骨头。
M1:手机思路反攻电脑的起点
当然,全家桶也有全家桶的代价:模块全焊死在一颗芯片上,谁也别想单独升级——手机不能换显卡,坏了只能整修。
集成度高到这个份上,"修"这个字就快从字典里划掉了。
金子内存
纳米尽头,还在卷
2025 年 9 月的那轮旗舰对决,已经把参数顶到高位:
骁龙 8 Elite Gen 5 的超大核主频爬到 4.6 吉赫,天玑 9500 同样押注 3 纳米。
而 2026 年 9 月,苹果的 A20 Pro 干脆把手机芯片带进 2 纳米:
台积电的 N2 工艺早在 2025 年四季度按计划量产,这是台积电第一个量产的环绕栅极(GAA)晶体管节点,据报道苹果包下了初期产能的一半以上——第一颗吃上 2 纳米的 A20 Pro 已经开卖,M6 也在路上。
Counterpoint 的季度统计,全球手机处理器出货里,联发科常年占三到四成,高通约三成,苹果约一两成——但在 600 美元以上的高端盘子,苹果一家就拿走 46%,高通 35%,联发科只剩 12%。走量
制程每往前走一步,晶圆就更贵一截——据报道,一片 2 纳米晶圆要卖到 3 万美元,比一部顶配 iPhone 还贵;据业内估算,设计一款 3 纳米旗舰芯片要烧掉数亿美元
发布会的话术也跟着换了几代:十年前比"几核"
五年前比"几纳米",这两年比"几 TOPS"——AI 时代,NPU 算力成了新的身份符号。
参数换了三代,比拼的内核一直没变:同样的大小,谁干的活多;同样的活,谁耗的电少。
话说有人最近换手机了吗
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com