不是商单,可以放心看
-
WHAT'S UP!欢迎来到和微论件!
兄弟们最近上网应该经常听到codex(略微有点古早)deepseekharness(DSH)或者workbuddy这类词语,或者skill RAG LORA这些词汇,如果么有的话,那该去补课啦,这些东西正在快速重塑我们的生活
自从GPT这枚核弹问世以来,大家以前查百度的习惯估计已经换成去问豆包这类LLM模型了,这类模型的缺点就是只能告诉你怎么做,但不能真的帮你去做,并且偶尔会有流口水现象,像是一个不太稳定的搜索引擎
而现在随着AI agent的问世,已经演变成可以自己操作电脑,给自己装插件的智能体,不需要懂代码,只要对着他“许愿”,他就能给你干活(当然,首先你要有Token),从这个迭代速度还是很快的,也许我们真的离AGI不远了
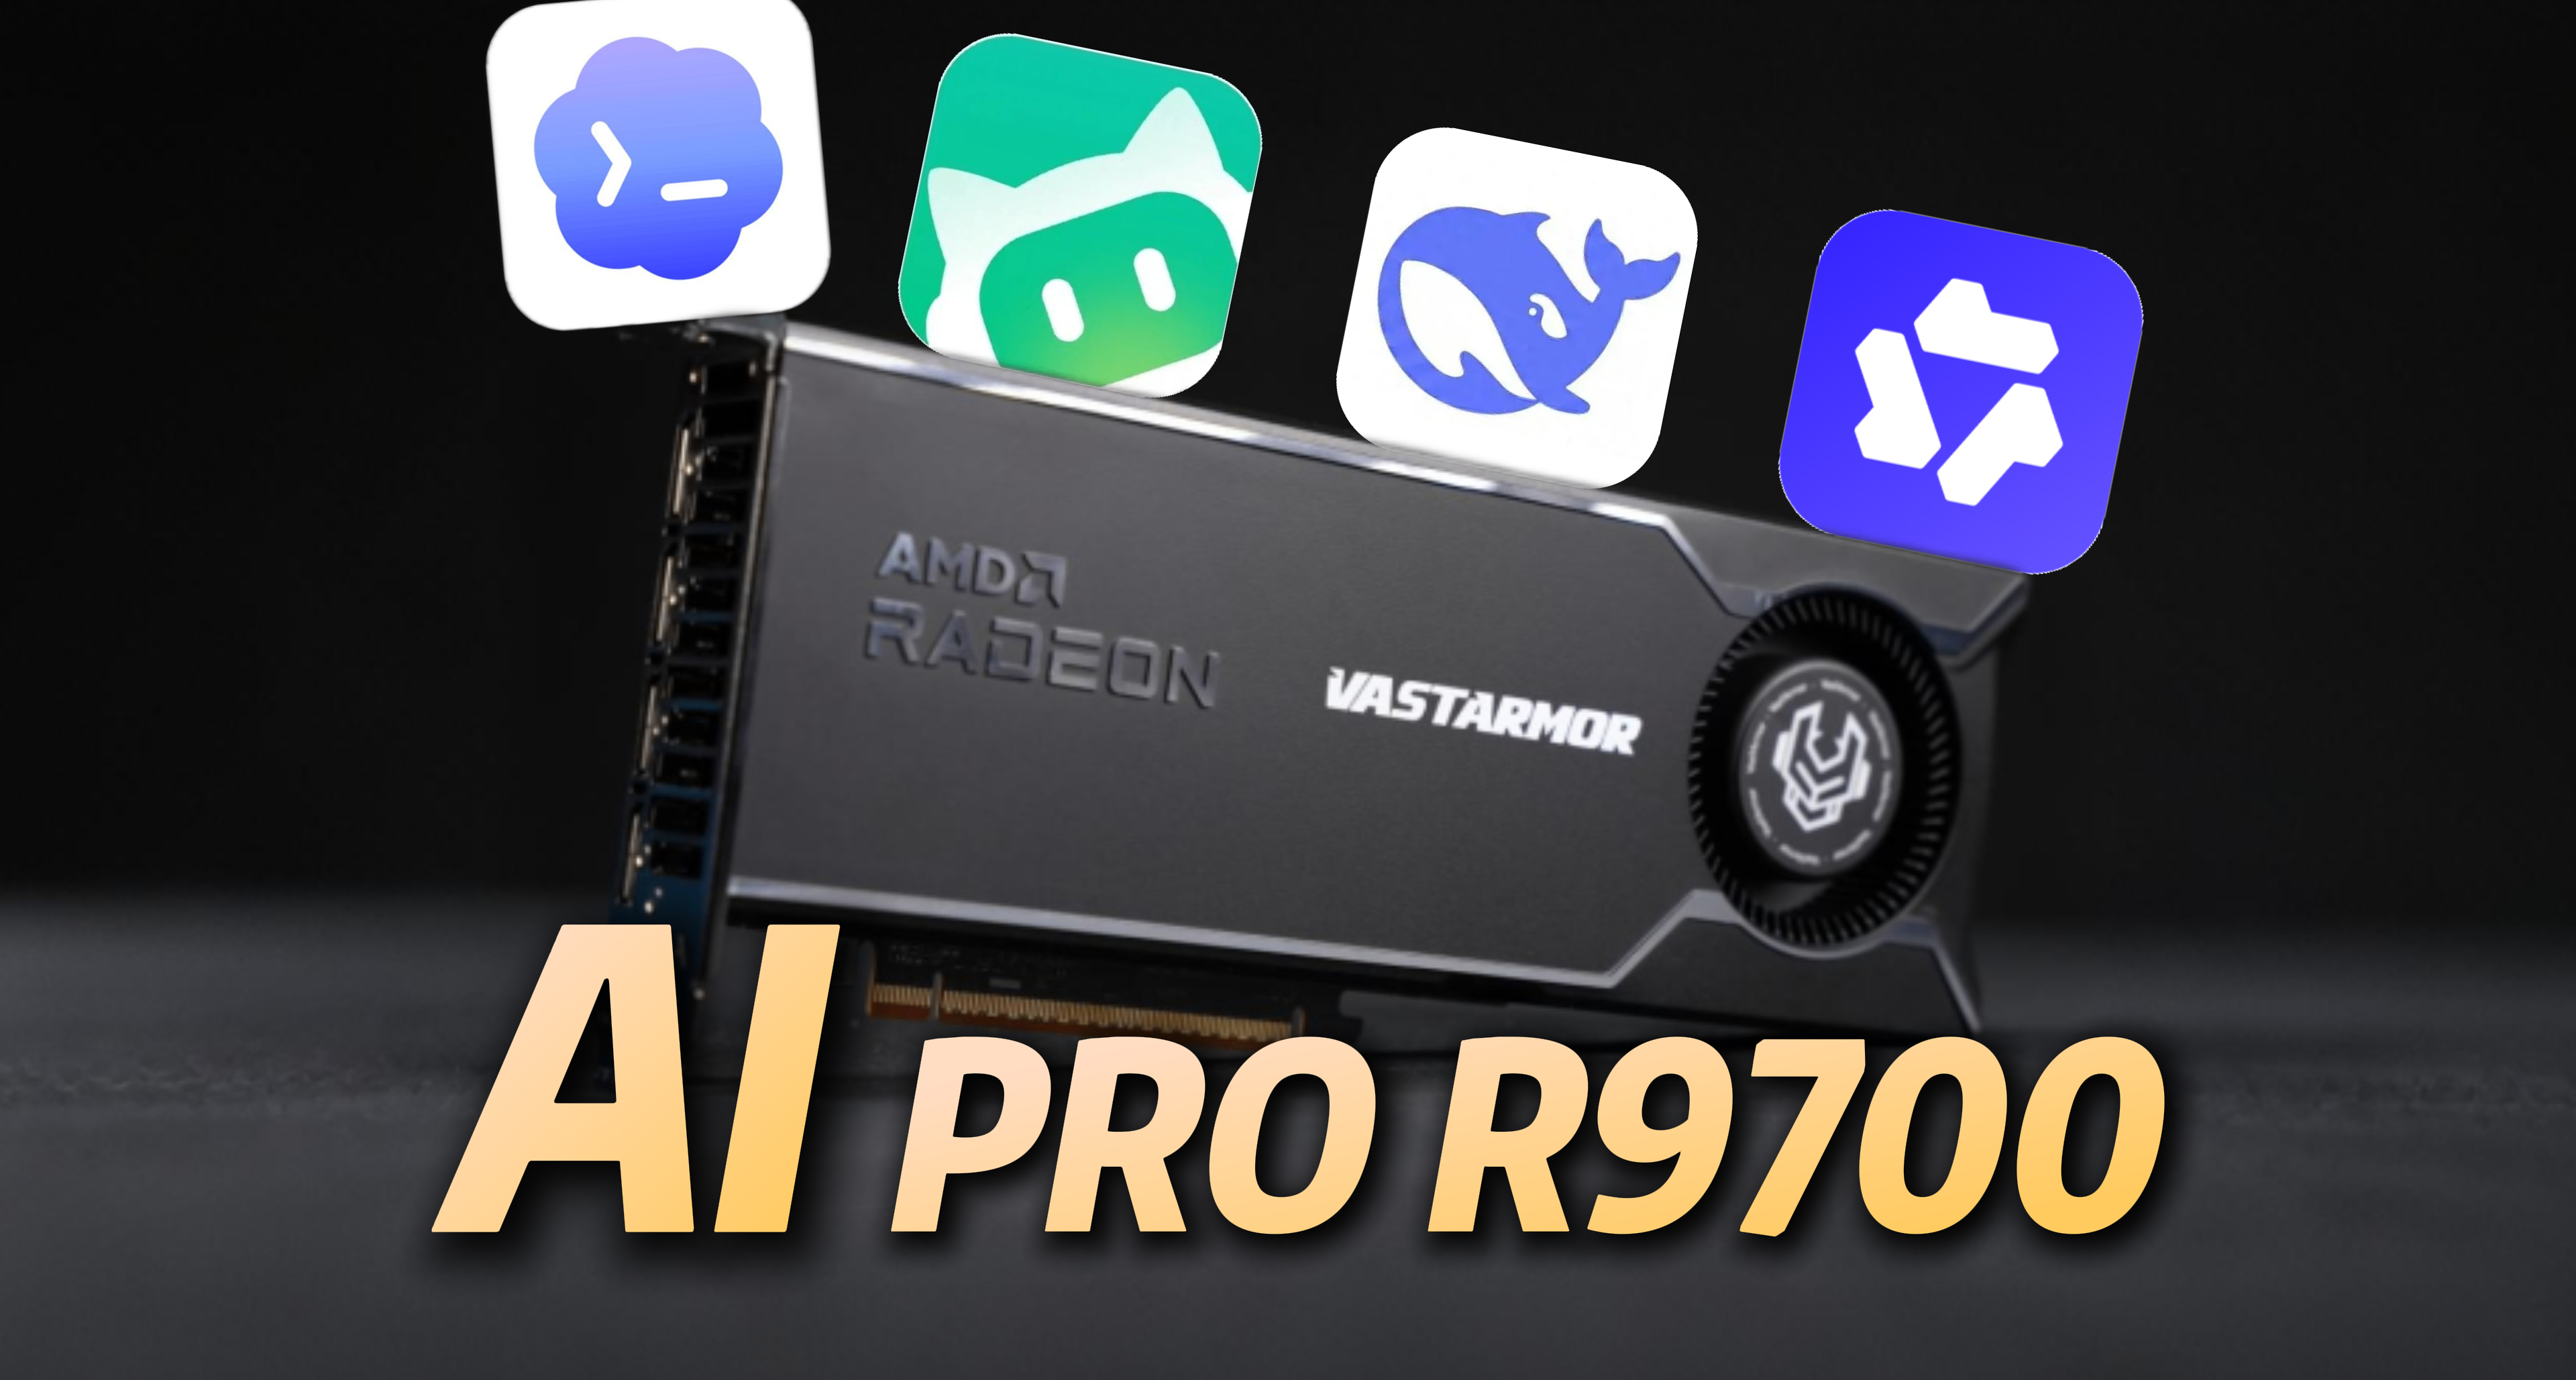
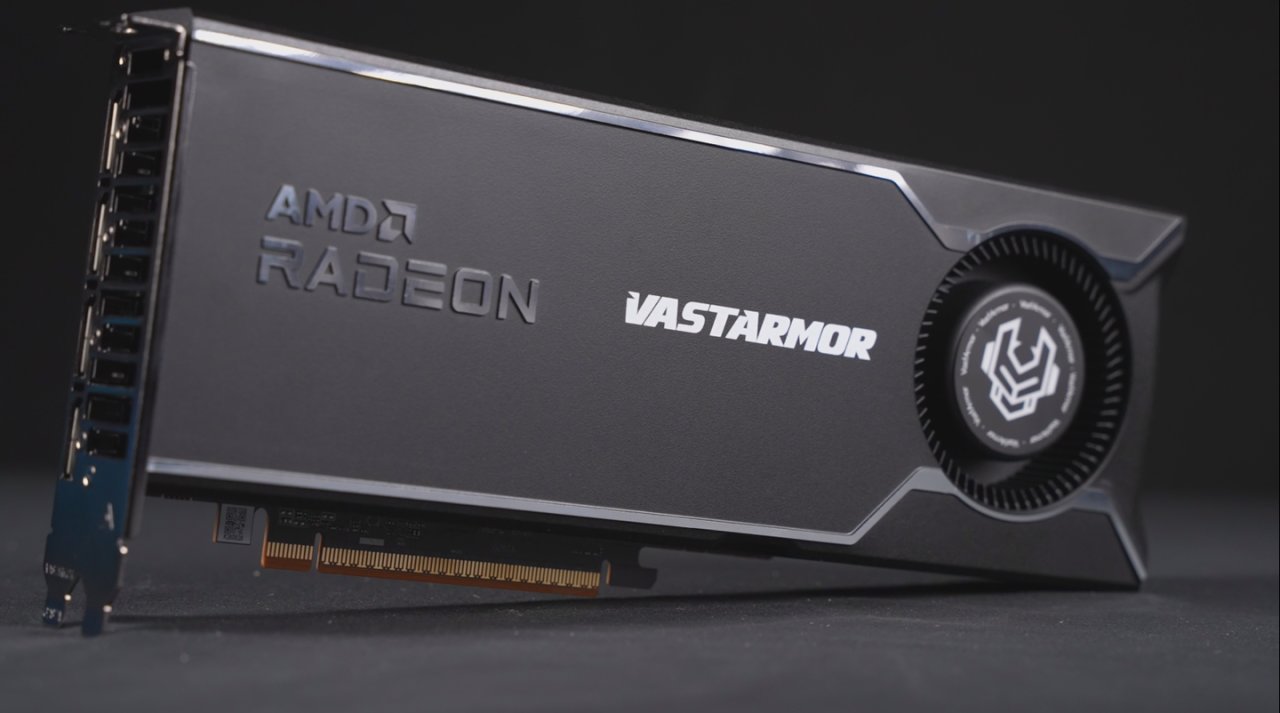
既然token是需要花钱的,也不可能真的去买十张H200本地跑AI,那有没有那种家用级的,可以装智力不错的模型的,成本不要太贵,比充API划算的显卡呢,有的,他就是今天的主角——瀚铠AI PRO R9700
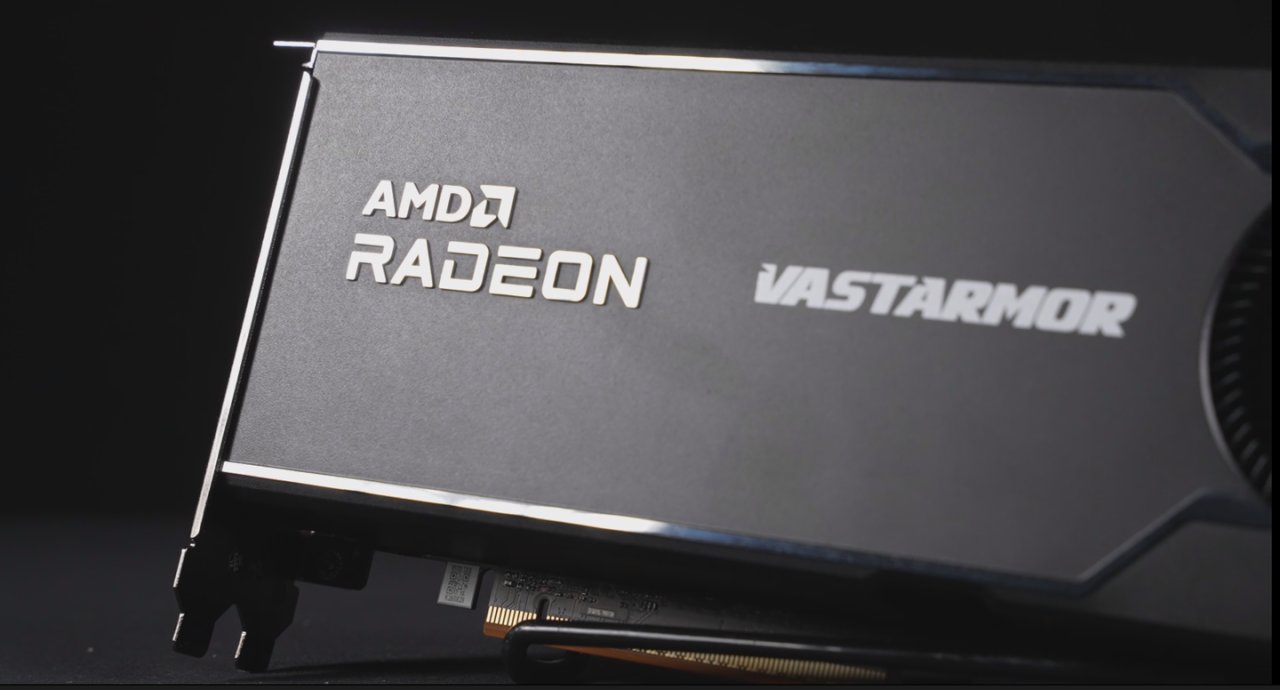
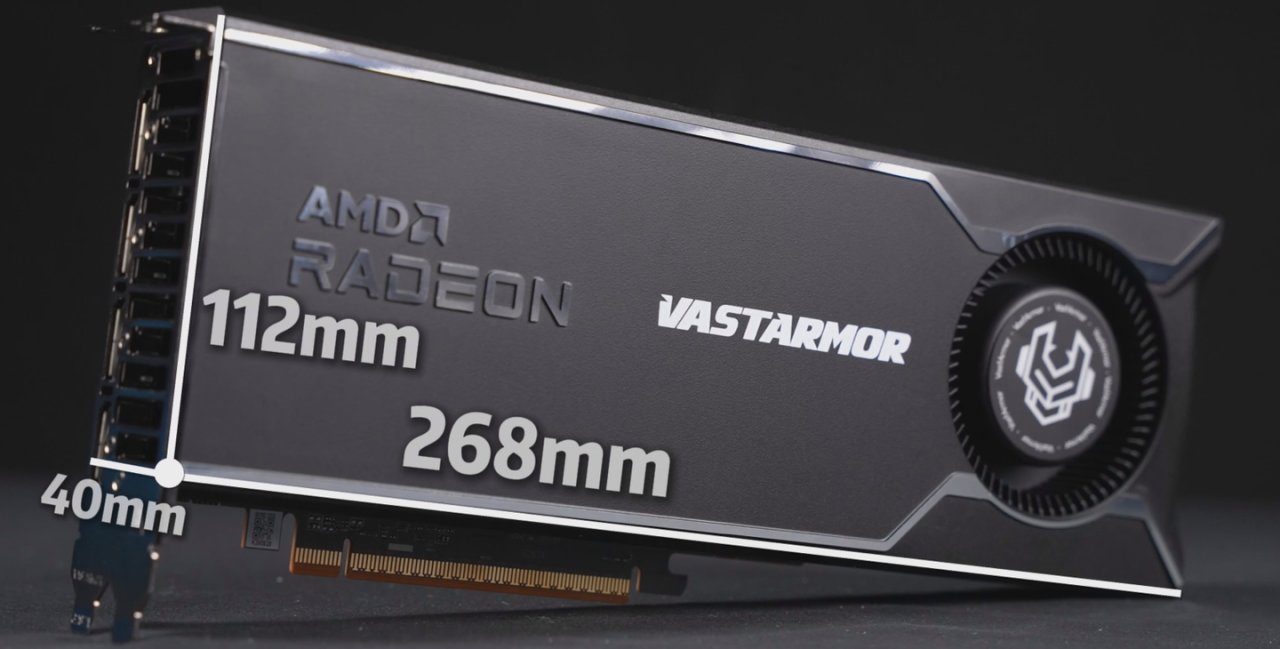
先看一眼外观,一眼看上去,就如同一眼上去一样,它是一张涡轮卡,比较适合多卡工况,268 × 112 × 40mm的小巧尺寸,双槽厚度,没有花里胡哨的装饰,整体外观可以用“朴素”来形容
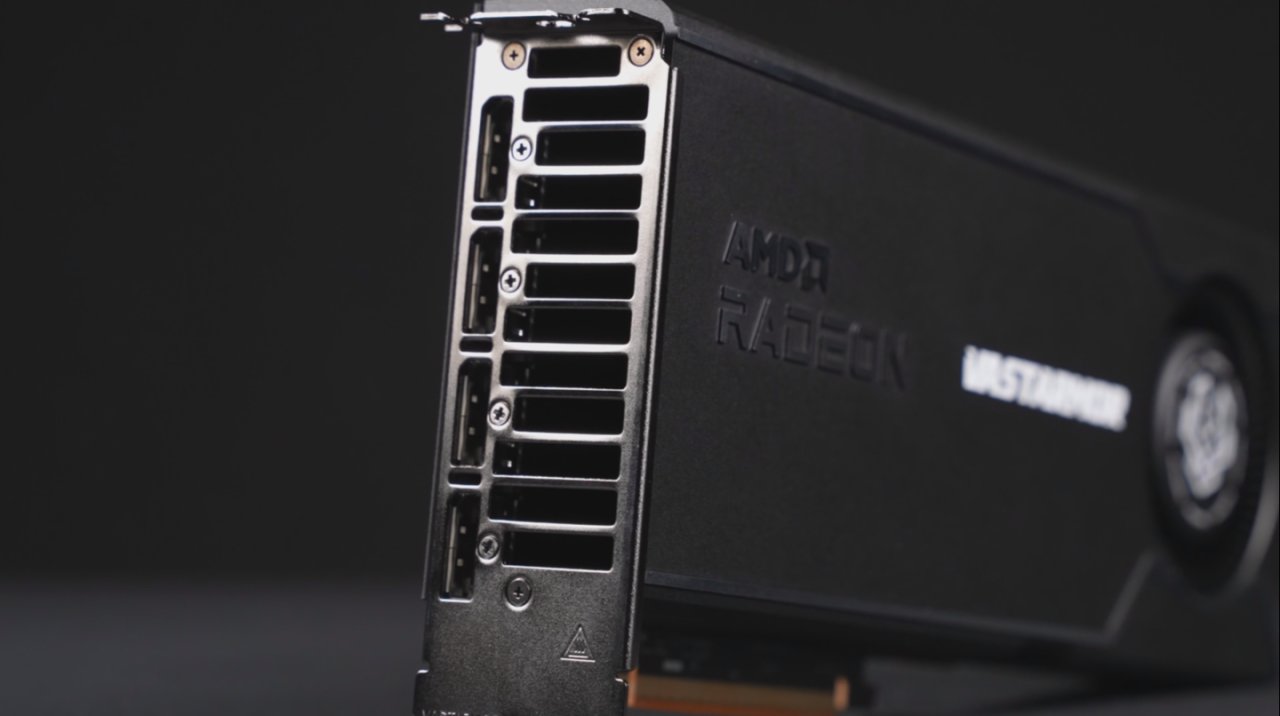
供电接口为16PIN,输出接口为4个DP口,没有HDMI。这也符合工作站定位,多屏输出和专业显示设备使用DP接口会更常见一些
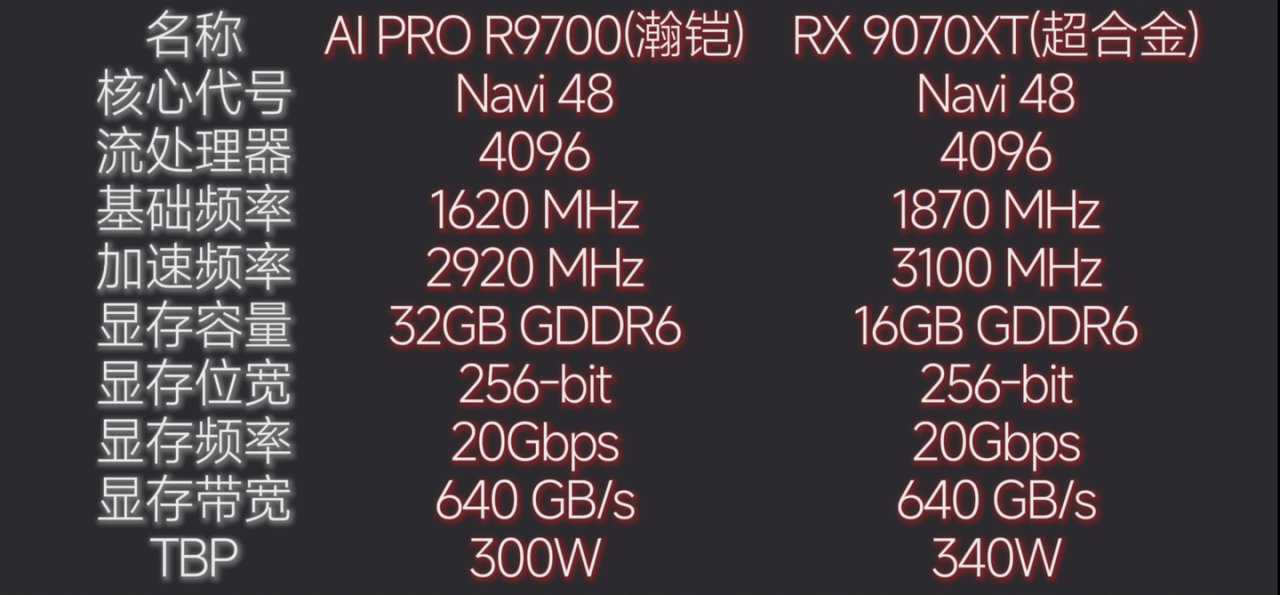
再简单过一下过一遍核心规格: 核心代号Navi 48,RDNA 4架构配备4096个流处理器,Boost斌率2920MHz,搭载32GB GDDR6显存,显存位宽256bit,TBP 300W。
欸,这不是9070XT的核心嘛,是的,它本质上就是一张频率功耗稍低32G版本的9070XT
大家都知道大就是好,显存永远不嫌多
对AI来说,显存算是几个核心指标之一。它直接关系到模型能不能跑、跑得爽不爽、能跑多大的模型。
直接进入实测环节
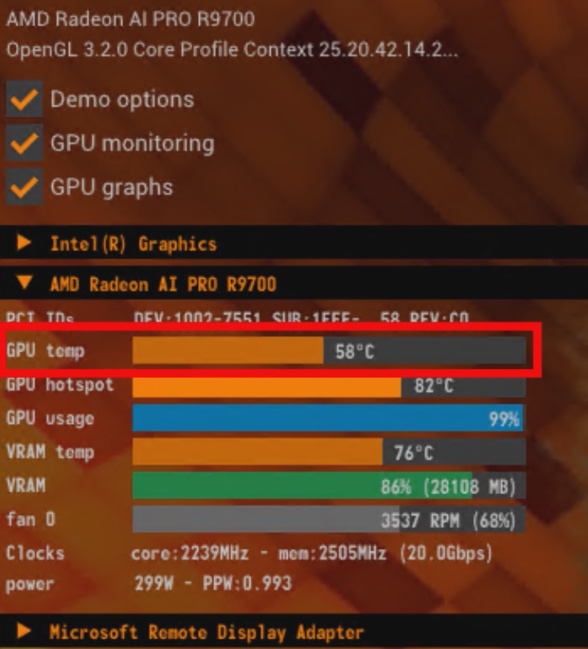
先带大家看一下烤鸡温度,得益于涡轮卡的优势,十分钟烤鸡测试后,核心温度仅有58℃,显存温度76℃,非常凉爽
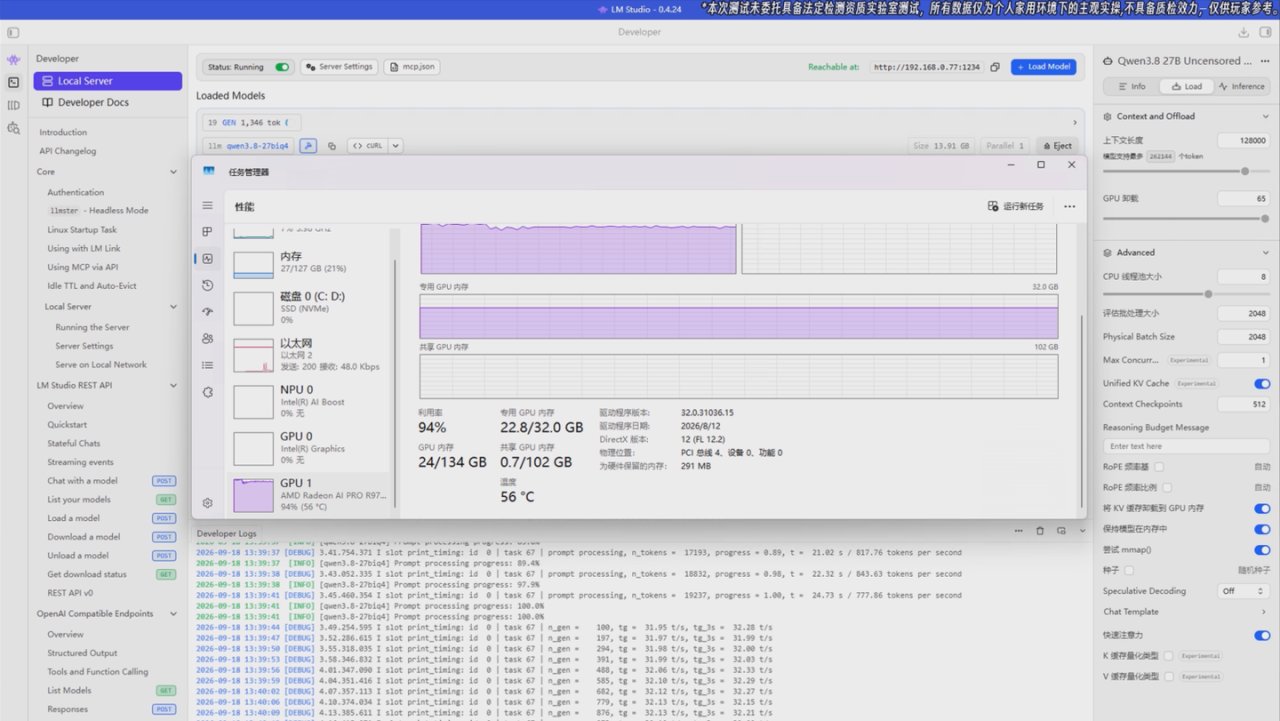
性能方面本地部署QWEN3.8 27B,IQ4量化,不开MTP与KV量化,上下文128K,显存占用在22G左右,预填充速度约800token/s这个速度还可以
实际体验下来只有冷启动的预填充阶段,需要等的久一点,其他部分都比较满意
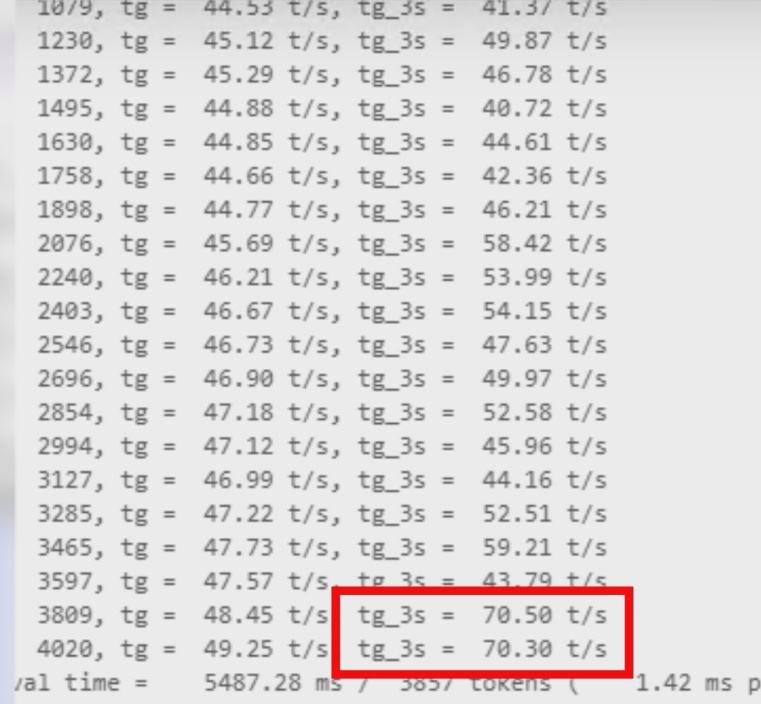
如果开启Q8 KV量化+MTP投机解码,速度最高可以暴涨到70token/s
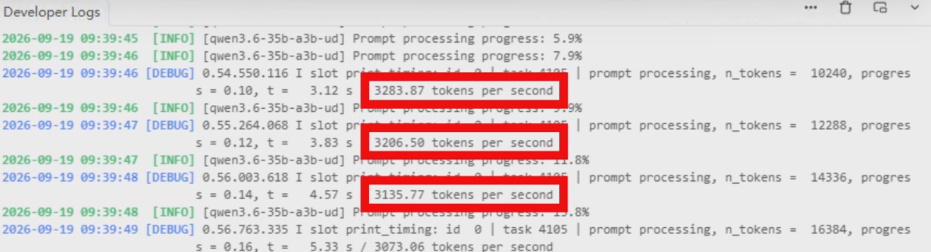
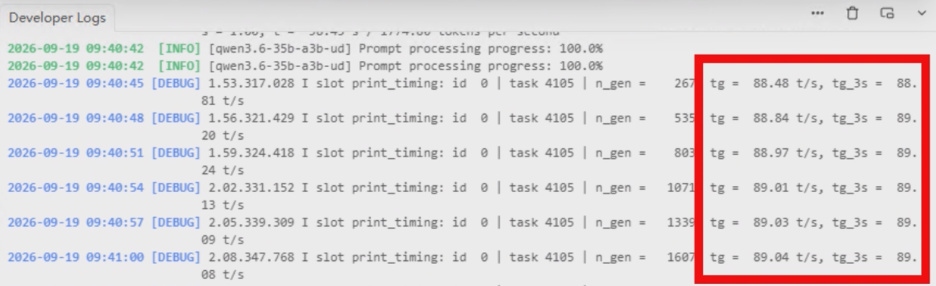
换成MOE之后R9700表现更为惊人,预填充速度一度冲到3000token/s,吐词速度也有90token/s。
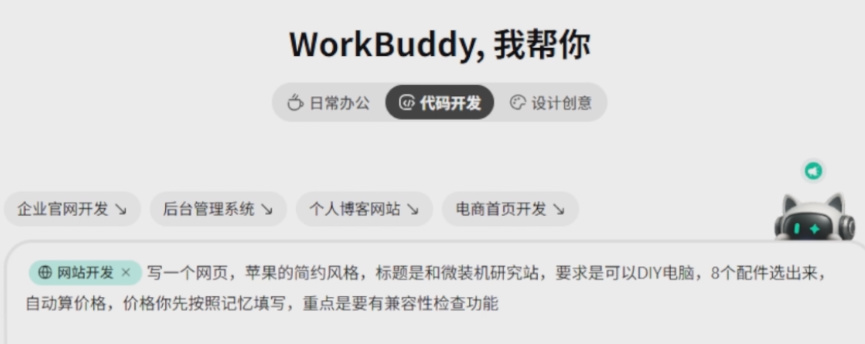
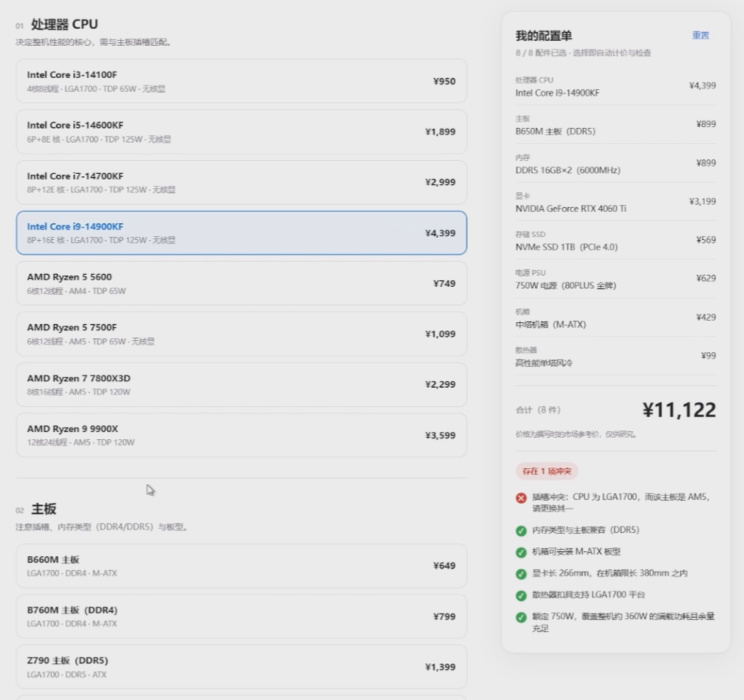
应用方面,我用WORKBUDDY做的这个小项目最终花了10分钟,可用性其实还不错,想要完全可用的话也不是不行,无非就是链接下数据库,完善下兼容性规则
不得不说,模型里面的老数据真让人感叹,去年的硬件价格竟然是这样的,让人有种恍如隔世的感觉
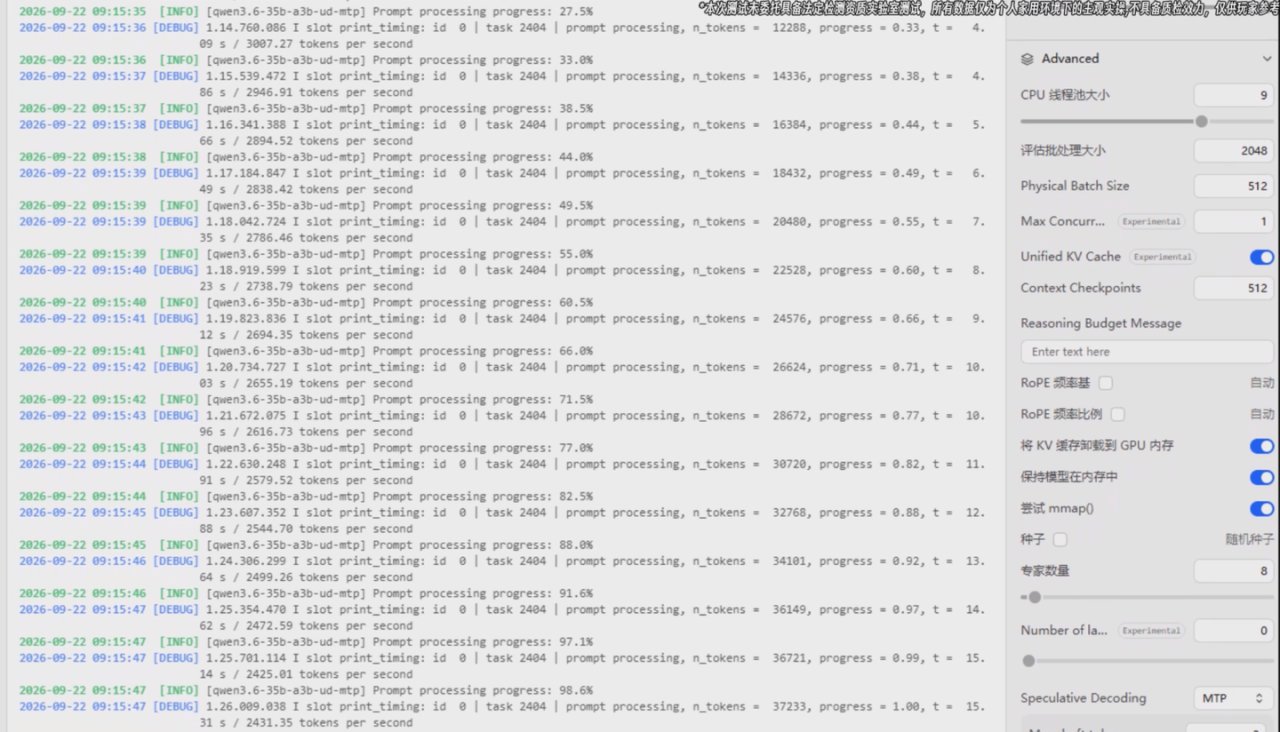
当前时间段,32G显存本地跑个小参数的MOE模型,体验就已经非常不错了(MOE是真的快)千问 3.6 35B A3B IQ4 量化版本中
上下文拉满,开启 MTP,预填速度可以来到约2500+ Token/S,吐词速度更是可以来到 140+ Token/S,已经可以解决一些并发的问题了,甚至并发还能把总带宽再撑大一点!
随着时间的继续后移,模型继续变小,32G显存也许真的能够撑起非常不错的本地AI生产力系统
如果你不想网速太慢跟不上时代,现阶段就想本地玩玩AI,那这张与5080售价接近的 R 9700或许就是你的“Dream Card”现阶段性价比非常不错(目前持续涨价中),相对于魔改卡,多了三年官方质保,让人安心不少
AI也许可能是泡沫,但至少现在,算力需求依然很大,存储也看不到降价的势头,想上车的人越来越多,不如趁着这波势头,乘风破浪!
“本文章由 AI 生成,内容仅供参考,请仔细甄别”
往期文章
2026年9月DIY电脑配置推荐实测24套主机2K到3W全覆盖可闭眼抄作业
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com