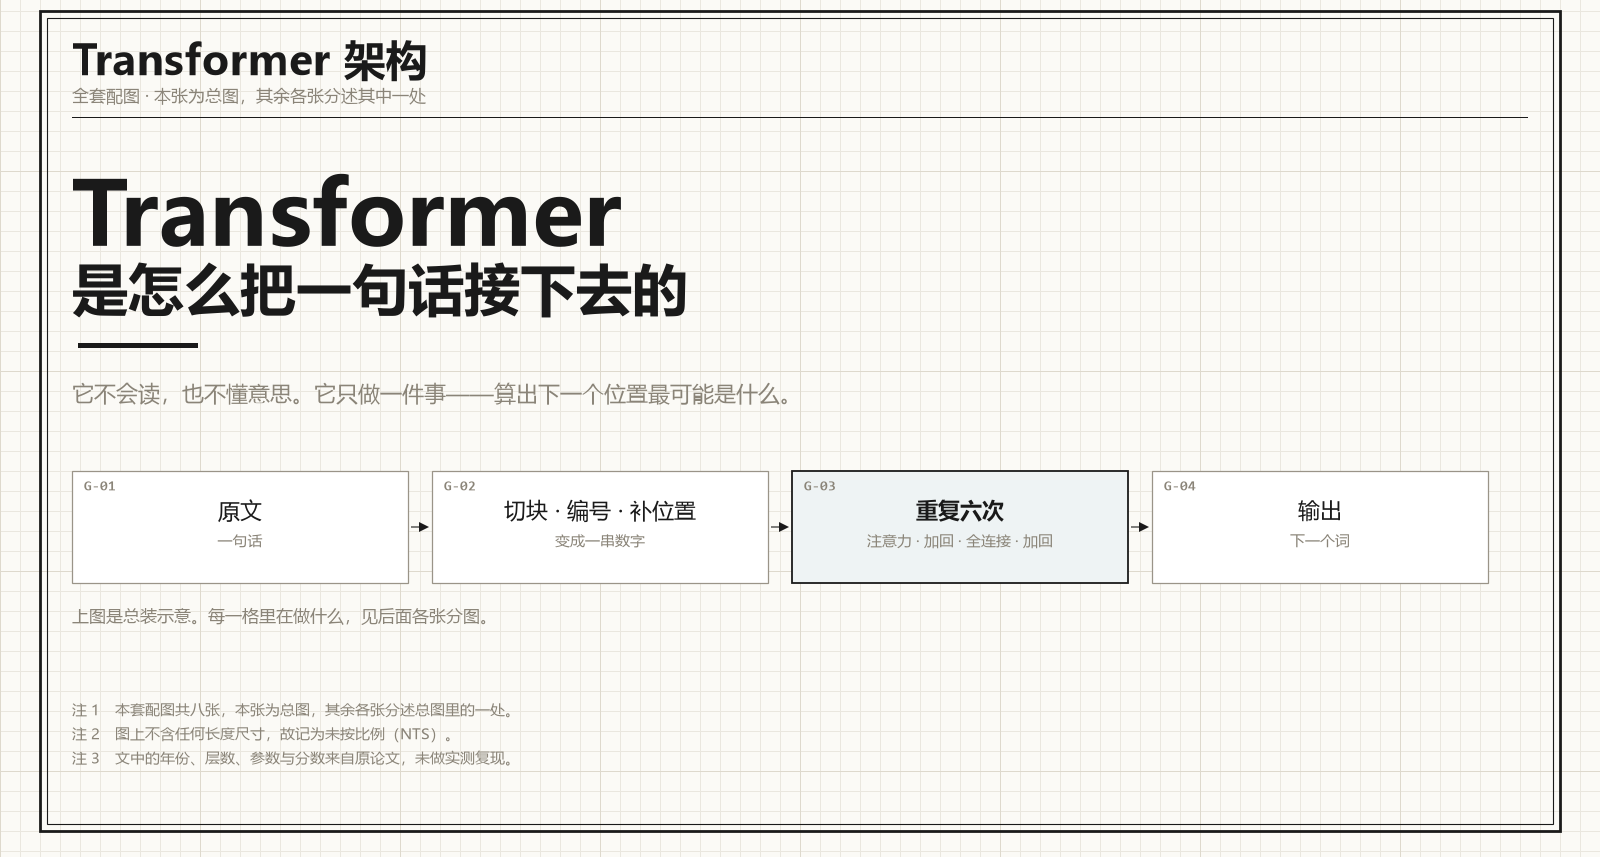
你在对话框里敲半句话,它把后半句补上。这个动作背后站着一篇 2017 年的论文,八个人写的。
论文的标题叫 Attention Is All You Need,是从一首歌倒装过来的。1967 年 6 月 25 日,人类第一次做全球卫星电视直播,英国广播公司请披头士代表英国出一首歌,要求只有一个,全世界都听得懂,用最简单的英语。列侬交出来的就是 All You Need Is Love,副歌几乎只有一个音,那一句话反复唱。二十几个国家、四亿多人同时看到了这场直播。
五十年后,八个人把这句话倒过来当论文标题。这不是起了个俏皮名字。倒装之后的字面意思是,你需要的只有注意力,这正是全文的主张,循环和卷积都可以不要。一句流行歌词就这么变成了一个技术断代的宣言。
先说它要解决什么麻烦。在这篇论文之前,机器读句子是一步一步来的,第一个词算完才算第二个词。这样读得慢,而且句子一长,开头那个词和第十个词之间的关系就容易淡掉。
句子先被切成小块,再变成一串数字
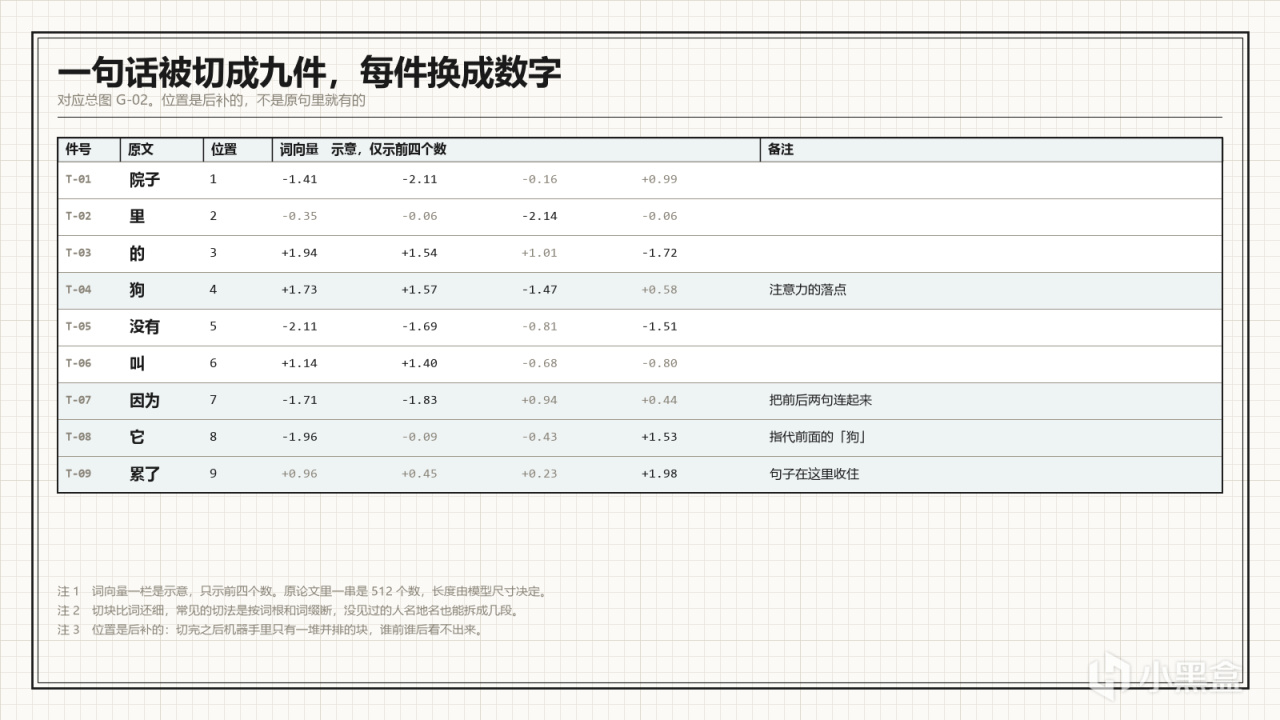
一句话进模型之前,要先切成小块。切得比词还细,常见的切法是按词根和词缀断,所以没见过的人名地名也能拆成几段处理。每一小块换成一串数字,这串数字叫词向量。
麻烦在顺序。切完之后,机器手里是一堆并排的小块,谁前谁后它看不出来。所以还要给每一块补一个位置信息,把序号掺进那串数字里。原论文用一组正弦和余弦函数把这个数直接算出来,不用事先设定。补完这一步,句子对机器来说才是一排有先后的东西。
每个小块都去问一遍,跟谁关系最大
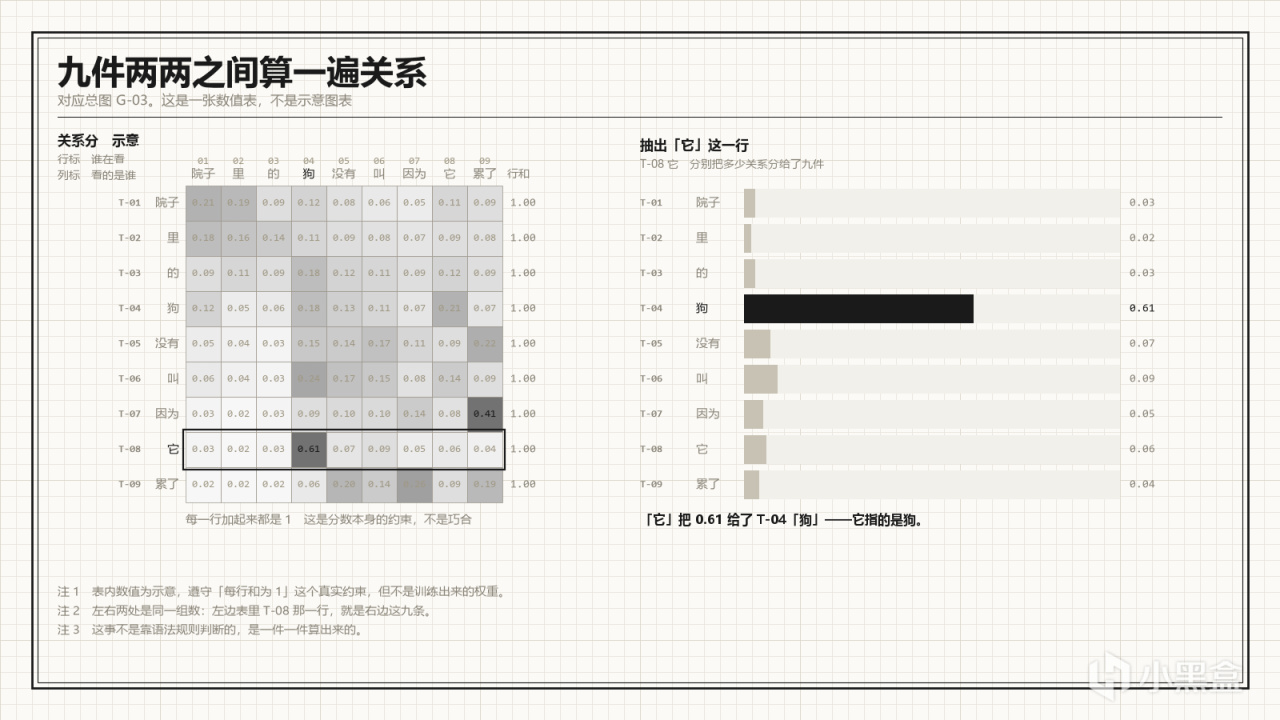
这是全篇的核心。每个小块都会问同一个问题,这句话里其他的小块,各自跟我有多大关系。
举个句子。院子里的狗没有叫,因为它累了。这里的它指的是什么,机器不是靠语法规则判断的,是算出来的。它会对句子里每个小块算一个分数,狗那个分数高,院子那个分数低,再按分数把各块的信息加权合起来,合成自己新的表示。
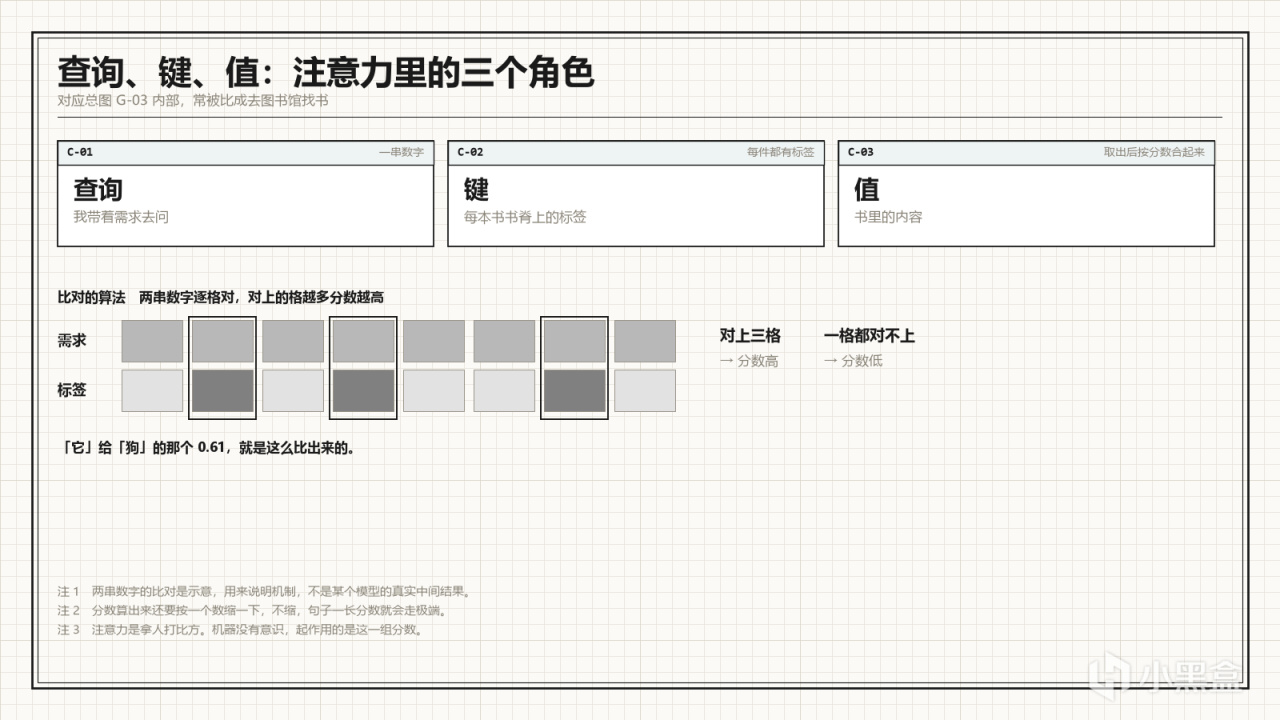
算法里有三个角色,常被比成去图书馆找书。你带着需求去问,这是查询;每本书书脊上的标签,这是键;书里的内容,这是值。拿你的需求去比每一本书的标签,标签最对得上的那几本,内容取得最多。分数怎么算,两串数字越对得上,分数就越高。算出来还要按一个数缩一下,不缩,句子一长,分数就会走极端。
注意力这个词是拿人打比方。人读一句话也会挑重点看,机器这一步做的事有点像,但它没有意识,出来的一组分数在起作用,谁高谁说话。
这一层里不止有注意力
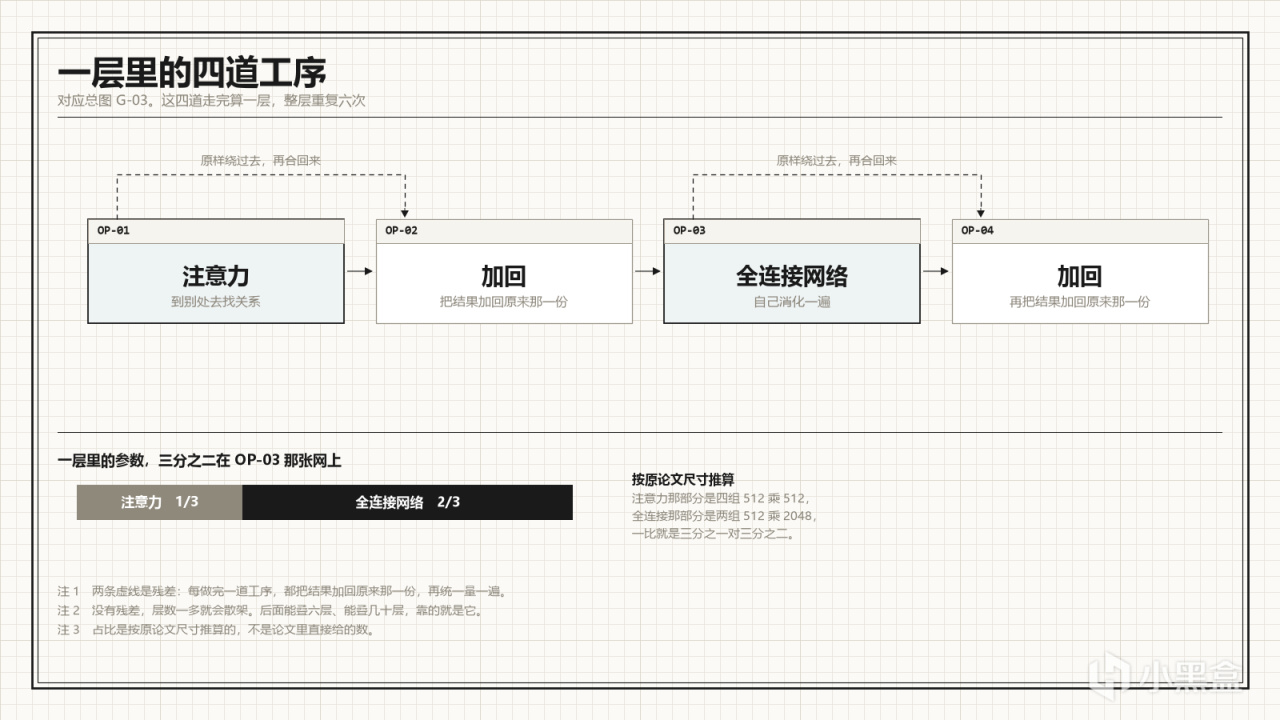
注意力负责到别处去找关系,找回来的东西还得自己消化一遍。所以每一层的注意力后面,都跟着一张普通的全连接网络,两层,先把数放大,再压回原来那么长。按原论文给的尺寸算,一层里三分之二的参数都在这张网上,注意力自己反倒占得少。
每做完一步,还会把结果加回原来那一份,再统一量一遍。这一步没有新东西,但没有它,层数一多就会散架。后面能叠六层、能叠几十层,靠的就是它。
这套结构其实是两半
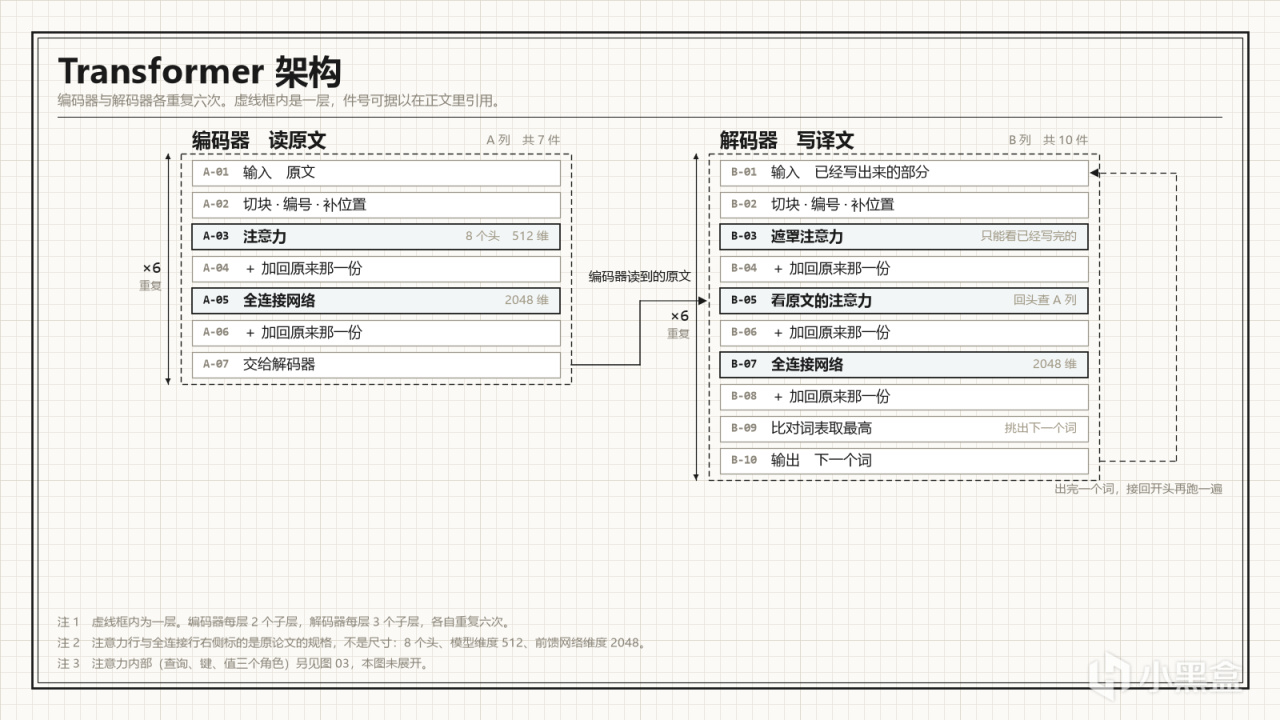
一半读原文,叫编码器;一半写译文,叫解码器。翻译的时候,解码器一边往下写,一边回头看原文。
有个细节要交代。解码器写第几个词的时候,不能提前看到后面还没写的词,所以它看自己的时候,得先把后面的位置遮起来。不遮,等于让它照着答案抄,训练就白做了。
这套动作要做很多遍
原论文里,编码器和解码器各自叠了六层,每一层都在上一层的结果上重做一遍同样的事。越往上,拿到的表示越抽象,下面几层盯着词和搭配,上面几层才看得出整句话在说什么。
八个头,同时开八场会
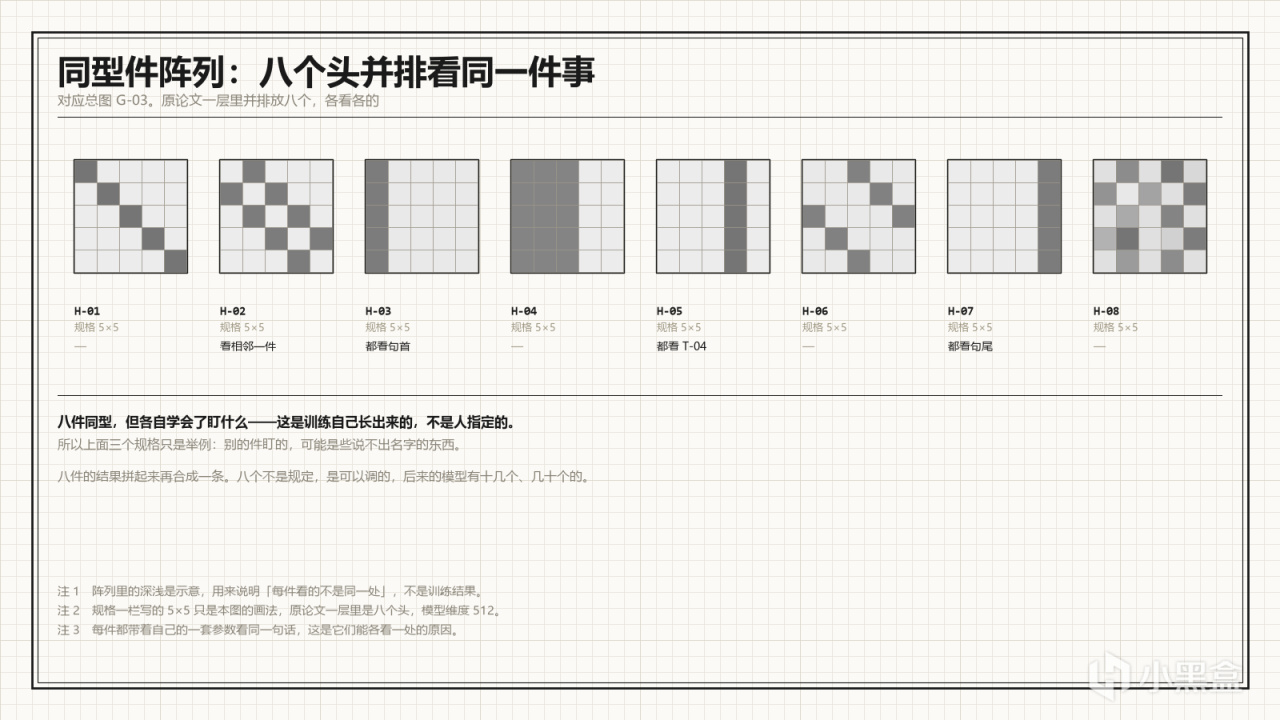
一个头只能盯一种关系,不够用。原论文里用了八个头,每个头带着自己的一套参数看同一句话,各盯一个角度,有的管搭配,有的管代词指代,有的管远近。八场会开完,结果拼起来再合成一条。八个这个数不是规定,是可以调的,后来的模型有十几个、几十个的。
循环去掉之后,机器才真正跑得动
原来那种一步一步读的做法卡在一个死结上,第一步没算完第二步不能开始,几千个计算核心大多闲着。改成让所有小块同时互相看,一步之内全算完,显卡才用得上。
代价也有。算关系的时候,每个小块都要跟其余所有小块比一遍,句子长度翻一倍,比较次数就翻到四倍。所以早期这一支只能处理五百到一千个小块,再长就算不动了。
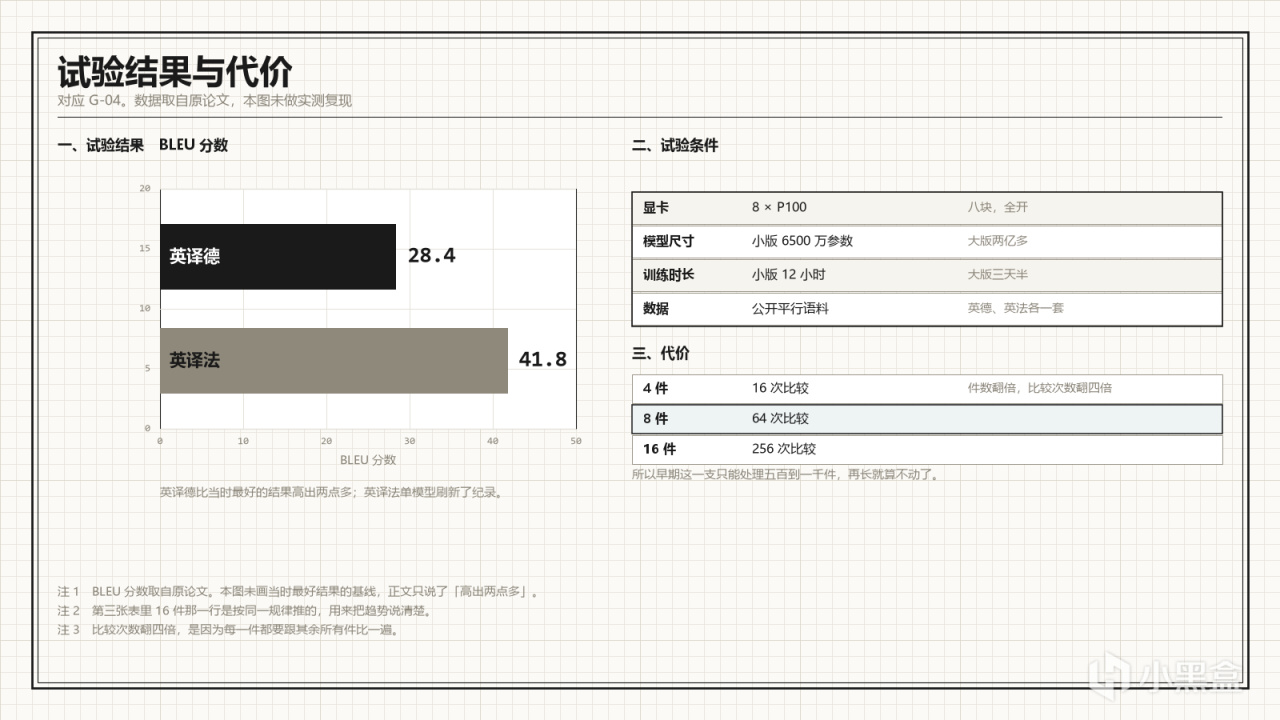
论文报出来的成绩是这样。英译德拿到 28.4 分,比当时最好的结果高出两点多;英译法 41.8 分,单模型刷新了纪录。跑出这个成绩用的是八块显卡,小的那版训练十二小时,大的那版三天半。
最后怎么变成一个词
最后一层出来的还是一串数字,不是词。要把它变成词,就拿它去跟词表里每一个词的向量比一遍,谁的分最高就输出谁。这跟开头把词变成数字是同一个动作,方向反过来了。
然后把这个词接到句子后面,整段再跑一遍,出下一个词。所谓把一句话接下去,就是这么一次一个跑出来的。
它并不会读,只是算得很准
这句话得说清楚。它不理解句子的意思,做的是另一件事,预测下一个位置最可能是什么。它做对的时候,看上去像懂了;它做错的时候,错法也往往不像人。
八个名字,顺序是抽签定的
这篇论文的署名顺序不是排的,是抽的。八个人没法定谁在前谁在后,最后决定每人名字后面标一颗星,再在页脚写一行,贡献相同,顺序随机。队里资历最深的诺姆·沙泽尔看到初稿时还挺意外,因为他的名字排在第一个。他后来开玩笑说,早知道这篇论文会这么出名,可能会更在意一下顺序。
Transformer 这个名字是队里的雅各布·乌斯科雷特起的,因为他喜欢这个词的发音。他们早期的设计文档里还配了变形金刚角色的插图,团队干脆就叫 Team Transformer。
原论文里那两版都不大,小的六千五百万参数,大的两亿多。今天动辄上千亿参数的大模型,跟它已经不在一个量级上。同一套骨架后来被搬去做图像,去做蛋白质结构,今天几乎所有大模型都住在里面。不过没有一个人能单独被叫做它的发明者。
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com