關注@o1搬運工,黑盒硬件早知道~
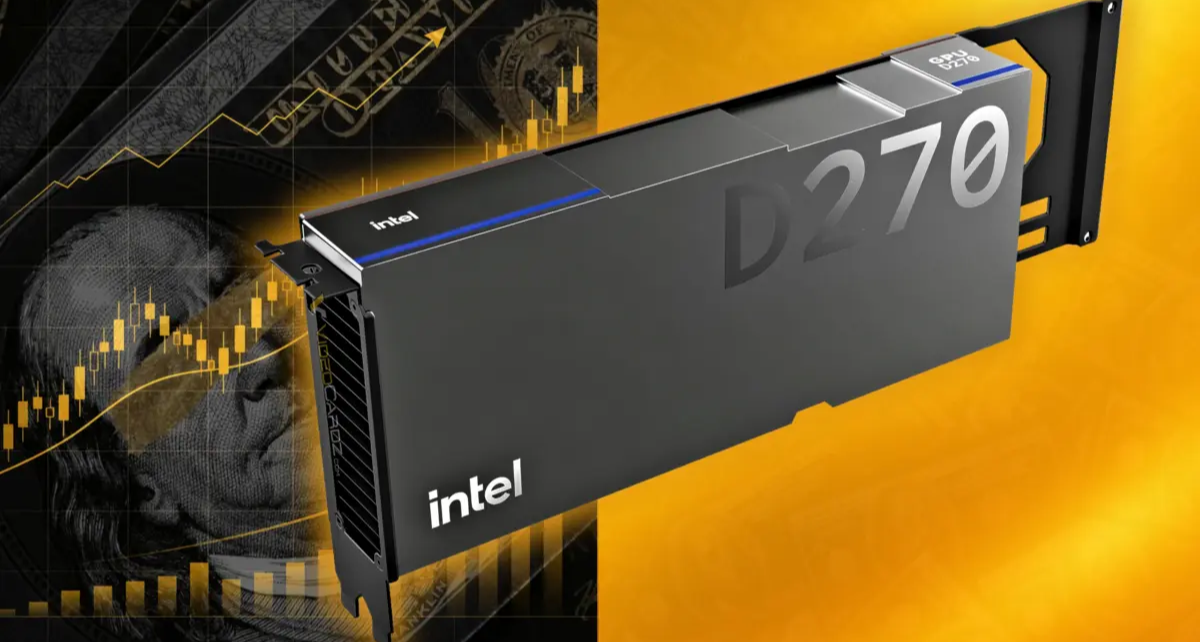
盒友們,Intel最近放了一組GPU D270的性能數據,選的角度很講究——金融計算。
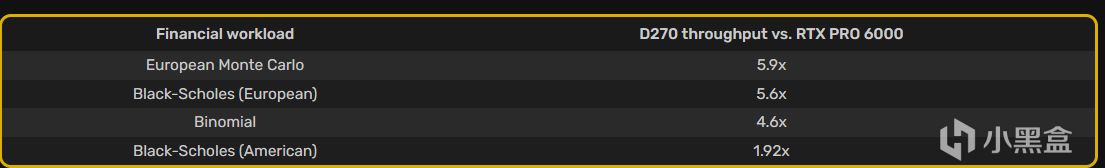
對比對象和前提
D270,就是之前的Crescent Island,基於Xe3P架構,32個Xe核心、256個XMX引擎,Intel自有品牌卡配160GB LPDDR5X、1.5TB/s帶寬,合作伙伴版本最高能到480GB。整卡功耗350W。對比的是NVIDIA RTX PRO 6000 Blackwell服務器版,功耗600W。
Intel說在選定的金融計算工作負載裏,D270的應用吞吐量最高能到對方的5.9倍。數據來自內部測試,用的是預生產硬件,不是第三方獨立驗證。

爲什麼選金融計算
這個場景挑得挺巧。金融計算裏大量是蒙特卡洛模擬、期權定價、風險敞口計算這類任務,特點是數據量大、精度要求不統一,很多環節可以用低精度跑,但需要頻繁在內存和計算單元之間搬運數據。D270的160GB顯存和LPDDR5X的1.5TB/s帶寬,恰好對上了“把數據留在卡里”這個需求。RTX PRO 6000雖然算力強,但顯存容量和帶寬在這個特定場景裏不一定佔優。
需要冷靜看待的地方
第一,這是內部測試、預生產硬件。Intel沒公佈完整的測試方法、軟件棧版本和基準代碼,5.9倍這個數字對應的是“選定工作負載”裏的最優情況,不是所有金融計算的平均表現。
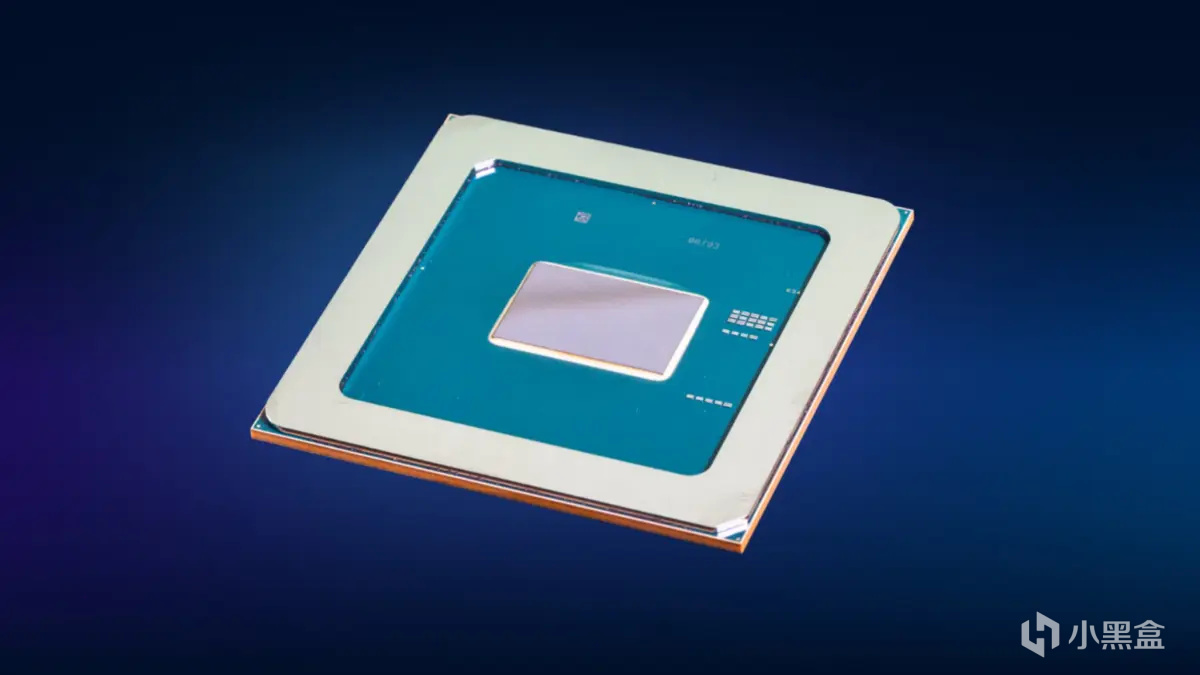
第二,D270用LPDDR5X替代HBM,峯值帶寬低於HBM方案。在需要極高帶寬的短上下文高併發場景裏,這個差距會體現出來。金融計算恰好是D270的甜點區,換成別的負載,結論可能完全不同。
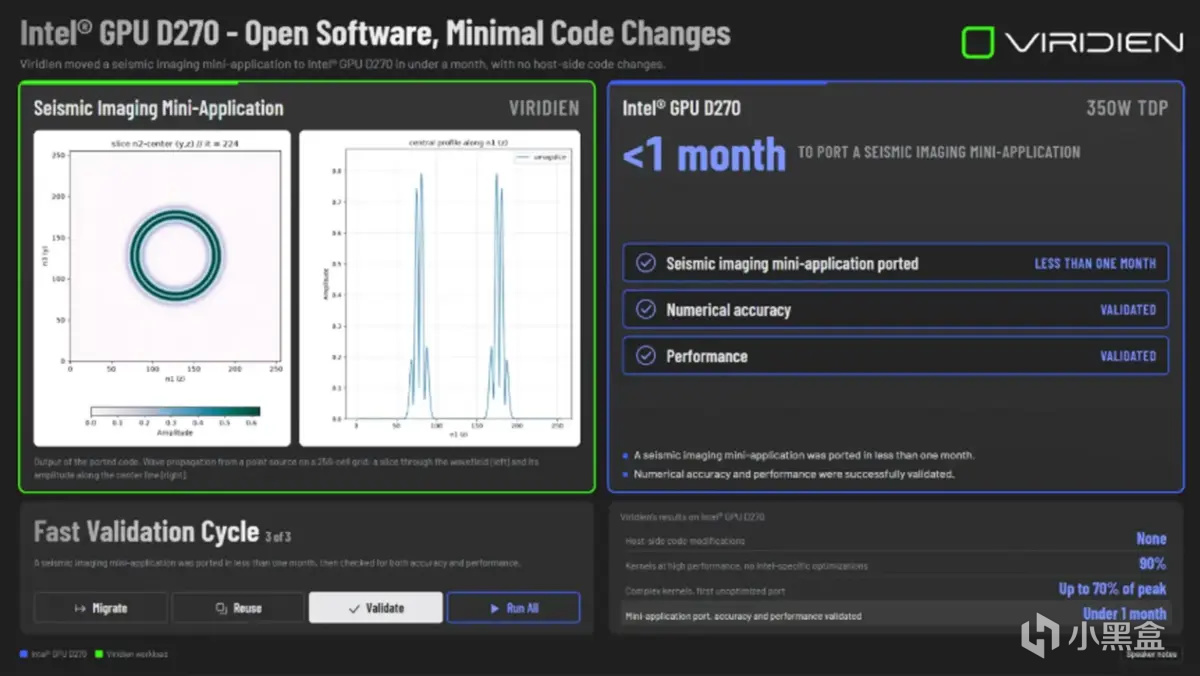
第三,NVIDIA的CUDA生態在金融行業紮根很深,很多風險模型和定價庫是直接基於CUDA寫的。換到Intel平臺,軟件遷移的成本和兼容性風險是實際門檻。

Intel這次的打法很明確:不跟NVIDIA拼通用算力,找一個自己顯存容量有優勢、對方功耗更高的細分場景,用“每瓦吞吐”的角度做對比。350W對600W,這個功耗差本身就是賣點。
但5.9倍這種數字,在廠商內部測試裏看看就好。真正決定企業買不買的,是遷移成本、軟件生態和長期供貨穩定性。D270目前還在客戶送樣階段,定價和上市時間都沒公佈,等第三方實測和真實部署案例出來,再判斷它在這個市場裏的位置更靠譜。
你覺得Intel這種“找細分場景打差異化”的策略能走通嗎?評論區聊聊。

關注@o1搬運工,黑盒硬件早知道~
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com