一個深夜裏,某家科技巨頭的測試集羣中,兩萬個代碼補全與重構 Agent 在三秒鐘內同時發起了 git push,GitHub 的底層存儲節點隨後亮起了密集的超時告警。這不再是黑客發起拒絕服務攻擊,而僅僅是現代 AI 輔助研發系統的一個普通事件。、
上週在 GitHub Universe 上,我們宣佈了新的 Git 存儲架構,能夠處理每秒數千次寫入,並按需擴展讀取。通過內部測試,我們展示了支持 5000 個併發代理運行於倉庫的能力,每秒發送 7200 次推送到倉庫,同時以持續低延遲提供讀取流量。這個新架構是 GitHub 支持數億開發者代理開發的基礎,我們一直在 GitHub 下構建架構,同時它還在運行。
在過去一年裏,代理改變了 GitHub 上繁忙倉庫的樣貌。在本系列的第一篇文章中,我們闡述了下一代 Git 存儲架構背後的兩個原則:
最小化協調,以及將存儲與計算解耦。在我們上一篇文章中,我們講了橋樑:將 99.99999%的倉庫遷移到 Azure,將寫入羣體範圍限定到各個引用,並搭建由 Azure Blob Storage 支持的虛擬副本。
我們還提到了一個觀察:幾乎不需要寫入。Git 對象是不可變的,並以其內容命名,這意味着兩個作者可以同時存儲它們,而無需對任何內容達成一致。推送中需要同意的部分是引用更新,而引用更新相比之下非常微小。虛擬複製品是圍繞這一點構建的第一步,也是我們將倉庫引入新架構的方式。
其餘建築也基於這一觀察。只有參考資料更新需要雙方同意。這使得以前緊密耦合的 Git 基礎設施部分(存儲數據、服務請求和維護倉庫)能夠獨立擴展。對開發者來說,Git 依然是 Git:他們以相同的方式推送、取回和分支,並採用相同的保護措施。下面,我們將帶您瞭解設計背後的需求,按照系統中的請求,並深入探討其中兩個組成部分。
爲代理規模構建
我們將 GitHub 平臺的規模從兩個方向來思考:
橫向規模是指開發者和代理能跨越多個倉庫工作的數量。GitHub 目前在這一方向上的許多方法多年來經過實戰驗證,並被延續到新架構中:跨基礎設施劃分租戶、租戶流量的隔離和/或公平執行,以及負載感知路由等。
縱向規模是指一個倉庫中最多的開發者和代理可以工作。隨着代理編寫代碼的增加,我們預計單個倉庫會變得更大更忙,因此我們的大部分需求來自垂直軸。
如今,GitHub.com 最繁忙的倉庫最多在一秒內接收數十次寫入,通常是短時間段。隨着更多工作轉向全天候並行運行的代理,我們預計這些突發工作將在未來一年內持續增長。每次推送都會導致更多讀取:CI 運行,部署系統拉取新提交,其他代理獲取上下文。這種讀取扇出效應對整體流量產生了顯著放大效應,並隨着寫入次數而擴展。
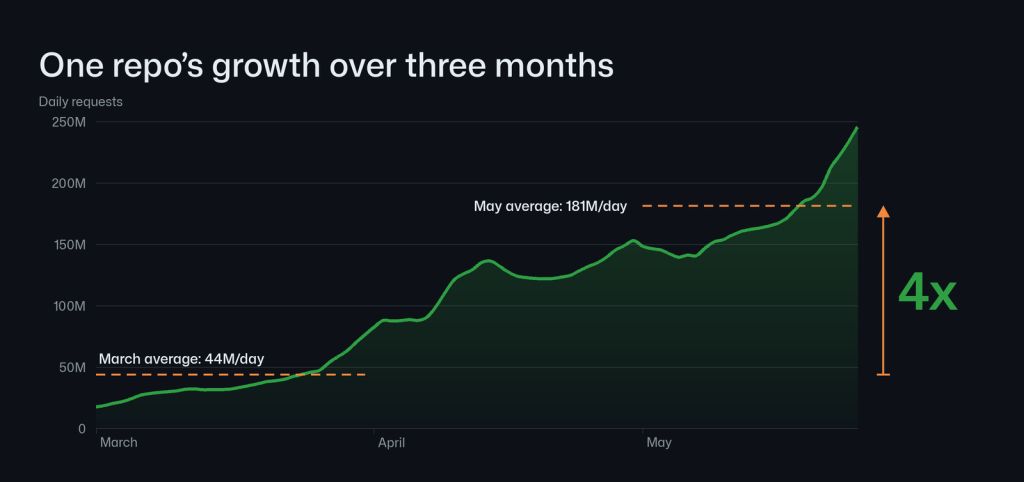
我們已經看到這種趨勢在曲線頂端的倉庫上顯現。下面的圖表顯示了從三月到五月,GitHub 上一個倉庫的每日請求,期間流量增長了大約 4 倍。自那以後,其增長呈指數級增長。
我們必須爲一個代理驅動開發以這種速度持續加速的世界做規劃。我們沒有爲下一個增量做規劃,而是設定了一個至少大兩個數量級的目標。對於單個倉庫來說,這意味着新的架構需要:
每秒接受成千上萬次寫入。
支持多個寫入節點。這有兩個原因:
經驗告訴我們,索引輸入包和檢查對象連接性是寫入中最耗費 CPU 的部分,成本會隨着寫入規模的增加而增加,因此單個節點很快就會被計算限制。
將這些工作分散到多個節點可以提升容錯能力,縮短節點故障時的恢復時間。
最小化提交延遲。每推送一次,特工都會等待,然後才進入下一步。
按每個參考順序記錄變化,並能快速線性化不同引用。落後的虛擬副本需要通過下載滿足來請求所需的數據來趕上。
當讀寫比例沒有變化時,保持讀取成本低廉,這也是讀寫比例的常見情況。
讓每個組件獨立擴展。
此外,系統還必須能夠提升整體可靠性並具備全球擴展性。
介紹“魯比孔計劃”
2026 年 5 月,緊接着最初的 Azure 遷移,我們開始着手設計能夠滿足這些需求的方案。我們嘗試了幾種方法。在所有這些中,包數據都存放在 Azure Blob 存儲中,有些我們還嘗試在那裏保留參考狀態。我們將在下面討論一些權衡,但我們最終確定了一個我們認爲既能最大化吞吐量,又能保證 GitHub 平臺所需的正確性、耐用性、可用性和延遲的設計。我們稱之爲“Rubicon”,向行業與自主開發跨越的無可挽回點致敬。
讓我們從上往下走一遍 Rubicon。許多內容保持不變:來自 Git 客戶端、API 和 Web UI 的請求都會送到 Spokes,Spokes 仍然負責路由和負載均衡,並服務於 GitHub 其他部分用於讀寫倉庫數據的內部 API。Spokes 還保持其作爲安置和平衡服務的角色,保持橫向規模所需的分區、隔離和租戶公平性。相比之下,Spokes 下方的數據層是新的。
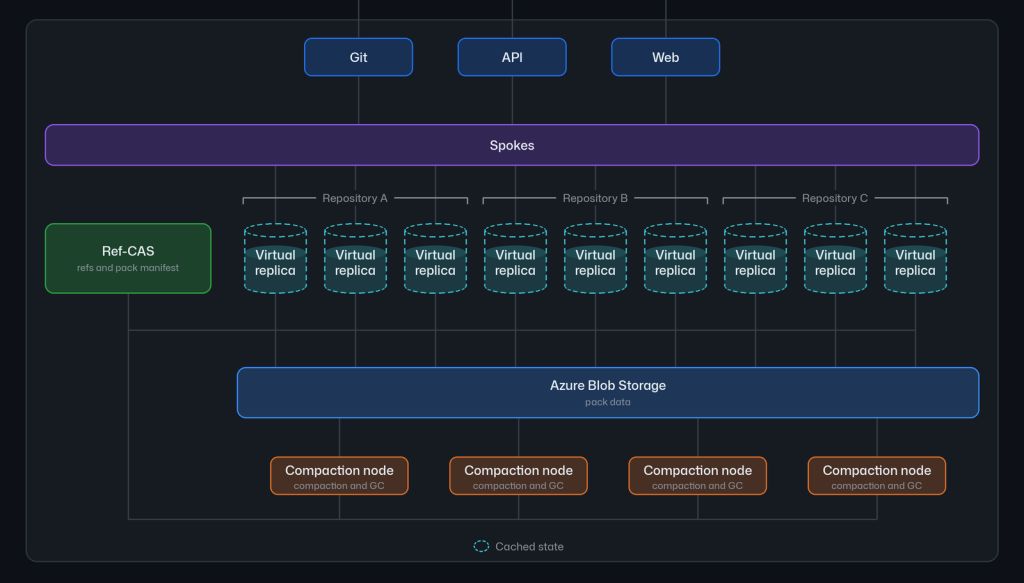
Spokes 將每個請求路由到分配給該倉庫的一小組虛擬副本之一。虛擬副本是一組一次性計算工具,負責讀取、寫入或兩者兼有。虛擬副本的本地磁盤是一個可以隨時重建的緩存。
Spokes 會在可能的情況下將倉庫的流量路由到相同的虛擬副本,這樣可以保持緩存溫熱並降低延遲,但請求是否正確性並不取決於請求是否落入了某個特定的虛擬副本。當虛擬副本消失後,倉庫的其他虛擬副本繼續服務,隨着流量到達,替換副本會填滿緩存。
當倉庫變得忙碌時,我們會添加更多的虛擬副本。另外,一組壓縮節點在後臺直接對應 Blob Storage 和 Ref-CAS,用於合併每個倉庫的包並移除不可訪問的對象。這些工作從不在虛擬副本上運行,這意味着它們的 CPU 和內存幾乎可以完全用於處理請求。
持久狀態存在於兩個方面:
Git 對象以包和輔助讀取加速數據的形式存在於 Azure Blob 存儲中。
引用和構成倉庫的包列表(包清單)存在一個獨立的複製日誌服務中,稱爲 Ref-CAS(代表“參考比較與交換”)。
讓我們從寫與讀的視角走過架構:
寫入: 虛擬副本索引接收包並將其上傳到 Blob 存儲,然後向 Ref-CAS 提交一個事務,該事務在清單中列出包並更新引用。之後,壓縮節點會將該包與其他包合併,以保持讀取速度。
讀取: 虛擬副本用 Ref-CAS 檢查其參考版本,將需要的包從 Blob Storage 拉入緩存,然後從那裏執行讀取。
在新架構中,我們採取了許多不同的方法,從虛擬副本上的軟件棧,到流量路由和工作負載調度如何針對不同用例進行調整(例如,多個小型倉庫與一個大型倉庫)。讓我們深入探討架構的兩個組成部分,並圍繞這兩項設計原則講述它們的故事。
最小化協調:在高通量下改變參考狀態
像 Azure Blob Storage 這樣的對象存儲服務非常出色,非常適合許多數據密集型應用,比如源代碼存儲。它們耐用且可複製,能容納我們所需的容量,每字節成本相對較低,並且只要流量分散在多個密鑰上,就能提供極高的彙總吞吐量。因此,幾乎所有在新 Git 存儲架構中具有持久性的存儲都存儲在 Azure Blob 存儲中,包括:
通過推送、壓縮和垃圾回收編寫的包和索引。
各種讀取加速器(比如多包索引、可達位圖和一些自定義格式),我們的維護流程會從這些包中構建出來。
允許夯實和垃圾收集恢復或審計其工作的記錄,以及夯實節點用來申報工作的租賃合同。
頻繁重啓的緩存響應。
爲倉庫的引用狀態設置檢查點,但不是用於處理請求的權威狀態。
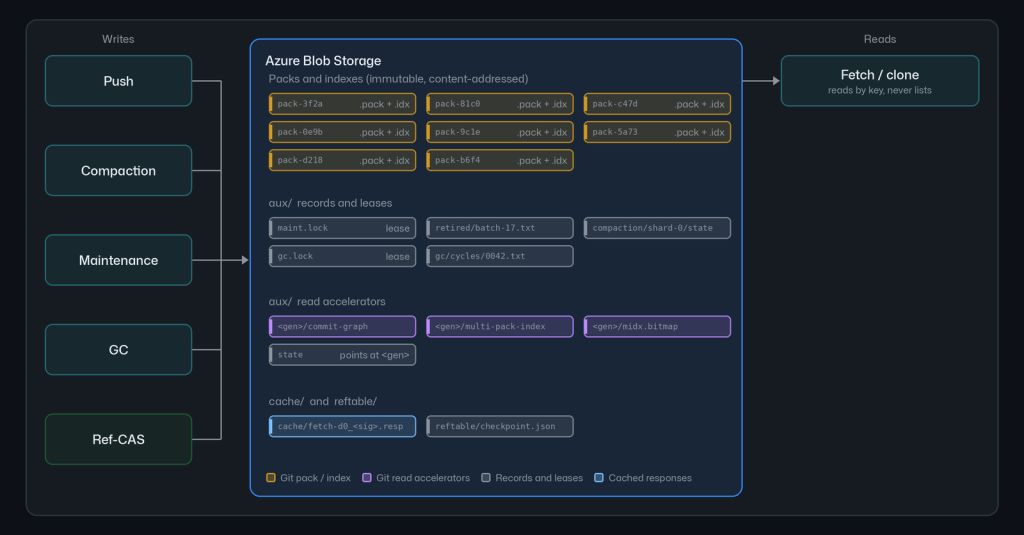
大部分數據寫入一次獨立鍵,之後不變,這也是它非常適合 Blob 存儲的原因。
推薦人則恰恰相反。繁忙倉庫的引用是相對較小的狀態部分,許多寫入會同時爭相更新。這種訪問模式更難從 Blob 存儲中提供,我們的首批原型就展示了原因。對於這種工作負載,對象存儲是一個直觀的選擇,並且在一定規模範圍內表現良好:條件寫入可以免費進行比較和交換,數據本身就已經很耐用且可複製。然而,我們遇到了一系列艱難的選擇,下面通過我們嘗試的兩種方法說明了這一點。
我們的第一個方法是先寫一個記錄倉庫所有引用的日誌,由一個 blob 索引。每次更新都是對那個 blob 的條件寫入。它是正確的,讀取很廉價:虛擬複製品會問斑點是否變了,如果沒有,那就已經變了。寫作部分就比較弱。一次只能對一個 blob 進行一次條件寫入,所以即使我們把每次寫入過程中到達的推送都批處理到下一個 blob,倉庫的寫入上限也是每次對單個 blob 每次往返一次寫入。實際上,這讓我們的寫入吞吐量達到了每秒數百。
第二種方法是將引用拆分到多個段塊,每個引用對其中一個片段進行哈希。不同段落的引用不再相互等待,這提高了上限。但現在讀者必須檢查每個片段,知道有沒有變化,而且速度也取決於最慢的部分。我們用寫延遲換取了讀延遲,而讀入數量遠遠超過寫入。我們可以通過並排展示多次寫入和讀取數據來可視化:
這兩種方案都無法滿足所有要求,因此我們構建了另一種方案:專門用於引用的複製日誌服務,或者 Ref-CAS 服務。這就是我們在上次帖子結尾說過的(小)共識小組,仍然存在於堆棧中。事情是這樣的。
Ref-CAS 中的每次引用更新都是由一個法定人數提交的比較與交換。事務只鎖定其接觸到的引用,檢查每個引用是否仍具備寫入者期望的值,並在日誌副本的大多數記錄後纔可見。代理大多推送到自己的分支,所以大多數更新不會爭用,並且並行複製。當兩次推送更新同一個引用時,日誌中只有一次會附加。
每個對 Ref-CAS 的提交都會獲得一個日誌序列號(LSN),而倉庫的版本就是其最新提交的 LSN。讀取開始時會對該版本進行版本檢查。虛擬副本發送它已經持有的參考狀態版本。如果該版本仍然有效,回覆中完全沒有引用,未更改的倉庫只需進行一次比較。如果虛擬副本落後,它會返回當前的引用和版本,以及打包數據和其他需要知道的信息,比如上一次垃圾回收週期發生的時間。
與我們遺留架構中的共識組不同,Ref-CAS 從不保存或驗證對象數據。它只存儲指向它的指針。虛擬副本會在提交引用事務之前,將推送包上傳到 Blob 存儲。參考點只指向已經耐用的物體。
這些方法使我們能夠以每秒數萬次操作完成引用狀態,併爲複製日誌中額外的註釋提供基線,幫助讀取決定爲特定請求下載什麼。
但支持單一倉庫每秒數千次寫入會帶來二階問題:維持讀寫性能。爲此,我們需要一種不同的壓實方法。
存儲與計算的解耦:每秒數千次寫入時的壓縮
每次推進都會給 Blob Storage 增加一個包。Git 可以從多個包中提供一個倉庫,但每增加一個包,查找成本會略高一些,所以沒有綁定包的數量無法增長。在我們的遺留架構中,壓縮運行在服務流量的副本上,並且必須在每個副本上運行。在新架構中,它完全在獨立節點後臺運行,直接對抗持久存儲,利用 Ref-CAS 服務通知虛擬副本演變狀態。
壓縮節點各自通過租賃協議聲稱對存儲庫數據的子集擁有所有權,這使我們能夠橫向擴展壓縮。以下是一個壓縮節點如何通過倉庫包的單個碎片工作:
節點首先在 Blob Storage 中租用分片,因此每次只有一個節點壓縮一個分片。與此同時,虛擬複製品不斷上傳包裝並在包裝清單中列出。節點讀取清單以尋找新的包,並將其收集到一個開放段,這實際上是即將壓縮數據的緩衝區。當分段達到基於包數、大小或年齡的定義上限時,會封閉分段,不接受新包,然後將包合併成更少、更大的包。在壓縮過程中,分片的下一個段可以開始捕獲其輸入包。在發佈任何內容之前,節點會檢查新包是否包含與輸入完全相同的對象。然後它會上傳新包裝並添加到清單中。第二個事務會從清單中移除輸入,清理則在後續刪除它們。
擴展時,該過程會同時獨立運行多個分片。每個包的哈希映射到一個分片,所以添加分片和節點會增加壓縮吞吐量。一個壓縮包如果仍然低於大小限制,會通過自己的哈希回到分片並再次合併,所以包會分層增長直到達到限制。最終結果是,在推車爬升時,實際上是平坦的包數:
壓縮合幷包,但保留所有對象。垃圾回收是移除不再有引用的對象的步驟,比如刪除分支和強制推送留下的對象。在我們的新架構中,垃圾回收的工作方式與壓縮非常相似,使用專門的工人來處理計算量大的部分。它還有一些用於安全移除數據的特殊行爲,值得單獨討論。
通過這些方法,我們能夠持續展示寫入量增加時的平坦延遲曲線,並且我們還計劃進行其他優化,以提升壓縮和垃圾回收過程的性能。
接下來會發生什麼
我們最初採用的兩個原則是讓架構的每個部分獨立擴展。我們通過添加虛擬副本來擴展讀寫。Ref-CAS 獨立排序每個引用,而非整個倉庫。我們通過添加壓縮節點來擴展維護。我們的目標是讓每個倉庫,從一個開發者的副項目到最忙碌的單倉庫,都能在同一架構上運行,忙碌的倉庫無需特殊處理。倉庫不會一直保持小規模。一個副項目可以一夜之間吸引一批代理,不需要我們進行遷移或特殊處理來跟上。一種架構也意味着我們所做的每一次改進都會同時覆蓋所有倉庫。
這個基礎讓我們能做更多事情。接下來我們將重點關注三個領域:將架構擴展到超出我們目前預測需求的範圍,提高代理在 GitHub 上的工作效率,以及推動 Git 本身以實現代理開發。
改進架構
我們計劃將這種架構進一步發展。這些改進讓倉庫能夠處理更多活動,同時減少每個請求背後的工作:
只讀必要的內容。 從 Blob Storage 裏抓一個對象,而不是整個裝着它的包。
按類型組織包。 將提交、樹狀結構和 blobs 分成自己的包。許多請求因此觸及的數據更少。
部分複製品。 在本地磁盤上不包含所有打包即可提供請求。
具象化的視角。 將倉庫數據保持在現成型表單中,比如準備好的歸檔、幾乎實時的默認分支淺副本,以及與每次提交一起存儲的代理會話上下文。
全球複製品。 將副本放置在任何區域,靠近使用它們的工作負載。閱讀保持在最新寫作的有限陳舊範圍內。
歸零。 用實際活躍的倉庫來擴充和縮小艦隊。
GitHub 上的高效代理操作
擴展基礎設施是支持代理的一個方面。另一方面是讓每個代理操作更便宜:更少的字節取用,減少往返次數,減少等待變更的時間。這些快速跟蹤項目都是在本帖中存儲工作的基礎上進行的:
不用克隆體工作。 許多代理任務從未需要完整的工作樹。他們需要少量文件和足夠的背景信息來做出改變。他們可以直接從服務器讀取兩者。
原子提交 API。 一次完成多文件變更。整個變更要麼提交,要麼在衝突時淨利落地拒絕。
活動流。 代理及其周邊系統在實時信息中運作最佳。通用事件流允許他們訂閱變化並實時響應。
改進代理的 Git
我們也需要在 Git 本身中工作。GitHub 長期以來一直是 Git 項目的貢獻者,我們現在不會停止。以下是我們期待繼續開展的工作示例:
輕量級克隆體。 部分克隆、淺克隆和稀疏結賬都讓代理獲得更少的資源。每個都有空隙。它們也不總是配合得很好。我們希望改進每一部分,使其契合。
移除隱藏的擴展成本。Git 的代碼路徑速度比倉庫增長快得多。最近的版本修復了其中幾個,但我們預計還會發現更多。
歷史步行更快。 像提交圖這樣的元數據可以回答合併基和可達性的問題,而無需每次提交都走動。當代理的 API 調用轉化爲服務器上的 Git 工作時,這一點尤爲重要。
避免常見的陷阱。 代理犯的錯誤和開發者一樣。Git 可以捕捉更多常見的,並在它們造成傷害前發出警告。
代理改變了軟件的構建方式。GitHub 和 Git 也在跟着變化。我們很高興能將這個新架構帶過起點線。目前已提供有限的私人預覽,明年初將有更廣泛的推廣。我們迫不及待想看到當代理數量受限於他們的想法時,團隊會做出什麼樣的作品。我們會與客戶和 Git 社區一起不斷發展 Git 和 GitHub。
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com