這兩天刷推特或者開發者社區,你大概率也見到了這個名字:Jev。(讀音應該是/dʒɛv/)
很多人第一反應,以爲又是哪家大廠偷偷憋出來的全能大模型,準備跟 GPT 或者 Claude 叫板。但只要點開它的文檔,你就會發現違反當前主流大模型的問題:它根本不會說話。
你讓它陪你閒聊,它不理你;
讓它寫一篇推文、潤色一份文檔,它連一個字都憋不出來;
甚至最基礎的寫段代碼,它直接給你返回報錯。
在大家習慣了“大模型無所不能”的今天,這簡直像個半成品。
可就是這麼一個看似“殘疾”的怪東西,近期直接在 AI 圈引爆了討論。背後的初創團隊 TypeSafe 憑着它拿下了 4000 萬美元的種子輪融資,官方的 waitlist 更是被全球開發者擠爆,大家都在通宵排隊等測試。(我也排了四五個小時隊才註冊成功,後續附上註冊教程。)
Q1:Jev 是如何誕生的?
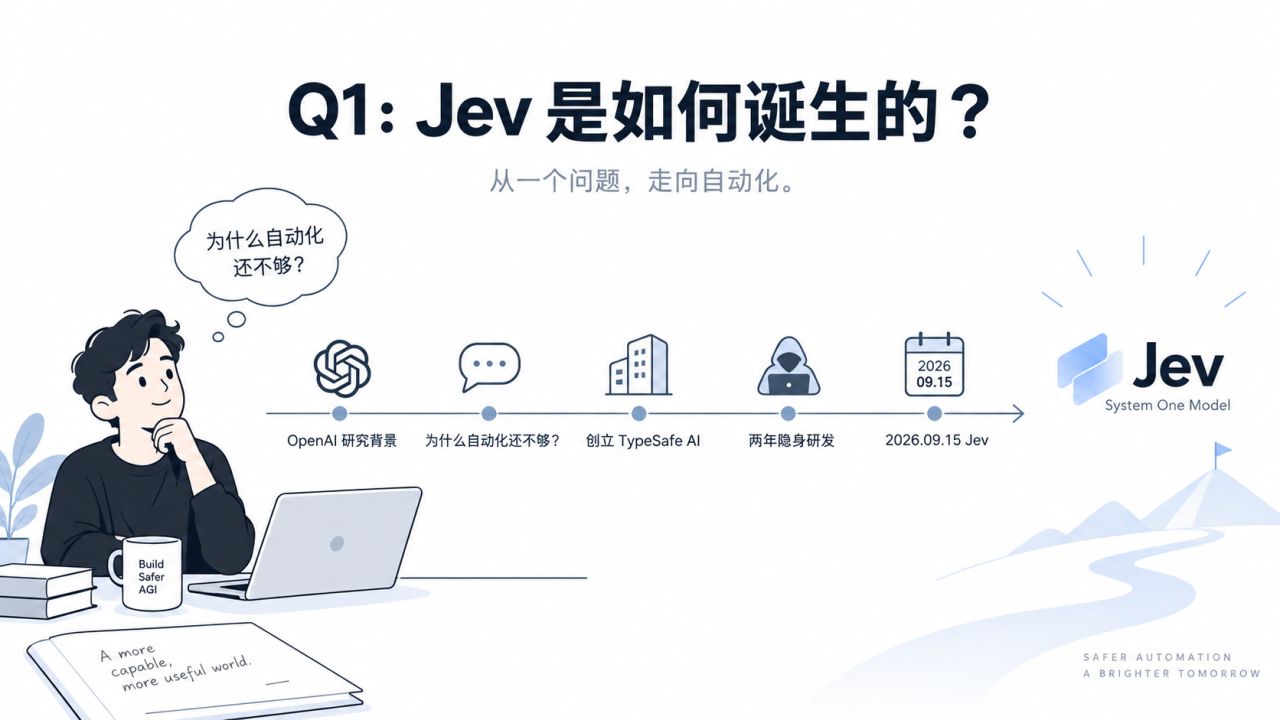
Jev 出自舊金山初創公司 TypeSafe AI,剛剛在 2026 年 9 月 15 日正式對外亮相。
背後的團隊創始人 Diogo Almeida 此前在 OpenAI 擔任核心研究員,更是現代大模型基石技術——人類反饋強化學習(RLHF)的共同發明者之一。當年正是這套方法,把原本只會在後頭生硬續寫詞語的冷冰冰算法,調教成了今天能說會道、知書達理的 ChatGPT。
也就是說,當年親手把 AI 教會“聊天”的人裏,就有他一個。
Diogo 坦言,過去四年裏他心裏始終盤旋着一個揮之不去的疑問:大模型在聊天這件事上早就已經超越大多數普通人了,但爲什麼現實世界裏真正的端到端自動化依然少得可憐?
全行業砸進去了成千上萬億美元,熱搜一天換一個,可推開屏幕看現實,普通人的日常生活並沒有發生翻天覆地的躍遷,絕大多數企業軟件和業務流水線,也遠沒有變得真正智能。問題到底卡在了哪裏?
爲了解決這個問題,於是他離開openai,創立了新公司,並開發出來jev模型,名字取自經濟學家 William Stanley Jevons(提出傑文斯悖論的那位學者)。
Q2:它開源了嗎?
不,完全閉源。
官方目前只提供雲端 API,根本沒有公開模型權重。網上大家看到的各種 GitHub 倉庫,都是社區開發者調用它的 API 寫的輔助工具和應用 demo。不過目前註冊就送5美刀。
Q3:和其他模型不同在哪?
如果把我們平時用的 ChatGPT、Claude 或豆包比作一個博學又健談的顧問,那你問什麼它都能接得住,引經據典聊上半天,情商和文筆時刻在線。
但 Jev 更像是工廠自動化流水線旁邊那個只戴白手套的質檢員:你把一份材料推到他面前,他不跟你寒暄,不解釋前因後果,甚至連頭都不抬,只在毫秒之間直接給你的機器遞出一個乾脆利落的硬核結論。
借用諾貝爾獎得主丹尼爾·卡尼曼在《思考,快與慢》裏的說法,人類大腦有兩種思維模式:慢思考(System 2)和快思考(System 1)。
我們現在最熟悉的各類大模型,走的基本都是慢思考路線:深思熟慮、一步步推導推理,哪怕算一道雞兔同籠,也要在內部列出長長的思維鏈,耗時耗電;
而 Jev 所代表的,恰恰是工業界苦等已久的直覺式快思考(System 1 Model):就像你推開門看一眼同事的臉色,一瞬間就能本能地察覺對方是不是在生氣,中間根本不需要在腦子裏寫一段議論文去推導論證。
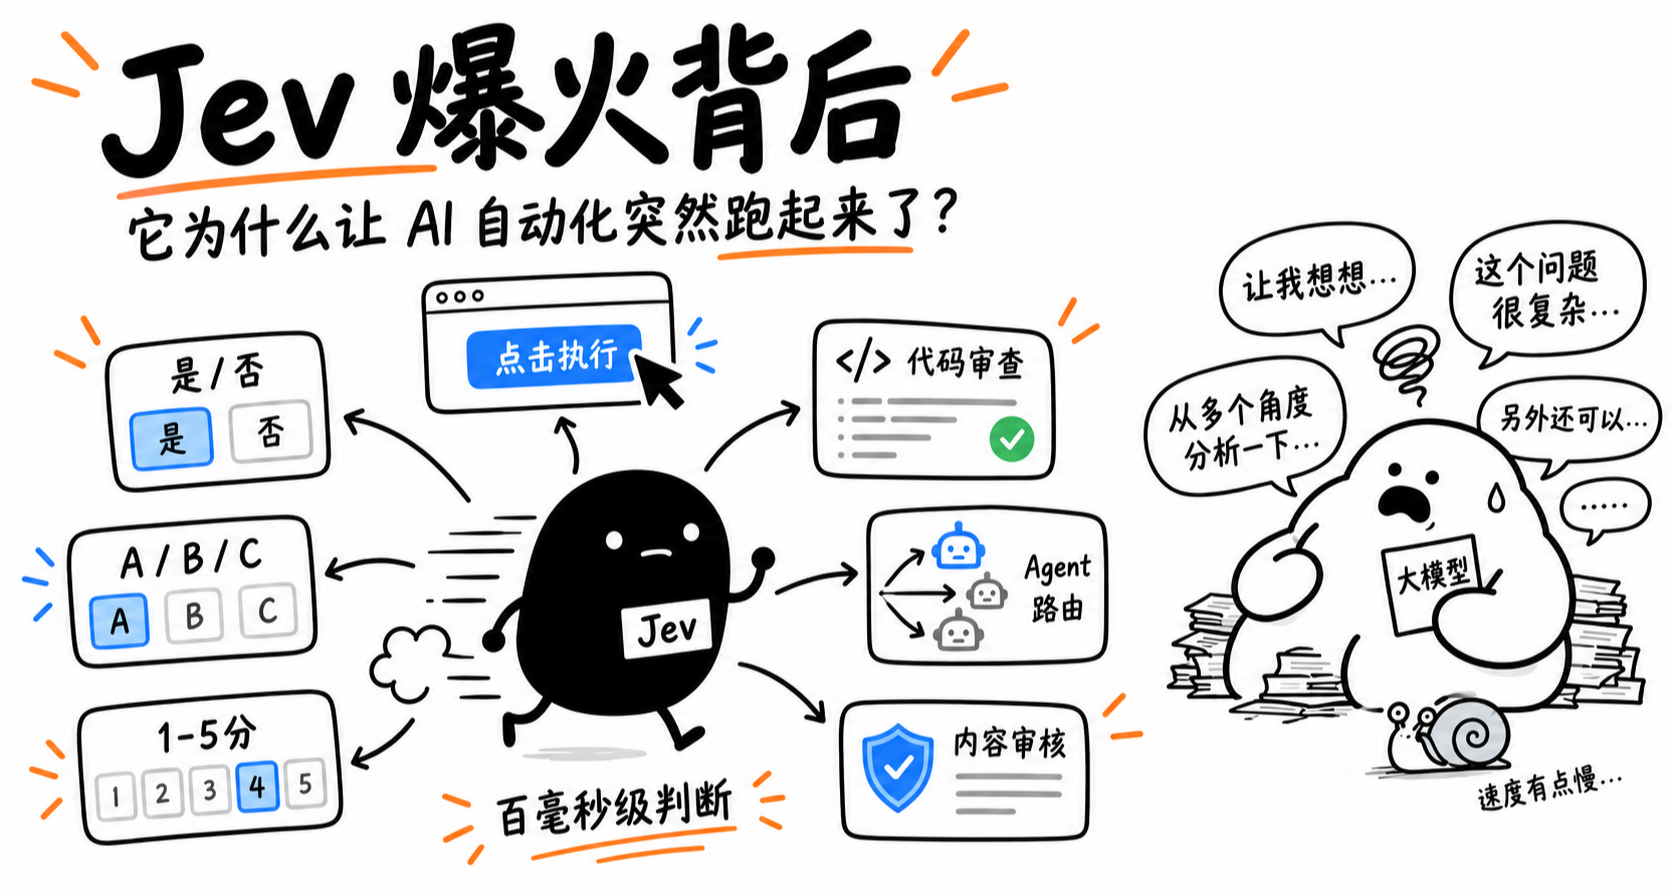
用大白話說,它存在的意義只有一句話:“只掃一眼,直接定論。”
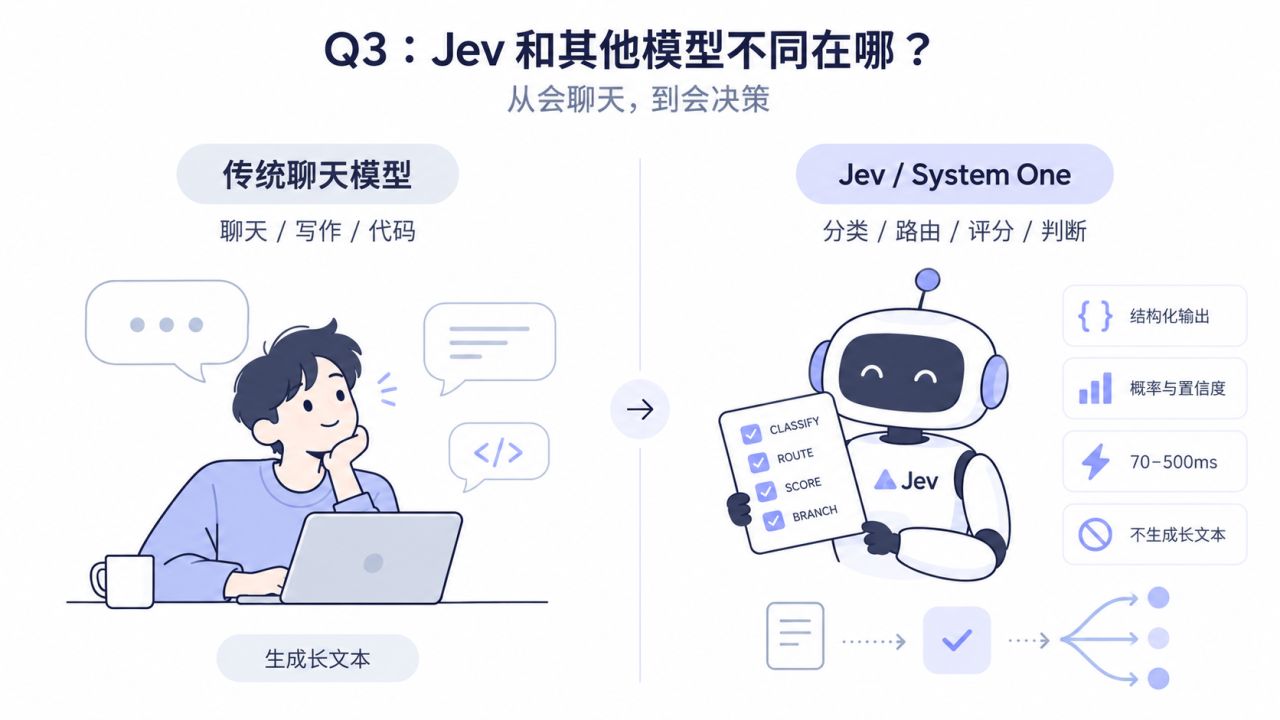
Jev :它只做判斷題和選擇題,100 毫秒出結果,一百萬 token 只要 4 美分。
普通AI如GPT,豆包等給人寫答案,Jev 給程序做判斷。
Q4:具體是怎麼樣的判斷?
把它放到真實的業務代碼裏,Jev 其實就是一個毫無感情的極速答題機。在它的世界裏,所有自由發揮的簡答題和長篇大論都被徹底剷除,整個系統只認三套極其剛性的題型:
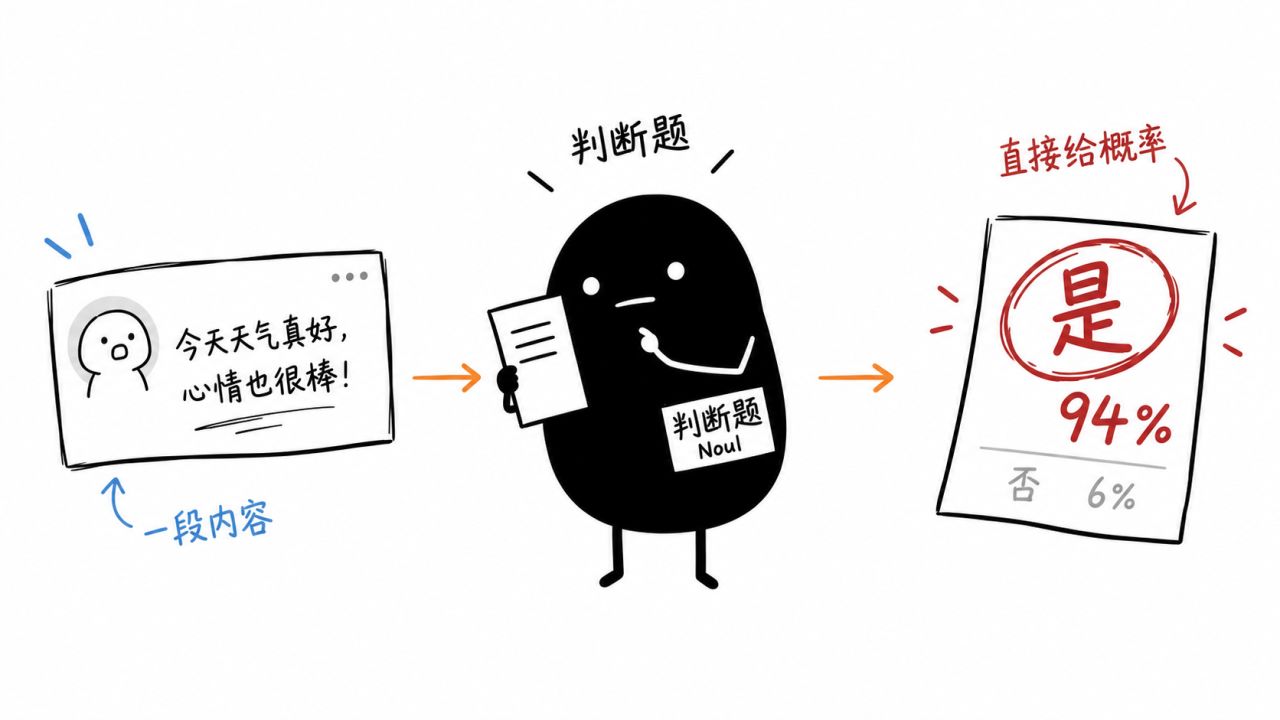
第一種是判斷題(官方叫 Noul)。 你塞給它一段原始素材,再加上一個非黑即白的命題。比如在社區防刷場景裏,扔進去一條新發的評論,命題是:“這段內容是否包含黑產引流推廣?”它完全不會向你解釋前因後果,而是直接扔回一個純粹的真實概率——比如判定爲真的概率是 94%。程序員拿到這個裸數據,根本不需要寫任何複雜的字符串清洗邏輯,隨手一行 if (prob > 0.8),靜默封禁或審覈攔截的分支就絲滑走通了。
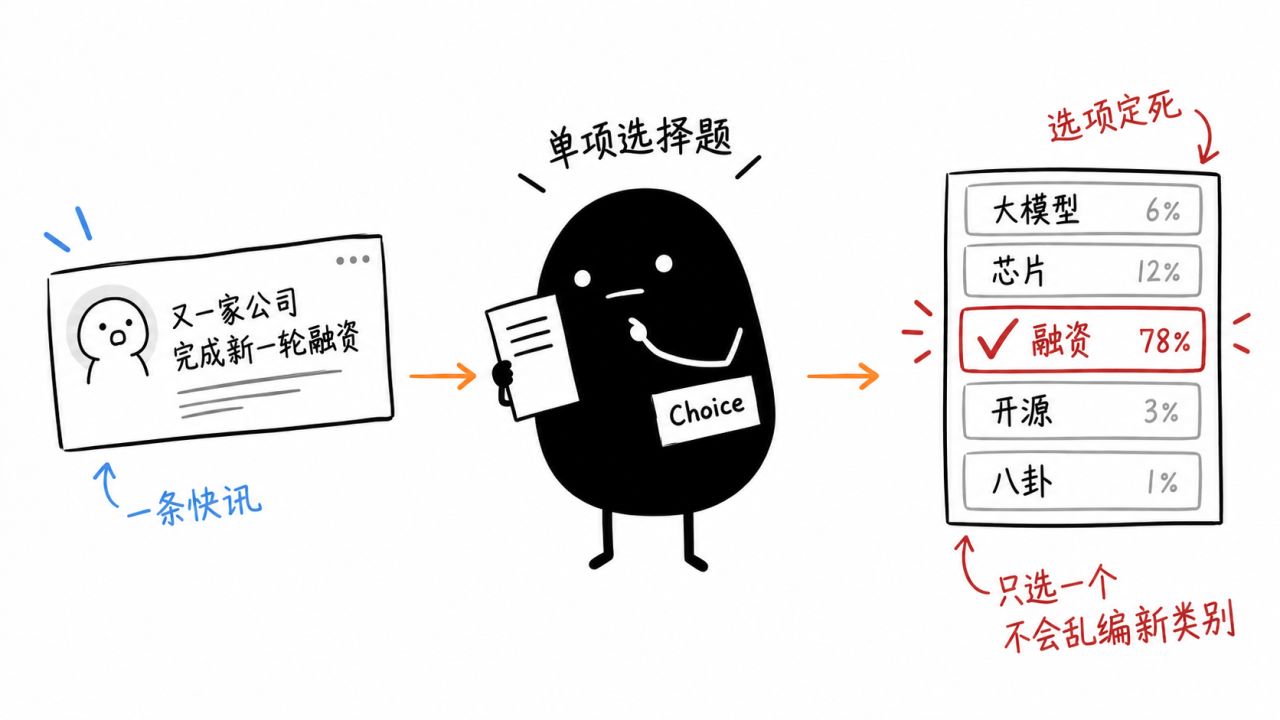
第二種是單項選擇題(官方叫 Choice)。 在調用之前,開發者需要把選項死死框定住,最多可以塞進 255 個候選槽位。比如做個自動化的資訊聚合雷達,候選池裏定死五個標籤:大模型更新、算力芯片動態、融資事件、開源發佈、行業八卦。Jev 掃完一篇快訊後,會嚴格返回這五個類別的概率分佈以及整體置信度。最讓工程團隊省心的是,選項是在外部定死的,模型在物理機制上就絕無可能“腦洞大開”,突然憑空捏造出一個第六類。你的後端程序拿到結果,直接扔進 switch-case 進行自動打標歸檔,徹底告別了過往解析大模型返回的 JSON 時動不動少個括號、多個字段的格式崩潰災難。
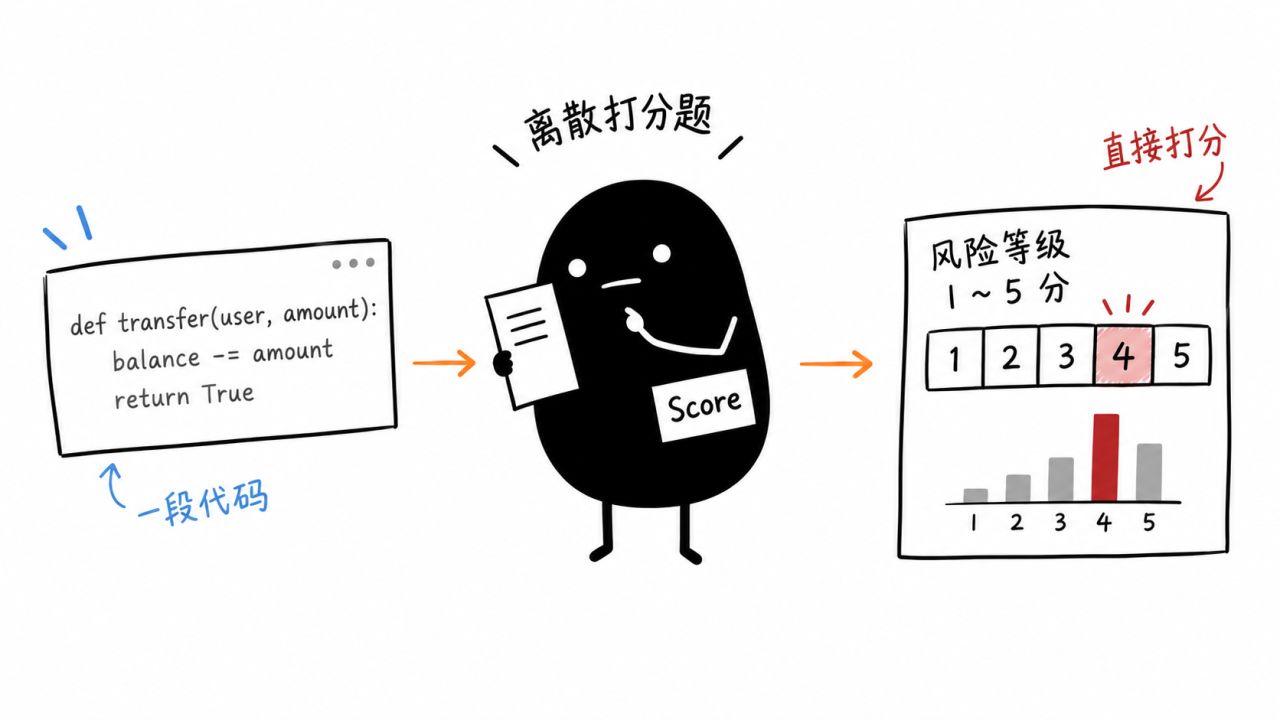
第三種是離散打分題(官方叫 Score)。 它專門用來對有順序規律的等級做量化評估。比如搭建一個代碼審查流水線,你定義一套從 1 到 5 級的潛在安全漏洞風險等級,它會直接給出整個分數的概率曲線分佈,讓你一眼看清代碼風險烈度的偏向。
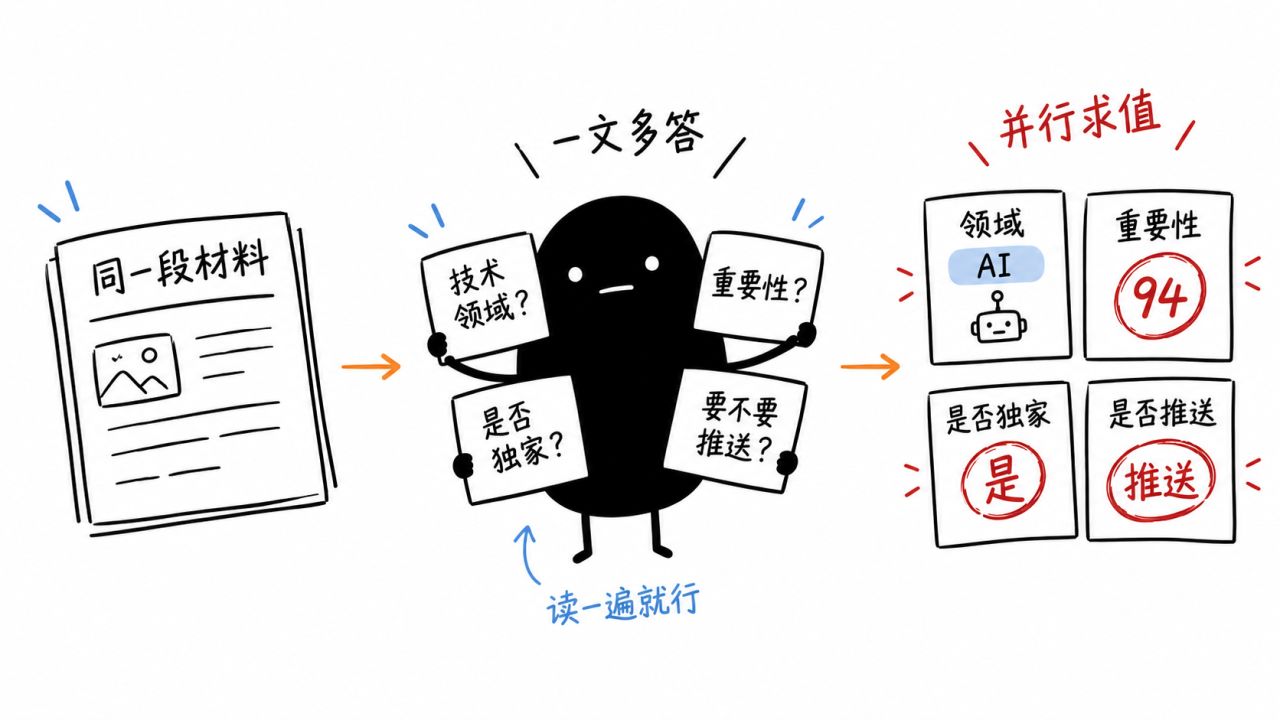
不過,最讓開發者拍大腿的還不是單個題目的速度,而是它的“一文多答”機制。
在以往的架構裏,面對一篇長新聞或者一份上報日誌,你可能要分別調用三次大模型,或者拼一段極長極脆的複雜 Prompt,讓它一次性返回一個大嵌套的 JSON。而 Jev 的做法是:同一段材料只在底層神經網絡裏編碼讀一遍,你可以同時在上面掛載好幾道題——“核心屬於哪個技術領域(Choice)”、“重要性分級(Score)”、“是不是突發獨家新聞(Noul)”、“是否需要立刻推送到全員告警羣(Noul)”。
四道題在內部並行求值,整套試卷答完交卷,耗時依然停留在短短几百毫秒。對系統鏈路來說,再也沒有比這種交付更乾淨、更痛快的了。
Q5:這樣只做決策靠譜嗎?
很多人看到這裏的第一反應大概是:只給做選擇題的模型,真的不是把老舊的分類器重新包裝、拿來忽悠投資人的噱頭嗎?
如果剝開概念包裝,往底層的計算原理和認知科學深挖一步,你會發現這其實是一條極其務實、甚至早就該被走通的工程解法。
現在的大模型之所以又貴又卡,根源在於它們的底層機制——自迴歸逐字生成。模型每吐出一個字,就必須把前面所有的內容塞回注意力網絡裏從頭到尾重算一遍。這就好比一個人在寫長篇大論,寫完一個字必須停下來把整篇文章通讀一次,再琢磨下一個字落在哪。這種機制確實催生了驚人的文字創意與代碼編寫能力,但如果拿來處理一個簡單的“是與否”,就無異於每次去便利店買一瓶礦泉水,都必須發動一輛幾十噸的重型卡車。
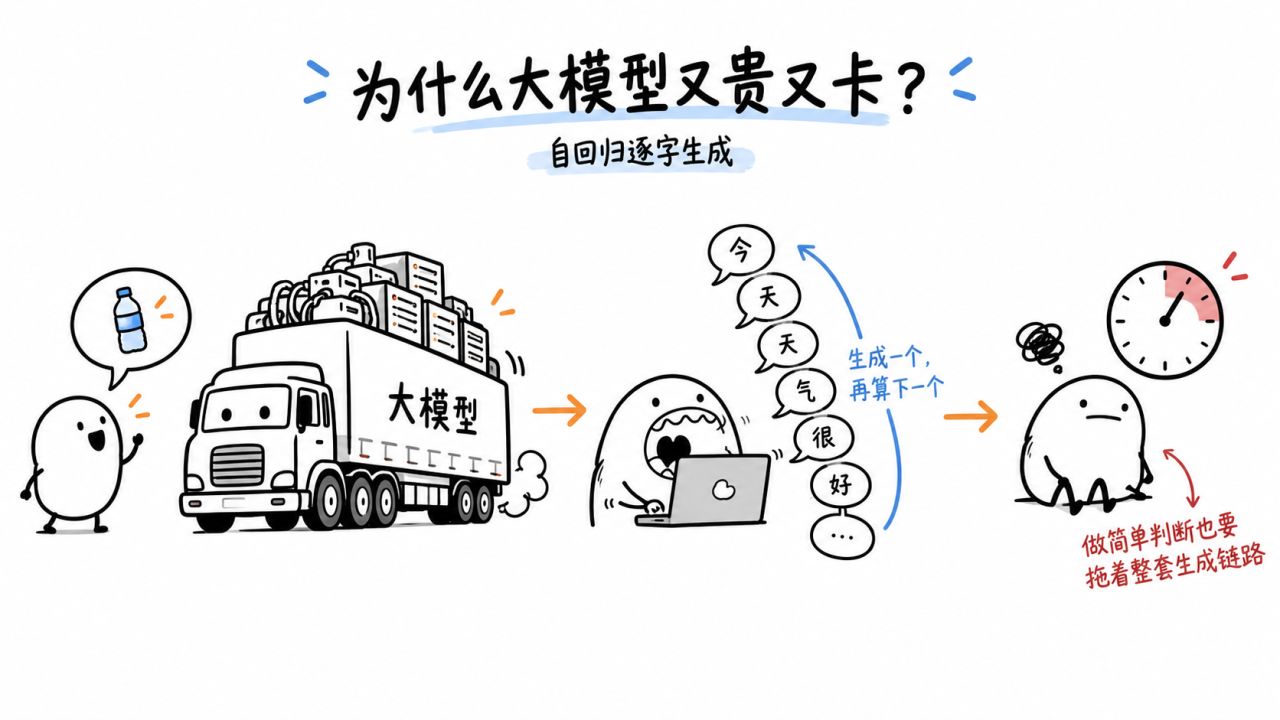
Jev 的解題思路則是把這套邏輯徹底掀翻。它在架構設計上就主動砍掉了任意自由文本的生成能力,把整個輸出空間死死摁在預先指定的幾個固定槽位上。因爲根本不需要像織毛衣那樣反反覆覆跑解碼循環,它直接在神經網絡的輸出層一次性完成幾個選項的概率矩陣運算。沒有冗餘的吐字過程,延遲自然而然能被硬生生砸進 70 到 500 毫秒的區間,大部分常規場景更是隻要 100 毫秒上下就能拍板。
但僅僅“快”並不稀奇,BERT 時代的小分類器同樣飛快。Jev 真正讓工程界眼前一亮的突破,在於它解決了小模型長期以來的致命死穴——概率校準。
以往許多小分類器都有嚴重的“盲目自信綜合徵”:明明判斷方向已經跑偏了,輸出的置信度依然敢標 99.9%,這在嚴肅的業務系統裏簡直是災難。而 TypeSafe 團隊採用的 RLCD(強化學習校準決策)訓練方法,核心就是把置信度調教得像一份極度剋制的氣象預報:如果它說這件事有 80% 的概率屬實,那麼在統計學的一百次樣本里,它大概率就真的只對 80 次左右。
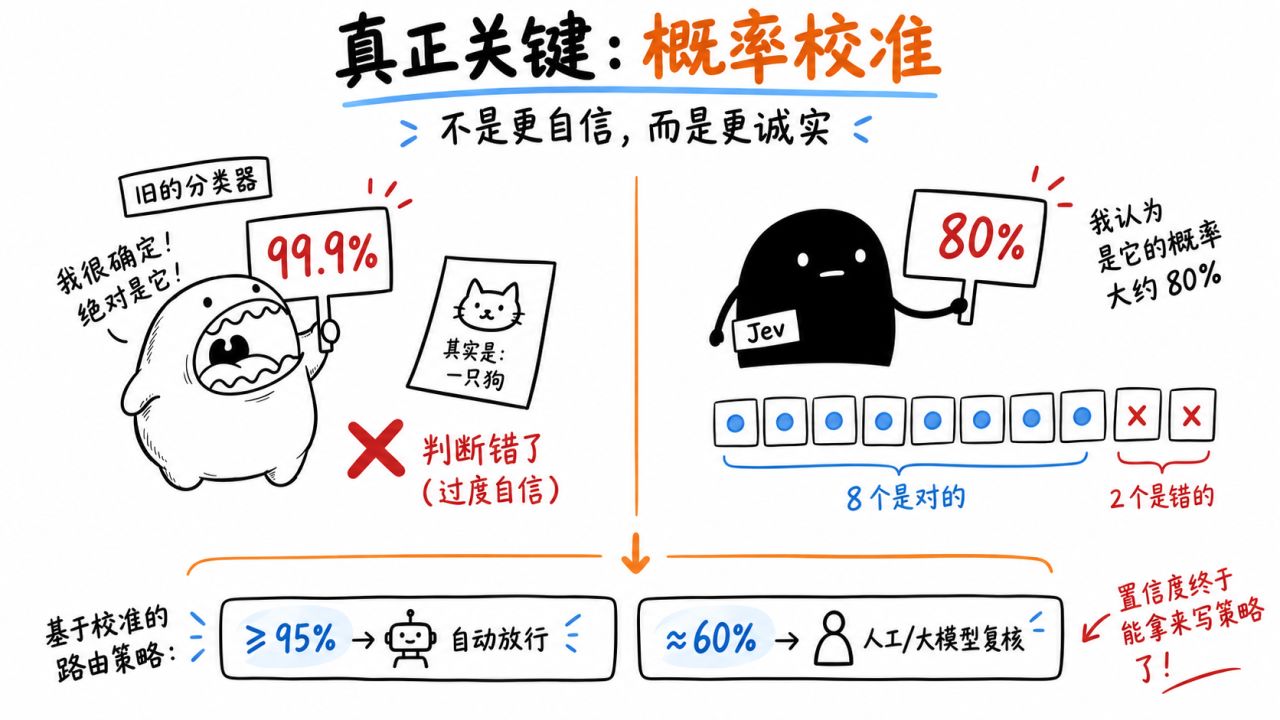
這種統計層面上的誠實,對後端系統而言是無價的。工程師終於敢在業務邏輯裏放心地寫策略分流:置信度達到 95% 以上的任務直接全自動放行;跌到 60% 左右模糊地帶的邊緣請求,則平穩降級交給人工或者大模型二次複覈。
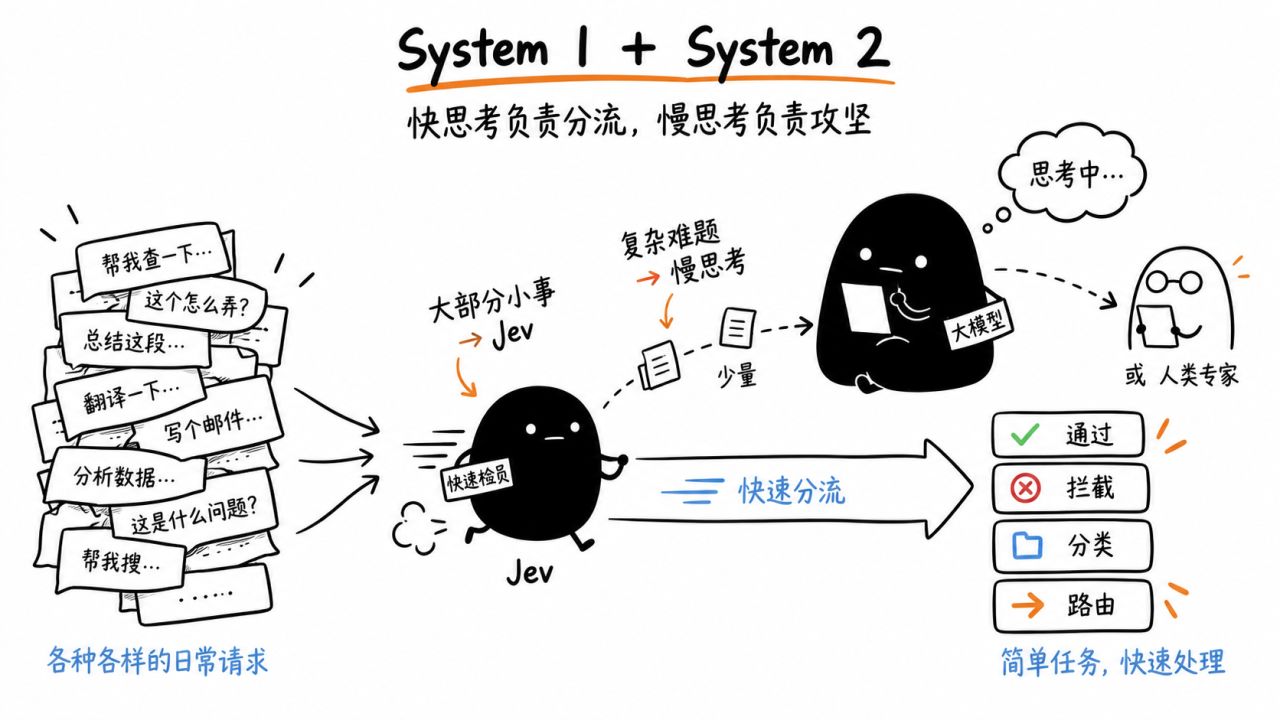
認知心理學裏常說的 System 1(快思考)與 System 2(慢思考),在生物演化中本就是協同工作的。人類日常生活裏絕大多數動作完全依賴憑直覺就能瞬間完成的快思考,只有遭遇極其棘手的攻堅難題時,纔會調動極度燒腦的慢思考深思熟慮。
過去兩年,整個 AI 界都在盲目模仿 System 2,試圖把所有輕量級的小事都強行拖進深思熟慮的長篇大論裏。而 Jev 這類模型的意義,就是把過度臃腫的算力釋放出來,替自動化系統重新補上那個早該具備的、依靠本能直覺高速運轉的 System 1。
Q6:Jev都可以用來做什麼?
Jev能做的事情太多了,而且 這兩天在推特上徹底殺瘋了,全網都在曬各種魔改玩法。官方 waitlist 如果排不上,大家基本都直接殺去 OpenRouter 調它。很多工程師現在第一件事,就是趕緊把 Jev 掛在自己的編程工具裏,給像 Claude Code 或者 Codex 這類重型模型配一個百毫秒級的“隨身裁判”。
當判斷的延遲被壓到幾十毫秒、成本降到幾分錢時,過去寫不出來的自動化邏輯,全被大家暴力跑通了。
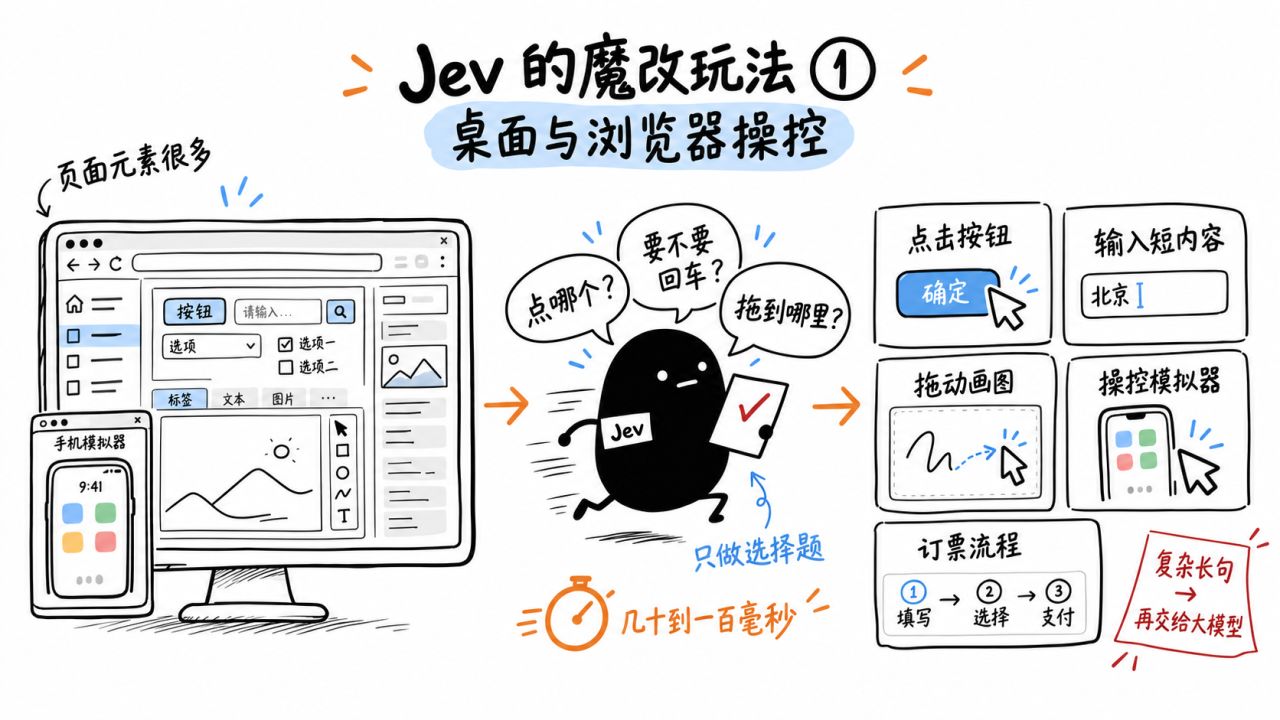
桌面和瀏覽器操控(Computer Use & Browser Use)。以前用 AI 自動化點網頁,每刷新一次頁面,大模型都要對着 DOM 樹和截圖思考兩秒鐘,卡得像幻燈片。現在大家把它拆成兩半:Jev 專門負責做單選題。幾十個按鈕和輸入框擺在面前,它幾十毫秒就能決定光標點哪個、該不該敲回車,甚至直接驅動鼠標在 Excalidraw 白板上畫圖、操控 iOS 模擬器跑 App,或者在網頁裏全自動極速訂機票。只有遇到輸入框要填複雜長句時,才調一下大模型。
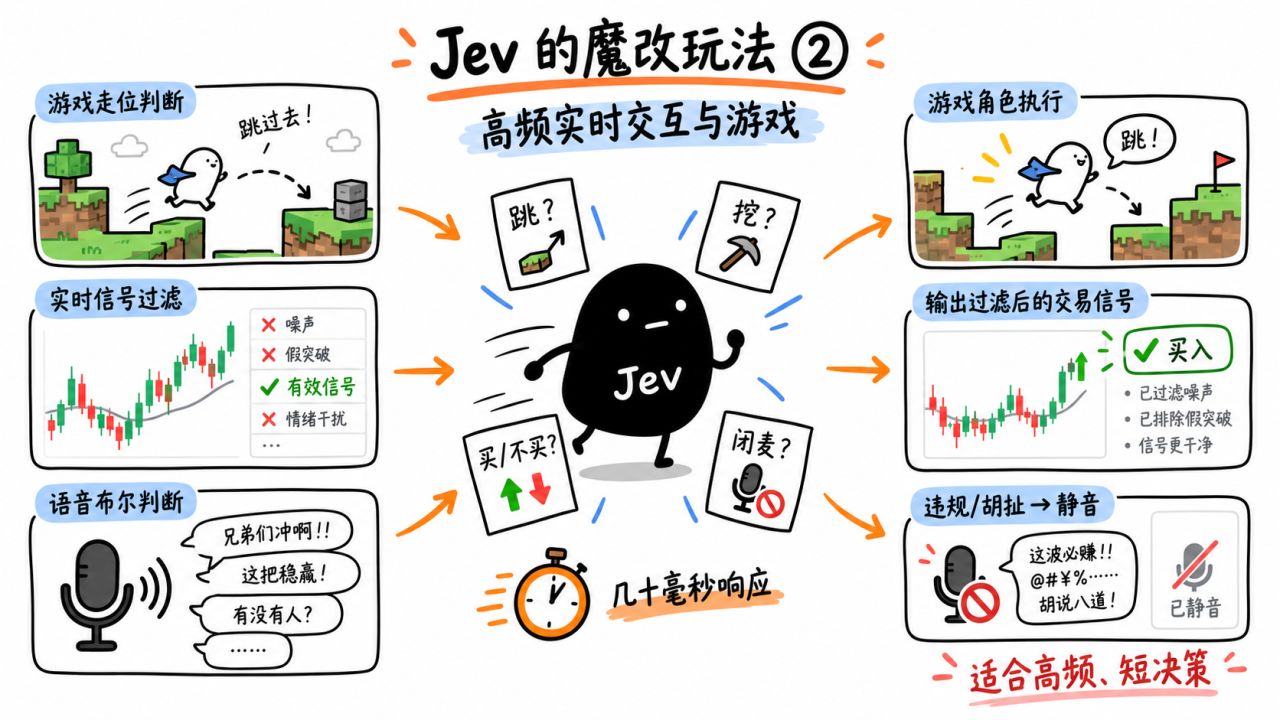
高頻實時交互與遊戲。因爲響應實在太快,有人把內存狀態轉成文本餵給它,讓它在《我的世界》裏實時做生存走位和挖掘判斷;在金融場景,有人拿它跑高頻的貨幣和股票實時交易信號過濾;在日常語音裏,還有人做了個“胡說八道禁言麥克風”——把麥克風的語音流實時轉成文字,Jev 在幾十毫秒內做布爾判斷,一旦發現發言者開始胡扯、吹牛或違規,直接在系統層一鍵閉麥。
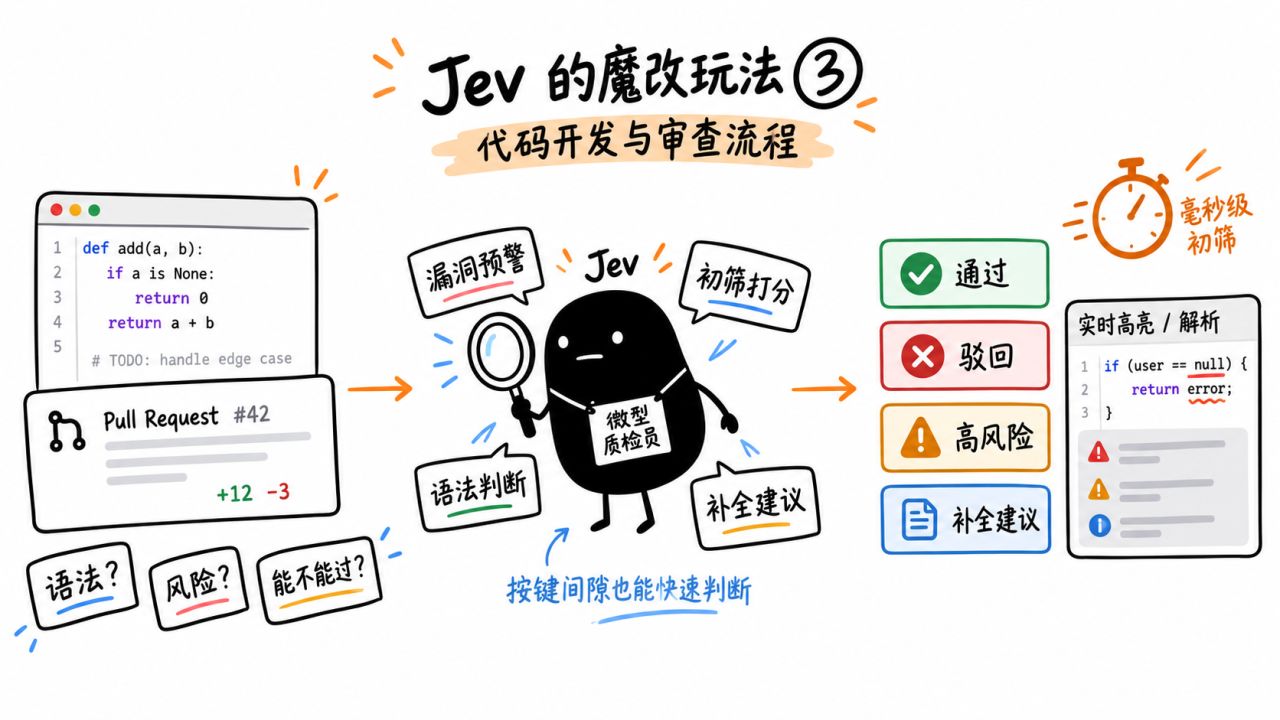
代碼開發與審查流程裏,它成了每個程序員手邊的微型質檢員。比如開發者提交了一個 PR,Jev 在後臺幾十毫秒內完成初篩打分和漏洞預警,不合格直接駁回;它還能充當任意小衆編程語言的實時語法高亮解析器、開發工具按鍵間隙的代碼自動補全與實時建議,甚至有人基於它的這種極致單選邏輯,腦洞大開地設計了一門專門依靠 Jev 決策驅動的新型編程語言。
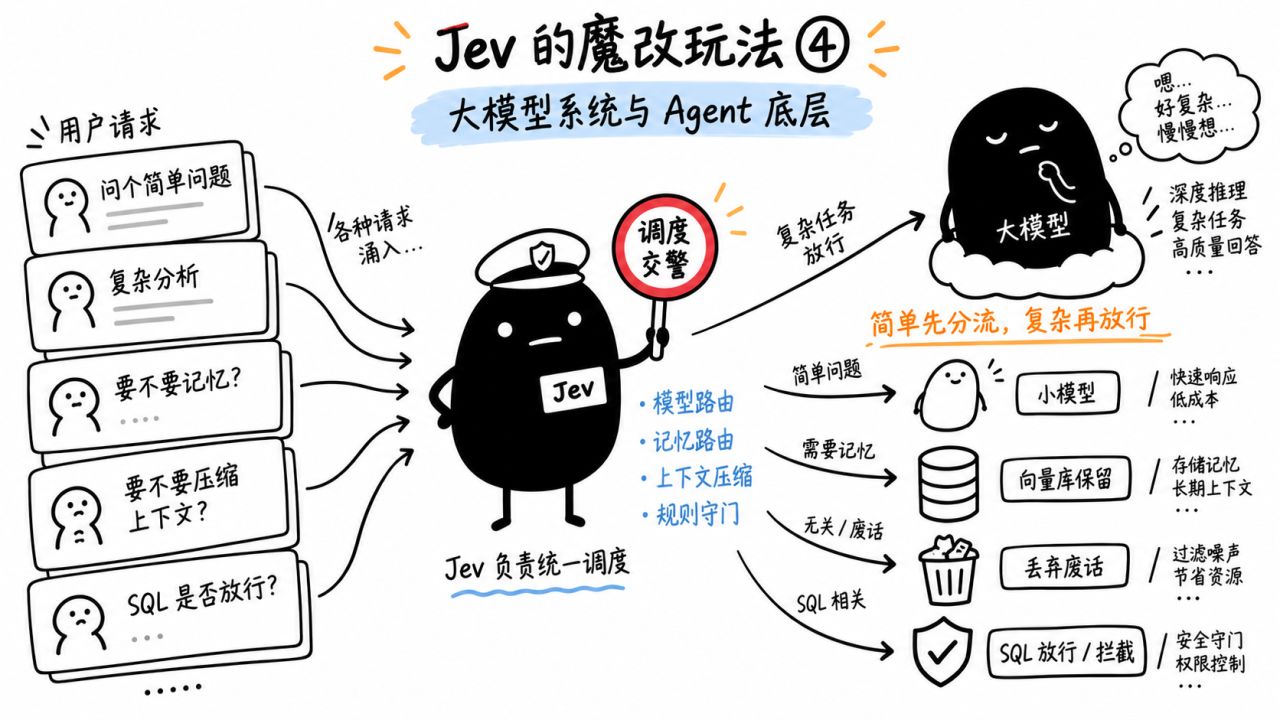
大模型系統與 Agent 底層,它基本成了標配的“調度交警”。比如“模型路由”,用戶發來一句話,Jev 瞬間判斷難度,簡單的丟給便宜的小模型,極其複雜的才放行給旗艦大模型;在多輪長對話裏,它負責做“記憶路由”和上下文即時壓縮,快速判斷哪幾句話該保留進向量數據庫、哪幾句廢話直接扔掉;連寫 SQL 都有了新玩法,用它來充當 SQL 擴展語句的篩選守門員。
審覈與結構化處理上,它更是天生的數字保安。在 Discord 頻道里做全天候高頻風控、毫秒級識別內容是不是 AI 水文、聊天輸入時給下一組推薦的 Emoji 做極速候選,以及官方給出的經典案例——企業 HR 系統裏成千上萬份簡歷的高併發多維度機篩。
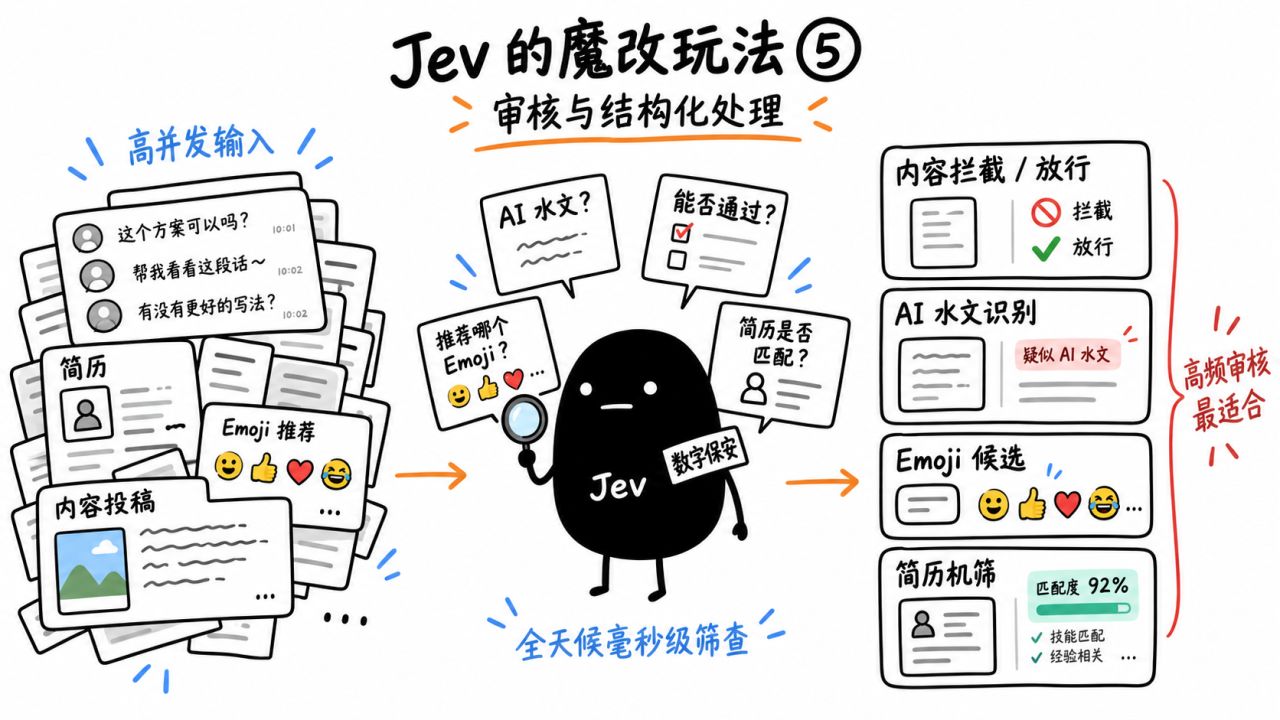
以前讓巨型模型去點個按鈕、審一行代碼、分流一句話,純屬大炮打蚊子;而把 Jev 這種只做判斷的百毫秒級小模型嵌入系統,機器才真正第一次有了像人類反射弧一樣的“肌肉直覺”。
Q7:如何進行註冊使用?
目前主要有兩條上手路徑:
第一條是走官方通道,直接去官網提交 waitlist 申請,早期申請的開發者反饋基本一到兩天就能批下來。通過後進入控制檯拿到 API Key。
第二條是嫌排隊太慢的捷徑,很多第三方聚合平臺已經第一時間接入支持,例如可以在 OpenRouter、Vercel AI Gateway 或者 Cloudflare AI 裏直接調用 typesafe-ai/jev 模型,無需等候審覈,計費標準也基本與官方保持同步。
如果你平時習慣用 Claude Code、Cursor 或者 Windsurf 這類 AI 編程工具,甚至都不用自己逐行啃文檔,直接把官方接口規範丟給編程助手,讓它幫你寫一個工單分類或者推文篩選函數,兩分鐘就能跑通全流程。
但在正式把 Jev 接入業務鏈路之前,務必清醒認識到它極其鮮明的“偏科”短板。
官方文檔在自我剖析時非常坦誠,列出了當前 Jev 1.13 版本的幾個致命死穴:
首先,它本質上是一個被極度特化的“偏科專科生”,在數數、精準算術以及日期先後推算上表現非常脆弱;長鏈條的多步邏輯推理(Multi-hop Reasoning)能力也有限,準確率會肉眼可見地下滑。
其次,模型的訓練基底依然以英文語料爲主。雖然中文文本能夠正常餵給它並完成識別,但對複雜長難句或隱晦表達的理解精度確實明顯弱於英文,若要在中文業務場景上線,務必先用本地小樣本測試集做嚴格驗證。
最後,大模型上常見的 Prompt Injection(提示詞注入)漏洞在它身上同樣無法免疫。如果輸入的內容中暗藏針對判斷邏輯的誘導性指令,它照樣有概率被帶偏進而選錯分類。
因此,切忌把 Jev 當成沒有缺陷的神話模型。在合法的候選選項裏它依然存在翻車概率;任何涉及退款打款、資金劃轉、批量刪庫等高危權限的操作,系統底層該保留的硬編碼業務鑑權與權限隔離,絕對一道都不能少。
更多遊戲資訊請關註:電玩幫遊戲資訊專區
電玩幫圖文攻略 www.vgover.com