写在前面:
如今这个时代,注意力和专注力都是我们自身宝贵的稀缺资源,
我总是很贪心地在一篇文章里塞下很多东西,总是想尽可能把我知道的东西尽量有逻辑,有条理地分享给大家,比如这篇,又爆了6000字,我通篇看来看去,怎么也缩不下去。
原因有很多,内容要由浅到深、要在必要的地方扩展补充关键信息、要文章形成完整的逻辑架构...
这往往导致一篇文的篇幅太长,阅读要花费的时间太多,就算这样,很多主题都只是点到表面,并没有深入。
其实我自己也知道这样不好。我们平时的事情那么多,大家哪有那么多精力和功夫花这么多时间来看完?
但是我又不想把一篇文章的内容拆散来发,因为我觉得这样会丢失文章里体现的思考过程,也会让大家不能顺理成章将一些信息之间建立逻辑关系,
说到底这也是我的私心,但目前也不知道该怎么优化,如果有什么想法,十分希望你们能在评论区告诉我。
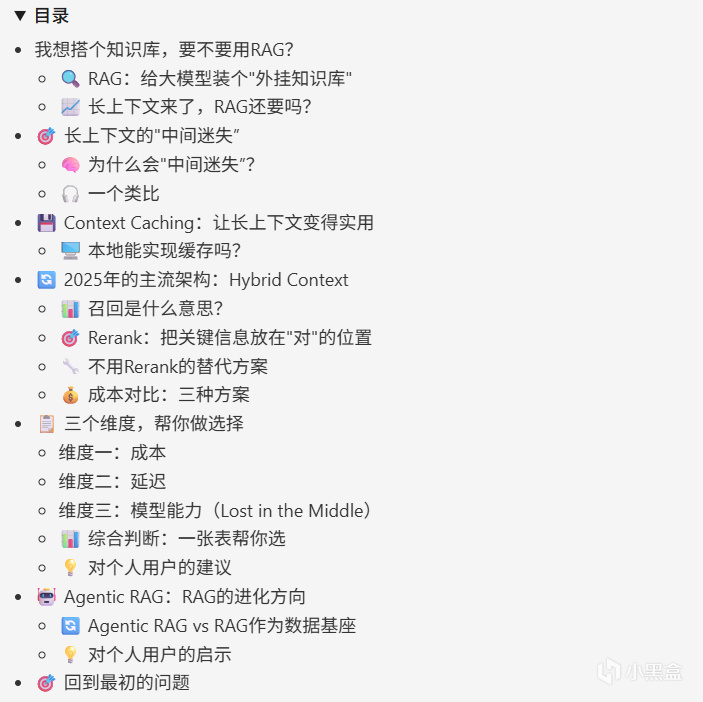
如果愿意看文章的盒友们,我强烈建议你们先看目录,然后直接看自己感兴趣、想了解的部分即可
---
本文约 6200 字,预计阅读时间约 14 分钟。
我想搭个知识库,要不要用RAG?
这个问题看似简单,但答案取决于具体情况。
先简单复习一下RAG是什么。
🔍 RAG:给大模型装个"外挂知识库"
RAG(Retrieval-Augmented Generation,检索增强生成)最早由Meta AI在2020年提出。核心思路很简单:大模型的知识是有限的、静态的,但可以通过"检索"把外部知识动态地喂给它。
具体来说,RAG的工作流程是:
1⃣ 切片
把文档切成小块(每块500-1000字)。为什么切?整篇文档太长,检索和匹配都不方便。就像图书馆不会把整本书塞进检索系统,而是按章节、段落建立索引。
2⃣ 向量化
用嵌入模型(Embedding Model)把每个文本块转成一串数字向量。
向量是什么?可以理解为文本的**“语义坐标”**——语义相近的文本,向量在空间里的距离也近。“苹果公司"和"Apple Inc.“的向量距离很近,和"红富士苹果"的距离就远了。
3⃣ 存储
把这些向量存进向量数据库。
4⃣ 检索
用户提问时,把问题也转成向量,在数据库里找最相似的几个文本块。
5⃣ 生成
把检索到的文本块塞进提示词,让大模型基于这些材料回答。
为什么RAG曾经是搭建知识库的标配?
因为大模型有两个致命缺陷:
知识有截止日期,不知道最新发生的事
没有私有数据,不知道公司内部的文档、产品手册、技术规范
RAG恰好解决了这两个问题——可以随时更新知识库,也可以把私有数据喂给模型。
📈 长上下文来了,RAG还需要吗?
2024年,Gemini推出100万Token的上下文窗口,“RAG已死"的言论甚嚣尘上。
2025年,DeepSeek把缓存Token的价格打到了原来的1%,长上下文模型变得异常便宜。
于是很多人开始想:既然模型能记住这么多内容,为什么不直接把所有笔记塞进去?
不需要切分文档、不需要向量检索、不需要复杂的RAG流水线,直接全量输入,让模型自己找答案。
听起来很美好。但实际效果如何?
🎯 长上下文的"中间迷失”
业界用NIAH(Needle In A Haystack,大海捞针)测试来评估长上下文模型的检索能力。
早期的测试很简单:把一个关键信息(“针”)藏在大量文本(“干草堆”)里,看模型能不能找到。
2025年的测试标准升级了——Multi-Needle Reasoning(多针推理)。比如:在100份财报(共100万Token)里,找到A公司和B公司在Q3的研发投入数据,并比较增长率。模型不仅要找到两个散落在不同位置的数据点,还要进行跨文档的逻辑比较。
测试结果揭示了一个物理规律:Lost in the Middle(中间迷失)。
模型对开头和结尾的内容记得最清楚,对中间的内容注意力会衰减。研究表明,当输入文本超过5万字时,中间位置信息的检索准确率可能下降40%以上。
🧠 为什么会"中间迷失”?
这不是模型的"缺陷”,而是注意力机制的固有特性。
Transformer的核心是自注意力。每个Token都要和所有其他Token计算关联度。注意力权重经过Softmax归一化后,所有位置的总和是1。
当序列长度从100变成10000,每个位置能分到的"注意力预算"被稀释了100倍。
但开头和结尾有天然优势:
开头:作为第一个位置,累积了最多的"被关注"机会
结尾:在生成时已经"看过"所有前置内容,天然带有全局视角
中间位置没有这种优势——它们既不是起点,也不是终点。
还有一个因素:位置偏好是训练数据的产物。
模型在训练时看到的大多是短文本。在这些文本里,开头往往是主题句、标题、摘要——信息密度高。结尾往往是结论、总结——也很重要。中间则是展开论述,信息相对稀释。
模型学到了这个模式:开头和结尾更值得"关注"。
🎧 一个类比
想象在听一场3小时的讲座。
开头10分钟很专注,因为不知道要讲什么。结尾10分钟也很专注,因为想知道结论。
中间2小时40分钟呢?注意力会不自觉地飘走——不是因为内容不重要,而是因为**“注意力预算"有限**。
模型也一样。
💾 Context Caching:让长上下文变得实用
长上下文还有另一个问题:成本和延迟。
把100万Token的文档塞进模型时,模型要对每个Token做前向传播,计算出每一层的Key和Value向量——这些统称为KV States。这个过程需要大量GPU时间。
问第二个问题?模型又要重新算一遍。
Context Caching的核心思路:把第一次计算出来的KV States存起来,下次直接用。
就像读一本书——第一次读要逐字逐句理解,第二次读时已经"记住"了内容,只需要关注新问题。
以DeepSeek V3为例,缓存命中后:
100万Token的输入成本从 $5.00 → $0.02(对比GPT-4o的$5/1M tokens)
延迟从 60秒 → 5秒
但缓存是有限的资源——显存不是无限的,服务商不可能无限期保存KV States。
不同服务商的策略:
Anthropic:缓存有最小token要求,有效期有限
DeepSeek:缓存时间较长,适合长对话场景
🖥 本地能实现缓存吗?
实现KV缓存的前提是:能访问模型的中间状态。这取决于用什么方式运行模型。
方案一:vLLM
vLLM是目前最流行的开源推理框架,内置PagedAttention机制,本质上就是一种高效的KV缓存管理。用vLLM部署本地模型(比如Llama、Qwen),缓存是开箱即用的。
方案二:HuggingFace Transformers
原生Transformers库不提供缓存管理,但可以手动实现。要做成生产可用的缓存系统,还需要缓存索引、缓存淘汰、缓存失效检测。
方案三:Ollama
Ollama默认不暴露KV缓存接口,但内部有类似的优化机制。问题是:无法直接控制Ollama的缓存行为。它更像一个黑盒,适合简单场景。
但有一个硬限制:KV缓存是存在显存里的。
以Llama-3-8B为例,每Token的KV缓存大约占用50KB显存。100万Token的缓存需要约50GB显存——这远超大多数消费级显卡。
实际可行的方案:
用量化模型
只缓存高频访问的文档片段
用CPU内存做二级缓存(但会牺牲延迟)
对个人用户来说,如果知识库小于10万Token,且用DeepSeek或类似低价模型,直接用长上下文是最简单的方案。不需要搭建向量数据库,不需要调优检索参数,把所有笔记塞进去就行。
但如果知识库更大呢?
🔄 2025年的主流架构:Hybrid Context
“RAG vs 长上下文"这个二元对立在2025年被打破了。
主流架构变成了Hybrid Context(混合上下文):用RAG做宽召回,用长上下文做深推理。
具体流程三步走:
1⃣ 宽召回
用向量检索+关键词检索,召回Top-100个相关文档(约50k-100k Token)。
这相当于把"大海"缩小成"池塘”。
2⃣ 上下文重组
用Rerank模型,把最相关的Top-10文档放在提示词的首部和尾部(利用注意力机制),其余90个文档放在中间。
3⃣ 长窗口推理
把这100k Token一次性喂给长文本模型。
📊 召回是什么意思?
召回(Recall)指的是:在所有相关的内容中,找出了多少。
知识库有1000篇文档,其中50篇和问题相关。系统找出了40篇,召回率就是80%。召回率越高,意味着漏掉相关内容的概率越低。
召回和精度往往是矛盾的:
召回100篇文档 → 召回率高,但里面有很多无关内容(精度低)
召回5篇文档 → 精度高,但可能漏掉重要内容(召回率低)
“宽召回"就是放宽召回的标准,宁可多找一些。
为什么敢召回这么多?因为后面还有长上下文模型来处理。模型会自己判断哪些内容真正相关——这是"深推理"的部分。
🎯 Rerank:把关键信息放在"对"的位置
Rerank模型的作用是重新评估"相关性”——不是看语义像不像,而是看对回答这个问题有多重要。
向量相似度只是"语义接近”,不等于"对回答问题最重要"。
举个例子:用户问"对比A公司和B公司的研发投入"。召回的文档里可能有50篇提到A公司,30篇提到B公司。按向量相似度排序,前10篇可能都是关于A公司的——B公司的信息被挤到中间位置,模型可能忽略。
Rerank模型输入"问题+文档",输出"相关性分数"。它比向量相似度更精准,因为能看到问题和文档之间的交互。
但Rerank不是必须的。如果知识库不大,且查询不复杂,向量检索的排序已经够用。
🔧 不用Rerank的替代方案
方案一:接受精度损失
如果查询相对简单,或者对精度要求不高,可以跳过Rerank。长上下文模型本身有一定"抗噪"能力。
方案二:用规则替代
比如关键词匹配度高的排前面、文档新鲜度高的排前面、文档来源权威性高的排前面。这比Rerank便宜,但效果取决于规则设计。
方案三:用LLM做Rerank
把问题和文档摘要一起喂给一个便宜的小模型,让它判断相关性。效果可能比专用Rerank模型差,但比规则方法灵活。
建议:知识库不大(<1000篇文档)且查询不复杂,Rerank的价值有限。知识库很大,或者查询需要跨文档推理,Rerank值得投入。开源的Rerank模型(如BGE-Reranker、Cohere Rerank)部署成本不高。
💰 成本对比
假设知识库有100万Token:
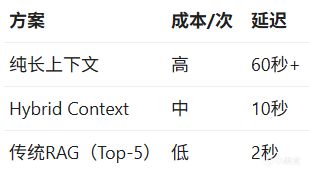
三种方案
Hybrid Context比纯长上下文便宜10倍,比传统RAG贵50倍。
为什么不用传统RAG?因为传统RAG的召回率低。Top-5可能漏掉关键信息,尤其是需要跨文档推理的场景。
Hybrid Context的思路是:用稍高的成本,换取更高的召回率和推理能力。
它填补了传统RAG和纯长上下文之间的空白——不是"最便宜"的方案,而是**“性价比最高"的方案**。
📋 三个维度,帮你做选择
怎么判断用哪种方案?看三个因素:成本、延迟、模型能力。
维度一:成本
例如用GPT-4o的价格来算,月查询量100次的情况下:
10万Token的月成本是$50,开始有点贵了
50万Token的月成本是$250,对个人用户来说不便宜
但如果用DeepSeek V3(带缓存),10万Token的缓存后成本是$0.002/次——几乎可以忽略。
价格信息有时效性,仅供参考,以官方价格为准
维度二:延迟
大多数用户能接受的等待时间是10秒以内。按这个标准,边界大约在10万Token。
但如果用缓存,第二次查询的延迟会大幅下降。
维度三:模型能力
这是最硬的限制。
当输入超过10万Token时,Lost in the Middle效应开始明显。模型可能漏掉中间位置的关键信息。
可以通过"上下文重组"来缓解——把最重要的内容放在开头和结尾。但这需要额外的处理逻辑,本质上已经开始接近Hybrid Context的思路了。
📊 综合判断
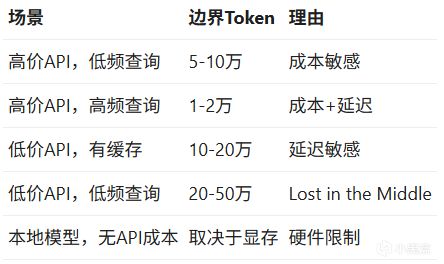
💡 对个人用户的建议
知识库<10万Token:直接用长上下文,不需要RAG。把所有笔记塞进去就行,简单直接。
知识库10-50万Token:考虑Hybrid Context。用简单的向量检索召回Top-100,然后喂给长上下文。
知识库>50万Token:RAG是必要的。纯长上下文在成本、延迟、准确性上都会出问题。
还有一个维度是更新频率:
知识库很少更新 → 长上下文+缓存很划算
知识库每天更新 → RAG更灵活,不需要重新计算缓存
🤖 Agentic RAG:RAG的进化方向
如果关注AI领域,可能听说过"Agentic RAG"这个词。它和传统RAG有什么区别?
核心区别在于:谁在控制检索过程。
传统RAG:固定流程,用户提问 → 向量检索 → 返回答案
Agentic RAG:Agent自主决定,需要什么信息?去哪里找?要不要继续检索?
举个例子:用户问"比较A公司和B公司去年的研发投入,并分析对股价的影响”。
传统RAG的流程:
把问题转成向量
在知识库里检索Top-K文档
把文档喂给模型生成答案
问题:如果知识库里只有研发数据,没有股价数据,模型只能基于不完整的信息回答。
Agentic RAG的流程:
Agent分析问题:需要两类信息——研发投入 + 股价
Agent先检索研发数据
Agent判断:研发数据有了,但缺股价数据
Agent决定:调用股价API获取数据
Agent整合两类信息,生成答案
关键区别:Agent有"规划"和"反思"能力。
它不是机械地执行检索,而是像一个研究员一样思考:我需要什么信息?我有了什么?还缺什么?去哪里补?
🔄 Agentic RAG vs RAG作为数据基座
这是两个相关但不同的概念。
Agentic RAG:RAG系统自己具有Agent能力,能自主规划检索策略、判断检索结果是否足够、调用多种数据源。
RAG作为数据基座:RAG系统被其他Agent调用,Agent需要数据时调用RAG,RAG只是Agent的一个"工具"。
一个类比:
Agentic RAG像一个"智能研究助理",自己能规划、执行、反思
RAG作为数据基座像一个"图书馆",等其他Agent来查资料
它们可以结合:一个Agentic RAG系统,既可以自己作为Agent完成任务,也可以被其他Agent调用提供数据。
💡 对个人用户的启示
Agentic RAG更强大,但也更复杂:
成本更高:可能多次调用模型进行规划和反思
延迟更长:多轮检索和推理需要时间
搭建难度更大:需要设计Agent的工作流程
对于个人知识库,如果查询相对简单(主要是事实查询),传统RAG或长上下文就够了。如果需要复杂的多步推理,Agentic RAG可能更有价值。
主流框架(LangChain、LlamaIndex)都提供了Agentic RAG组件的封装,搭建门槛比想象中低。
🎯 回到最初的问题
2026年了,搭建自己的知识库还需要RAG吗?
答案不是简单的"需要"或"不需要"。
RAG没有死,但RAG的定义被重写了。它不再只是"检索工具",而是正在进化为AI Agent的"神经中枢"——上下文引擎、数据基座、记忆系统。
对于个人知识库:
数据量小、查询简单 → 长上下文可能是更简单的选择
追求更低成本、更快响应、更灵活扩展 → RAG依然值得投入
真正重要的不是选择RAG还是长上下文,而是理解它们各自的边界和协同方式。
2025年的主流架构是Hybrid Context——用RAG做宽召回,用长上下文做深推理。这种"检索前置,长上下文容纳"的范式,可能是未来几年的最优解。
而Agentic RAG代表的是另一个维度的进化:从"被动检索工具"向"主动智能系统"的转变。
这个方向处于快速发展期,刚刚开始走向成熟。
感谢大家的耐心阅读,这篇文章是上篇文章Skill到底是什么,会影响以后用AI的方法吗?的投票结果决定的。对于问题:文档数量大时怎么优化RAG,看完这篇文章相信心里也已经有思路了。
如果还有什么想看的内容,欢迎在评论区告诉我。同时放出新一期的选题投票
更多游戏资讯请关注:电玩帮游戏资讯专区
电玩帮图文攻略 www.vgover.com